



تشغيل AI Agent على VPS (سيرفر افتراضي): إزاي تختار السيرفر وإيه اللي تشغّله
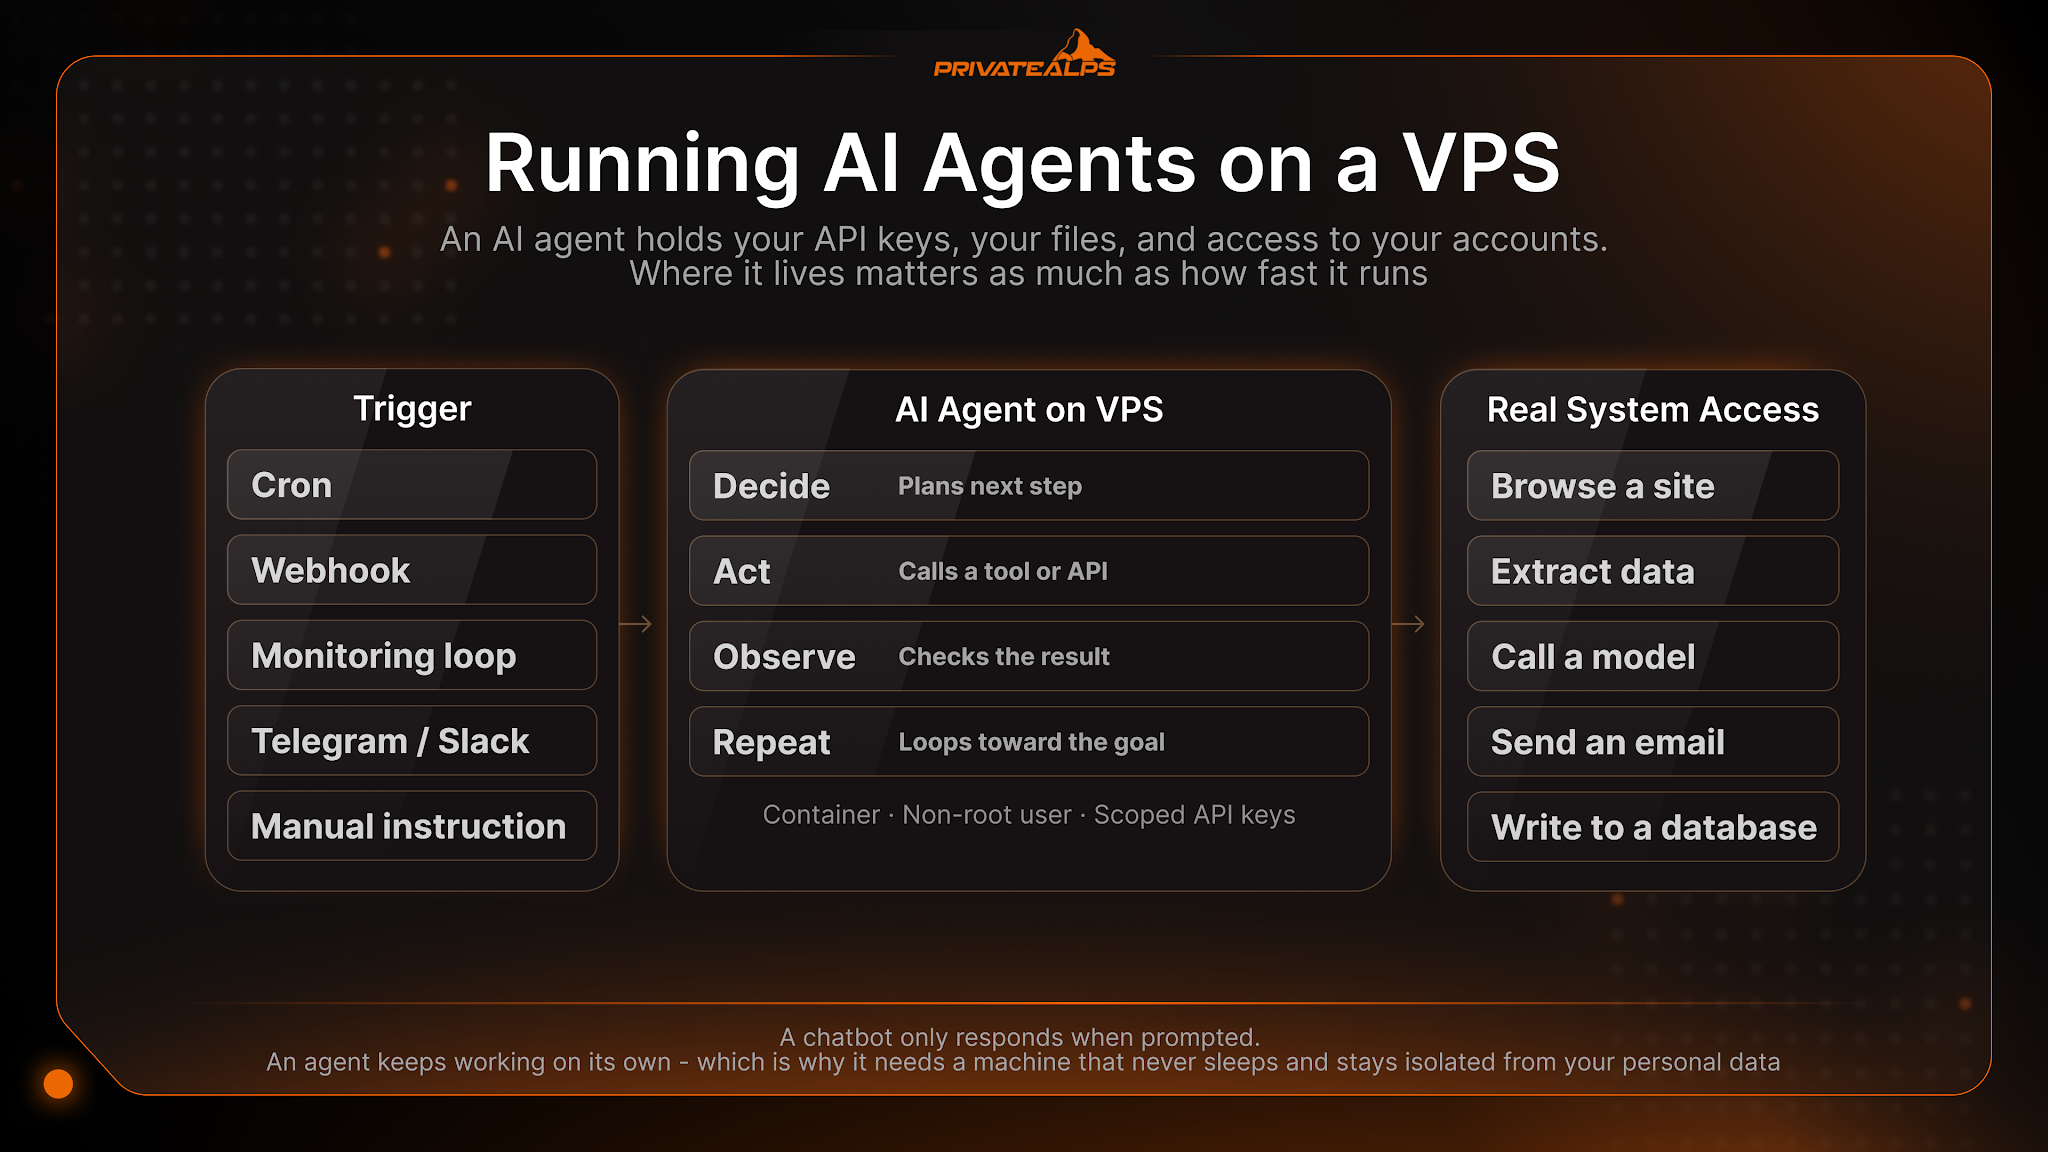
الـAI Agent هو برنامج مستقل مصمم يشتغل بشكل مستمر، بيخطط، ويستدعي أدوات، ويتصرف باتجاه هدف معين من نفسه. الطبيعة المستمرة دي بالتحديد هي اللي بتخلي تشغيله على VPS أنسب بكتير من تشغيله على لابتوب، لأن اللابتوب بينام، وبيخلّص البطارية، وبيعرّض ملفاتك الشخصية لأي حاجة الـagent يعملها بعد كده.
الدليل ده بيجاوب على سؤالين مترابطين: هتشغّل إيه (نوع الـagent والفريموورك)، وإزاي تختار سيرفر ليه (المواصفات والاستضافة). الإجابتين بيتوقفوا على قرار واحد: هل الموديل بتاعك بيشتغل من خلال API خارجي، ولا محلياً على نفس الجهاز؟ لو حسمت القرار ده صح، باقي الحسابات بتتظبط لوحدها.
في خيط هادي بيجري تحت كل اختيار في الدليل ده. الـAI Agent المستقل بيمسك الـAPI keys بتاعتك، وملفاتك، وصلاحيات وصولك لحساباتك، فمكان تشغيله وإيه اللي يقدر يوصله مهم بنفس قد أهمية سرعته.
باختصار
الـVPS هو المكان المعتاد لتشغيل الـAI Agent لأنه بيوفر تشغيل 24/7، وعنوان IP ثابت، وموارد مخصصة، وعزل عن جهازك الشخصي. أكبر عامل في تحديد حجم السيرفر هو إذا كان الـlanguage model بيشتغل من خلال API خارجي ولا محلياً على الهاردوير. الـagents اللي بتعتمد على API بتفضل خفيفة، والموديلات المحلية محتاجة أكتر بكتير. السيرفر بيصلّح البنية التحتية، مش طريقة التفكير، ومش هيعوّض agent اتعمله تحديد نطاق سيء.
- الـVPS بيخلي الـagent شغال 24/7 من غير ما يتأثر بلابتوبك.
- الـIP الثابت بيخلّي الـagent يستقبل webhooks وrequests الـAPI callbacks.
- العزل بيحدّ من الضرر لو الـagent اتاخد عليه.
- الـagents اللي بتعتمد على API خفيفة: حوالي 1-2 vCPU و2-4 GB RAM بيكفوا غالباً.
- تشغيل أكتر من agent مع Docker وقاعدة بيانات متجهات (vector DB) بيوصّلك لـ4 vCPU / 8 GB+.
- تشغيل الـinference للموديل محلياً محتاج GPU (VRAM)، مش مجرد CPU أكبر.
- السيرفر مش هيصلّح agent متحدد بشكل سيء ولا تعامل ضعيف مع الأسرار.
- النسخ الاحتياطي والـAPI keys المحددة بصلاحيات مسئوليتك انت، مش مسئولية الاستضافة.
الـAI Agent إيه، وليه نشغّله على سيرفر؟
الـAI Agent هو برنامج مستقل بيخطط للخطوات، ويستدعي الأدوات، ويراجع النتايج، ويتصرف في loop باتجاه هدف، من غير ما إنسان يوافق على كل خطوة. الـchatbot بيرد بس لما حد يكلمه. أما الـagent فبيفضل شغال لوحده، وده اللي بيخليه محتاج جهاز مابينامش ومعزول عن بياناتك الشخصية.
عملياً، الـagent بيستلم هدف، ويقسّمه لخطوات، ويشغّل loop للتفكير: يقرر، يتصرف، يراقب، ويكرر. كلمة «يتصرف» معناها إن عنده وصول حقيقي للنظام، يقدر يتصفح موقع، يستخرج بيانات، يستدعي موديل، يبعت إيميل، أو يكتب في قاعدة بيانات. كل تصرف بيلمس حاجة إنت مالكها، فالـagent محتاج مضيف مستقر وشغال طول الوقت، مش لابتوب شخصي.
دي أكتر الحاجات اللي بتصحّي الـagent:
- مهام مجدولة (زي تشغيل ليلي بنظام الـcron)
- webhooks جاية من خدمة تانية
- loops مراقبة لسعر أو feed أو endpoint
- رسايل جديدة على Telegram أو Slack أو الإيميل
- تعليمات يدوية من المشغّل بتاعه
ليه الـVPS هو المكان الافتراضي للـAI Agents
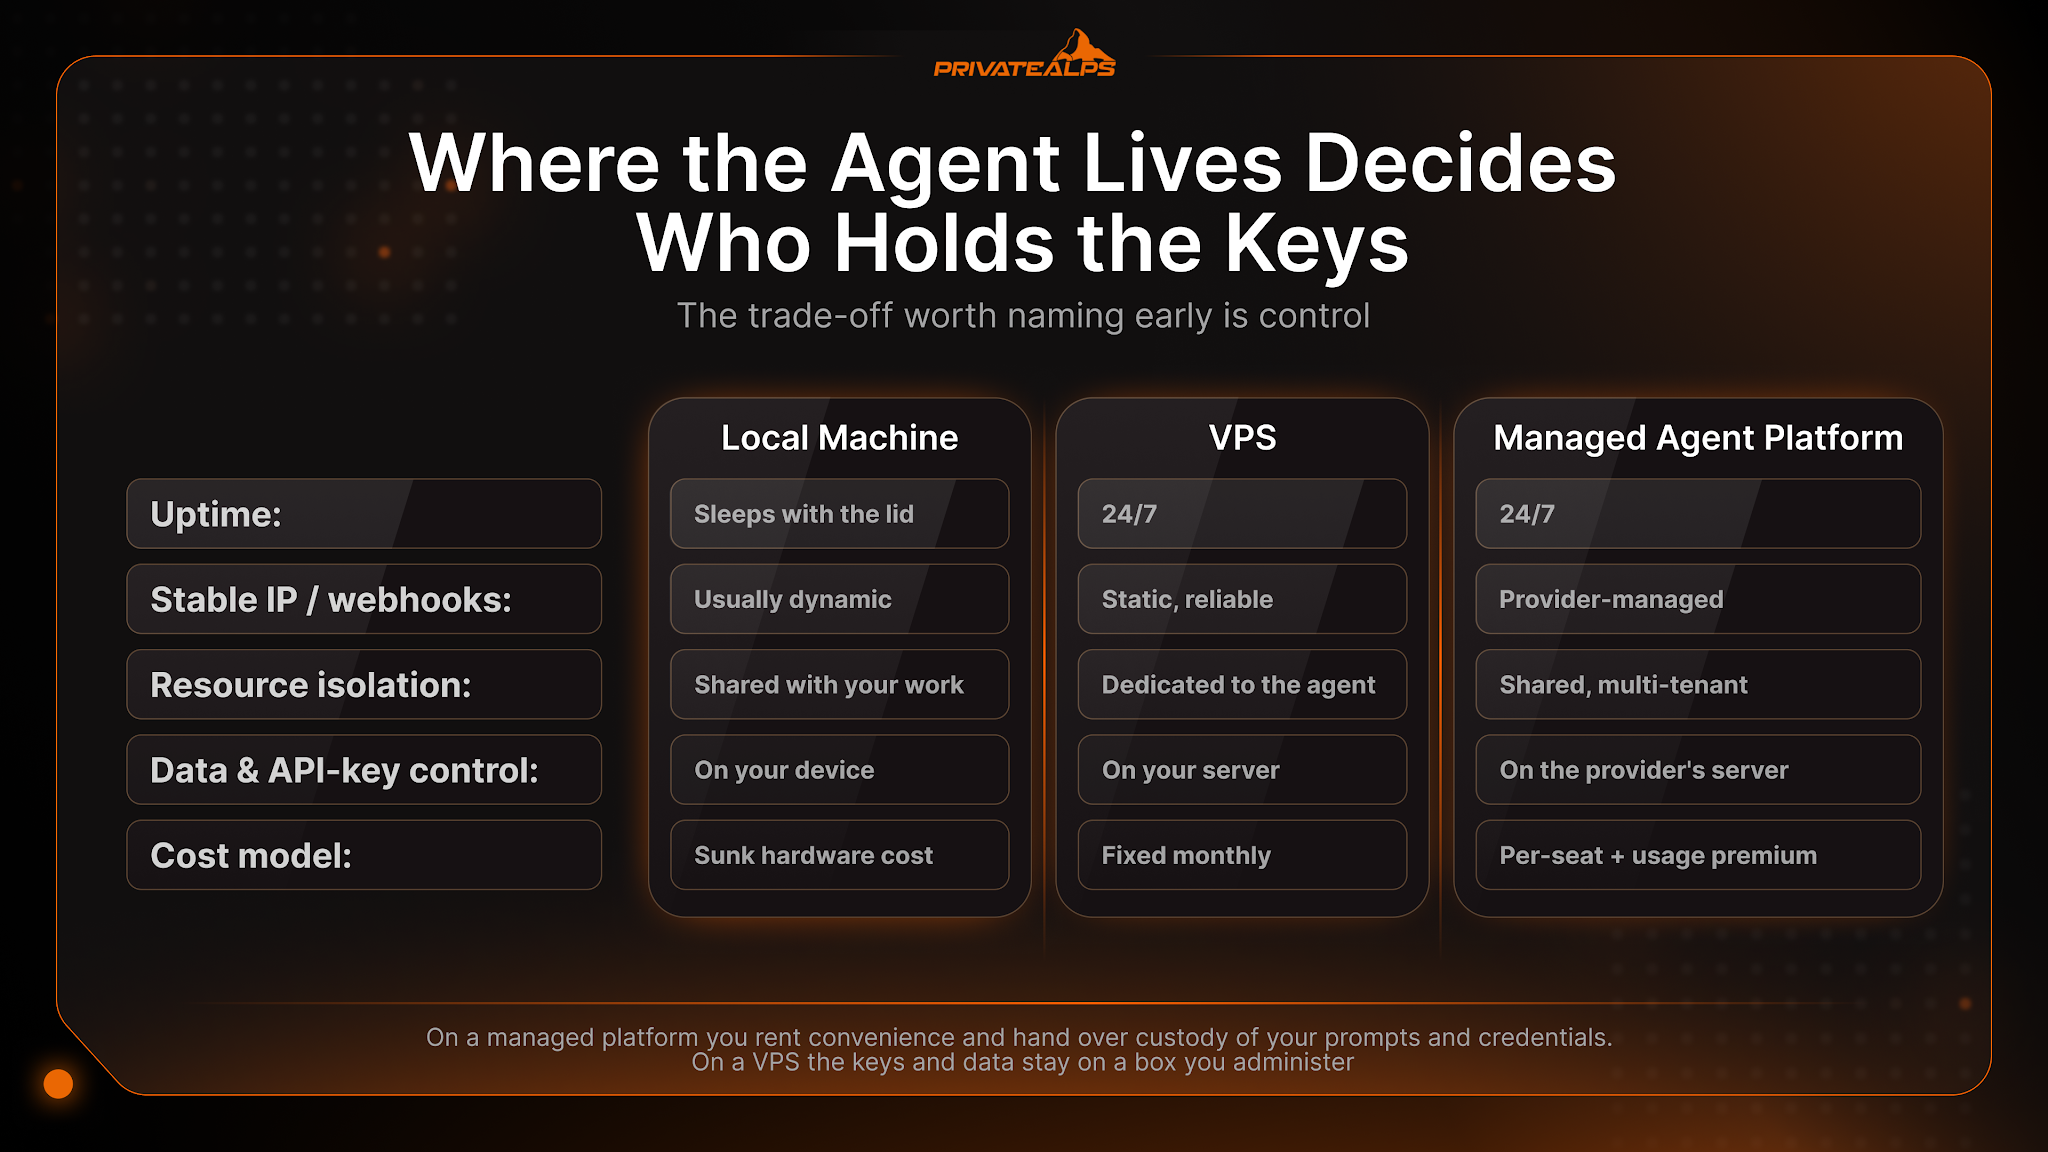
الـVPS هو الحل العملي بين اللابتوب والمنصة المُدارة بالكامل. اللابتوب بينام، وبيخلّص البطارية، وموجود على شبكتك الشخصية. المنصة المُدارة مريحة، لكن الـkeys والبيانات وسجل المحادثات بتاعتك بتعيش على سيرفر حد تاني. الـVPS بيديك تشغيل 24/7 وموارد مخصصة، وفي نفس الوقت بيخليك متحكم في الجهاز.
| العامل | جهاز محلي | VPS | منصة agents مُدارة |
|---|---|---|---|
| التشغيل المستمر | بينام لما تقفل الغطا | 24/7 | 24/7 |
| IP ثابت / webhooks | عادةً متغير | ثابت وموثوق | بيديره المزوّد |
| عزل الموارد | مشترك مع شغلك | مخصص للـagent | مشترك، multi-tenant |
| التحكم في البيانات والـAPI keys | على جهازك | على سيرفرك | على سيرفر المزوّد |
| مجهود الإعداد | قليل | متوسط | الأقل |
| نموذج التكلفة | تكلفة هاردوير اتدفعت خلاص | شهري ثابت | لكل مستخدم + رسوم استخدام |
| قابلية التوسع | محدودة باللابتوب | توسيع الـCPU/الرام/التخزين | بيتوسّع، بشروطهم |
الـtrade-off اللي يستاهل نقوله من الأول هو التحكم. في المنصة المُدارة إنت بتدفع مقابل الراحة، وبتسلّم حضانة الـprompts والاعتمادات بتاعتك. في الـVPS إنت بتعمل الإعداد بنفسك، بس الـkeys والبيانات بتفضل على جهاز إنت بتديره، ولو الـagent اتعمله prompt injection، الضرر بيفضل محصور في الـinstance ده ومايتوزعش على خدمة مشتركة.
تشغّل إيه؟ AI Agents، وفريموركات، وأحمال شغل
تقريباً أي AI agent مبني على Linux بيشتغل على VPS. أحسن طريقة لتصنيفهم هي حسب مكان تشغيل الموديل، يعني من خلال API خارجي ولا محلياً على الجهاز، وحسب نوع الشغل. كلهم بيتركّبوا على VPS Linux عادي.
في جيلين يستاهلوا التفريق بينهم. الـAutoGPT كان أول agent مستقل انتشر بشكل كبير، وأحسن تعامل معاه إنه الجيل الأول، مش الافتراضي الحالي. أما CrewAI وLangChain فهما فريموركات ناضجة. موجة 2026، واللي فيها OpenClaw وHermes Agent وClaude Code، بتشتغل كخدمات مستمرة self-hosted. ولاحظ إن Claude Code بيعمل authentication بحساب Anthropic بتاعك، وبيكلّم الموديل من خلال Anthropic API؛ ومش تسجيل دخول استهلاكي مشترك.
| الأداة | إيه هي (الجيل) | مكان الموديل | الاستخدام الشائع |
|---|---|---|---|
| OpenClaw | daemon لـagent شخصي self-hosted (موجة 2026) | API أو محلي | مساعد شغال دايماً، رسايل، مراقبة |
| Hermes Agent | agent مستقل self-hosted من Nous Research (موجة 2026) | API أو محلي | مهام مستمرة، skills بيبنيها بنفسه |
| Claude Code | coding agent على الـterminal، بحساب Anthropic API خاص بيك (موجة 2026) | API (بعيد) | قراءة وكتابة الكود، أتمتة الـrepo |
| CrewAI | فريموورك تنسيق multi-agent (معروف ومستقر) | API أو محلي | فرق agents بأدوار محددة |
| LangChain | فريموورك لتطبيقات الـagent/LLM (معروف ومستقر) | API أو محلي | pipelines مخصصة، ربط الأدوات ببعض |
| AutoGPT | agent مستقل انتشر بسرعة في الأول (الجيل الأول) | API أو محلي | تجارب، مشاريع قديمة |
| Cline / Aider / Continue | coding agents ومساعدين للكود | API أو محلي | مهام كود جوه الـeditor والـCLI |
| n8n | أتمتة workflows فيها nodes للـAI | API أو محلي | أتمتة بتتشغل بـwebhooks |
| Ollama | runtime لتشغيل الموديلات محلياً | محلي | تشغيل موديلات مفتوحة على الجهاز |
أحمال الشغل الشائعة اللي الأدوات دي بتشيلها:
- مراقبة المنافسين والأسعار
- scraping واستخراج بيانات منظمة
- مساعدين رسايل على Telegram أو Slack أو Discord
- coding agents بتقرا وتكتب في الـrepo بتاعك
- أتمتة مجدولة و listeners للـwebhooks
- معالجة مستندات محلياً واستعلامات RAG
كل أداة هنا بيتديلها وصول حقيقي للنظام: shell وملفات وAPI keys، وده السبب إن مكان تشغيلها مش تفصيلة جانبية.
Agents بتعتمد على API ولا موديل محلي: القرار اللي بيحدد المواصفات
كود الـagent نفسه خفيف. اللي بيخلي السيرفر كبير أو صغير هو مكان تشغيل الـlanguage model. مع agent بيعتمد على API، الـinference بيحصل على infrastructure المزوّد، فالسيرفر بتاعك بيعمل orchestration للـcalls بس. ومع agent بموديل محلي، الموديل بيشتغل على هاردوير إنت مالكه، والقيد بيتحول من تكلفة الـtokens لذاكرة الـGPU.
| البُعد | agent بيعتمد على API | agent بموديل محلي |
|---|---|---|
| مكان تشغيل الـinference | سيرفرات المزوّد | VPS بتاعك / GPU |
| احتياج الـCPU | منخفض لمتوسط | عالي (أو بيتنقل للـGPU) |
| احتياج الرام | 2-4 GB لـagent واحد | 16-32 GB رام للسيستم (الـVRAM هو الحد الحقيقي) |
| احتياج الـGPU | مش مطلوب | مطلوب، والـVRAM بيحدد السقف (شوف قسم الـGPU) |
| التخزين | صغير (logs، dependencies) | كبير (أوزان الموديل) |
| نموذج التكلفة | سيرفر قليل التكلفة + لكل token | هاردوير غالي + تكلفة لكل token شبه صفر |
| مكان بيانات الـprompts | بتروح للمزوّد بتاع الموديل | بتفضل على سيرفرك |
«بيعتمد على API» مش معناها «حمل صفر». حتى مع الـinference البعيد، الـCPU والرام بيتضغطوا أثناء تحليل المستندات، وتقطيع النص، وحساب الـembeddings محلياً، واستعلامات قاعدة بيانات المتجهات، وده كله الأجزاء اللي بتشتغل على جهازك جوه الـRAG pipeline. وزاوية التحكم واضحة هنا كمان: الـagent اللي بيعتمد على API بيبعت بيانات الـprompts بتاعتك لمزوّد طرف تالت، أما الموديل المحلي فبيخلي كل token يفضل على السيرفر. وتشغيل موديل محلياً من خلال runtime زي Ollama هو اللي بيحافظ على البيانات دي جوه بيتك.
إزاي تختار مواصفات السيرفر: CPU ورام وتخزين وباندويدث
اختار حجم الـVPS حسب مستوى الشغل، مش حسب الضجة. الـagent الواحد اللي بيعتمد على API بيشتغل على instance صغير. لو ضفت Docker وقاعدة بيانات وكذا agent، الرام والتخزين NVMe بيبقوا هم العوامل المحدِّدة. تشغيل الموديل محلياً فئة مختلفة خالص ومحتاج GPU. ابدأ صغير، وتقدر توسّع الـCPU والرام والتخزين مع زيادة الشغل.
| مستوى الشغل | vCPU | الرام | التخزين | GPU؟ | أمثلة agents |
|---|---|---|---|---|---|
| agent واحد بيعتمد على API | 1-2 | 2-4 GB | 20-40 GB NVMe | لا | agent واحد من OpenClaw / Hermes |
| agents متعددة + Docker + قاعدة بيانات متجهات | 4 | 8-16 GB | 80 GB+ NVMe | لا | كذا agent، RAG pipeline |
| أتمتة تقيلة (n8n + معالجة محلية) | 4-8 | 16 GB+ | 100 GB+ NVMe | اختياري | workflow + أسطول scraping |
| تشغيل LLM محلي | 8+ | 16-32 GB | 100 GB+ NVMe | أيوه (VRAM) | Ollama / vLLM بيقدم موديل |
كل عامل من دول مرتبط باحتياج حقيقي. الرام بيشيل حالة الـagent وأي قاعدة بيانات محلية أو vector store؛ وتخزين NVMe بيسرّع استعلامات المتجهات والـlogs وكاش الـdependencies؛ والباندويدث مهم للـscraping والـstreaming؛ والـCPU المخصص، مش المشترك، بيشيل تأثير الجيران المزعجين اللي بيزوّد الـlatency في loop مراقبة محكم. ولأن المتطلبات دي بتتغير بسرعة، قيّس على الوثايق الحالية للفريموورك، وبعدين ابدأ بـVPS Linux بـNVMe متواضع وبعدين وسّعه. الاختيار الأول مش قفل عليك.
محتاج GPU عشان تشغّل AI Agent؟
لأ، مش محتاج للـagents اللي بتعتمد على API، لأن الموديل بيشتغل على infrastructure المزوّد. الـGPU مطلوب بس لو إنت بتستضيف الموديل محلياً بـruntime زي Ollama أو vLLM أو llama.cpp. هنا الـVRAM هو العامل المحدِّد، وبيزيد مع حجم الموديل وطول الـcontext.
قاعدة تقريبية للـinference المحلي: قدّر الـVRAM بالمعادلة (عدد البارامترات × bits لكل weight) ÷ 8. موديل 7B بـquantization على 4-bit محتاج تقريباً 4-6 GB من الـVRAM، وموديل 70B محتاج حوالي 38-48 GB. الموديلات الصغيرة المكمّاة ممكن تشتغل بالـCPU بس، لكن ببطء، وغالباً بأقل من عشرة tokens في الثانية، فـسيرفر GPU مخصص فيه دعم NVIDIA CUDA هو الاختيار العملي لـinference محلي سريع الاستجابة.
إزاي تختار مزود VPS لتشغيل AI Agent
بعد ما تحدد المواصفات، اختيار الاستضافة بيتلخص في كام معيار مهم تحديدًا لأي Agent شغال طول الوقت وماسك بيانات الدخول وصلاحيات الأدوات. الموارد المخصصة، والـ root access، وسرعة النشر، والـ snapshots، والتشفير، والدولة اللي السيرفر فيها، كل واحد منهم له وزن مختلف للـ Agent عن الموقع الثابت.
| المعيار | ليه يهم في AI Agent | إيه اللي تتأكد منه |
|---|---|---|
| CPU/RAM مخصص ولا مشترك | استقرار في زمن الاستجابة للمراقبة وأحمال الـ loops | هل الـ cores والـ RAM مضمونين، ولا "حصة عادلة" بين المستخدمين |
| Root access | تقدر تنزل أي framework أو container runtime أو موديل محلي | root كامل، مش لوحة تحكم مقيدة |
| سرعة النشر | تشغّل وتجرّب بسرعة | قد إيه الوقت اللي بياخده تجهيز VPS instance |
| Snapshots / backups | ترجع لنسخة قبل أي تغيير خطر للـ Agent | عدد مرات الـ snapshot وطريقة الاسترجاع |
| تشفير الديسك بالكامل | حماية المفاتيح والبيانات وهي متخزنة | هل التشفير متاح (مثلًا KVM) |
| Console / IPMI access | تسترجع instance اتقفل أو اتضبط غلط | هل الـ console متاح من غير ما تحتاج الـ OS شغال |
| الباندويدث والشبكة | الـ Agents اللي بتعمل scraping أو streaming بتنقل بيانات كتير | حدود الترافيك وسياسة البورتات |
| الاختصاص القضائي والخصوصية | الـ Agent بيعالج بياناتك ومفاتيحك | مكان السيرفر، وسياسة التسجيل وتسجيل الأنشطة (logging) |
الصف الأخير يستاهل تركيز خاص. لأن الـ Agent بيعالج بيانات المشغّل وبيانات دخوله، فالبلد اللي فيها السيرفر وإيه اللي الاستضافة بتسجله بيبقوا جزء من أمانك، مش حاجة تيجي في الآخر. اقرا سياسة الاختصاص القضائي وشروط التسجيل وسياسة الـ logging كويس قبل ما تسلّم عملية أوتوماتيك مفاتيحك.
إزاي تشغّل Agent على VPS: Docker والمستخدمين والعزل
شغّل الـ Agent جوه container بمستخدم مخصص غير root، مش على الجهاز الأساسي كـ root. الـ containerization بيخلّي الإعداد قابل للتكرار وبيضيف طبقة عزل، والمستخدم غير المميز بيحدد الحاجات اللي الـ Agent المخترَق يقدر يوصلها. الـ process manager بيخليه شغال بعد أي restart، والـ snapshots بتخليك ترجع من أي تغيير غلط.
- اعمل container للـ Agent باستخدام Docker عشان يتكرر الإعداد ويكون معزول.
- اعمل مستخدم مخصص غير root وشغّل الـ Agent بيه.
- استخدم process manager (systemd أو pm2) عشان يعيد التشغيل تلقائيًا بعد الـ reboot.
- خلّي الذاكرة والـ logs والإعدادات على تخزين دائم.
- خزّن API keys برّه الكود، في ملف environment مقيد.
- اعمل snapshot للسيرفر قبل أي تغيير كبير.
العزل هو الهدف الأساسي من التصميم ده. لو الـ Agent اتعمله prompt injection أو شغّل skill خبيثة، الـ containment بيحبس الضرر جوه الـ container ومايوصلش للجهاز الأساسي ولا للشبكة الأوسع. ده الفرق بين حادثة اتحاوطت وسيرفر اتخترق.
الأمان والخصوصية: احتواء Agent أوتوماتيك
الـ Agent اللي عنده صلاحيات shell وملفات وAPIs ومراسلة بيفتح سطح هجوم أكبر، فالـ least privilege والعزل إلزاميين مش اختياريين. OWASP Top 10 for LLM Applications بيصنّف الـ prompt injection والـ excessive agency ضمن أكبر المخاطر لنفس السبب ده: الـ Agent ممكن يتخدع ويستخدم الصلاحيات اللي إنت إديتهاله بطريقة غلط.
- خزّن API keys في ملف environment مقيد، ومتحطهاش في الكود أبدًا.
- شغّل الـ Agent بمستخدم غير root جوه container.
- قيّد الترافيك الخارج بـ whitelist عشان الـ Agent المخترَق ميقدرش يوصل لأي host عشوائي.
- حدد كل API key بأقل حاجة محتاجها.
- سجّل كل حاجة عشان تقدر تراجعها بعد أي حادثة.
- استخدم أدوات observability مفتوحة المصدر (مثلًا Langfuse) عشان بيانات الـ trace تفضل على سيرفرك.
على منصة managed، الـ prompts والمفاتيح وسجل المحادثات بتبقى على بنية تحتية لطرف تالت. الـ self-hosting بيخليهم تحت تحكم المشغّل، ولما يبقوا على سيرفرك، الاختصاص القضائي للسيرفر والتشفير على الديسك وإذا كان التسجيل طلب هويتك كلها بتبقى جزء من صورة الخصوصية. مش ده تخويف، ده ببساطة سطح الهجوم اللي بتتحمله لما برنامج يشتغل نيابة عنك.
التكلفة: تشغيل ذاتي على VPS ولا منصات Agent مُدارة
الـ VPS تكلفة شهرية ثابتة ومتوقعة وإنت متحكم فيها بالكامل. المنصات المُدارة بتضيف رسوم على الراحة وبتخلّي بياناتك برّه السيرفر. ولوحدها، استخدام الموديل، يعني الـ API tokens، بند تكلفة مستقل عن السيرفر. الـ Agents اللي بتعتمد على API بتجمع بين تكلفة سيرفر منخفضة وتكلفة tokens متغيرة، أما الـ Agents اللي بتشغّل موديل محلي فبتبادل الـ tokens بتكلفة عتاد أعلى.
الفرق الحقيقي بيتحدد بحجم الاستخدام. الإعداد المعتمد على API بيخلّي تكلفة السيرفر قليلة لكن بيضيف فاتورة بالـ token بتكبر مع الاستخدام. الإعداد بموديل محلي بيحتاج تكلفة عتاد ثابتة أعلى (كارت GPU) لكن تكلفة الـ token الإضافية تقريبًا صفر، وده بيكسب بس مع حجم استخدام مستمر وعالي. المنصات المُدارة ليها تكاليف مخفية هي كمان، زي رسوم الـ seats والـ token markup والـ lock-in اللي بيبقى مكلف لما تحب تخرج منه.
| الإعداد | تكلفة السيرفر | تكلفة الموديل | الأنسب لـ |
|---|---|---|---|
| API على VPS | قليلة وثابتة | متغيرة حسب الـ token | معظم الـ Agents، والأحمال المتقطعة |
| موديل محلي على سيرفر GPU | أعلى وثابتة | ~صفر لكل token | حجم عالي ومستمر |
| منصة Agent مُدارة | مضمّنة في الباقة | بسعر مضاعف + رسوم لكل seat | أسرع بداية، وأقل تحكم |
الخلاصة: اختار السيرفر على حسب الـ Agent
الـ Agent الواحد المعتمد على API بيحتاج VPS صغير بس، والـ Agents المتعددة أو الكتيرة على Docker محتاجة RAM أكتر وNVMe، والـ local inference محتاج سيرفر GPU، والإعدادات اللي الخصوصية أو العزل فيها حاجة أساسية لازم تكون على عتاد مخصص لمستأجر واحد. مفيش سيرفر أفضل واحد لكل الحالات، في بس السيرفر اللي يناسب مكان الموديل وحجم الشغل واحتياجات الخصوصية عندك. حدد الأول الموديل هيشتغل فين، وبعدين حجم السيرفر، وبعدين اختار استضافة تثق فيها بالمفاتيح بتاعتك.
PrivateAlps بتغطي كل نوع Agent على الطيف اللي فوق. للـ API-based agents، VPS من NVMe Linux بيقدم root access كامل وCPU وRAM مخصصين وتجهيز سريع. أما لاستنتاج الموديلات المحلية، فالـ GPU dedicated servers بتشغّل عتاد NVIDIA A100/H100 (حسب التوفر) مع دعم CUDA. ولو محتاج توسّع أو عزل أو تشغّل الـ hypervisor بتاعك، فـالسيرفرات المخصصة bare-metal لمستأجر واحد بتقدم CPU وRAM مخصصين (مش مشتركين) وتشفير الديسك بالكامل عن طريق KVM، ووصول IPMI/console، وخيارات دفع مجهولة (من غير KYC) تحت الاختصاص القضائي السويسري offshore. السيرفرات المخصصة والـ GPU اللي بتتجهز حسب الطلب ممكن تاخد وقت، أما الـ VPS فبيتنشر بسرعة. شوف الرينج الكامل على privatealps.net.
الأسئلة الشائعة
AI Agent هو إيه؟
الـ AI Agent برنامج أوتوماتيك بيخطط وينفّذ مهام متعددة الخطوات باستخدام أدوات، من غير ما إنسان يوافق على كل خطوة. ده بيفرّقه عن الـ chatbot اللي بيرد بس لما تكتبله. الـ Agent بيقرر، ويتصرف، ويراجع النتيجة، ويكمل نحو هدفه لوحده.
أقدر أشغّل AI Agent على VPS؟
أيوه، الـ VPS هو المكان القياسي لتشغيله. بيديه تشغيل 24/7، وIP ثابت للـ webhooks، وعزل عن جهازك الشخصي. ولأي حاجة أبعد من التجربة البسيطة، السيرفر هو المكان الصح.
الـ AI Agent محتاج كام RAM؟
الـ Agent الواحد المعتمد على API بيشتغل على حوالي 2-4 GB RAM. لما تضيف Docker أو قاعدة بيانات أو كذا Agent، خطط لـ 8-16 GB. الموديل اللغوي المحلي محتاج أكتر بكتير، 16 GB على الأقل، و32 GB أو أكتر للموديلات الكبيرة.
محتاج GPU عشان أشغّل AI Agent؟
لأ، مش للـ Agents المعتمدة على API، لأن الموديل بيشتغل على بنية الـ provider التحتية، فالـ GPU عندهم. انت محتاج GPU بس لو هتستضيف الموديل اللغوي محليًا. في الحالة دي، الـ VRAM هو العامل المحدد.
أنهي AI Agents تقدر تشتغل على VPS؟
معظم الـ Agents اللي شغالة على Linux بتشتغل على VPS. المجموعة الحالية بتشمل OpenClaw وHermes Agent وClaude Code، جنب frameworks معروفة زي CrewAI وLangChain وn8n. كلهم بيتنزلوا على Linux instance عادي.
أنهي مواصفات سيرفر محتاجها لـ AI Agent؟
لـ Agent واحد معتمد على API، فئة البداية 1-2 vCPU و2-4 GB RAM تكفي. للـ Agents المتعددة أو المتحوّلة لـ containers ومعاها vector database، اطلع لحوالي 4 vCPU و8-16 GB RAM وتخزين NVMe. الـ local inference محتاج GPU فوق ده.
هل آمن أشغّل Agent أوتوماتيك على سيرفر؟
أيوه، مع عزل مظبوط. شغّله جوه container بمستخدم غير root، وقيّد الترافيك الخارج بـ whitelist، وحدد كل API key بأقل حاجة محتاجها، وسجّل كل حاجة. الضوابط دي بتحبس أي Agent مخترق أو اتخدع بـ prompt injection.
أشغّل الـ Agent على VPS ولا على جهازي؟
استخدم VPS لأي حاجة أبعد من التجربة البسيطة. الجهاز المحلي بينام وبيستهلك موارده، وبيعرّض بياناتك الشخصية وشبكتك لأي حاجة الـ Agent بيعملها. السيرفر بيفضل شغال، ومعزول، وبيبعد الـ Agent عن جهازك اليومي.
أقدر أستضيف الموديل اللغوي على سيرفري كمان، ولا الـ Agent بس؟
الاتنين ينفعوا يتستضافوا بنفسك. تقدر تشغّل الـ Agent والموديل مع بعض باستخدام runtime زي Ollama أو vLLM. المشكلة إن الموديل المحلي محتاج GPU فيه VRAM كفاية، أو CPU مخصص معتبر، عشان يفضل سريع في الرد.
تكلفة تشغيل AI Agent على VPS قد إيه؟
السيرفر تكلفة شهرية ثابتة وإنت متحكم فيها. الـ Agents المعتمدة على API بتضيف فوقها فاتورة tokens متغيرة بتكبر مع الاستخدام. إعدادات الموديل المحلي بتبادل تكلفة الـ tokens بتكلفة عتاد أعلى في الأول، أساسًا GPU.
