


ما هو التخزين الموزع (Distributed Storage)؟
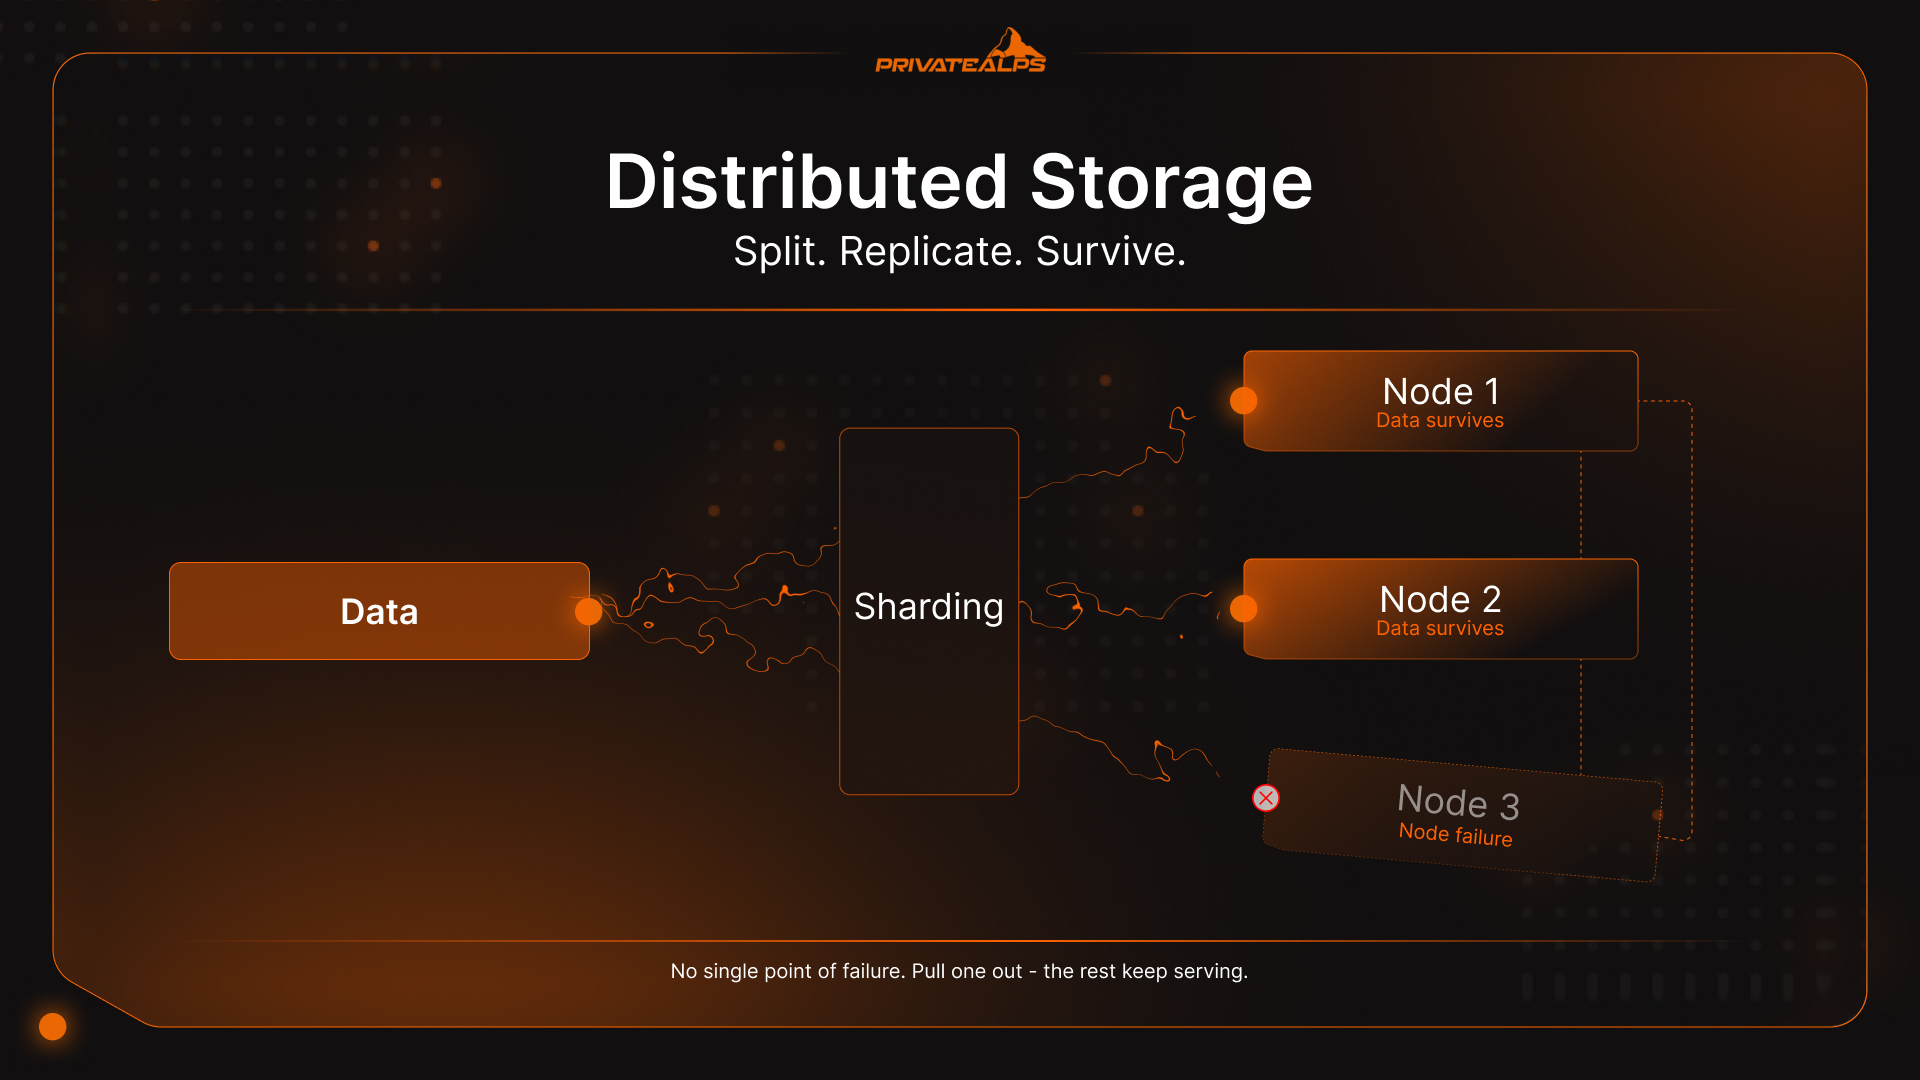
التخزين الموزع هو الطريقة اللي بتتعامل بيها البنية التحتية الحديثة مع بيانات كبيرة جدًا، أو حساسة جدًا، أو بتتطلب وصول متكرر بدرجة تخلي جهاز واحد مش قادر يحتفظ بيها بشكل موثوق. بدل ما يتكتب كل حاجة على سيرفر واحد، النظام بيقسّم البيانات أو بيكرّرها أو بيشفّرها على عدة نودات مستقلة، سيرفرات أو درايفات أو مراكز بيانات. النودات دي بتشتغل مع بعض، بس مفيش نود واحدة فيها كل البيانات. لو شلت واحدة، الباقي يفضل شغال. الدليل ده بيشرح إزاي أنظمة التخزين الموزع بتتصرف فعليًا تحت الضغط، وإيه التوازنات المعمارية اللي بتفرضها، وأنهي نوع تخزين يناسب كل نوع شغل.
ملخص بالذكاء الاصطناعي
التخزين الموزع معمارية برمجية معرّفة بالسوفتوير، بتقسّم البيانات على عدة نودات فعلية باستخدام ثلاث تقنيات أساسية: التقسيم إلى شاردات (sharding، يعني تقسيم البيانات لأجزاء منفصلة بتتوجّه لنودات مختلفة)، والنسخ المتماثل (replication، يعني الاحتفاظ بنسخ متطابقة متعددة على نودات مختلفة عشان الوصول يكون سريع)، وترميز المحو (erasure coding، يعني تشفير البيانات لأجزاء فيها تكافؤ رياضي بحيث أي مجموعة فرعية منها تقدر تعيد بناء الكل).
فيه ثلاثة أنواع رئيسية لأنظمة التخزين الموزع: تخزين الكائنات (object storage، فضاء أسماء مسطح وواجهة برمجية متوافقة مع S3)، وتخزين الكتل (block storage، أحجام ثابتة لعمليات I/O عشوائية منخفضة الزمن)، وتخزين الملفات (file storage، فضاء أسماء هرمي عن طريق NFS أو SMB). وكل إعداد تخزين بيانات موزع بيواجه نظرية CAP، وده معناه إنه ممكن يضمن اتنين بس من الثلاثة: الاتساق، والتوفر، وتحمل التقسيم، وده في نفس الوقت.
الفايدة التشغيلية الأساسية إن عطل نود مش بيسبب انقطاع؛ النظام بيوجّه الطلبات للنسخ الباقية تلقائيًا. وحجم الموضوع ده كبير: البشرية بتنتج أكتر من 400 مليون تيرابايت من البيانات الجديدة كل يوم، وده حجم معمارية مركزية ما تقدرش تستوعبه من غير ما تنهار في الآخر تحت وزنها.
التخزين الموزع مقابل التخزين المركزي
التخزين المركزي بيحط كل حاجة في مكان واحد: سيرفر واحد، أو SAN واحد، أو مركز بيانات واحد. ده النموذج كله. ولما المكان ده يتعب، كل حاجة بتقف. التخزين الموزع بيعالج الموضوع ده مباشرةً: البيانات موجودة على عدة نودات مستقلة، فمفيش نقطة فشل واحدة تقدر توقف النظام كله أو تمنع الوصول للكل.
عطل واحد في الهاردوير، والوصول يقف. خلاص كده. التوسّع معناه ترقية أو استبدال النظام الأساسي، وده عادةً بيعني توقف عن الخدمة ونقاش عن مصاريف رأسمالية محدش عايز يدخله. التخزين الموزع بيتفادى الاتنين بالتصميم: تضيف نود عشان تكبر، ولما نود تقع، الكلستر بيتفادى عليها. مفيش مشكلة ولا انقطاع. البيانات كانت موجودة على أكتر من نود قبل ما أي حاجة تتكسر.
| البُعد | التخزين المركزي | التخزين الموزع |
|---|---|---|
| تحمل الأعطال | نقطة فشل واحدة | البيانات بتفضل سليمة لو نود اتشالت |
| قابلية التوسع | رأسي (ترقية الهاردوير) | أفقي (إضافة نودات) |
| زمن الاستجابة (Latency) | منخفض للوصول المحلي | متغير؛ بيعتمد على طوبولوجيا الشبكة |
| التكلفة عند الحجم الصغير | تكلفة مبدئية أقل | أدنى كلستر قابل للتشغيل أعلى |
| التكلفة عند الحجم الكبير | مكلف في التوسع | الهاردوير التجاري بيقلل التكلفة |
| التوزيع الجغرافي | موقع واحد | متعدد المناطق حسب الإعداد |
| التعقيد التشغيلي | سهل في الإدارة | محتاج أدوات تنسيق (orchestration) |
إزاي أنظمة التخزين الموزع بتشتغل
نظام التخزين الموزع بياخد البيانات الداخلة، ويقسّمها لأجزاء، ويوجّه الأجزاء دي للنودات الصح في الكلستر، ويتابع كل قطعة من خلال طبقة الميتاداتا. كده أي جزء يقدر يتحدد مكانه ويتسحب ويتجمع تاني عند الطلب، بغض النظر عن النود اللي شايلاه. دي الحلقة الأساسية. وفيه أربع آليات بتشغّلها:
- التقسيم إلى شاردات (تقسيم البيانات) لما البيانات توصل، النظام بيقطعها لقطع أصغر، شاردات أو بلوكات، ويوزّعها على النودات. ده اللي بيفتح باب الـ I/O المتوازي: كذا نود بتتعامل مع القراءة والكتابة في نفس الوقت، فالإنتاجية بتكبر مع حجم الكلستر بدل ما تقف عند سقف جهاز واحد. ومنطق التوجيه عادةً بيكون consistent hashing، وده بيخلي التوزيع متوازن مع كبر الكلستر من غير ما يتعاد ترتيب كل حاجة كل ما نود تتضاف.
- النسخ المتماثل (Replication) الطريقة الفجة بس الفعّالة: تخزّن N نسخة متطابقة من كل شارد على نودات منفصلة، عادةً تلاتة. لو نود وقعت، الاتنين التانيين يفضلوا يخدموا فورًا. مفيش إعادة بناء ولا انتظار. النسخ المتماثل هو الاختيار الصح للـ البيانات الساخنة (hot data)، زي قواعد البيانات النشطة، والـ feeds اللحظية، وأي حاجة فيها ميلي ثانية زيادة في القراءة بتكلفك فعلًا.
- ترميز المحو (Erasure Coding) هنا بتبقى حسابات كفاءة التخزين مثيرة. بدل تلات نسخ كاملة، النظام بيشفّر الكائن لـ $k$ جزء بيانات زائد $m$ جزء تكافؤ (parity)، ويوزّع الـ $k+m$ كلهم على النودات، ويقدر يعيد بناء الكائن الكامل من أي $k$ منهم. يعني $m$ نود ممكن تقع في نفس الوقت من غير ما أي حاجة تضيع. إعداد Reed-Solomon RS(6,3) بيخزّن 9 بلوكات بدل الـ 18 اللي بيحتاجها النسخ الثلاثي 3x، وبيقلل المساحة الزيادة في التخزين الخام من 200% لحوالي 50%. الحتة الصعبة إن عملية التشفير وفك التشفير بتستهلك دورات CPU، وترميز المحو بيشتغل أحسن مع البيانات الباردة، يعني المحتوى اللي نادرًا ما بيتعدّل أو بيتوصل له بتكرار عالي. للأحمال اللي فيها كتابات صغيرة متكررة، النسخ الثلاثي لسه بيكسب في زمن الاستجابة.
| طريقة الحماية | الزيادة في التخزين | الأنسب لـ | التوازن (Trade-Off) |
|---|---|---|---|
| النسخ الثلاثي 3x | 3x من السعة الخام | البيانات الساخنة، أحمال زمن استجابة منخفض | تكلفة تخزين عالية عند الحجم الكبير |
| ترميز المحو RS(6,3) | 1.5x من السعة الخام | البيانات الباردة، الأرشفة، الكائنات الكبيرة | زيادة في الـ CPU، وزمن إعادة بناء أعلى |
- توجيه الميتاداتا (Metadata Routing) كل نظام تخزين موزع بيحتفظ بطبقة ميتاداتا، وهي بشكل أساسي خريطة بتقول أي شارد موجود على أنهي نود. لما عميل يطلب بيانات، خدمة الميتاداتا بتحدد النودات الصح، والنظام بيسحب الأجزاء ويجمعها من غير ما العميل يشوف التعقيد أصلًا. في الكلسترات الكبيرة زي Ceph أو HDFS، طبقة الميتاداتا نفسها موزّعة على نودات. لازم تكون كده. سيرفر ميتاداتا واحد هيبقى هو الاختناق اللي كنت بتحاول تهرب منه.
أنواع أنظمة التخزين الموزع
التخزين الموزع مش حاجة واحدة. ده تصنيف فيه تلات نماذج بيانات مختلفة تحته، واختيار النموذج الغلط لشغل معين غلطة شائعة ومكلفة بشكل مفاجئ. تخزين الكائنات وتخزين الكتل وتخزين الملفات كل واحد فيهم بيحل مشكلة مختلفة. وقواعد البيانات الموزعة، زي Cassandra وCockroachDB وGoogle Spanner، بتمثل نوع رابع، بتضيف دلالات الاستعلام فوق إدارة البيانات الموزعة، بس ده نقاش منفصل.
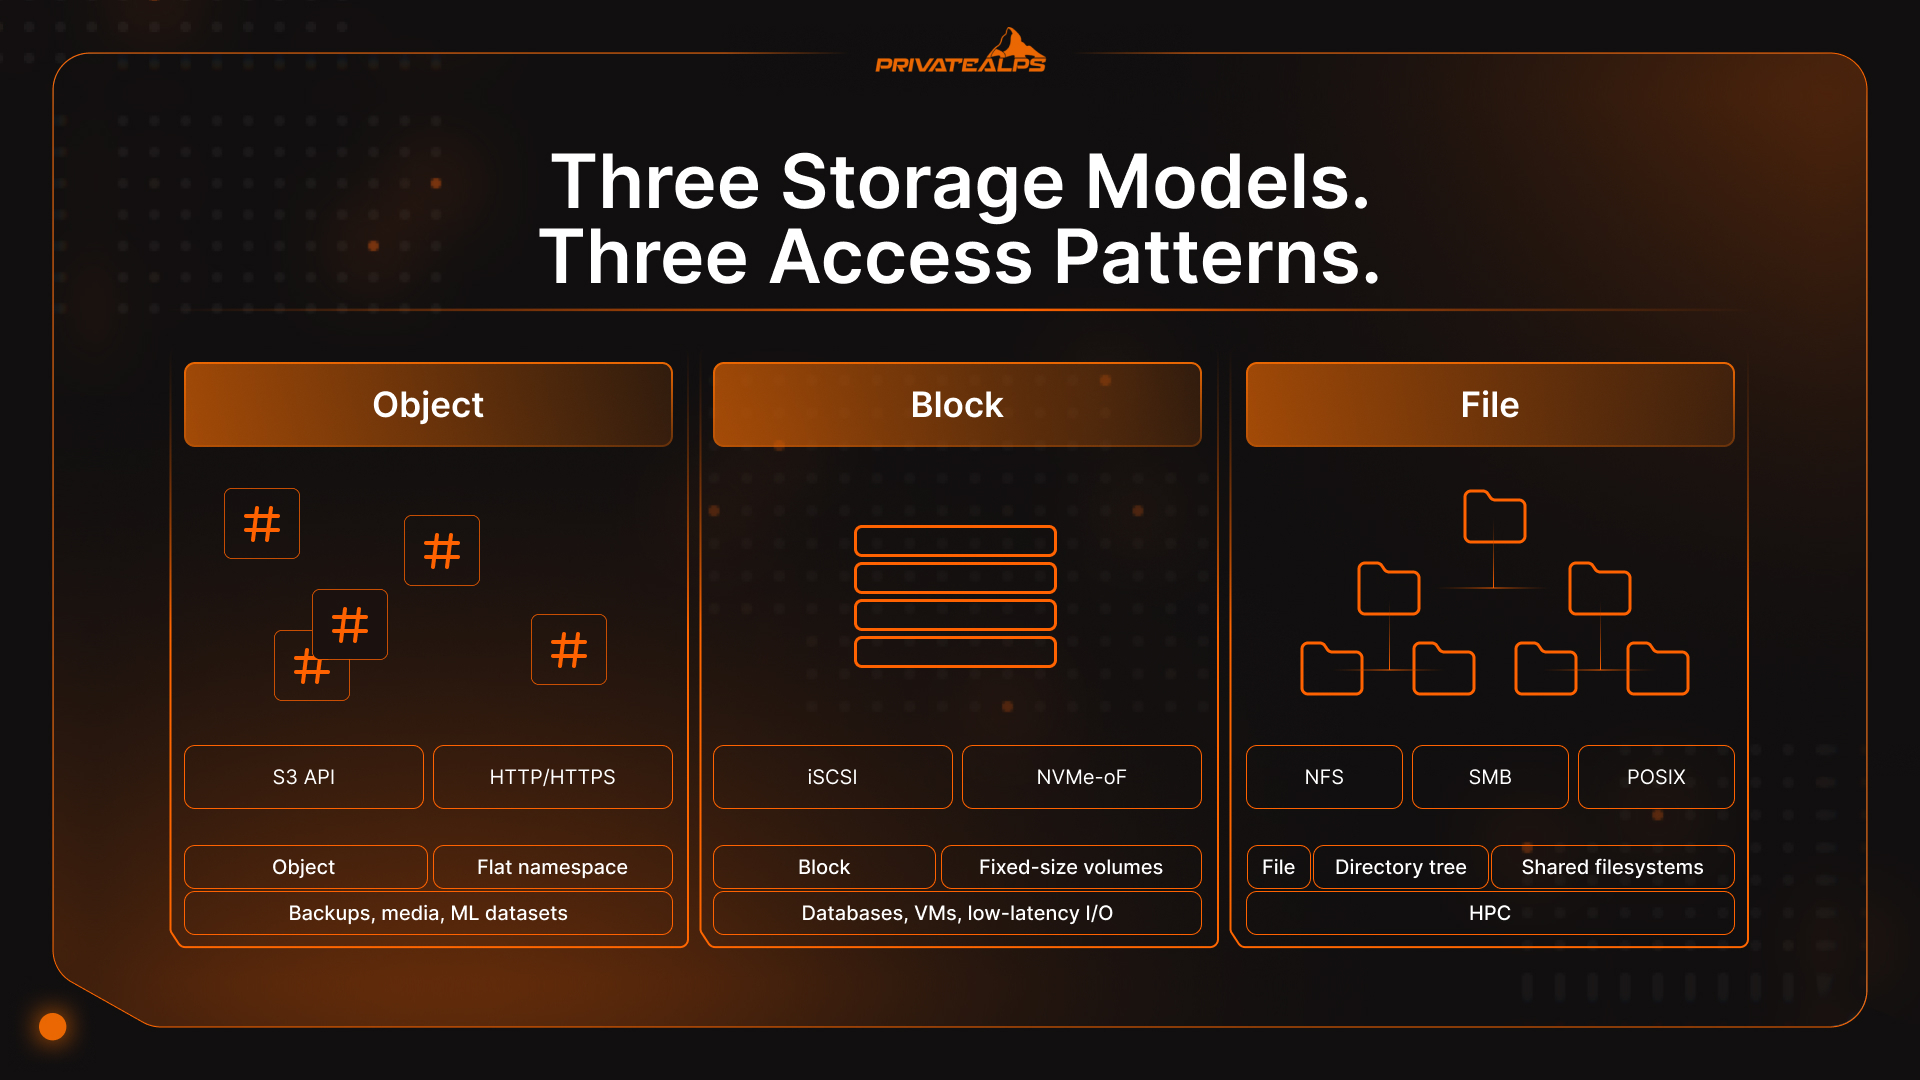
| النوع | إزاي البيانات بتتخزن | طريقة الوصول | الأنسب لـ | أمثلة |
|---|---|---|---|---|
| Object | فضاء أسماء مسطح، كائنات غنية بالميتاداتا | واجهة متوافقة مع S3 (HTTP/HTTPS) | البيانات غير المهيكلة على نطاق كبير: النسخ الاحتياطية، الميديا، مجموعات بيانات ML | AWS S3، MinIO، Ceph RADOS |
| Block | أحجام خام بحجم ثابت | iSCSI، NVMe-oF، FC | قواعد البيانات، الـ VMs، عمليات I/O عشوائية منخفضة الزمن | Ceph RBD، AWS EBS، Lightbits |
| File | شجرة مجلدات هرمية | NFS، SMB، POSIX | أنظمة الملفات المشتركة، HPC، المجلدات الشخصية | GlusterFS، HDFS، Azure Files |
تخزين الكائنات الموزع (Distributed Object Storage)
تخزين الكائنات الموزع بينظّم البيانات ككائنات فردية غير قابلة للتعديل موجودة في فضاء أسماء مسطح، مفيش مجلدات ولا مسارات ملفات ولا هرمية تحتاج صيانة. كل كائن ليه معرّف فريد (hash أو UUID) مع ميتاداتا غنية، وبتوصله عن طريق واجهة API متوافقة مع S3 عبر HTTP. ولأن الكائنات بتتستبدل بدل ما تتعدّل جزئيًا، مشكلة الـ locking اللي بتحدد الأداء وتقيّد قابلية التوسع في أنظمة الكتل والملفات بتختفي ببساطة. ده اللي بيخلي AWS S3 وAzure Blob وCeph يتوسعوا لـ exabytes: مفيش overhead تنسيق لفضاء الأسماء، ومفيش تنافس على الأقفال، وأي نود في الكلستر تقدر تخدم أي طلب كائن بشكل مستقل.
تخزين الكتل الموزع (Distributed Block Storage)
تخزين الكتل بيدّي أحجام خام للسيرفرات، بلوكات بحجم ثابت وعناوين فريدة، من غير أي طبقة filesystem فوقها. التطبيقات بتكتب على البلوكات مباشرةً، وده اللي بيوفر I/O عشوائي منخفض الزمن ومتسق لقواعد البيانات وأقراص الـ VMs والأحمال المعبأة في containers. في قيد معماري واحد بيفاجئ الناس: حجم البلوكات عادةً ممكن يتركّب على سيرفر واحد بس في نفس الوقت. الوصول المشترك من أكتر من سيرفر محتاج تنسيق إضافي فوقه، زي cluster filesystem متراكب فوق أجهزة الكتل.
تخزين الملفات الموزع (Distributed File Storage)
تخزين الملفات بيقدّم filesystem مشترك من خلال بروتوكولات قياسية: NFS وSMB والوصول المتوافق مع POSIX. كذا عميل ممكن يركّب نفس الحجم في نفس الوقت، وده بيخليه الاختيار الطبيعي للأحمال التعاونية وبيئات HPC والتطبيقات القديمة اللي بتتوقع شجرة مجلدات ومحدش هيعيد كتابتها قريب. التوازن الحقيقي: الحفاظ على فضاء أسماء مجلدات متسق عبر نودات موزعة بيخلق overhead تنسيق بيتراكم مع الحجم. أغلب الـ hyperscalers في الآخر بينقلوا من تخزين الملفات الموزع لتخزين الكائنات الموزع للبيانات الأساسية لما الحجم يكبر بما يكفي.
نظرية CAP: التوازن اللي مفيش منه مفر في التخزين الموزع
نظرية CAP بتقول إن نظام البيانات الموزع يقدر يضمن تلات حاجات بس من اتنين في نفس الوقت: الاتساق (Consistency، كل قراءة بترجع أحدث كتابة)، والتوفر (Availability، كل طلب بياخد رد)، وتحمل التقسيم (Partition Tolerance، النظام بيفضل شغال مع انقسامات الشبكة). الشبكات بتتقسم، فتحمل التقسيم مش اختياري. القرار الحقيقي دايمًا بيكون بين الاتساق والتوفر لما عطل يحصل.
[إريك بروير قدّم نظرية CAP في سنة 2000؛ وجيلبرت ولينش صاغوا البرهان رسميًا في 2002][https://www.scylladb.com/glossary/cap-theorem/]. ولسه ده القرار اللي بيشكّل كل حاجة تانية في معمارية التخزين الموزع، لأنه بيحدد إزاي النظام بيتصرف في اللحظة بالظبط اللي انت محتاجه فيها أكتر حاجة، لما حاجة تكون اتكسرت أصلًا.
| النظام | نوع CAP | السلوك أثناء التقسيم | الأنسب لـ |
|---|---|---|---|
| MongoDB | CP (مع read/write concern بالأغلبية) | يرفض الطلبات لحد ما الاتساق يرجع | السجلات المالية، المخزون، الحجوزات |
| HBase | CP | يرجّع أخطاء بدل ما يرجّع بيانات قديمة | التحليلات المهيكلة، أشغال الـ batch المتسقة |
| Apache Cassandra | AP | يفضل متاح؛ ممكن يخدم قراءات قديمة | الـ feeds الاجتماعية، الرسائل، بيانات IoT |
| DynamoDB (default) | AP | يرد دايمًا؛ ويصالح عدم الاتساق بشكل غير متزامن | تطبيقات المستهلكين عالية الإنتاجية |
| CockroachDB | CP | الاتساق أولًا، مع SQL موزع | أحمال المعاملات العالمية |
القرار العملي: هل الشغل بتاعك يتحمل قراءة قديمة (stale read)؟ رصيد بنكي، أو حجز مقعد، أو عدد المخزون، غالبًا لأ. روح لـ CP. فيد اجتماعي، أو stream أحداث من sensor، أو تيليمتري تحليلات، ثواني تأخير مش مشكلة. روح لـ AP، واحتفظ بضمان التوفر.
أمان التخزين الموزع: التشفير وسيادة البيانات
الأمان في التخزين الموزع بيقوم على ثلاث طبقات مختلفة: البيانات الساكنة (Data at Rest)، والبيانات أثناء النقل (Data in Transit)، وملكية المفاتيح. ولو غلطت في واحدة منهم، الاتنين التانيين مش هينفعوك. ممكن البنية التحتية تكون متاحة بالكامل، وفي نفس الوقت البيانات الحساسة تكون متاحة بهدوء لناس مش المفروض توصلها.
لازم التشفير يغطي الطبقات الثلاث. البيانات الساكنة عادةً بتستخدم AES-256، سواء بمفاتيح بتديرها الشركة المزوّدة أو مفاتيح بيديرها العميل (CMK). الإدارة من طرف المزوّد أسهل تشغيليًا، بس مزوّد التخزين هو اللي بيمسك مادة المفتاح، وده اعتبار أمني مهم جدًا للقطاعات المنظّمة اللي بتعدّي على مراجعات تدقيق. التشفير من جانب العميل (Client-side Encryption) بيلغي التعرض ده خالص؛ البيانات بتتشفّر قبل ما تخرج من جهاز العميل، فالمزوّد ما بيشوفش النص الأصلي أبدًا، بغض النظر عن أي طلبات قانونية ممكن تيجي. أما البيانات أثناء النقل، فـTLS 1.3 هو الحد الأدنى للأمان، وأي نظام لسه بيسمح بـ TLS 1.2 محتاج استثناء موثّق بموجب معظم أطر الامتثال الحالية.
سيادة البيانات غالبًا بتفاجئ الفرق. البيانات بتخضع لقوانين البلد اللي هي موجودة فيه فعليًا، مش بلد الشركة ولا مكان المستخدم. سويسرا حاصلة على وضع الكفاية بموجب المادة 45 من اللائحة العامة لحماية البيانات (GDPR)، ولذلك نقل البيانات من الاتحاد الأوروبي لسويسرا بيتم من غير ضمانات تعاقدية إضافية. وقانون حماية البيانات الفيدرالي المُعدّل (nFADP) بيواءم القواعد السويسرية المحلية مع GDPR، وده معناه إن البنية التحتية السويسرية بتوفّر تغطية تنظيمية متسقة تحت الإطارين في نفس الوقت.
حاجة سهل نأجّلها بس ما ينفعش: الخوارزميات التشفيرية اللي بتحمي أغلب البنى التحتية للتخزين النهارده ما اتصممتش عشان تصمد أمام كمبيوتر كمّي قادر. أعلنت NIST ثلاث معايير لتشفير ما بعد الكم في أغسطس 2024، من ضمنها FIPS 203 (ML-KEM). لو التخزين الموزع عندك بيحتفظ بسجلات ليها مدة احتفاظ طويلة، زي الأرشيف الطبي والسجلات المالية والمستندات القانونية، يبقى تهديد «احصد الآن، فك التشفير لاحقًا» شغّال فعلًا من دلوقتي. لازم خطط التقييم تبدأ قبل ما الأرشيفات دي توصل لمرحلة النضج بوقت كافي.
أهم مزايا التخزين الموزع
- تحمّل الأعطال من غير انقطاع الخدمة: لما سيرفر (Node) يقع، نظام كشف النبضات (Heartbeat) بيكتشف العطل، والطلبات بتتحوّل تلقائيًا للنسخ المتماثلة (Replicas) الشغّالة. من غير تدخل يدوي ومن غير الحاجة لنافذة صيانة.
- قابلية التوسع الأفقي: السعة الجديدة بتيجي من إضافة سيرفرات (Nodes) للكلاستر، والبيانات بتتوزّع من جديد في الخلفية من غير ما تأثر على الترافيك الحي أو تحتاج أي توقف.
- التوزيع الجغرافي: النسخ المتماثلة عبر مناطق مختلفة بتقلل زمن الاستجابة للمستخدمين المنتشرين جغرافيًا، وبتحوّل الامتثال لمكان تخزين البيانات (Data Residency) من مشروع بنية تحتية لمجرد قرار إعدادات.
- إنتاجية الإدخال والإخراج المتوازي: أكتر من سيرفر بيتعامل مع القراءة والكتابة في نفس الوقت، وده الاختيار الوحيد القابل للتوسع لخطوط تدريب الذكاء الاصطناعي وتعلم الآلة، وتحويل ترميز الفيديو، وبث الميديا على حجم إنتاج حقيقي.
- من غير تقييد بمزوّد واحد مع البروتوكولات المفتوحة: واجهات برمجة متوافقة مع S3، وNFS، ومنصات مفتوحة المصدر زي Ceph، بتخلّي الفرق تنتقل بين المزوّدين أو تشغّل البنية التحتية على سيرفرات خاصة بيها من غير ما تعيد كتابة كود التطبيق.
- كفاءة التكلفة على نطاق واسع: أجهزة عادية بتحل محل مصفوفات التخزين المملوكة الغالية، والـ Erasure Coding بيقلل احتياج السعة الخام لحد 50% مقارنةً بالنسخ الكاملة عبر السيرفرات.
حدود التخزين الموزع وتحدياته
- تعقيد الاتساق: الحفاظ على حالة متسقة عبر السيرفرات محتاج ضبط دقيق لنماذج الاتساق، وعوامل النسخ، وإعدادات النصاب (Quorum). الإعداد الغلط مش بيعلن عن نفسه بصوت عالي، لكنه بيخلّي البيانات تتباعد بهدوء.
- العبء التشغيلي: تشغيل كلاستر تخزين موزع معناه إنك مسؤول عن تخطيط نطاقات الأعطال، وإجراءات استبدال السيرفرات، وخطوط المراقبة، وضبط الأداء. سيرفر واحد مش بيطلب منك كل ده.
- الاعتماد على الشبكة: البنية كلها بتفترض اتصال موثوق وعالي السعة بين السيرفرات. أي تدهور في الشبكة بينعكس مباشرة وبنفس النسبة على زمن الاستجابة وخسارة الإنتاجية.
- زمن الاستجابة مع عمليات الإدخال والإخراج العشوائية الصغيرة: التخزين الموزع متحسّن للقراءة المتتابعة الكبيرة والإنتاجية المتوازية. أحمال العمل اللي فيها عمليات عشوائية صغيرة كتير، وبالذات قواعد بيانات OLTP، غالبًا بتشتغل أحسن على تخزين NVMe متصل محليًا.
- الحد الأدنى للحجم المجدي: مزايا التكلفة والتعقيد في التخزين الموزع مش بتظهر على كلاستر من سيرفرين. تحت حد معيّن، خدمة تخزين سحابية مُدارة أو سيرفر واحد مضبوط كويس بتكون أرخص وأسهل في التشغيل ببساطة.
حالات استخدام واقعية للتخزين الموزع
- الميديا والبث: Netflix وYouTube مش بيقدّموا الفيديو من مكان مركزي واحد، بل بيوزّعوا المحتوى المرمّز على كلاسترات تخزين الكائنات (Object Storage) القريبة جغرافيًا من المشاهدين. مركز بيانات واحد مش هيقدر يستوعب البث العالمي المتزامن على نطاق واسع، وتكلفة الباندويدث لوحدها هتكون مرهقة جدًا. التخزين الموزع للبيانات هو اللي بيخلّي اقتصاديات البث تشتغل فعلًا.
- الرعاية الصحية: فحص الرنين المغناطيسي الواحد بيولّد من 500 ميجابايت لـ1 جيجابايت من بيانات التصوير. لما تضرب ده في شبكة مستشفيات كبيرة، بأنواع أجهزة مختلفة ومدد احتفاظ طويلة ومواقع متعددة، هتلاقي بيانات بالبيتابايت بتتراكم بسرعة. التخزين الموزع القابل للتوسع مع تكرار جغرافي هو الطريقة اللي بتخلّي الأنظمة الصحية تحافظ على الوصول المتوافق مع HIPAA لسجلات المرضى حتى لو مركز بيانات إقليمي وقع.
- الذكاء الاصطناعي وتعلم الآلة: تدريب نموذج لغوي كبير معناه تغذية كلاسترات GPU بتيرابايت لبيتابايت من البيانات، بقراءة غير متتابعة هتشبّع نظام التخزين التقليدي في لحظات. Ceph وHDFS وتخزين الكائنات المتوافق مع S3 بقوا الطبقة القياسية للبنية التحتية لخطوط تعلم الآلة، لأن إنتاجية القراءة المتوازية بتاعتهم بتطابق فعلًا اللي كلاسترات الـ GPU بتستهلكه.
- النسخ الاحتياطي والتعافي من الكوارث: التعافي الحقيقي من الكوارث معناه إن البيانات موجودة في مكانين منفصلين جغرافيًا على الأقل، بنطاقات أعطال مستقلة، مش رفين في نفس المبنى. سياسات النسخ وقواعد التوزيع المدمجة مباشرةً في طبقة التخزين الموزع بتحدد RPO وRTO على مستوى البنية التحتية، من غير الحاجة لمجموعة برامج نسخ احتياطي منفصلة. وقلة الأجزاء المتحركة معناها كمان سطح هجوم أصغر.
التخزين الموزع مقابل التخزين اللامركزي: إيه الفرق؟
التخزين الموزع معناه إن البيانات متوزعة على سيرفرات كتير، لكن منظمة واحدة لسه بتملك وبتتحكم في الكل: السياسات، وصلاحيات الوصول، وإمكانية الحذف، وسجلات التدقيق. التخزين اللامركزي بيلغي السلطة المركزية دي تمامًا. البيانات بتعيش عبر أقران (Peers) مستقلين، ومفيش مشغّل واحد يقدر يرقّب أو يوصل أو يحذف فيها من غير إذن.
الفرق ده ليه نتايج تشغيلية حقيقية. النظام الموزع المُدار مركزيًا ممكن يتراجع عليه، ويتعمله تحديثات وترقيعات، وعليه اتفاقيات مستوى خدمة (SLA)، ويتحط تحت الامتثال التنظيمي. النظام اللامركزي بيبدّل كل ده بمقاومة للرقابة والتشغيل من غير ثقة مسبقة. ده مفيد في سياقات معينة، بس مش اللي أغلب الشركات اللي بتشغّل تخزين إنتاجي محتاجاه فعلًا.
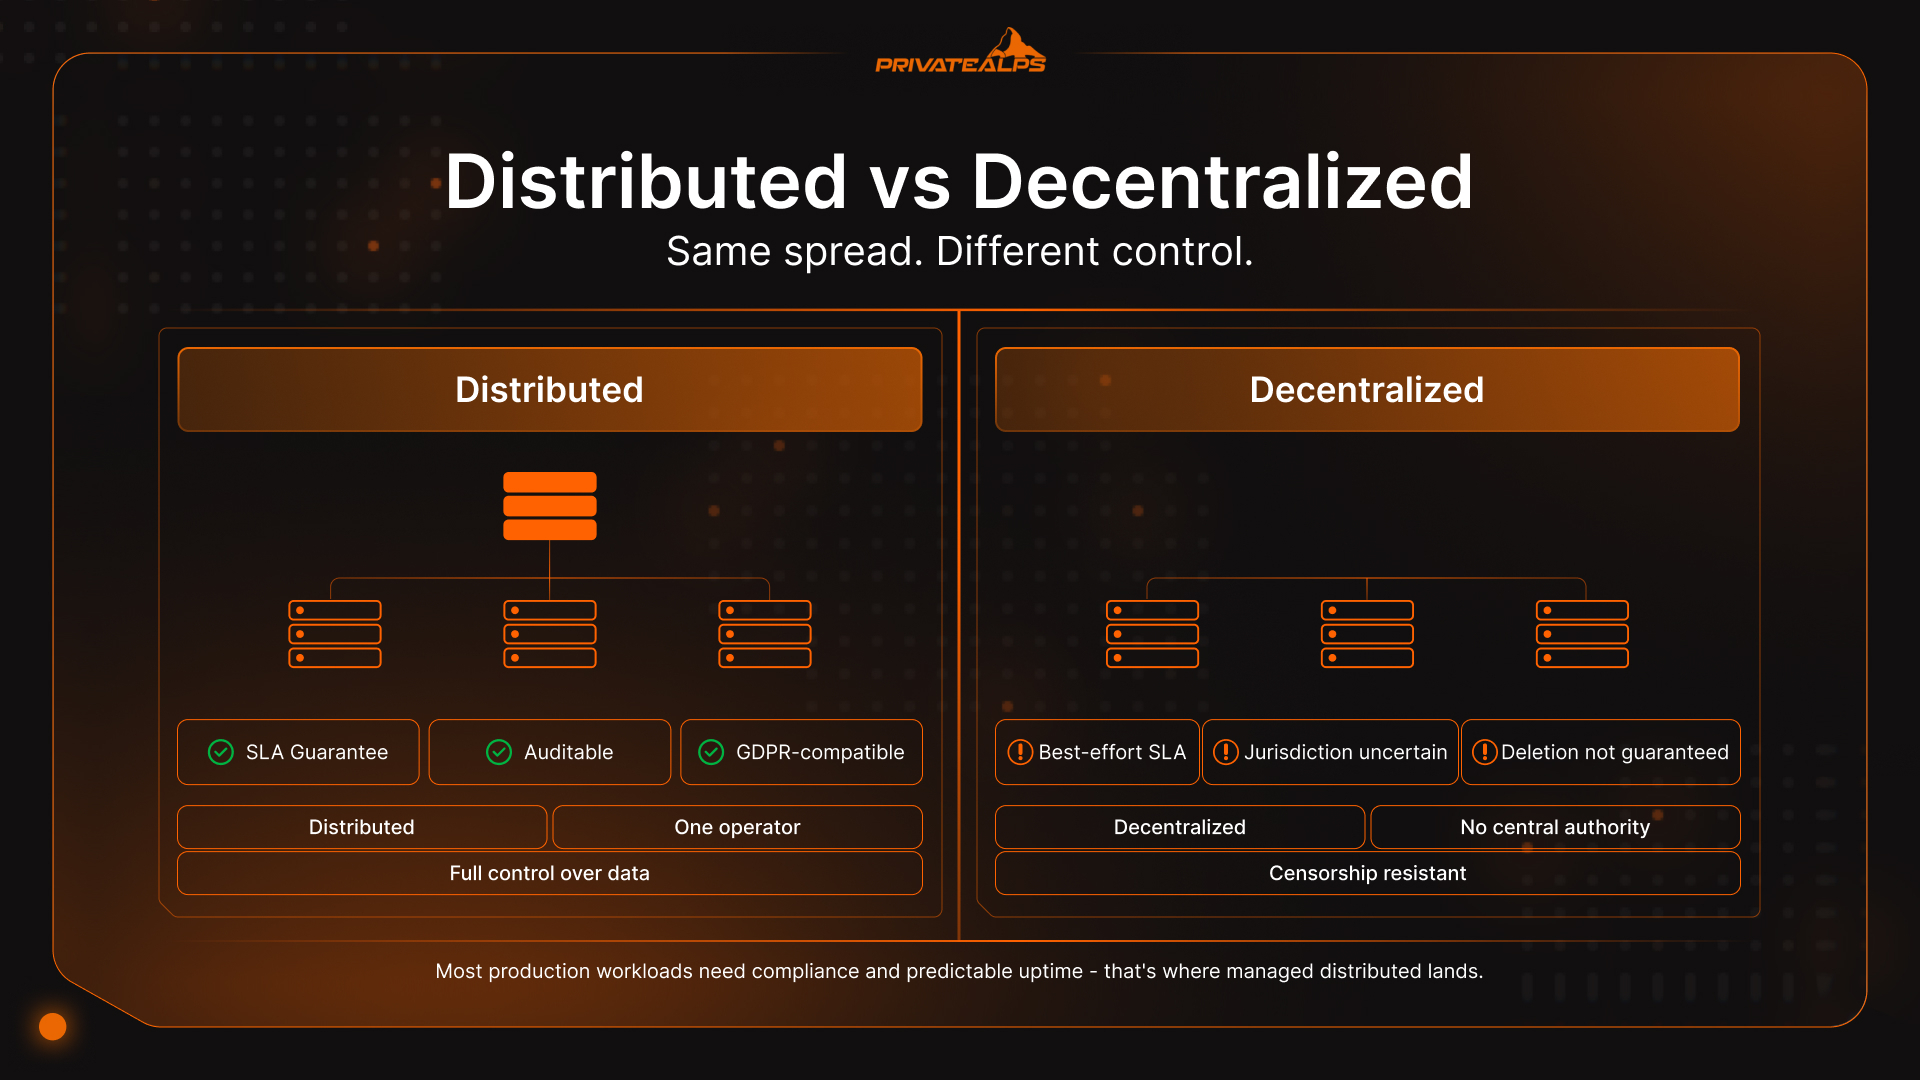
| المعيار | التخزين الموزع | التخزين اللامركزي |
|---|---|---|
| التحكم | يُدار مركزيًا | لا توجد سلطة مركزية |
| SLA / ضمانات التوفر | ممكن ضمانات تعاقدية | أفضل جهد، ويعتمد على البروتوكول |
| الامتثال | قابل للتدقيق، متوافق مع GDPR | الاختصاص القضائي غير واضح |
| حذف البيانات | مضمون | مش دايمًا ممكن |
| التحكم في الوصول | قائم على الأدوار، مُدار | تشفيري، من غير ثقة مسبقة |
| أمثلة | AWS S3، Azure Blob، Ceph | Storj، Filecoin، IPFS |
وفي طبقة تانية تستاهل التوضيح: تخزين السحابة متعدد المناطق (زي AWS S3 مع النسخ عبر المناطق، أو Azure geo-redundant storage) لسه بنية تحتية مُدارة مركزيًا. المزوّد هو اللي بيدير السيرفرات والنسخ المتماثل، وإنت عمليًا بتأجّر الجغرافيا. منصات السحابة الموزعة الحقيقية زي Storj أو Cubbit بتوزّع البيانات على مشغّلين مستقلين، وده بيشيل التقييد بمزوّد واحد، بس بيفتح تاني أسئلة عن اتفاقيات مستوى الخدمة وسجلات التدقيق. ولأغلب أحمال العمل اللي محتاجة مستندات امتثال وتوفر متوقع، النهج الموزع المُدار هو الاختيار اللي بيتحسم عليه الموضوع.
الخلاصة
التخزين الموزع مش منتج، ده تصنيف معماري، والنوع المناسب بيعتمد بالكامل على اللي إنت بتشغّله. تخزين الكائنات وتخزين الكتل وتخزين الملفات كل واحد منهم ليه نموذج بيانات مبني لأنماط وصول وأحمال عمل مختلفة. نظرية CAP بتفرض مفاضلة حقيقية بين الاتساق والتوفر لحظة حصول أعطال الشبكة، والغلط في القرار ده ممكن يكلّف غالي. ولما نيجي للنسخ المتماثل (Replication) مقابل Erasure Coding، درجة حرارة البيانات هي اللي بتحسم: البيانات الساخنة محتاجة نسخ متماثل عشان زمن الاستجابة، والبيانات الباردة بتستفيد من كفاءة التخزين اللي بيوفرها Erasure Coding. لأغلب الفرق، الحل الموزع المُدار، سواء من مزوّد خاص أو سحابة عامة، طالما ضوابط مكان البيانات والأمان قابلة للتحقق، بيحقق توازن أفضل بين قابلية التوسع والأداء وسهولة التشغيل اليومي من كلاستر مستضاف ذاتيًا.
خزّن بياناتك في سويسرا مع PrivateAlps
لو أحمال العمل بتاعتك محتاجة تخزين كائنات موزع متوافق مع S3 مع مكان بيانات قابل للتحقق، PrivateAlps بتشغّل بنية تحتية سويسرية متوافقة بالكامل مع المادة 45 من GDPR وnFADP. بياناتك بتفضل في سويسرا، من غير مشاركة مع طرف تالت، ومن غير مسارات غامضة عبر اختصاصات أجنبية، ومن غير مفاجآت. سواء كنت بتنقل بياناتك من مزوّد سحابي كبير أو بتبني بنية تخزين موزع تركز على الخصوصية من الصفر، PrivateAlps بتوفّر الأداء ويقين الامتثال اللي حملك فعلًا محتاجه.
الأسئلة الشائعة
إيه الفرق بين التخزين الموزع وتخزين السحابة؟
تخزين السحابة نموذج تقديم خدمة: حد تاني هو اللي بيدير البنية التحتية، وإنت بتوصلها عبر الإنترنت بالدفع حسب الاستخدام. التخزين الموزع بنية معمارية: البيانات متوزعة على سيرفرات متعددة عشان الاحتياطية وقابلية التوسع. الاتنين مفهومين مستقلين. ممكن تشغّل تخزين موزع بالكامل على سيرفرات خاصة بيك باستخدام Ceph أو MinIO، وفي المقابل مزوّد سحابة ممكن من الناحية التقنية يقدّم تخزين مركزي خلف واجهة برمجة. أغلب خدمات تخزين السحابة بتستخدم بنى موزعة من جوّه، بس ده تفصيل تنفيذي، مش تعريف تخزين السحابة.
إيه أفضل نظام تخزين موزع؟
مفيش إجابة واحدة تنفع للكل، والمسألة بتعتمد على حمل العمل ونموذج البيانات. للبيانات غير المهيكلة والنسخ الاحتياطي، مخازن الكائنات المتوافقة مع S3 زي MinIO أو Ceph RADOS هي الاختيار القياسي. ولأحجام قواعد البيانات وأقراص الـ VM اللي محتاجة إدخال وإخراج كتل متسق وزمن استجابة منخفض، Ceph RBD أو Lightbits أنسب. ولأنظمة الملفات المشتركة في بيئات HPC أو البيئات القديمة، GlusterFS أو HDFS هما اللي الفرق بتروح لهم غالبًا. ابدأ بنمط الوصول، ونظام التخزين بييجي بعد كده طبيعي.
هل التخزين الموزع هو نفسه RAID؟
لأ. RAID بيشتغل جوّه سيرفر واحد أو مصفوفة تخزين واحدة، وبيحمي من عطل الهارد جوّه جهاز واحد. التخزين الموزع بيشتغل عبر سيرفرات فيزيائية منفصلة متصلة بالشبكة، وممكن يمتد لمباني متعددة أو لمراكز بيانات كاملة. RAID مش هيفيدك لما السيرفر نفسه يقع. أنظمة التخزين الموزع متصممة خصيصًا عشان تتحمّل أعطال السيرفرات، وأعطال الرفوف، وانقطاع مراكز البيانات بالكامل. فرق النطاق ده جوهري.
إزاي التخزين الموزع بيتعامل مع أعطال السيرفرات؟
السيرفرات بترسل إشارات نبض منتظمة لطبقة الميتاداتا في الكلاستر. لما سيرفر يقف عن الرد، النظام بيكتشف العطل، عادةً في ثواني، وبيحوّل الطلبات للسيرفرات اللي فيها النسخ المتماثلة أو أجزاء Erasure Coding. في الإعدادات المبنية على النسخ المتماثل، عملية استعادة في الخلفية بتنشئ نسخ جديدة عشان ترجّع عامل النسخ المتماثل المضبوط عبر الكلاستر. العملية كلها تلقائية، وفي كلاستر تخزين موزع متضبط كويس، التطبيقات مش بتشوف العطل خالص.
هل التخزين الموزع مناسب للشركات الصغيرة؟
خدمات التخزين الموزع المُدارة، زي تخزين الكائنات المتوافق مع S3 من مزوّد سحابي أو من متخصص زي PrivateAlps، بتشتغل على أي حجم من غير حد أدنى لعدد السيرفرات في الكلاستر. أما كلاسترات التخزين الموزع المستضافة ذاتيًا فحكايتها مختلفة: تشغيل Ceph بشكل إنتاجي غالبًا بيحتاج من 3 لـ5 سيرفرات على الأقل قبل ما العبء التشغيلي يبقى مبرر. للفرق الصغيرة، الخدمات المُدارة بتوفّر المزايا المعمارية الكاملة للتخزين الموزع من غير عبء إدارة البنية التحتية.
