


Mikä on hajautettu tallennus?
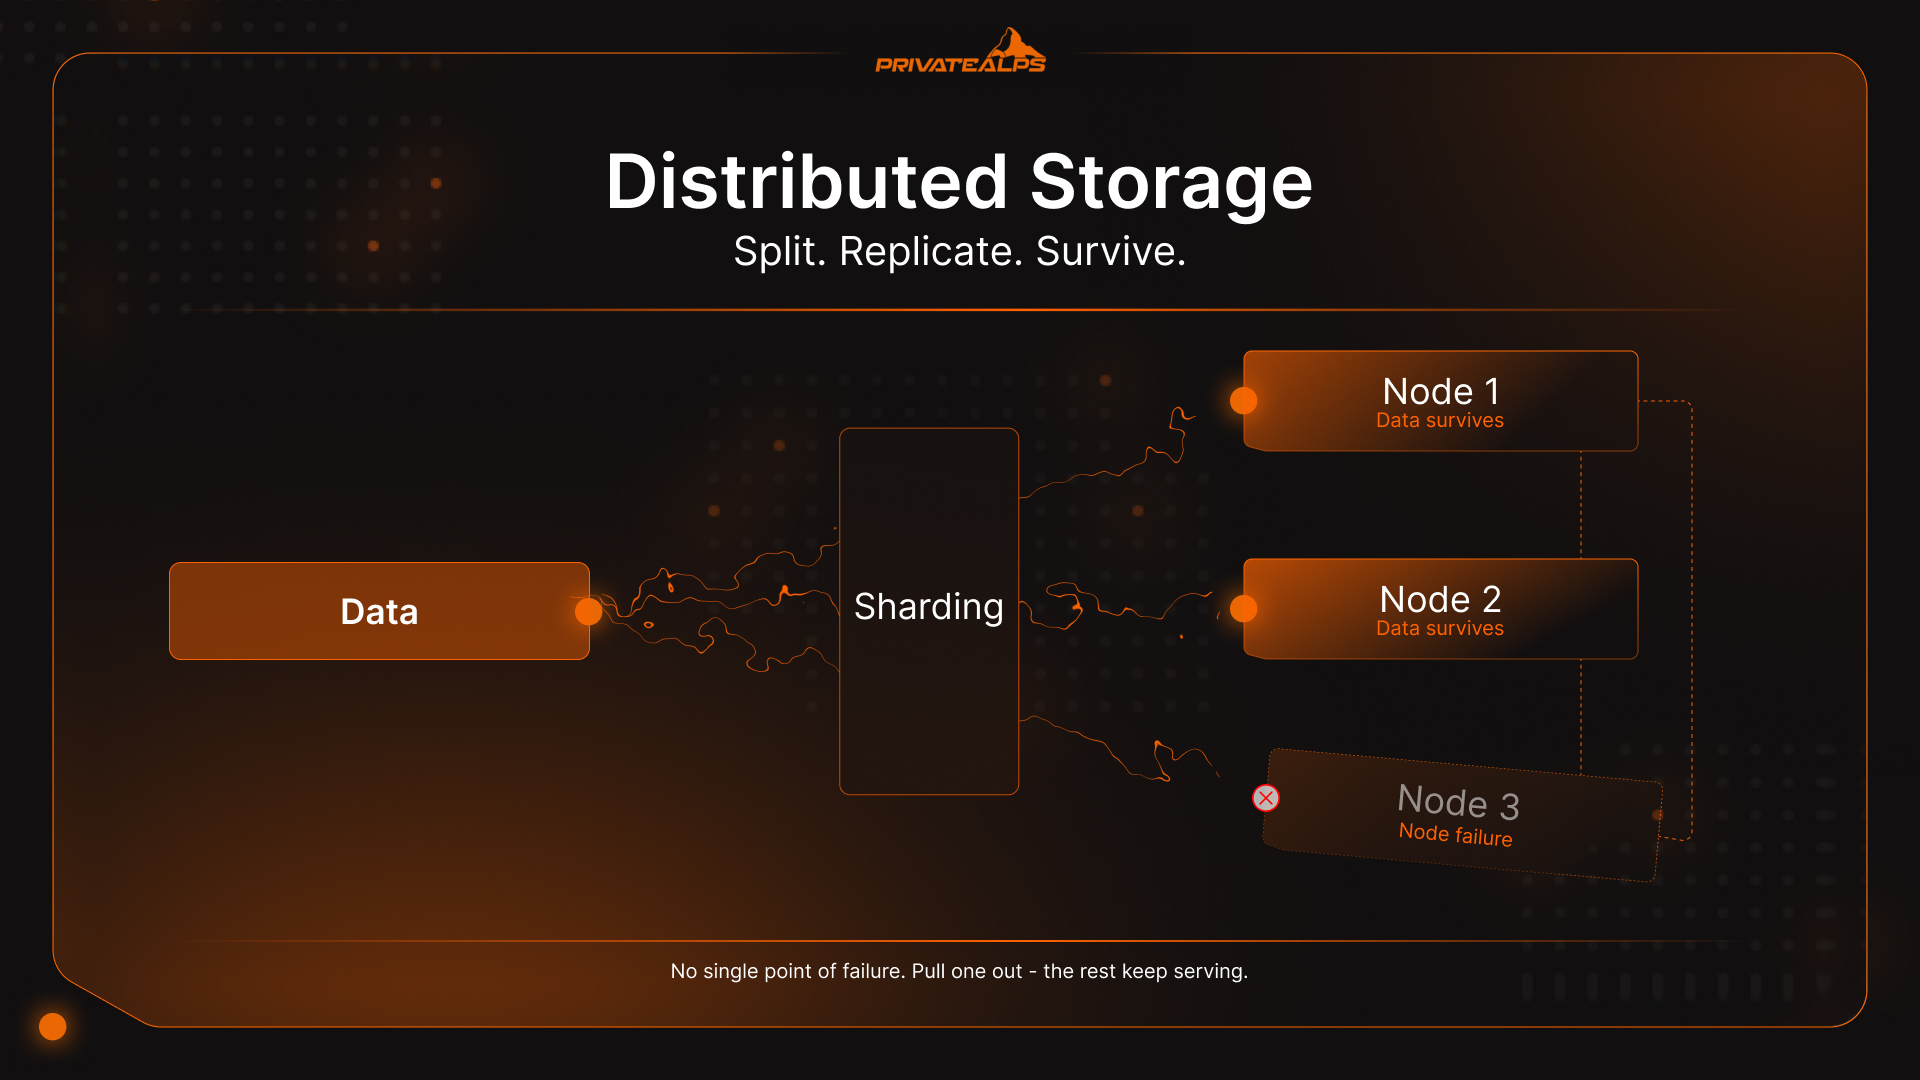
Hajautettu tallennus on tapa, jolla nykyinen infrastruktuuri käsittelee dataa, joka on yksinkertaisesti liian suurta, liian kriittistä tai liian paljon käytettyä, jotta yksi kone pystyisi tallentamaan sen luotettavasti. Sen sijaan, että kaikki kirjoitettaisiin yhdelle palvelimelle, järjestelmä jakaa, monistaa tai koodaa datan useisiin itsenäisiin solmuihin: palvelimiin, levyihin ja datakeskuksiin. Solmut toimivat yhdessä, mutta yksikään solmu ei sisällä kaikkea dataa. Kun yksi solmu poistetaan, loput jatkavat palvelua. Tämä opas kertoo, miten hajautetut tallennusjärjestelmät todellisuudessa toimivat kuormituksen alla, mitä arkkitehtuurisia kompromisseja ne edellyttävät ja mikä tallennustyyppi sopii mihinkin työkuormaan.
AI-yhteenveto
Hajautettu tallennus on ohjelmistopohjainen arkkitehtuuri, joka jakaa datan useisiin fyysisiin solmuihin kolmen ydintekniikan avulla: sharding (datan jakaminen erillisiin osiin, jotka ohjataan eri solmuihin), replikointi (useiden identtisten kopioiden säilyttäminen solmujen välillä nopeaa käyttöä varten) ja pyyhkäisykoodaus (datan koodaaminen paloiksi matemaattisella pariteettitiedolla, jotta mikä tahansa osajoukko riittää koko datan rakentamiseen).
Hajautetulla tallennusjärjestelmällä on kolme päätyyppiä: objektitallennus (tasainen nimiavaruus, S3-yhteensopiva rajapinta), lohkotallennus (kiinteän kokoiset levyt pienen viiveen satunnaiseen I/O:hun) ja tiedostotallennus (hierarkkinen nimiavaruus NFS:n tai SMB:n kautta). Jokainen hajautettu tietojen tallennus kohtaa CAP-teoreeman: järjestelmä voi taata samanaikaisesti vain kaksi seuraavista kolmesta: johdonmukaisuus, saatavuus ja osiotoleranssi.
Operatiivinen keskeinen hyöty on, että solmujen vikaantuminen ei aiheuta katkoksia. Järjestelmä ohjaa pyynnöt automaattisesti toimiviin replikoihin.
Mittakaavaa kuvaa tämä: ihmiskunta tuottaa joka päivä yli 400 miljoonaa terabyteä uutta dataa. Määrä on sellainen, ettei mikään keskitetty arkkitehtuuri pysty käsittelemään sitä ilman, että se lopulta romahtaa omaan painoonsa.
Hajautettu tallennus vs. keskitetty tallennus
Keskitetty tallennus kerää kaiken yhteen paikkaan: yhdelle palvelimelle, yhteen SAN-verkkoon tai yhteen datakeskukseen. Siinä on koko malli. Kun siinä paikassa on ongelma, kaikki pysähtyy. Hajautettu tallennus ratkaisee tämän suoraan: data on useissa itsenäisissä solmuissa, joten yksikään vikakohta ei voi pysäyttää koko järjestelmää tai estää kaikkea käyttöä.
Yksi laitevika tarkoittaa, että käyttö loppuu. Täysin. Kasvattaminen edellyttää pääjärjestelmän päivittämistä tai vaihtamista, mikä yleensä tarkoittaa seisokkia ja keskustelua investointimenoista, jota kukaan ei halua käydä. Hajautettu tallennus välttää molemmat suunnittelultaan: kasvatat lisäämällä solmun, ja kun solmu hajoaa, klusteri ohjaa liikenteen sen ohi. Ei draamaa eikä katkoksia. Data oli jo useissa solmuissa ennen kuin mitään hajosi.
| Ulottuvuus | Keskitetty tallennus | Hajautettu tallennus |
|---|---|---|
| Vikasietoisuus | Yksittäinen vikakohta | Data säilyy yksittäisen solmun menetyksessä |
| Skaalautuvuus | Vertikaalinen (päivitä laite) | Horisontaalinen (lisää solmuja) |
| Viive | Matala paikalliselle käytölle | Vaihteleva; riippuu verkon topologiasta |
| Kustannus pienessä mittakaavassa | Alhaisempi alkuinvestointi | Korkeampi vähimmäiskoko klusterille |
| Kustannus suuressa mittakaavassa | Kallis skaalata | Tavallinen laitteisto alentaa kustannuksia |
| Maantieteellinen hajauttaminen | Yksi sijainti | Monialueinen konfiguraation mukaan |
| Operatiivinen monimutkaisuus | Helppo hallita | Vaatii orkestrointityökaluja |
Miten hajautetut tallennusjärjestelmät toimivat
Hajautettu tallennusjärjestelmä ottaa saapuvan datan, pilkkoo sen paloiksi, ohjaa palat klusterin oikeisiin solmuihin ja seuraa jokaista osaa metatietokerroksen kautta. Näin mikä tahansa pala voidaan paikantaa, hakea ja koota tarvittaessa riippumatta siitä, missä solmussa se on. Tämä on perusperiaate. Sitä ohjaavat neljä mekanismia:
- Sharding (datan osiointi) Kun data saapuu, järjestelmä leikkaa sen pienempiin osiin (shardeihin tai lohkoihin) ja jakaa ne solmuihin. Tämä mahdollistaa rinnakkaisen I/O:n: useat solmut käsittelevät lukuja ja kirjoituksia samanaikaisesti, joten läpäisykyky kasvaa klusterin koon mukana eikä rajoitu yhden koneen kattoon. Reititys perustuu yleensä johdonmukaiseen hajautukseen (consistent hashing), joka pitää jakauman tasaisena klusterin kasvaessa ilman, että kaikki sekoittuu uudelleen aina, kun solmu lisätään.
- Replikointi Karkea mutta tehokas tapa: säilytä N identtistä kopiota kustakin shardista eri solmuissa, yleensä kolme. Kun yksi solmu putoaa verkosta, kaksi muuta jatkavat palvelua heti. Ei uudelleenrakentamista eikä odottelua. Replikointi on oikea valinta kuumalle datalle, kuten aktiivisille tietokannoille, reaaliaikaisille syötteille ja kaikelle, missä lukujen ylimääräinen millisekunti todella maksaa.
- Pyyhkäisykoodaus Tässä tallennustehokkuuden laskenta muuttuu kiinnostavaksi. Kolmen täyden kopion sijaan järjestelmä koodaa objektin $k$ datapalaan ja $m$ pariteettipalaan, jakaa kaikki $k+m$ solmuihin ja pystyy rakentamaan koko objektin mistä tahansa $k$:sta palasta. Näin $m$ solmua voi hajota samanaikaisesti menettämättä dataa. Reed-Solomon RS(6,3) -konfiguraatio tallentaa 9 lohkoa siinä, missä 3x replikointi vaatii 18, joten raakatallennuksen ylimäärä laskee 200 %:sta noin 50 %:iin. Haittapuolena on, että koodaus ja dekoodaus kuluttavat suorittimen resursseja, ja pyyhkäisykoodaus toimii paremmin kylmälle datalle, eli sisällölle, jota muokataan tai käytetään harvoin. Työkuormissa, joissa on paljon pieniä kirjoituksia, 3x replikointi voittaa edelleen viiveessä.
| Suojausmenetelmä | Tallennusylimäärä | Paras käyttötarkoitus | Kompromissi |
|---|---|---|---|
| 3x replikointi | 3x raakakapasiteetti | Kuuma data, matalan viiveen työkuormat | Korkea tallennuskustannus suuressa mittakaavassa |
| Pyyhkäisykoodaus RS(6,3) | 1,5x raakakapasiteetti | Kylmä data, arkistointi, suuret objektit | Suorittimen kuormitus, korkeampi uudelleenrakennusviive |
- Metatietoreititys Jokainen hajautettu tallennusjärjestelmä ylläpitää metatietokerrosta, eli käytännössä karttaa siitä, mikä shardi on missäkin solmussa. Kun asiakas pyytää dataa, metatietopalvelu tunnistaa oikeat solmut, ja järjestelmä hakee ja kokoaa palat ilman, että asiakas näkee monimutkaisuutta lainkaan. Suurissa klustereissa, kuten Cephissä tai HDFS:ssä, metatietokerros on itsekin hajautettu solmuihin. Sen täytyy olla. Yksittäinen metatietopalvelin muodostuisi pullonkaulaksi, jota juuri yritit välttää.
Hajautettujen tallennusjärjestelmien tyypit
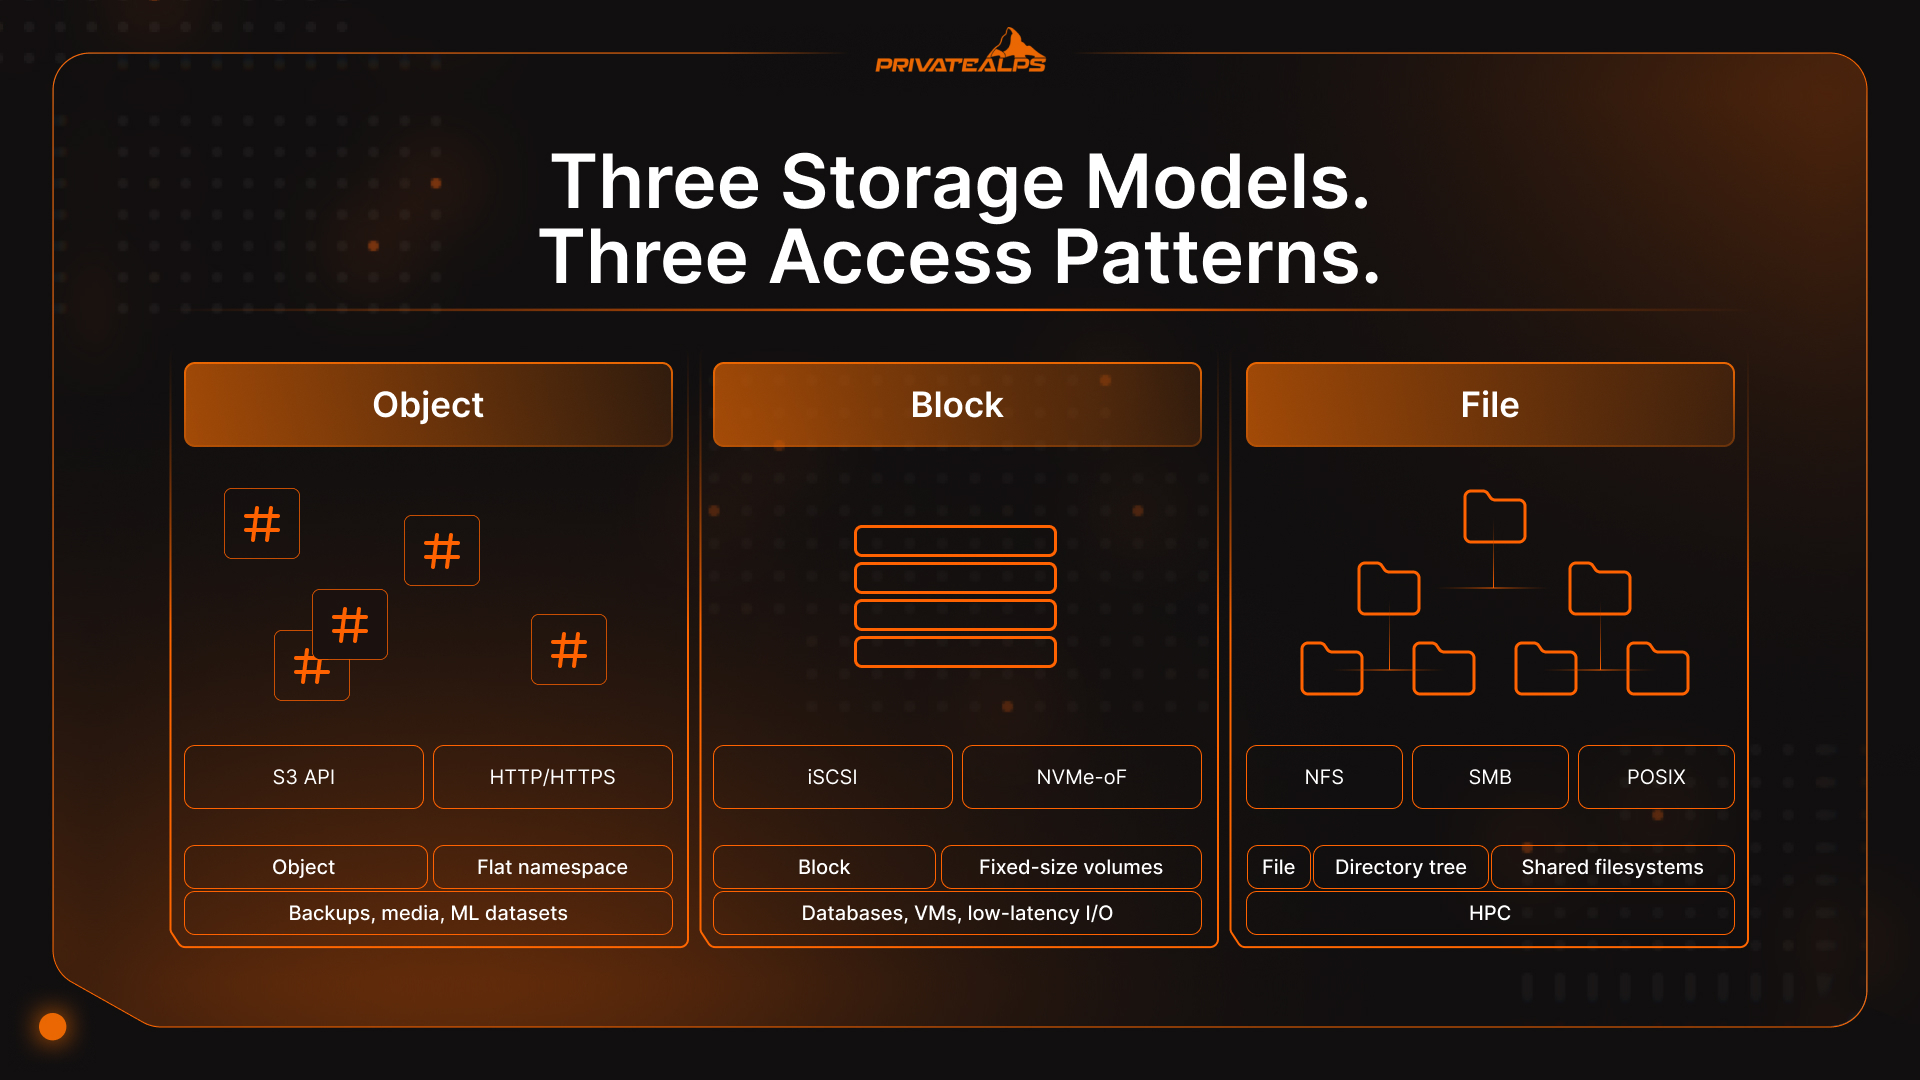
Hajautettu tallennus ei ole yksi asia. Se on kategoria, jonka alla on kolme erillistä tietomallia, ja väärän mallin valinta työkuormaan on yllättävän yleinen ja kallis virhe. Objekti-, lohko- ja tiedostotallennus ratkaisevat kukin eri ongelman. Hajautetut tietokannat, kuten Cassandra, CockroachDB ja Google Spanner, muodostavat neljännen tyypin, sillä ne lisäävät kyselysemantiikan hajautetun tiedonhallinnan päälle, mutta se on erillinen keskustelu.
| Tyyppi | Miten data tallennetaan | Käyttötapa | Paras käyttötarkoitus | Esimerkkejä |
|---|---|---|---|---|
| Objekti | Tasainen nimiavaruus, metatietorikkaat objektit | S3-yhteensopiva rajapinta (HTTP/HTTPS) | Jäsentymätön data suuressa mittakaavassa: varmuuskopiot, media, ML-aineistot | AWS S3, MinIO, Ceph RADOS |
| Lohko | Kiinteän kokoiset raakalevyt | iSCSI, NVMe-oF, FC | Tietokannat, virtuaalikoneet, matalan viiveen satunnainen I/O | Ceph RBD, AWS EBS, Lightbits |
| Tiedosto | Hierarkkinen hakemistopuu | NFS, SMB, POSIX | Jaetut tiedostojärjestelmät, HPC, kotihakemistot | GlusterFS, HDFS, Azure Files |
Hajautettu objektitallennus
Hajautettu objektitallennus järjestää datan yksittäisiksi, muuttumattomiksi objekteiksi tasaisessa nimiavaruudessa, ilman hakemistoja, tiedostopolkuja tai ylläpidettävää hierarkiaa. Jokaisella objektilla on yksilöllinen tunniste (hajautusarvo tai UUID) ja runsaasti metatietoja, ja siihen pääsee S3-yhteensopivan rajapinnan kautta HTTP:llä. Koska objekteja korvataan eikä niitä päivitetä osittain, lukitusongelma, joka rajoittaa suorituskykyä ja skaalautuvuutta lohko- ja tiedostojärjestelmissä, yksinkertaisesti katoaa. Näin AWS S3, Azure Blob ja Ceph skaalautuvat eksatavuihin: nimiavaruuden koordinointi ei kuormita, lukitukset eivät kilpaile, ja mikä tahansa klusterin solmu voi vastata mihin tahansa objektipyyntöön itsenäisesti.
Hajautettu lohkotallennus
Lohkotallennus antaa palvelimille raakoja levyjä: kiinteän kokoisia lohkoja, joilla on yksilölliset osoitteet ilman tiedostojärjestelmän abstraktiota päällä. Sovellukset kirjoittavat suoraan lohkoihin, ja juuri tämä tuo tasaisen, matalan viiveen satunnaisen I/O:n tietokannoille, virtuaalikoneiden levyille ja kontitetuille työkuormille. Yksi arkkitehtuurin rajoite yllättää monet: lohkolevyn voi yleensä liittää kerrallaan vain yhteen palvelimeen. Usean palvelimen jaettu käyttö vaatii lisäorkestrointia, esimerkiksi klusteritiedostojärjestelmän lohkolaitteiden päälle.
Hajautettu tiedostotallennus
Tiedostotallennus tarjoaa jaetun tiedostojärjestelmän tavallisten protokollien kautta: NFS, SMB ja POSIX-yhteensopiva käyttö. Useat asiakkaat voivat liittää saman levyn samanaikaisesti, mikä tekee siitä luonnollisen valinnan yhteistyöhön perustuville työkuormille, HPC-ympäristöille ja vanhoille sovelluksille, jotka odottavat hakemistopuuta eikä niitä kirjoiteta uudelleen lähiaikoina. Käytännön kompromissi on, että yhtenäisen hakemistonimiavaruuden ylläpito hajautetuissa solmuissa aiheuttaa koordinointikuormaa, joka kasvaa mittakaavan myötä. Useimmat hyperskaalaajat siirtyvat lopulta hajautetusta tiedostotallennuksesta hajautettuun objektitallennukseen päädatan osalta, kun volyymit kasvavat riittävän suuriksi.
CAP-teoreema: väistämätön kompromissi hajautetussa tallennuksessa
CAP-teoreema toteaa, että hajautettu tietojärjestelmä voi taata kerrallaan vain kaksi kolmesta: johdonmukaisuuden (jokainen luku palauttaa viimeisimmän kirjoituksen), saatavuuden (jokaiseen pyyntöön saadaan vastaus) ja osiotoleranssin (järjestelmä toimii edelleen verkon jakautuessa). Verkot jakautuvat, joten osiotoleranssi ei ole valinnainen ominaisuus. Varsinainen päätös on aina johdonmukaisuuden ja saatavuuden välillä, kun vika iskee.
[Eric Brewer esitteli CAP-teoreeman vuonna 2000, ja Gilbert ja Lynch muotoilivat todistuksen vuonna 2002][https://www.scylladb.com/glossary/cap-theorem/]. Se on edelleen päätös, joka muokkaa kaikkea muuta hajautetun tallennuksen arkkitehtuurissa, koska se määrää, miten järjestelmä käyttäytyy juuri silloin, kun sitä eniten tarvitset, eli kun jokin on jo rikki.
| Järjestelmä | CAP-tyyppi | Käyttäytyminen osion aikana | Paras käyttötarkoitus |
|---|---|---|---|
| MongoDB | CP (enemmistölukun ja -kirjoituksen asetuksilla) | Hylkää pyynnöt, kunnes johdonmukaisuus on palautettu | Taloustiedot, varastot, varaukset |
| HBase | CP | Palauttaa virheitä vanhentuneen datan sijaan | Jäsennelty analytiikka, johdonmukaiset erätyöt |
| Apache Cassandra | AP | Pysyy saatavilla; voi palauttaa vanhentuneita lukuja | Sosiaaliset syötteet, viestintä, IoT-telemetria |
| DynamoDB (oletus) | AP | Vastaa aina; sovittaa epäjohdonmukaisuuden asynkronisesti | Suuren läpäisykyvyn kuluttajasovellukset |
| CockroachDB | CP | Johdonmukaisuus ensin, hajautettu SQL | Globaalit transaktiotyökuormat |
Käytännön kysymys kuuluu: voiko työkuormasi sietää vanhentunutta lukua? Pankkisaldo, istuinvaraus tai varastomäärä: todennäköisesti ei. Valitse CP. Sosiaalinen syöte, anturitapahtumavirta tai analytiikkatelemetria: muutaman sekunnin vanhentuneisuus käy. Valitse AP ja pidä saatavuustakuu.
Hajautetun tallennuksen tietoturva: salaus ja datan suvereniteetti
Hajautetun tallennuksen tietoturva koostuu kolmesta eri kerroksesta: levossa oleva data, siirrossa oleva data ja avainten omistajuus. Jos yksikin näistä on huonosti, muut eivät pelasta tilannetta. Infrastruktuuri voi olla täysin käytettävissä, vaikka arkaluonteinen data on hiljaa väärien ihmisten saavutettavissa.
Salauksen on katettava kaikki kolme kerrosta. Levossa oleva data käyttää yleensä AES-256-salausta, joko palveluntarjoajan hallitsemilla tai asiakkaan hallitsemilla avaimilla (CMK). Palveluntarjoajan hallitsemat avaimet ovat käytännössä helpompia, mutta tallennuspalvelun toimittaja hallitsee silloin avainmateriaalia. Tämä on kriittinen tietoturvanäkökohta sääntelyn alaisille toimialoille, joiden on läpäistävä tarkastuksia. Asiakaspään salaus poistaa tämän riskin kokonaan: data salataan ennen kuin se lähtee asiakkaalta, joten palveluntarjoaja ei koskaan näe selkokielistä dataa, riippumatta siitä, millaisia lakivaatimuksia tulee. Siirrossa olevan datan osalta TLS 1.3 on tietoturvan vähimmäistaso. Kaikki, mikä vielä sallii TLS 1.2:n, vaatii useimpien nykyisten vaatimustenmukaisuuskehysten mukaan dokumentoidun poikkeuksen.
Datan suvereniteetti yllättää usein tiimit. Dataan sovelletaan sen fyysisen sijaintipaikan lakeja, eikä yrityksen kotimaan tai käyttäjän sijainnin lakeja. Sveitsillä on GDPR:n 45 artiklan mukainen riittävyyspäätös, joten data voidaan siirtää EU:sta Sveitsiin ilman lisäsuojatoimia sopimuksissa. Uudistettu tietosuojalaki (nFADP) yhdenmukaistaa Sveitsin kansalliset säännöt GDPR:n kanssa. Tämä tarkoittaa, että sveitsiläinen infrastruktuuri täyttää johdonmukaisesti molempien kehysten vaatimukset samanaikaisesti.
Yksi asia, jonka voi helposti lykätä, mutta jota ei pitäisi: suurimman osan nykyisestä tallennusinfrastruktuurin suojaavista salausalgoritmeista ei ole suunniteltu kestämään kykenevää kvanttitietokonetta. NIST hyväksyi elokuussa 2024 kolme kvanttikestävän salauksen standardia, joihin kuuluu FIPS 203 (ML-KEM). Jos hajautetussa datan tallennuksessa säilytetään pitkäaikaisia tietueita, kuten lääketieteellisiä arkistoja, taloushallinnon tietoja tai oikeudellisia asiakirjoja, uhkamalli ”kerää nyt, pura myöhemmin” on jo käynnissä. Arviointi kannattaa aloittaa hyvissä ajoin, ennen kuin arkistot saavuttavat kypsyysvaiheensa.
Hajautetun tallennuksen keskeiset edut
- Vikasietoisuus ilman palvelukatkoksia: Solmun vikaantuminen käynnistää sydämenlyöntitunnistuksen ja automaattisen uudelleenohjauksen toimiville replikoille. Manuaalista toimenpidettä tai huoltoikkunaa ei tarvita.
- Horisontaalinen skaalautuvuus: Uutta tallennuskapasiteettia saadaan lisäämällä solmuja klusteriin. Data tasapainottuu taustalla ilman, että käytössä oleva liikenne häiriintyy tai palvelu keskeytyy.
- Maantieteellinen hajauttaminen: Replikointi eri alueiden välillä lyhentää viiveitä maantieteellisesti hajallaan oleville käyttäjille. Samalla datan sijaintivaatimusten noudattamisesta tulee asetusvalinta eikä erillinen infrastruktuuriprojekti.
- Rinnakkainen I/O-läpäisy: Useat solmut käsittelevät lukuja ja kirjoituksia samanaikaisesti. Tämä on ainoa skaalautuva arkkitehtuuri tekoälyn ja koneoppimisen koulutusputkille, videon transkoodaukselle ja median suoratoistolle todellisissa tuotantomäärissä.
- Ei toimittajasidonnaisuutta avoimilla protokollilla: S3-yhteensopivat rajapinnat, NFS ja avoimen lähdekoodin alustat, kuten Ceph, mahdollistavat siirtymisen palveluntarjoajalta toiselle tai infrastruktuurin ajamisen omissa tiloissa ilman sovelluskoodin uudelleenkirjoittamista.
- Kustannustehokkuus mittakaavassa: Tavallinen laitteisto korvaa kalliit omistusoikeudelliset tallennusjärjestelmät. Pyyhkimiskoodaus (erasure coding) vähentää raakakapasiteettitarvetta jopa 50 % verrattuna täydelliseen replikointiin solmujen välillä.
Hajautetun tallennuksen rajoitteet ja haasteet
- Johdonmukaisuuden monimutkaisuus: Johdonmukaisen tilan ylläpitäminen solmujen välillä vaatii huolellista säätöä johdonmukaisuusmalleille, replikointikertoimille ja kvoorumiasetuksille. Virheasetus ei ilmoita itsestään äänekkäästi. Se ajautuu hiljaa datan eriytymiseen.
- Käytön ja ylläpidon kuormitus: Hajautetun tallennusklusterin ajaminen tarkoittaa vikaantumisalueiden suunnittelua, solmujen vaihtomenettelyjä, valvontaputkia ja suorituskyvyn viritystä. Yksi palvelin ei vaadi sinulta tätä kaikkea.
- Verkkoriippuvuus: Koko arkkitehtuuri olettaa luotettavan ja suurikaistaisen yhteyden solmujen välillä. Verkon heikkeneminen heijastuu suoraan ja suhteellisesti tallennuksen viiveisiin ja läpäisyyn.
- Viive pienissä satunnaisissa I/O-operaatioissa: Hajautettu tallennus on optimoitu suurille peräkkäisille lukuille ja rinnakkaiselle läpäisylle. Työkuormat, joissa on paljon pieniä satunnaisia I/O-operaatioita, erityisesti OLTP-tietokannat, toimivat usein paremmin paikallisesti liitetyllä NVMe-lohkotallennuksella.
- Käytännöllinen vähimmäiskoko: Hajautetun tallennuksen kustannus- ja monimutkaisuusedut eivät näy kahden solmun klusterissa. Tietyn rajan alapuolella hallinnoitu pilvitallennuspalvelu tai hyvin viritetty yksittäinen palvelin on yksinkertaisesti halvempi ja helpompi ylläpitää.
Hajautetun tallennuksen käyttötapaukset käytännössä
- Media ja suoratoisto: Netflix ja YouTube eivät tarjoa videoita keskitetystä sijainnista. Ne jakavat koodatun sisällön objektitallennusklustereihin, jotka sijaitsevat katsojien lähellä maantieteellisesti. Yksi konesali ei pysty käsittelemään samanaikaisia globaaleja suoratoistoja mittakaavassa. Pelkät kaistanleveyskustannukset olisivat kohtuuttomia. Hajautettu datan tallennus tekee suoratoiston taloudesta todella toimivan.
- Terveydenhuolto: Yksi MRI-tutkimus tuottaa 500 MB–1 GB kuvantamisdataa. Kerro tämä suuren sairaalaverkoston määrällä, eri kuvantamismenetelmillä, pitkillä säilytysajoilla ja useilla toimipisteillä, ja petatavuja kertyy nopeasti. Skaalautuva hajautettu tallennus maantieteellisellä redundanssilla mahdollistaa sen, että terveydenhuoltojärjestelmät voivat ylläpitää HIPAA-yhteensopivaa pääsyä potilastietoihin, vaikka alueellinen konesali vikaantuisi.
- Tekoäly ja koneoppiminen: Suuren kielimallin koulutus tarkoittaa GPU-klustereiden syöttämistä teratavuista petatavuihin dataa. Data luetaan epäjärjestyksessä, mikä kuormittaisi perinteisen tallennusjärjestelmän lähes välittömästi. Ceph, HDFS ja S3-yhteensopivat objektivarastot ovat vakiintuneet koneoppimisputkien infrastruktuurikerroksiksi, koska niiden rinnakkainen lukuläpäisy vastaa todella sitä, mitä GPU-klusterit kuluttavat.
- Varmuuskopiointi ja katastrofipalautus: Todellinen katastrofipalautus tarkoittaa, että data on olemassa vähintään kahdessa maantieteellisesti erillisessä paikassa, joilla on riippumattomat vikaantumisalueet. Kahden telineen sijoittaminen samaan rakennukseen ei riitä. Hajautetun tallennuskerroksen sisäiset replikointikäytännöt ja sijoittelusäännöt määrittelevät RPO- ja RTO-arvot infrastruktuuritasolla ilman erillistä varmuuskopiointiohjelmistopinoa. Vähemmän liikkuvia osia tarkoittaa myös pienempää hyökkäyspinta-alaa.
Hajautettu tallennus vs. desentralisoitu tallennus: mitä eroa on?
Hajautetussa tallennuksessa data on jaettu useille solmuille, mutta yksi organisaatio omistaa ja hallitsee kokonaisuutta. Organisaatio päättää käytännöistä, käyttöoikeuksista, poistamismahdollisuudesta ja lokeista. Desentralisoidussa tallennuksessa keskitetty valta poistetaan kokonaan. Data on hajallaan riippumattomissa vertaisverkon solmuissa, eikä yksikään operaattori voi yksin sensuroida, käyttää tai poistaa sitä.
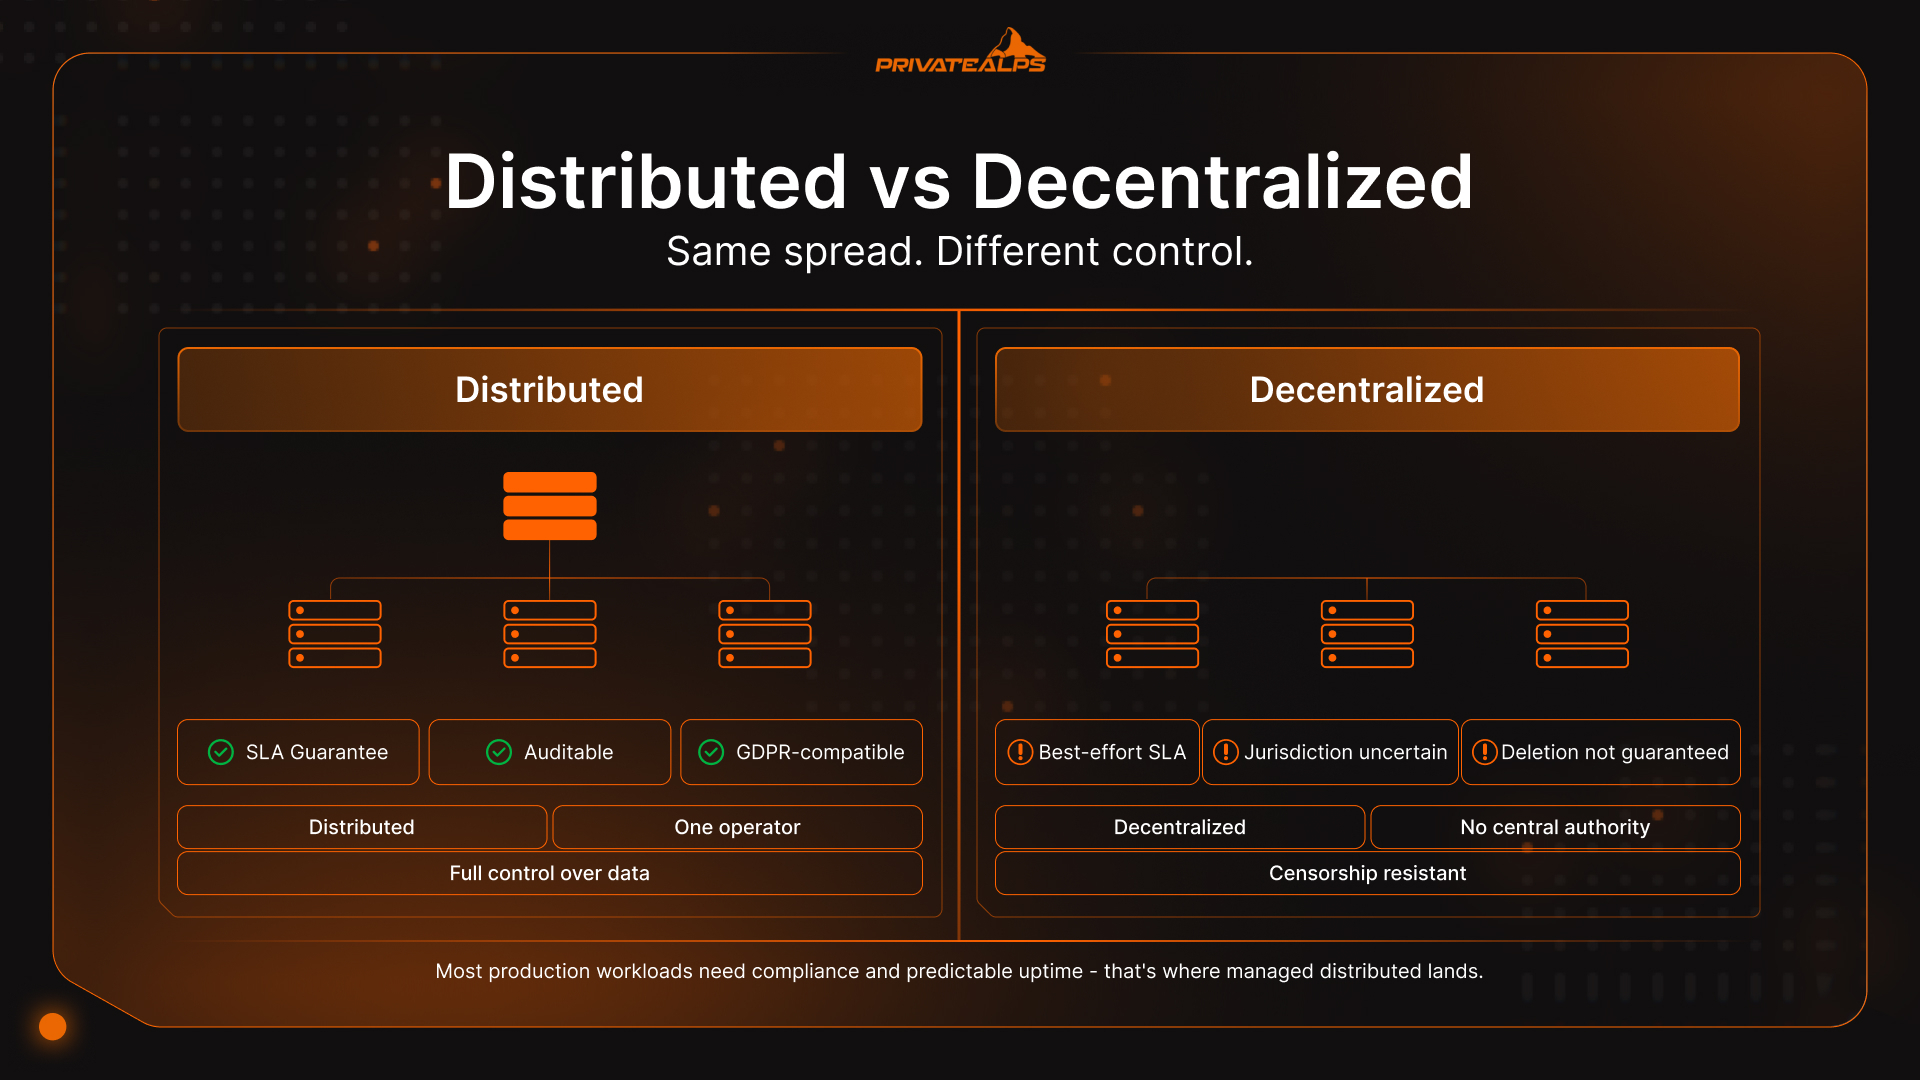
Tällä erolla on todellisia käytännön seurauksia. Keskitetysti hallittua hajautettua järjestelmää voidaan tarkastaa, päivittää, sitoa SLA-sopimuksiin ja saattaa sääntelyn vaatimustenmukaiseksi. Desentralisoitu järjestelmä vaihtaa kaiken tämän sensuurinkestävyyteen ja luottamuksettomaan toimintaan. Nämä ovat arvokkaita tietyissä yhteyksissä, mutta eivät sitä, mitä useimmat yritykset tuotantotallennusinfrastruktuurillaan tarvitsevat.
| Ulottuvuus | Hajautettu tallennus | Desentralisoitu tallennus |
|---|---|---|
| Hallinta | Keskitetysti hallinnoitu | Ei keskusta |
| SLA / käytettävyystakuut | Sopimukseen perustuvat takuut mahdollisia | Parhaan yrityksen mukaiset, protokollasta riippuvat |
| Vaatimustenmukaisuus | Tarkastettavissa, GDPR-yhteensopiva | Lainkäyttöalue epävarma |
| Tietojen poistaminen | Taattu | Ei aina mahdollista |
| Käyttöoikeuksien hallinta | Roolipohjainen, hallinnoitu | Kryptografinen, luottamukseton |
| Esimerkkejä | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Yksi lisäkerros kannattaa erottaa: monialueinen pilvitallennus (esimerkiksi AWS S3 alueiden välisellä replikoinnilla tai Azure geo-redundant storage) on edelleen keskitetysti hallinnoitua infrastruktuuria. Palveluntarjoaja hallitsee solmuja ja replikointia, ja sinä käytännössä vuokraat maantieteellisen sijainnin. Todelliset hajautetut pilvialustat, kuten Storj ja Cubbit, reitittävät dataa riippumattomien operaattoreiden kesken. Ne poistavat palveluntarjoajasidonnaisuuden, mutta avaavat uudelleen kysymyksiä SLA-sopimuksista ja tarkastusjäljistä. Useimmissa työkuormissa, jotka tarvitsevat vaatimustenmukaisuusdokumentointia ja ennustettavaa käytettävyyttä, hallinnoitu hajautettu ratkaisu on paras valinta.
Yhteenveto
Hajautettu tallennus ei ole yksittäinen tuote vaan arkkitehtuurikategoria, ja sopiva muoto riippuu täysin siitä, mitä ajat. Objekti-, lohko- ja tiedostotallennuksella on kullakin oma tietomallinsa, joka on suunniteltu eri käyttömalleille ja työkuormille. CAP-teoreema pakottaa aitoon kompromissiin johdonmukaisuuden ja saatavuuden välillä heti, kun verkkovirheitä ilmenee. Väärä ratkaisu voi maksaa kalliisti. Kun kyse on replikoinnista ja pyyhkimiskoodauksesta, datan lämpötila ratkaisee. Kuumat tiedot tarvitsevat replikointia viiveen takia, kylmät tiedot hyötyvät pyyhkimiskoodauksen tallennustehokkuudesta. Useimmille tiimeille hallinnoitu hajautettu ratkaisu, joka on yksityisen palveluntarjoajan tai julkisen pilven tarjoama, kunhan datan sijainti ja turvakontrollit ovat todennettavissa, tuo paremman tasapainon skaalautuvuuden, suorituskyvyn ja päivittäisen käytön yksinkertaisuuden välille kuin itse ylläpidetty klusteri.
Tallenna datasi Sveitsiin PrivateAlpsilla
Jos työkuormasi tarvitsee S3-yhteensopivaa hajautettua objektitallennusta todennettavalla datan sijainnilla, PrivateAlps tarjoaa sveitsiläiseen infrastruktuuriin perustuvan palvelun, joka täyttää sekä GDPR:n 45 artiklan että nFADP:n vaatimukset. Datasi pysyy Sveitsissä. Ei kolmansien osapuolten jakamista, ei epäselvää reititystä ulkomaisten lainkäyttöalueiden kautta, eikä yllätyksiä. Siirryitpä pois hyperskaalaajalta tai rakennat yksityisyyttä painottavaa hajautettua tallennusarkkitehtuuria alusta alkaen, PrivateAlps tarjoaa suorituskyvyn ja vaatimustenmukaisuuden varmuuden, jota työkuormasi todella tarvitsee.
UKK
Mikä on ero hajautetun tallennuksen ja pilvitallennuksen välillä?
Pilvitallennus on toimitustapa: joku muu hallinnoi infrastruktuuria, ja sinä käytät sitä internetin kautta käytön mukaan maksaen. Hajautettu tallennus on arkkitehtuuri, jossa data on jaettu useille solmuille varmuuden ja skaalautuvuuden takia. Nämä ovat toisistaan riippumattomia käsitteitä. Voit ajaa hajautettua tallennusta kokonaan omissa tiloissasi Cephillä tai MinIO:lla, ja pilvipalveluntarjoaja voi teknisesti tarjota keskitettyä tallennusta API:n takana. Useimmat pilvitallennuspalvelut käyttävät sisäisesti hajautettuja arkkitehtuureja, mutta se on toteutusyksityiskohta eikä pilvitallennuksen määritelmä.
Mikä on paras hajautettu tallennusjärjestelmä?
Yleistä vastausta ei ole. Se riippuu työkuormasta ja tietomallista. Jäsentymättömään dataan ja varmuuskopioihin S3-yhteensopivat objektivarastot, kuten MinIO tai Ceph RADOS, ovat tavallinen valinta. Tietokantavolyymeihin ja virtuaalikoneiden levyihin, jotka tarvitsevat johdonmukaista ja matalaviiveistä lohko-I/O:ta, Ceph RBD tai Lightbits sopii paremmin. Jaettuihin tiedostojärjestelmiin HPC- tai vanhoissa ympäristöissä tiimit päätyvät yleensä GlusterFS:ään tai HDFS:ään. Aloita käyttömallista, ja tallennusjärjestelmä seuraa siitä.
Onko hajautettu tallennus sama asia kuin RAID?
Ei ole. RAID toimii yhden palvelimen tai tallennustaulukon sisällä ja suojaa levyvikoja yhdessä koneessa. Hajautettu tallennus toimii erillisten fyysisten solmujen välillä, jotka on yhdistetty verkon kautta, ja ne voivat sijaita useissa rakennuksissa tai kokonaisissa konesaleissa. RAID ei auta, kun itse palvelin vikaantuu. Hajautetut tallennusjärjestelmät on suunniteltu nimenomaan sietämään solmuvikoja, telinevikoja ja koko konesalin katkoksia. Laajuudessa on perustavanlaatuinen ero.
Miten hajautettu tallennus käsittelee solmujen vikaantumisia?
Solmut lähettävät säännöllisesti sydämenlyöntisignaaleja klusterin metadatakerrokselle. Kun solmu lakkaa vastaamasta, järjestelmä tunnistaa vian yleensä muutamassa sekunnissa ja ohjaa pyynnöt solmuille, joilla on replikat tai pyyhkimiskoodatut osat. Replikointiin perustuvissa ratkaisuissa taustalla käynnistyy palautusprosessi, joka luo uudet kopiot, jotta määritelty replikointikerroin palautuu koko klusterissa. Kaikki tapahtuu automaattisesti. Hyvin konfiguroidussa hajautetussa tallennusklusterissa sovellukset eivät huomaa vikaa lainkaan.
Sopiiko hajautettu tallennus pienille yrityksille?
Hallinnoidut hajautetun tallennuksen palvelut, kuten pilvipalveluntarjoajan S3-yhteensopiva objektitallennus tai erikoistuneen palveluntarjoajan, kuten PrivateAlpsin, tarjoama palvelu, toimivat kaikenkokoisille yrityksille ilman klusterin vähimmäisvaatimusta. Itse ylläpidetyt hajautetun tallennuksen klusterit ovat eri asia: Cephin tuotantokäyttö vaatii yleensä vähintään kolmesta viiteen solmua, ennen kuin ylläpidon kuorma alkaa kannattaa. Pienille tiimeille hallinnoidut palvelut tarjoavat hajautetun tallennuksen arkkitehtuuriedut ilman infrastruktuurin hallinnan taakkaa.
