


डिस्ट्रीब्यूटेड स्टोरेज क्या है?
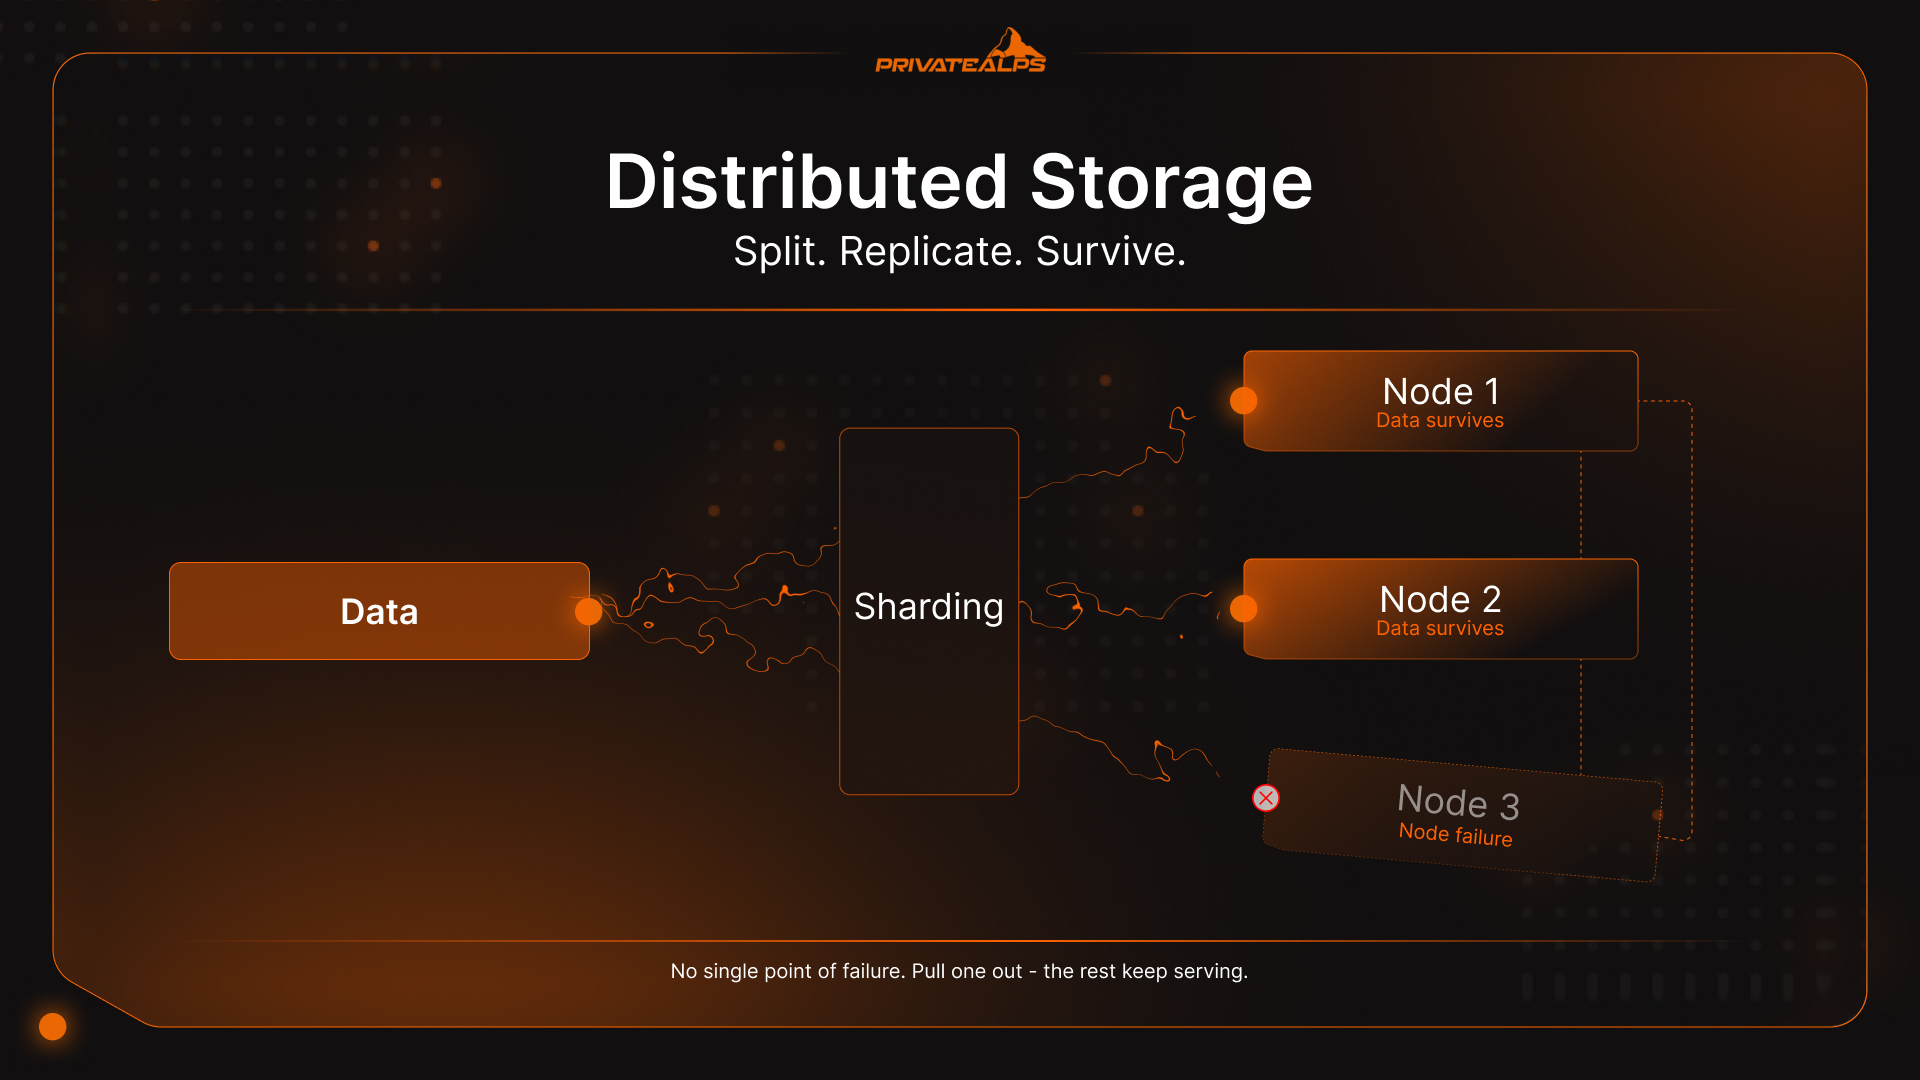
डिस्ट्रीब्यूटेड स्टोरेज आधुनिक इन्फ्रास्ट्रक्चर में उस डेटा को संभालने का तरीका है जो एक मशीन पर भरोसेमंद ढंग से रखने के लिए बहुत बड़ा, बहुत महत्वपूर्ण या बहुत ज़्यादा एक्सेस होने वाला होता है। सारा डेटा एक ही सर्वर पर लिखने के बजाय, सिस्टम उस डेटा को कई स्वतंत्र नोड्स में बाँटता है, दोहराता है या एन्कोड करता है। ये नोड्स सर्वर, ड्राइव या डेटा सेंटर हो सकते हैं। वे मिलकर काम करते हैं, लेकिन कोई एक नोड सारा डेटा नहीं रखता। अगर एक नोड हटा दिया जाए, तो बाकी नोड सेवा देते रहते हैं। यह गाइड बताती है कि लोड के तहत डिस्ट्रीब्यूटेड स्टोरेज सिस्टम वास्तव में कैसे व्यवहार करते हैं, वे किन आर्किटेक्चरल ट्रेड-ऑफ़ को जन्म देते हैं, और कौन-सा स्टोरेज प्रकार किस वर्कलोड के लिए सही है।
AI सारांश
डिस्ट्रीब्यूटेड स्टोरेज एक सॉफ़्टवेयर-डिफ़ाइंड आर्किटेक्चर है जो तीन मुख्य तकनीकों का उपयोग करके डेटा को कई भौतिक नोड्स में बाँटता है: शार्डिंग (डेटा को अलग-अलग हिस्सों में बाँटना, जो अलग-अलग नोड्स पर भेजे जाते हैं), रेप्लिकेशन (तेज़ एक्सेस के लिए नोड्स पर एक जैसी कई प्रतियाँ रखना), और इरेज़र कोडिंग (डेटा को गणितीय पैरिटी के साथ टुकड़ों में एन्कोड करना, ताकि कोई भी उपसमूह पूरे डेटा को दोबारा बना सके)।
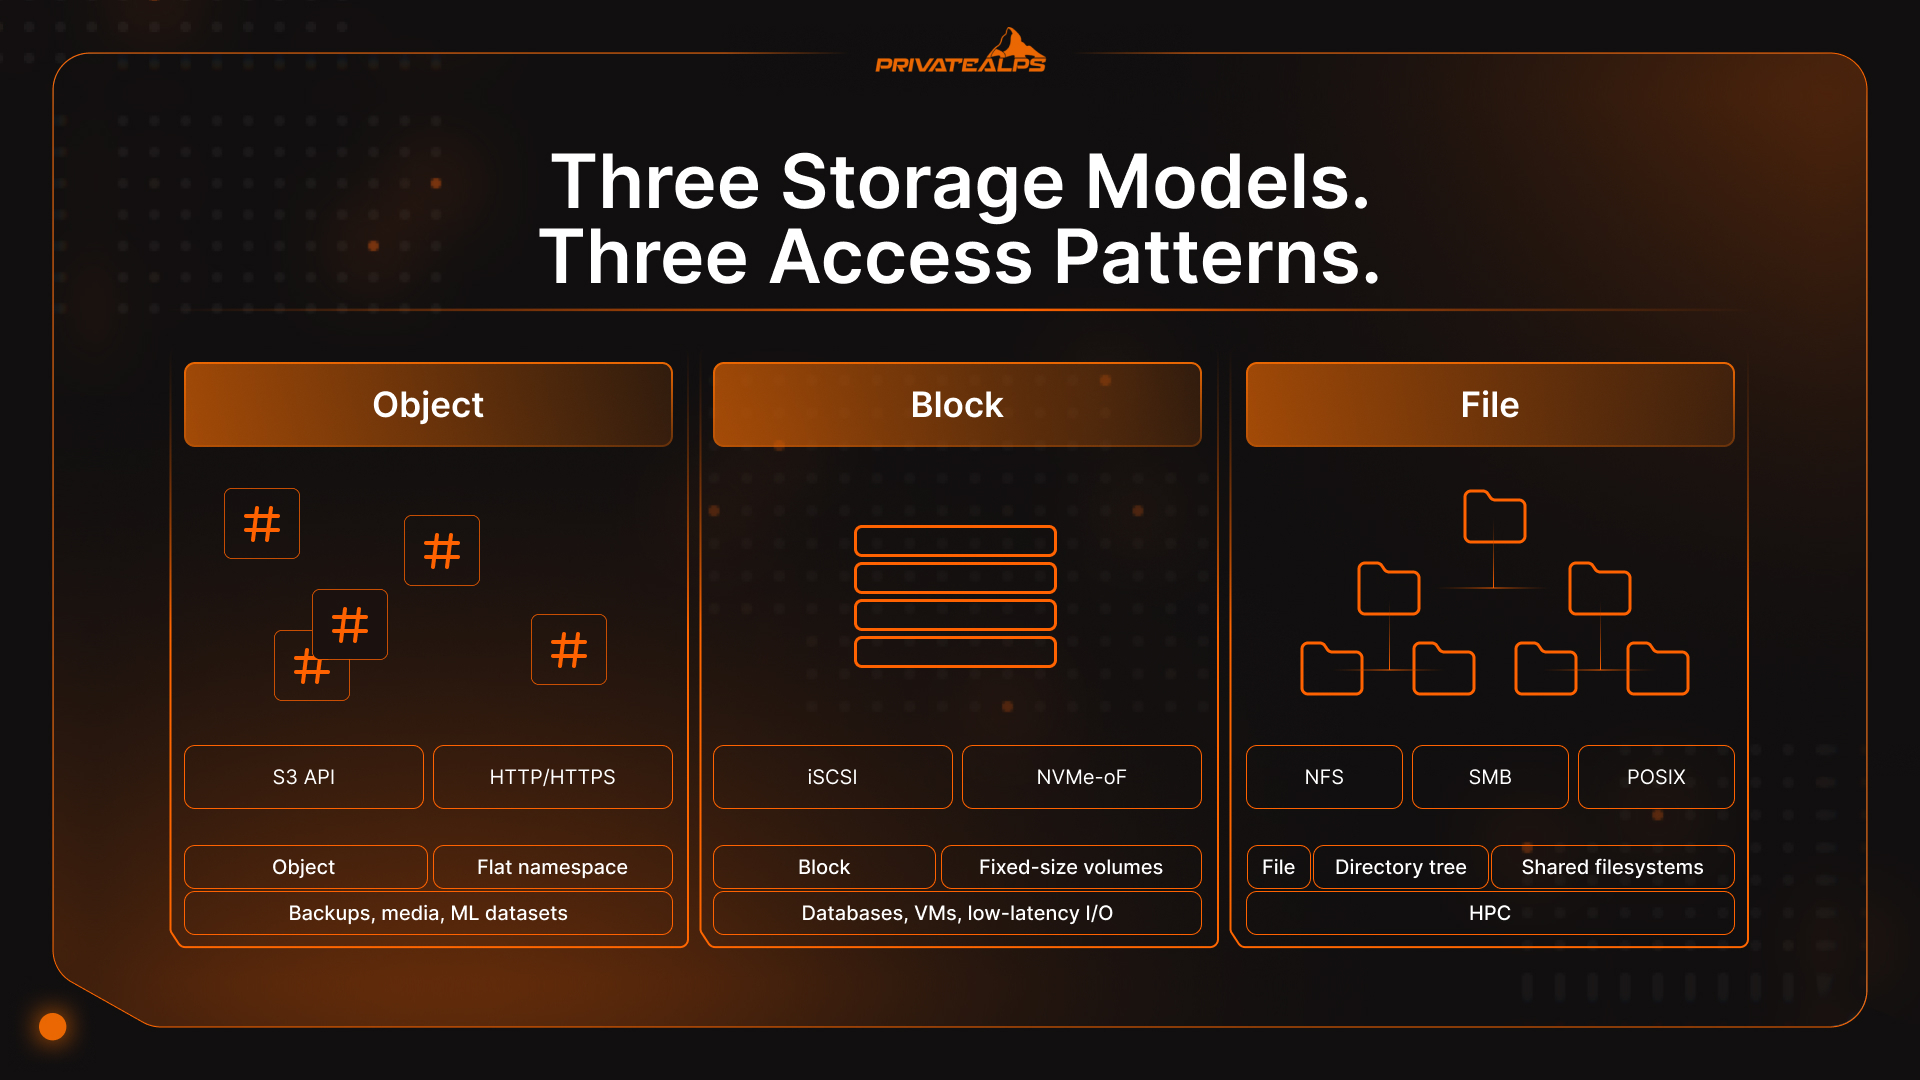
डिस्ट्रीब्यूटेड स्टोरेज सिस्टम के तीन मुख्य प्रकार होते हैं: ऑब्जेक्ट स्टोरेज (फ्लैट नेमस्पेस, S3-कम्पैटिबल API), ब्लॉक स्टोरेज (कम-लेटेंसी रैंडम I/O के लिए फिक्स्ड-साइज़ वॉल्यूम), और फाइल स्टोरेज (NFS या SMB के ज़रिए हाइरार्किकल नेमस्पेस)। हर डिस्ट्रीब्यूटेड डेटा स्टोरेज सेटअप को CAP थ्योरम की सीमा का सामना करना पड़ता है: यह एक साथ केवल दो चीज़ों की गारंटी दे सकता है, कंसिस्टेंसी, अवेलेबिलिटी और पार्टिशन टॉलरेंस में से।
इसका मुख्य परिचालन लाभ यह है कि नोड फेलियर से आउटेज नहीं होता; सिस्टम अपने-आप अनुरोधों को बचे हुए रेप्लिकाओं की ओर भेज देता है।
दाँव पर लगे पैमाने को समझें: मानवता हर दिन 40,00,00,000 TB से ज़्यादा नया डेटा बनाती है। इतनी मात्रा को कोई सेंट्रलाइज़्ड आर्किटेक्चर अपने ही बोझ तले दबे बिना नहीं संभाल सकता।
डिस्ट्रीब्यूटेड स्टोरेज बनाम सेंट्रलाइज़्ड स्टोरेज
सेंट्रलाइज़्ड स्टोरेज सब कुछ एक ही जगह रखता है: एक सर्वर, एक SAN, एक डेटा सेंटर। पूरा मॉडल बस इतना ही है। जब उस जगह पर कोई समस्या आती है, तो सब कुछ रुक जाता है। डिस्ट्रीब्यूटेड स्टोरेज इस समस्या का सीधा समाधान करता है: डेटा कई स्वतंत्र नोड्स में रहता है, इसलिए कोई एक फेलियर पॉइंट पूरे सिस्टम को ऑफ़लाइन नहीं कर सकता या सारी एक्सेस नहीं रोक सकता।
एक हार्डवेयर फेलियर और एक्सेस बंद। बस। स्केल करने के लिए मुख्य सिस्टम को अपग्रेड या बदलना पड़ता है, जिसमें आमतौर पर डाउनटाइम और एक ऐसी कैपिटल एक्सपेंडिचर वाली बातचीत होती है जिससे कोई नहीं गुज़रना चाहता। डिस्ट्रीब्यूटेड स्टोरेज डिज़ाइन से ही इन दोनों समस्याओं से बच जाता है: बढ़ने के लिए एक नोड जोड़ें, और जब कोई नोड खराब हो, तो क्लस्टर उसके आसपास से रास्ता बना लेता है। कोई हंगामा नहीं, कोई आउटेज नहीं। कुछ टूटने से पहले ही डेटा कई नोड्स पर मौजूद था।
| पैमाना | सेंट्रलाइज़्ड स्टोरेज | डिस्ट्रीब्यूटेड स्टोरेज |
|---|---|---|
| फॉल्ट टॉलरेंस | एकल फेलियर पॉइंट | व्यक्तिगत नोड खोने पर भी डेटा सुरक्षित |
| स्केलेबिलिटी | वर्टिकल (हार्डवेयर अपग्रेड) | हॉरिज़ॉन्टल (नोड जोड़ें) |
| लेटेंसी | लोकल एक्सेस के लिए कम | परिवर्तनशील; नेटवर्क टोपोलॉजी पर निर्भर |
| छोटे पैमाने पर लागत | कम शुरुआती लागत | अधिक न्यूनतम व्यवहार्य क्लस्टर |
| बड़े पैमाने पर लागत | स्केल करना महंगा | कमोडिटी हार्डवेयर से लागत घटती है |
| भौगोलिक वितरण | एकल स्थान | कॉन्फ़िगरेशन से मल्टी-रीजन |
| परिचालन जटिलता | प्रबंधन में सरल | ऑर्केस्ट्रेशन टूलिंग की आवश्यकता |
डिस्ट्रीब्यूटेड स्टोरेज सिस्टम कैसे काम करते हैं
एक डिस्ट्रीब्यूटेड स्टोरेज सिस्टम आने वाले डेटा को लेता है, उसे टुकड़ों में तोड़ता है, उन टुकड़ों को क्लस्टर के सही नोड्स तक पहुँचाता है, और मेटाडेटा लेयर के ज़रिए हर हिस्से को ट्रैक करता है, ताकि कोई भी टुकड़ा किसी भी नोड पर हो, माँगने पर खोजा, प्राप्त किया और दोबारा जोड़ा जा सके। यही बुनियादी चक्र है। इसे चार यांत्रिकी शक्ति देती हैं:
- शार्डिंग (डेटा पार्टिशनिंग) जब डेटा आता है, तो सिस्टम उसे छोटे हिस्सों में काटता है (शार्ड या ब्लॉक) और उन्हें नोड्स पर फैलाता है। इसी से पैरेलल I/O संभव होता है: कई नोड्स एक साथ रीड और राइट संभालते हैं, इसलिए थ्रूपुट एक मशीन की सीमा पर अटकने के बजाय क्लस्टर के आकार के साथ बढ़ता है। रूटिंग लॉजिक आमतौर पर कंसिस्टेंट हैशिंग होता है, जो क्लस्टर बढ़ने पर भी वितरण को समान रखता है, और हर नोड जुड़ने पर सब कुछ दोबारा व्यवस्थित नहीं करना पड़ता।
- रेप्लिकेशन सीधा लेकिन प्रभावी तरीका: हर शार्ड की N एक जैसी प्रतियाँ अलग-अलग नोड्स पर रखना, आमतौर पर तीन। अगर एक नोड ऑफ़लाइन हो जाए, तो बाकी दो तुरंत सेवा देते रहते हैं। न पुनर्निर्माण, न इंतज़ार। हॉट डेटा के लिए रेप्लिकेशन सही विकल्प है, जैसे सक्रिय डेटाबेस, रियल-टाइम फ़ीड, या ऐसा कोई भी काम जहाँ रीड पर एक अतिरिक्त मिलीसेकंड भी वास्तव में नुकसान करता हो।
- इरेज़र कोडिंग यहीं स्टोरेज दक्षता का गणित दिलचस्प हो जाता है। तीन पूरी प्रतियों के बजाय, सिस्टम किसी ऑब्जेक्ट को $k$ डेटा फ्रैगमेंट और $m$ पैरिटी फ्रैगमेंट में एन्कोड करता है, सभी $k+m$ को नोड्स पर बाँटता है, और किन्हीं $k$ से पूरा ऑब्जेक्ट दोबारा बना सकता है। इसलिए $m$ नोड्स एक साथ फेल हो सकते हैं और कुछ भी नहीं खोता। एक Reed-Solomon RS(6,3) कॉन्फ़िगरेशन 3x रेप्लिकेशन में लगने वाले 18 ब्लॉक के बजाय 9 ब्लॉक स्टोर करता है, जिससे कच्चे स्टोरेज का ओवरहेड 200% से घटकर लगभग 50% रह जाता है। नुकसान यह है कि एन्कोड/डिकोड में CPU चक्र खर्च होते हैं, और इरेज़र कोडिंग कोल्ड डेटा पर बेहतर काम करती है, यानी ऐसी सामग्री जो शायद ही कभी बदली या ज़्यादा बार एक्सेस की जाती है। बार-बार छोटे राइट वाले वर्कलोड के लिए, लेटेंसी में 3x रेप्लिकेशन अब भी आगे रहता है।
| सुरक्षा विधि | स्टोरेज ओवरहेड | सबसे उपयुक्त | ट्रेड-ऑफ़ |
|---|---|---|---|
| 3x रेप्लिकेशन | 3x कच्ची क्षमता | हॉट डेटा, कम-लेटेंसी वर्कलोड | बड़े पैमाने पर उच्च स्टोरेज लागत |
| इरेज़र कोडिंग RS(6,3) | 1.5x कच्ची क्षमता | कोल्ड डेटा, आर्काइव, बड़े ऑब्जेक्ट | CPU ओवरहेड, अधिक रीबिल्ड लेटेंसी |
- मेटाडेटा रूटिंग हर डिस्ट्रीब्यूटेड स्टोरेज सिस्टम एक मेटाडेटा लेयर रखता है, जो मूल रूप से एक नक्शा है कि कौन-सा शार्ड किस नोड पर है। जब कोई क्लाइंट डेटा माँगता है, तो मेटाडेटा सर्विस सही नोड्स पहचानती है, और सिस्टम क्लाइंट को जटिलता देखे बिना फ्रैगमेंट प्राप्त करके जोड़ता है। Ceph या HDFS जैसे बड़े पैमाने के क्लस्टर में मेटाडेटा लेयर खुद नोड्स पर फैली होती है। इसे ऐसा होना ही पड़ता है। एक अकेला मेटाडेटा सर्वर वही बॉटलनेक बन जाता है, जिससे आप बचना चाहते थे।
डिस्ट्रीब्यूटेड स्टोरेज सिस्टम के प्रकार
डिस्ट्रीब्यूटेड स्टोरेज कोई एक चीज़ नहीं है। यह एक श्रेणी है, जिसके नीचे तीन अलग डेटा मॉडल हैं, और किसी वर्कलोड के लिए गलत मॉडल चुनना आश्चर्यजनक रूप से आम और महंगी गलती है। ऑब्जेक्ट, ब्लॉक और फाइल स्टोरेज में से हर एक अलग समस्या हल करता है। डिस्ट्रीब्यूटेड डेटाबेस, जैसे Cassandra, CockroachDB, Google Spanner, एक चौथा प्रकार हैं, जो डिस्ट्रीब्यूटेड डेटा मैनेजमेंट के ऊपर क्वेरी सिमैंटिक्स जोड़ते हैं, पर वह एक अलग चर्चा है।
| प्रकार | डेटा कैसे स्टोर होता है | एक्सेस विधि | सबसे उपयुक्त | उदाहरण |
|---|---|---|---|---|
| ऑब्जेक्ट | फ्लैट नेमस्पेस, मेटाडेटा-समृद्ध ऑब्जेक्ट | S3-कम्पैटिबल API (HTTP/HTTPS) | बड़े पैमाने पर अनस्ट्रक्चर्ड डेटा: बैकअप, मीडिया, ML डेटासेट | AWS S3, MinIO, Ceph RADOS |
| ब्लॉक | फिक्स्ड-साइज़ रॉ वॉल्यूम | iSCSI, NVMe-oF, FC | डेटाबेस, VM, कम-लेटेंसी रैंडम I/O | Ceph RBD, AWS EBS, Lightbits |
| फाइल | हाइरार्किकल डायरेक्टरी ट्री | NFS, SMB, POSIX | शेयर्ड फाइलसिस्टम, HPC, होम डायरेक्टरी | GlusterFS, HDFS, Azure Files |
डिस्ट्रीब्यूटेड ऑब्जेक्ट स्टोरेज
डिस्ट्रीब्यूटेड ऑब्जेक्ट स्टोरेज डेटा को एक फ्लैट नेमस्पेस में अलग-अलग, अपरिवर्तनीय ऑब्जेक्ट के रूप में व्यवस्थित करता है। इसमें कोई डायरेक्टरी, फाइल पाथ या बनाए रखने वाला कोई पदानुक्रम नहीं होता। हर ऑब्जेक्ट को एक अनोखा पहचानकर्ता (हैश या UUID) और समृद्ध मेटाडेटा मिलता है, और आप उस तक HTTP पर S3-कम्पैटिबल API के ज़रिए पहुँचते हैं। चूँकि ऑब्जेक्ट्स आंशिक रूप से अपडेट होने के बजाय बदले जाते हैं, इसलिए ब्लॉक और फाइल सिस्टम में प्रदर्शन को सीमित करने और स्केलेबिलिटी घटाने वाली लॉकिंग समस्या लगभग खत्म हो जाती है। इसी तरह AWS S3, Azure Blob और Ceph एक्साबाइट तक स्केल करते हैं: न नेमस्पेस समन्वय का ओवरहेड, न लॉक कॉन्टेंशन, और क्लस्टर का कोई भी नोड किसी भी ऑब्जेक्ट अनुरोध को स्वतंत्र रूप से सेवा दे सकता है।
डिस्ट्रीब्यूटेड ब्लॉक स्टोरेज
ब्लॉक स्टोरेज सर्वरों को कच्चे वॉल्यूम देता है: अनोखे पतों वाले फिक्स्ड-साइज़ ब्लॉक, उनके ऊपर कोई फाइलसिस्टम एब्स्ट्रैक्शन नहीं। एप्लिकेशन सीधे ब्लॉक्स पर लिखते हैं, और यही डेटाबेस, VM डिस्क और कंटेनराइज़्ड वर्कलोड के लिए लगातार, कम-लेटेंसी रैंडम I/O देता है। एक आर्किटेक्चरल सीमा लोगों को अक्सर चौंकाती है: एक ब्लॉक वॉल्यूम आम तौर पर एक समय में केवल एक सर्वर पर माउंट हो सकता है। कई सर्वरों के साझा एक्सेस के लिए ऊपर से अतिरिक्त ऑर्केस्ट्रेशन चाहिए, जैसे ब्लॉक डिवाइस पर बिछाया गया क्लस्टर फाइलसिस्टम।
डिस्ट्रीब्यूटेड फाइल स्टोरेज
फाइल स्टोरेज मानक प्रोटोकॉल के ज़रिए एक शेयर्ड फाइलसिस्टम देता है: NFS, SMB, POSIX-कम्पैटिबल एक्सेस। कई क्लाइंट एक ही समय में एक ही वॉल्यूम माउंट कर सकते हैं, इसलिए यह सहयोगी वर्कलोड, HPC वातावरण और ऐसे लीगेसी एप्लिकेशन के लिए स्वाभाविक विकल्प है जो डायरेक्टरी ट्री की अपेक्षा करते हैं और जिन्हें निकट भविष्य में दोबारा नहीं लिखा जाने वाला। असली दुनिया का ट्रेड-ऑफ़ यह है: डिस्ट्रीब्यूटेड नोड्स पर एक सुसंगत डायरेक्टरी नेमस्पेस बनाए रखने से समन्वय ओवरहेड पैदा होता है, जो पैमाने के साथ बढ़ता जाता है। ज़्यादातर हाइपरस्केलर, वॉल्यूम काफ़ी बड़े होने पर, प्राथमिक डेटा के लिए डिस्ट्रीब्यूटेड फाइल स्टोरेज से डिस्ट्रीब्यूटेड ऑब्जेक्ट स्टोरेज की ओर माइग्रेट कर जाते हैं।
CAP थ्योरम: डिस्ट्रीब्यूटेड स्टोरेज में अपरिहार्य ट्रेड-ऑफ़
CAP थ्योरम कहता है कि एक डिस्ट्रीब्यूटेड डेटा सिस्टम एक समय में तीन में से केवल दो चीज़ों की गारंटी दे सकता है: कंसिस्टेंसी (हर रीड सबसे नया राइट लौटाता है), अवेलेबिलिटी (हर अनुरोध को जवाब मिलता है), और पार्टिशन टॉलरेंस (नेटवर्क बँटने पर भी सिस्टम चलता रहता है)। नेटवर्क बँटते हैं, इसलिए पार्टिशन टॉलरेंस वैकल्पिक नहीं है। असली निर्णय हमेशा तब होता है जब कोई फेलियर आता है और तय करना होता है कि कंसिस्टेंसी या अवेलेबिलिटी में से किसे चुनें।
[Eric Brewer ने 2000 में CAP प्रस्तुत किया; Gilbert और Lynch ने 2002 में इसका प्रमाण औपचारिक रूप से दिया][https://www.scylladb.com/glossary/cap-theorem/]। यह आज भी वह निर्णय है जो डिस्ट्रीब्यूटेड स्टोरेज आर्किटेक्चर की बाकी हर चीज़ को आकार देता है, क्योंकि यह तय करता है कि सिस्टम ठीक उसी क्षण कैसा व्यवहार करेगा जब आपको उसकी सबसे ज़्यादा ज़रूरत हो, यानी जब कुछ पहले से टूटा हुआ हो।
| सिस्टम | CAP प्रकार | पार्टिशन के दौरान व्यवहार | सबसे उपयुक्त |
|---|---|---|---|
| MongoDB | CP (मेजॉरिटी रीड/राइट कंसर्न के साथ) | कंसिस्टेंसी बहाल होने तक अनुरोध अस्वीकार करता है | वित्तीय रिकॉर्ड, इन्वेंट्री, बुकिंग |
| HBase | CP | पुराने डेटा के बजाय एरर लौटाता है | संरचित एनालिटिक्स, कंसिस्टेंट बैच जॉब |
| Apache Cassandra | AP | उपलब्ध रहता है; पुराने रीड दे सकता है | सोशल फ़ीड, मैसेजिंग, IoT टेलीमेट्री |
| DynamoDB (डिफ़ॉल्ट) | AP | हमेशा जवाब देता है; असंगति को असिंक्रोनस रूप से सुलझाता है | हाई-थ्रूपुट कंज़्यूमर ऐप्स |
| CockroachDB | CP | पहले कंसिस्टेंसी, डिस्ट्रीब्यूटेड SQL | ग्लोबल ट्रांज़ैक्शनल वर्कलोड |
व्यावहारिक निर्णय यह है: क्या आपका वर्कलोड पुराना रीड सह सकता है? बैंक बैलेंस, सीट रिज़र्वेशन, इन्वेंट्री काउंट, इनमें शायद नहीं। CP चुनें। सोशल फ़ीड, सेंसर इवेंट स्ट्रीम, एनालिटिक्स टेलीमेट्री, इनमें कुछ सेकंड की पुरानी जानकारी चल जाती है। AP चुनें और अवेलेबिलिटी की गारंटी बनाए रखें।
डिस्ट्रीब्यूटेड स्टोरेज सुरक्षा: एन्क्रिप्शन और डेटा सॉवरेनटी
डिस्ट्रीब्यूटेड स्टोरेज की सुरक्षा तीन अलग परतों पर टिकी होती है: डेटा एट रेस्ट, डेटा इन ट्रांजिट, और की ओनरशिप। इनमें से किसी एक में भी चूक हो जाए, तो बाकी दो परतें आपको नहीं बचाएँगी। इंफ्रास्ट्रक्चर पूरी तरह उपलब्ध हो सकता है, फिर भी संवेदनशील डेटा चुपचाप गलत लोगों की पहुँच में हो सकता है।
एन्क्रिप्शन को तीनों परतों को कवर करना होगा। डेटा एट रेस्ट के लिए आम तौर पर AES-256 इस्तेमाल होता है, जिसकी की या तो प्रोवाइडर-मैनेज्ड होती है या कस्टमर-मैनेज्ड की (CMK)। प्रोवाइडर-मैनेज्ड की संचालन में आसान होती है, लेकिन इसमें की-मटीरियल स्टोरेज वेंडर के पास रहता है, और ऑडिट से गुजरने वाले रेगुलेटेड उद्योगों के लिए यह एक गंभीर सुरक्षा विचार है। क्लाइंट-साइड एन्क्रिप्शन इस जोखिम को पूरी तरह खत्म कर देता है। डेटा क्लाइंट से बाहर जाने से पहले ही एन्क्रिप्ट हो जाता है, इसलिए चाहे कोई भी कानूनी अनुरोध आए, प्रोवाइडर कभी प्लेनटेक्स्ट नहीं देखता। डेटा इन ट्रांजिट के लिए TLS 1.3 न्यूनतम सुरक्षा मानक है। जो भी सिस्टम अब भी TLS 1.2 की अनुमति देता है, उसके लिए अधिकांश मौजूदा कंप्लायंस फ्रेमवर्क के तहत दस्तावेज़ीकृत अपवाद की ज़रूरत होती है।
डेटा सॉवरेनटी अक्सर टीमों को अनजाने में चौंका देती है। डेटा उस देश के कानूनों के अधीन होता है जहाँ वह भौतिक रूप से रखा गया है, न कि कंपनी के देश या यूज़र की लोकेशन के अधीन। स्विट्ज़रलैंड को GDPR Article 45 के तहत अडेक्वेसी स्टेटस प्राप्त है, इसलिए EU से स्विट्ज़रलैंड में डेटा ट्रांसफर अतिरिक्त कॉन्ट्रैक्चुअल सेफगार्ड के बिना हो सकता है। संशोधित Federal Act on Data Protection (nFADP) स्विस घरेलू नियमों को GDPR के अनुरूप लाता है। इसका मतलब है कि स्विस इंफ्रास्ट्रक्चर दोनों फ्रेमवर्क में एक साथ एकसमान नियामक सुरक्षा देता है।
एक बात जिसे टालना आसान है, लेकिन टालनी नहीं चाहिए: आज अधिकांश स्टोरेज इंफ्रास्ट्रक्चर को सुरक्षित रखने वाले क्रिप्टोग्राफ़िक एल्गोरिदम सक्षम क्वांटम कंप्यूटर से बचने के लिए डिज़ाइन नहीं किए गए थे। NIST ने अगस्त 2024 में तीन पोस्ट-क्वांटम क्रिप्टोग्राफ़ी मानक अंतिम रूप दिए, जिनमें FIPS 203 (ML-KEM) भी शामिल है। अगर आपके डिस्ट्रीब्यूटेड डेटा स्टोरेज में लंबी अवधि तक रखे जाने वाले रिकॉर्ड हैं, जैसे मेडिकल आर्काइव, वित्तीय रिकॉर्ड या कानूनी दस्तावेज़, तो “अभी हार्वेस्ट करो, बाद में डिक्रिप्ट करो” वाला खतरा पहले से सक्रिय है। मूल्यांकन की समयसीमा इन आर्काइव के परिपक्व होने से काफी पहले शुरू हो जानी चाहिए।
डिस्ट्रीब्यूटेड स्टोरेज के मुख्य फायदे
- सेवा रुके बिना फॉल्ट टॉलरेंस: नोड फेल होने पर हार्टबीट डिटेक्शन चालू होता है और ट्रैफ़िक अपने-आप बचे हुए रेप्लिका की ओर मोड़ दिया जाता है। इसके लिए न मैन्युअल हस्तक्षेप चाहिए, न किसी मेंटेनेंस विंडो की ज़रूरत होती है।
- हॉरिज़ॉन्टल स्केलेबिलिटी: क्लस्टर में नए नोड जोड़कर स्टोरेज क्षमता बढ़ाई जा सकती है। डेटा बैकग्राउंड में री-बैलेंस होता है, बिना लाइव ट्रैफ़िक को प्रभावित किए या डाउनटाइम के।
- भौगोलिक वितरण: रीजन के बीच रेप्लिकेशन भौगोलिक रूप से बिखरे यूज़र्स के लिए लेटेंसी घटाता है, और डेटा रेज़िडेंसी कंप्लायंस को एक इंफ्रास्ट्रक्चर प्रोजेक्ट के बजाय कॉन्फ़िगरेशन का निर्णय बना देता है।
- पैरेलल I/O थ्रूपुट: कई नोड एक साथ रीड और राइट संभालते हैं। वास्तविक प्रोडक्शन स्तर पर AI/ML ट्रेनिंग पाइपलाइन, वीडियो ट्रांसकोडिंग या मीडिया स्ट्रीमिंग के लिए यही एकमात्र स्केलेबल आर्किटेक्चर है।
- ओपन प्रोटोकॉल के साथ कोई वेंडर लॉक-इन नहीं: S3-compatible APIs, NFS और Ceph जैसे ओपन-सोर्स प्लेटफ़ॉर्म टीमों को एप्लिकेशन कोड दोबारा लिखे बिना प्रोवाइडर बदलने या ऑन-प्रिमाइसेस इंफ्रास्ट्रक्चर चलाने देते हैं।
- बड़े पैमाने पर लागत दक्षता: कमोडिटी हार्डवेयर महंगे प्रोप्राइटरी स्टोरेज एरे की जगह लेता है। इरेज़र कोडिंग नोड्स में पूरी रेप्लिकेशन की तुलना में कच्ची क्षमता की ज़रूरत को 50% तक घटा सकता है।
डिस्ट्रीब्यूटेड स्टोरेज की सीमाएँ और चुनौतियाँ
- कंसिस्टेंसी की जटिलता: नोड्स के बीच एकसमान स्थिति बनाए रखने के लिए कंसिस्टेंसी मॉडल, रेप्लिकेशन फ़ैक्टर और quorum सेटिंग्स को सावधानी से ट्यून करना पड़ता है। गलत कॉन्फ़िगरेशन ज़ोर से संकेत नहीं देता, बल्कि डेटा को चुपचाप असंगत स्थिति में ले जाता है।
- ऑपरेशनल ओवरहेड: डिस्ट्रीब्यूटेड स्टोरेज क्लस्टर चलाने का मतलब है फ़ेल्योर डोमेन की योजना, नोड बदलने की प्रक्रियाएँ, मॉनिटरिंग पाइपलाइन और परफ़ॉर्मेंस ट्यूनिंग संभालना। एक अकेले सर्वर से इतनी माँगें नहीं होतीं।
- नेटवर्क पर निर्भरता: पूरा आर्किटेक्चर नोड्स के बीच भरोसेमंद, उच्च-बैंडविड्थ कनेक्टिविटी मानकर चलता है। नेटवर्क की गिरावट सीधे और अनुपात में स्टोरेज लेटेंसी और थ्रूपुट के नुकसान में बदल जाती है।
- छोटे रैंडम I/O में लेटेंसी: डिस्ट्रीब्यूटेड स्टोरेज बड़े सीक्वेंशियल रीड और पैरेलल थ्रूपुट के लिए ऑप्टिमाइज़ होता है। भारी छोटे-रैंडम I/O वाले वर्कलोड, खासकर OLTP डेटाबेस, अक्सर लोकली अटैच्ड NVMe ब्लॉक स्टोरेज पर बेहतर चलते हैं।
- न्यूनतम व्यवहार्य पैमाना: डिस्ट्रीब्यूटेड स्टोरेज के लागत और जटिलता के फायदे दो-नोड क्लस्टर पर नज़र नहीं आते। एक निश्चित सीमा से नीचे, मैनेज्ड क्लाउड स्टोरेज सर्विस या अच्छी तरह ट्यून किया गया एक सिंगल सर्वर सीधे सस्ता और चलाने में आसान होता है।
डिस्ट्रीब्यूटेड स्टोरेज के वास्तविक उपयोग
- मीडिया और स्ट्रीमिंग Netflix और YouTube वीडियो एक केंद्रीय लोकेशन से नहीं देते। वे एन्कोडेड कंटेंट को दर्शकों के भौगोलिक रूप से करीब स्थित ऑब्जेक्ट स्टोरेज क्लस्टर में बाँटते हैं। एक अकेला डेटा सेंटर बड़े पैमाने पर एक साथ वैश्विक स्ट्रीम नहीं संभाल सकता; केवल बैंडविड्थ की लागत ही निषेधात्मक होती। स्ट्रीमिंग का अर्थशास्त्र वास्तव में डिस्ट्रीब्यूटेड डेटा स्टोरेज से ही काम करता है।
- हेल्थकेयर एक MRI स्टडी 500 MB से 1 GB इमेजिंग डेटा पैदा करती है। इसे किसी बड़े अस्पताल नेटवर्क में गुणा करें, जहाँ अलग-अलग मोडैलिटी, लंबी रिटेंशन आवश्यकताएँ और कई साइट्स हों, तो तेज़ी से पेटाबाइट्स जमा होते दिखते हैं। भौगोलिक रिडंडेंसी वाला स्केलेबल डिस्ट्रीब्यूटेड स्टोरेज ही वह तरीका है जिससे हेल्थ सिस्टम किसी क्षेत्रीय डेटा सेंटर के फेल होने पर भी मरीज़ रिकॉर्ड तक HIPAA-compliant पहुँच बनाए रखते हैं।
- AI और मशीन लर्निंग किसी बड़े लैंग्वेज मॉडल को ट्रेन करने के लिए GPU क्लस्टर को टेराबाइट से पेटाबाइट तक का डेटा देना पड़ता है, और यह डेटा नॉन-सीक्वेंशियल पैटर्न में एक्सेस होता है, जो किसी पारंपरिक स्टोरेज सिस्टम को लगभग तुरंत ओवरलोड कर देगा। Ceph, HDFS और S3-compatible ऑब्जेक्ट स्टोर ML पाइपलाइन के लिए मानक इंफ्रास्ट्रक्चर लेयर बन गए हैं, क्योंकि उनका पैरेलल रीड थ्रूपुट वास्तव में उतना ही है जितना GPU क्लस्टर खपाते हैं।
- बैकअप और डिज़ास्टर रिकवरी असली डिज़ास्टर रिकवरी का मतलब है कि डेटा कम से कम दो भौगोलिक रूप से अलग स्थानों पर स्वतंत्र फ़ेल्योर डोमेन के साथ मौजूद हो, न कि एक ही इमारत में दो रैक पर। डिस्ट्रीब्यूटेड स्टोरेज लेयर में सीधे बने रेप्लिकेशन नियम और प्लेसमेंट नियम इंफ्रास्ट्रक्चर स्तर पर RPO और RTO तय करते हैं, बिना अलग बैकअप सॉफ़्टवेयर स्टैक की ज़रूरत के। कम चलने वाले हिस्से होने का मतलब छोटी अटैक सरफ़ेस भी है।
डिस्ट्रीब्यूटेड स्टोरेज बनाम डिकेंट्रलाइज़्ड स्टोरेज: क्या है अंतर?
डिस्ट्रीब्यूटेड स्टोरेज का मतलब है कि डेटा कई नोड्स में बिखरा होता है, लेकिन पूरा सिस्टम अब भी एक ही संगठन के पास होता है, जो नीतियों, एक्सेस अधिकारों, डिलीट करने की क्षमता और ऑडिट लॉग को नियंत्रित करता है। डिकेंट्रलाइज़्ड स्टोरेज इस केंद्रीय अधिकार को पूरी तरह हटा देता है। डेटा स्वतंत्र पीयर्स में मौजूद रहता है, और कोई एक ऑपरेटर उसे अकेले सेंसर, एक्सेस या डिलीट नहीं कर सकता।
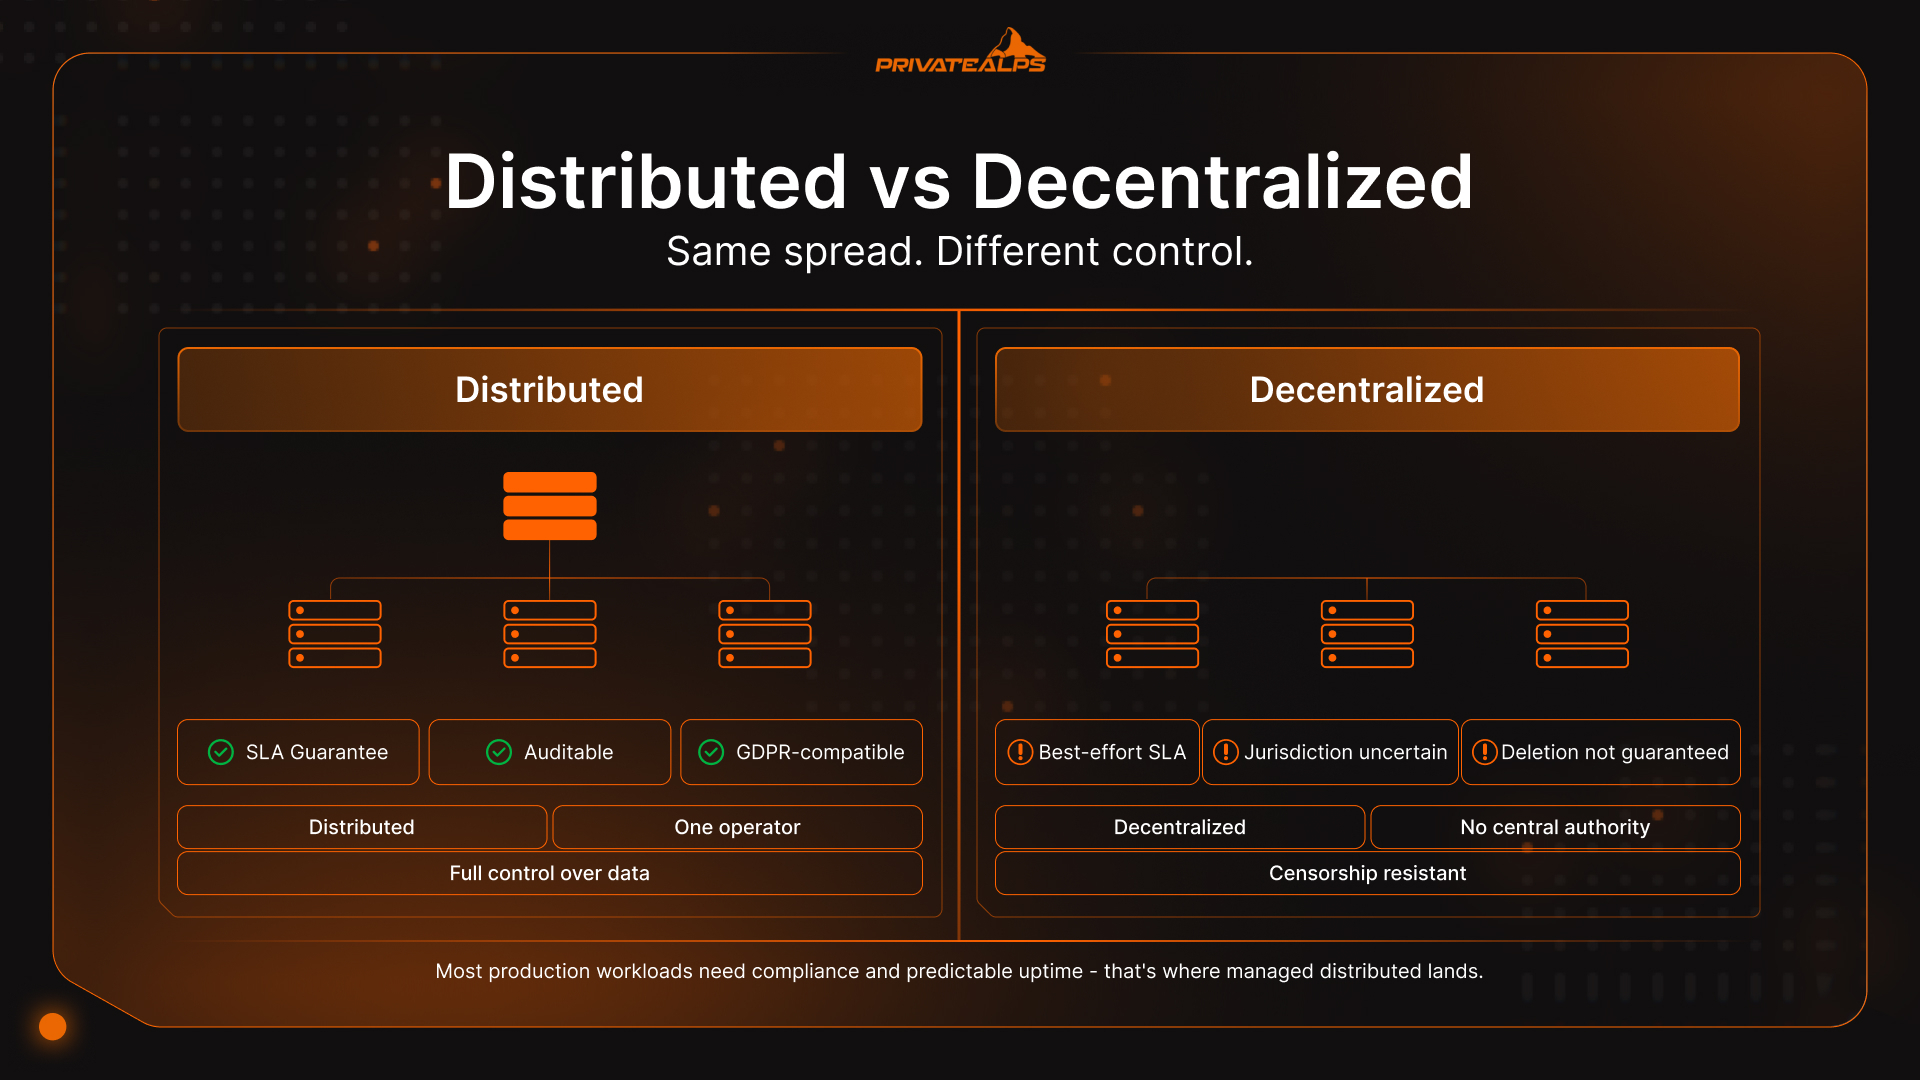
इस अंतर के वास्तविक ऑपरेशनल परिणाम हैं। केंद्रीय रूप से प्रबंधित डिस्ट्रीब्यूटेड सिस्टम का ऑडिट हो सकता है, उसे पैच किया जा सकता है, SLA के साथ चलाया जा सकता है और रेगुलेटरी कंप्लायंस में लाया जा सकता है। डिकेंट्रलाइज़्ड सिस्टम इन सबके बदले सेंसरशिप-प्रतिरोध और ट्रस्टलेस संचालन देता है। यह कुछ खास संदर्भों में मूल्यवान है, लेकिन अधिकांश व्यवसायों को, जो प्रोडक्शन स्टोरेज इंफ्रास्ट्रक्चर चलाते हैं, असल में इसकी ज़रूरत नहीं होती।
| आयाम | डिस्ट्रीब्यूटेड स्टोरेज | डिकेंट्रलाइज़्ड स्टोरेज |
|---|---|---|
| नियंत्रण | केंद्रीय रूप से प्रशासित | कोई केंद्रीय प्राधिकरण नहीं |
| SLA / अपटाइम गारंटी | कॉन्ट्रैक्चुअल गारंटी संभव | Best-effort, प्रोटोकॉल-निर्भर |
| कंप्लायंस | ऑडिट योग्य, GDPR-compatible | अधिकार क्षेत्र अनिश्चित |
| डेटा डिलीशन | गारंटीड | हमेशा संभव नहीं |
| एक्सेस कंट्रोल | रोल-आधारित, प्रबंधित | क्रिप्टोग्राफ़िक, ट्रस्टलेस |
| उदाहरण | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
एक और परत अलग करके समझने लायक है: मल्टी-रीजन क्लाउड स्टोरेज, जैसे क्रॉस-रीजन रेप्लिकेशन वाला AWS S3 या Azure geo-redundant storage, अब भी केंद्रीय रूप से प्रशासित इंफ्रास्ट्रक्चर है। प्रोवाइडर नोड्स और रेप्लिकेशन संभालता है; आप असल में भूगोल किराए पर ले रहे हैं। Storj या Cubbit जैसे असली डिस्ट्रीब्यूटेड क्लाउड प्लेटफ़ॉर्म डेटा को स्वतंत्र ऑपरेटरों में रूट करते हैं, जिससे प्रोवाइडर लॉक-इन हटता है, लेकिन SLA और ऑडिट ट्रेल से जुड़े सवाल फिर से खुल जाते हैं। जिन वर्कलोड को कंप्लायंस दस्तावेज़ और अनुमानित अपटाइम चाहिए, उनके लिए प्रबंधित डिस्ट्रीब्यूटेड दृष्टिकोण ही सबसे सही बैठता है।
सारांश
डिस्ट्रीब्यूटेड स्टोरेज कोई एक प्रोडक्ट नहीं है, यह एक आर्किटेक्चरल श्रेणी है, और सही प्रकार पूरी तरह इस पर निर्भर करता है कि आप क्या चला रहे हैं। ऑब्जेक्ट, ब्लॉक और फ़ाइल स्टोरेज में से हर एक का डेटा मॉडल अलग एक्सेस पैटर्न और वर्कलोड के लिए बना है। जैसे ही नेटवर्क फ़ेल्योर होते हैं, CAP थ्योरम कंसिस्टेंसी और उपलब्धता के बीच एक वास्तविक ट्रेड-ऑफ़ थोप देता है, और यह निर्णय गलत होने पर महंगा पड़ सकता है। रेप्लिकेशन बनाम इरेज़र कोडिंग के मामले में डेटा का “तापमान” तय करता है: हॉट डेटा को लेटेंसी के लिए रेप्लिकेशन चाहिए, जबकि कोल्ड डेटा को इरेज़र कोडिंग की स्टोरेज दक्षता का फायदा मिलता है। ज़्यादातर टीमों के लिए, एक मैनेज्ड डिस्ट्रीब्यूटेड समाधान, चाहे प्राइवेट प्रोवाइडर हो या पब्लिक क्लाउड, जब तक डेटा रेज़िडेंसी और सुरक्षा नियंत्रण सत्यापित हो सकें, स्केलेबिलिटी, परफ़ॉर्मेंस और रोज़मर्रा की ऑपरेशनल सरलता के बीच सेल्फ-होस्टेड क्लस्टर से बेहतर संतुलन देता है।
PrivateAlps के साथ अपना डेटा स्विट्ज़रलैंड में स्टोर करें
अगर आपके वर्कलोड को सत्यापित डेटा रेज़िडेंसी के साथ S3-compatible डिस्ट्रीब्यूटेड ऑब्जेक्ट स्टोरेज चाहिए, तो PrivateAlps स्विस-आधारित इंफ्रास्ट्रक्चर चलाता है, जो GDPR Article 45 और nFADP दोनों का पूर्ण अनुपालन करता है। आपका डेटा स्विट्ज़रलैंड में ही रहता है: कोई तीसरे पक्ष के साथ साझाकरण नहीं, विदेशी अधिकार क्षेत्रों से होकर अस्पष्ट रूटिंग नहीं, कोई आश्चर्य नहीं। चाहे आप किसी हाइपरस्केलर से दूर जा रहे हों या शुरुआत से प्राइवेसी-प्रथम डिस्ट्रीब्यूटेड स्टोरेज आर्किटेक्चर बना रहे हों, PrivateAlps वह परफ़ॉर्मेंस और कंप्लायंस की निश्चितता देता है जिसकी आपके वर्कलोड को असल में ज़रूरत है।
अक्सर पूछे जाने वाले प्रश्न
डिस्ट्रीब्यूटेड स्टोरेज और क्लाउड स्टोरेज में क्या अंतर है?
क्लाउड स्टोरेज एक डिलीवरी मॉडल है: इंफ्रास्ट्रक्चर कोई और मैनेज करता है, और आप इंटरनेट पर पे-पर-यूज़ आधार पर उसे एक्सेस करते हैं। डिस्ट्रीब्यूटेड स्टोरेज एक आर्किटेक्चर है: रिडंडेंसी और स्केलेबिलिटी के लिए डेटा कई नोड्स में फैला होता है। ये स्वतंत्र अवधारणाएँ हैं। आप Ceph या MinIO के साथ डिस्ट्रीब्यूटेड स्टोरेज पूरी तरह ऑन-प्रिमाइसेस चला सकते हैं, और कोई क्लाउड प्रोवाइडर तकनीकी रूप से API के पीछे सेंट्रलाइज़्ड स्टोरेज भी दे सकता है। ज़्यादातर क्लाउड स्टोरेज सर्विस अंदरूनी तौर पर डिस्ट्रीब्यूटेड आर्किटेक्चर इस्तेमाल करती हैं, लेकिन वह एक इम्प्लीमेंटेशन विवरण है, क्लाउड स्टोरेज की परिभाषा नहीं।
सबसे अच्छा डिस्ट्रीब्यूटेड स्टोरेज सिस्टम कौन सा है?
इसका कोई सार्वभौमिक जवाब नहीं है; यह वर्कलोड और डेटा मॉडल पर निर्भर करता है। अनस्ट्रक्चर्ड डेटा और बैकअप के लिए MinIO या Ceph RADOS जैसे S3-compatible ऑब्जेक्ट स्टोर मानक विकल्प हैं। डेटाबेस वॉल्यूम और VM डिस्क के लिए, जिन्हें सुसंगत, कम लेटेंसी वाले ब्लॉक I/O की ज़रूरत है, Ceph RBD या Lightbits बेहतर फिट है। HPC या लीगेसी वातावरण में शेयर्ड फ़ाइलसिस्टम के लिए टीमें आम तौर पर GlusterFS या HDFS पर पहुँचती हैं। एक्सेस पैटर्न से शुरुआत करें; स्टोरेज सिस्टम उसी से तय होता है।
क्या डिस्ट्रीब्यूटेड स्टोरेज RAID जैसा ही है?
नहीं। RAID एक ही सर्वर या स्टोरेज एरे के भीतर काम करता है, और एक मशीन के अंदर डिस्क फ़ेल्योर से बचाता है। डिस्ट्रीब्यूटेड स्टोरेज नेटवर्क से जुड़े अलग-अलग भौतिक नोड्स में काम करता है, जो कई इमारतों या पूरे डेटा सेंटर में फैले हो सकते हैं। जब सर्वर ही फ़ेल हो जाए, तो RAID मदद नहीं करता। डिस्ट्रीब्यूटेड स्टोरेज सिस्टम खास तौर पर नोड फ़ेल्योर, रैक फ़ेल्योर और पूरे डेटा सेंटर के आउटेज को सहने के लिए डिज़ाइन किए जाते हैं। दायरे का यह अंतर मौलिक है।
डिस्ट्रीब्यूटेड स्टोरेज नोड फ़ेल्योर को कैसे संभालता है?
नोड्स क्लस्टर की मेटाडेटा लेयर को नियमित हार्टबीट सिग्नल भेजते हैं। जब कोई नोड जवाब देना बंद कर देता है, तो सिस्टम फ़ेल्योर को पहचान लेता है, आम तौर पर कुछ सेकंड के भीतर, और रिक्वेस्ट को उन नोड्स की ओर रूट कर देता है जिनमें रेप्लिका या इरेज़र-कोडेड फ़्रैगमेंट मौजूद हैं। रेप्लिकेशन-आधारित सेटअप में, एक बैकग्राउंड रिकवरी प्रक्रिया नई कॉपियाँ बनाती है ताकि क्लस्टर में कॉन्फ़िगर किया गया रेप्लिकेशन फ़ैक्टर बहाल हो जाए। पूरी प्रक्रिया स्वचालित है; ठीक से कॉन्फ़िगर किए गए डिस्ट्रीब्यूटेड स्टोरेज क्लस्टर में एप्लिकेशन को फ़ेल्योर दिखता ही नहीं।
क्या डिस्ट्रीब्यूटेड स्टोरेज छोटे व्यवसायों के लिए उपयुक्त है?\\
मैनेज्ड डिस्ट्रीब्यूटेड स्टोरेज सर्विस, जैसे क्लाउड प्रोवाइडर का S3-compatible ऑब्जेक्ट स्टोरेज या PrivateAlps जैसा विशेषज्ञ प्रदाता, किसी भी पैमाने पर बिना न्यूनतम क्लस्टर आवश्यकता के काम करती हैं। सेल्फ-होस्टेड डिस्ट्रीब्यूटेड स्टोरेज क्लस्टर अलग कहानी है: Ceph को उत्पादन में चलाने के लिए आम तौर पर कम से कम तीन से पाँच नोड्स चाहिए, इससे पहले कि ऑपरेशनल ओवरहेड उचित ठहरे। छोटी टीमों के लिए, मैनेज्ड सर्विस बिना इंफ्रास्ट्रक्चर मैनेजमेंट के भार के डिस्ट्रीब्यूटेड स्टोरेज के पूरे आर्किटेक्चरल लाभ देती हैं।
