


distributed storage คือ อะไร?
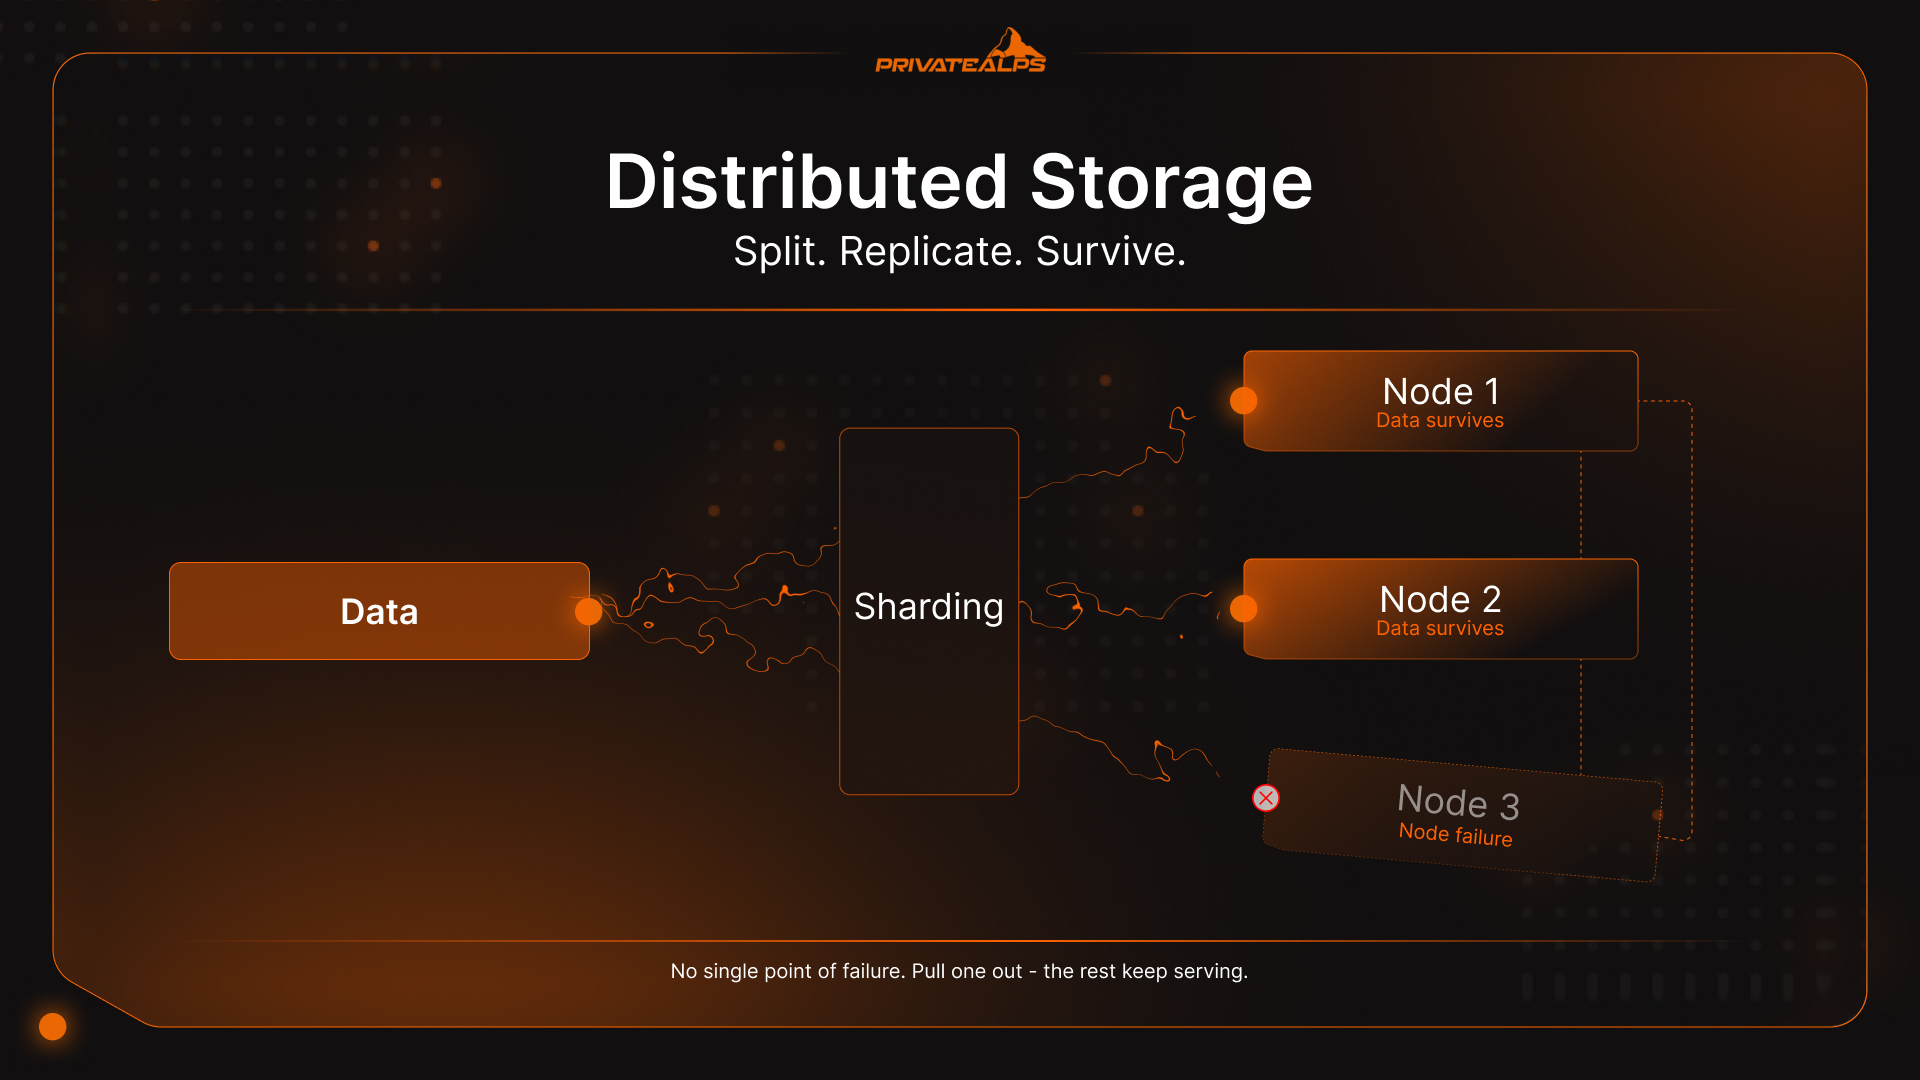
distributed storage คือวิธีที่โครงสร้างพื้นฐานสมัยใหม่ใช้จัดการข้อมูลที่ใหญ่เกินไป สำคัญเกินไป หรือถูกเข้าถึงบ่อยเกินกว่าเครื่องเดียวจะเก็บได้อย่างน่าเชื่อถือ แทนที่จะเขียนข้อมูลทั้งหมดลงเซิร์ฟเวอร์เครื่องเดียว ระบบจะแบ่ง คัดลอก หรือเข้ารหัสข้อมูลแล้วกระจายไปยังหลายโหนดที่เป็นอิสระต่อกัน ได้แก่ เซิร์ฟเวอร์ ไดรฟ์ และดาต้าเซ็นเตอร์ โหนดเหล่านี้ทำงานร่วมกัน แต่ไม่มีโหนดใดเก็บข้อมูลทั้งหมดไว้ หากถอดโหนดหนึ่งออก โหนดที่เหลือยังให้บริการต่อได้ คู่มือนี้อธิบายว่าระบบ distributed storage ทำงานจริงภายใต้โหลดอย่างไร ต้องแลกอะไรบ้างในเชิงสถาปัตยกรรม และควรเลือกประเภทการจัดเก็บแบบใดกับงานแต่ละประเภท
สรุปโดย AI
distributed storage คือสถาปัตยกรรมที่ควบคุมด้วยซอฟต์แวร์ ซึ่งกระจายข้อมูลไปยังหลายโหนดทางกายภาพโดยใช้เทคนิคหลักสามอย่าง ได้แก่ sharding (แบ่งข้อมูลเป็นชิ้นย่อยแล้วส่งไปยังโหนดต่าง ๆ) replication (เก็บสำเนาที่เหมือนกันหลายชุดไว้ในโหนดต่าง ๆ เพื่อให้เข้าถึงได้เร็ว) และ erasure coding (เข้ารหัสข้อมูลเป็นชิ้นส่วนพร้อมข้อมูลพาริตีทางคณิตศาสตร์ เพื่อให้ชิ้นส่วนบางส่วนสามารถสร้างข้อมูลทั้งหมดขึ้นมาใหม่ได้)
ระบบ distributed storage มีสามประเภทหลัก ได้แก่ object storage (namespace แบบแบน ใช้ API ที่รองรับ S3) block storage ( วอลุ่มขนาดคงที่สำหรับการเข้าถึงแบบสุ่มที่มี latency ต่ำ) และ file storage (namespace แบบลำดับชั้นผ่าน NFS หรือ SMB) ทุก distributed data storage ต้องเผชิญ CAP theorem ซึ่งระบุว่าระบบสามารถรับประกันได้เพียงสองในสามอย่างพร้อมกัน ได้แก่ consistency, availability และ partition tolerance
ประโยชน์เชิงปฏิบัติหลักคือ การเสียของโหนดจะไม่ทำให้ระบบล่ม เพราะระบบจะส่งคำขอไปยังสำเนาที่ยังทำงานอยู่โดยอัตโนมัติ
สิ่งที่ต้องคำนึงถึงในระดับใหญ่คือ มนุษยชาติสร้างข้อมูลใหม่มากกว่า 400 ล้านเทระไบต์ ทุกวัน ปริมาณนี้เป็นสิ่งที่สถาปัตยกรรมแบบรวมศูนย์รับไม่ไหว และในที่สุดจะล่มภายใต้น้ำหนักของตัวเอง
distributed storage vs centralized storage
centralized storage เก็บทุกอย่างไว้ในที่เดียว ได้แก่ เซิร์ฟเวอร์เครื่องเดียว SAN เดียว หรือดาต้าเซ็นเตอร์เดียว นี่คือโมเดลทั้งหมด เมื่อที่นั้นมีปัญหา ทุกอย่างจะหยุดทำงาน distributed storage แก้ปัญหานี้โดยตรง เพราะข้อมูลอยู่บนหลายโหนดที่เป็นอิสระ จุดล้มเหลวเพียงจุดเดียวจึงไม่สามารถทำให้ระบบทั้งหมดออฟไลน์หรือบล็อกการเข้าถึงทั้งหมดได้
เมื่อฮาร์ดแวร์เสีย การเข้าถึงก็หยุดลงทันที ไม่มีทางเลือกอื่น การขยายระบบหมายถึงการอัปเกรดหรือเปลี่ยนระบบหลัก ซึ่งมักต้องหยุดให้บริการและต้องคุยเรื่องงบลงทุนที่ไม่มีใครอยากคุย distributed storage หลีกเลี่ยงทั้งสองอย่างได้ตั้งแต่การออกแบบ คือเพิ่มโหนดเพื่อขยายระบบ และเมื่อโหนดใดเสีย คลัสเตอร์จะเปลี่ยนเส้นทางไปรอบโหนดนั้นเอง ไม่มีปัญหาและไม่มีการหยุดให้บริการ เพราะข้อมูลอยู่บนหลายโหนดอยู่แล้วก่อนที่จะเกิดความเสียหาย
| มิติ | Centralized Storage | Distributed Storage |
|---|---|---|
| Fault tolerance | จุดล้มเหลวเพียงจุดเดียว | ข้อมูลยังอยู่รอดเมื่อโหนดใดโหนดหนึ่งหายไป |
| Scalability | แนวตั้ง (อัปเกรดฮาร์ดแวร์) | แนวนอน (เพิ่มโหนด) |
| Latency | ต่ำสำหรับการเข้าถึงภายในที่เดียวกัน | แปรผัน ขึ้นอยู่กับโทโพโลยีของเครือข่าย |
| Cost at small scale | ต้นทุนเริ่มต้นต่ำกว่า | คลัสเตอร์ขั้นต่ำที่ใช้งานได้มีต้นทุนสูงกว่า |
| Cost at large scale | ขยายระบบได้แพง | ฮาร์ดแวร์ทั่วไปช่วยลดต้นทุน |
| Geographic distribution | ตำแหน่งเดียว | หลายภูมิภาคตามการตั้งค่า |
| Operational complexity | จัดการได้ง่าย | ต้องใช้เครื่องมือ orchestration |
distributed storage ทำงานอย่างไร
ระบบ distributed storage รับข้อมูลที่เข้ามา แบ่งเป็นชิ้น ส่งแต่ละชิ้นไปยังโหนดที่เหมาะสมทั่วทั้งคลัสเตอร์ และติดตามทุกชิ้นผ่าน metadata layer เพื่อให้สามารถค้นหา ดึง และประกอบชิ้นส่วนกลับมาได้ตามต้องการ ไม่ว่าโหนดใดจะเป็นผู้เก็บชิ้นส่วนนั้นอยู่ นี่คือลูปพื้นฐาน และมีกลไกสี่อย่างที่ขับเคลื่อนมัน
- Sharding (Data Partitioning) เมื่อข้อมูลเข้ามา ระบบจะตัดข้อมูลเป็นชิ้นเล็ก ๆ ที่เรียกว่า shard หรือ block แล้วกระจายไปยังโหนดต่าง ๆ สิ่งนี้ทำให้เกิด parallel I/O คือหลายโหนดจัดการการอ่านและเขียนพร้อมกัน ทำให้ปริมาณงานเพิ่มขึ้นตามขนาดคลัสเตอร์ แทนที่จะจำกัดอยู่ที่ขีดความสามารถของเครื่องเดียว ตรรกะการกำหนดเส้นทางมักใช้ consistent hashing ซึ่งช่วยให้การกระจายข้อมูลสม่ำเสมอเมื่อคลัสเตอร์ขยายตัว โดยไม่ต้องจัดเรียงข้อมูลใหม่ทั้งหมดทุกครั้งที่มีโหนดเพิ่มเข้ามา
- Replication วิธีที่ตรงไปตรงมาแต่มีประสิทธิภาพ คือเก็บสำเนาที่เหมือนกัน N ชุดของแต่ละ shard ไว้ในโหนดแยกกัน โดยทั่วไปคือสามชุด เมื่อโหนดหนึ่งออฟไลน์ อีกสองโหนดยังให้บริการได้ทันที ไม่ต้องสร้างข้อมูลใหม่และไม่ต้องรอ Replication เป็นทางเลือกที่เหมาะกับ hot data เช่น ฐานข้อมูลที่ใช้งานอยู่ ฟีดข้อมูลแบบเรียลไทม์ หรือทุกอย่างที่แค่เพิ่มเวลาอ่านอีกหนึ่งมิลลิวินาทีก็ทำให้เสียหายได้
- Erasure Coding นี่คือส่วนที่การคำนวณประสิทธิภาพการจัดเก็บน่าสนใจ แทนที่จะเก็บสำเนาเต็มสามชุด ระบบจะเข้ารหัสออบเจกต์เป็นชิ้นข้อมูล $k$ ชิ้นบวกกับชิ้นพาริตี $m$ ชิ้น แล้วกระจายทั้ง $k+m$ ชิ้นไปยังโหนดต่าง ๆ และสามารถสร้างออบเจกต์เต็มขึ้นมาใหม่จากชิ้นใดก็ได้ $k$ ชิ้น ดังนั้น $m$ โหนดสามารถเสียพร้อมกันได้โดยไม่สูญเสียข้อมูล การกำหนดค่า Reed-Solomon RS(6,3) จัดเก็บ 9 บล็อก แทนที่จะเป็น 18 บล็อกที่ต้องใช้กับ 3x replication ซึ่งลดค่าใช้จ่ายพื้นที่จัดเก็บดิบจาก 200% เหลือประมาณ 50% ข้อเสียคือการเข้ารหัสและถอดรหัสใช้รอบ CPU และ erasure coding ทำงานได้ดีกับ cold data คือข้อมูลที่ไม่ค่อยถูกแก้ไขหรือเข้าถึงบ่อย สำหรับงานที่เขียนข้อมูลขนาดเล็กบ่อย ๆ 3x replication ยังให้ latency ที่ดีกว่า
| วิธีการป้องกัน | ค่าใช้จ่ายพื้นที่จัดเก็บ | เหมาะที่สุดกับ | ข้อแลกเปลี่ยน |
|---|---|---|---|
| 3x Replication | 3 เท่าของความจุดิบ | Hot data, งานที่ต้องการ latency ต่ำ | ต้นทุนการจัดเก็บสูงเมื่อขยายระบบ |
| Erasure Coding RS(6,3) | 1.5 เท่าของความจุดิบ | Cold data, archival, ออบเจกต์ขนาดใหญ่ | ภาระ CPU และ latency ในการสร้างใหม่สูงกว่า |
- Metadata Routing ทุกระบบ distributed storage มี metadata layer ซึ่งโดยพื้นฐานคือแผนที่ว่า shard ใดอยู่บนโหนดใด เมื่อไคลเอนต์ร้องขอข้อมูล บริการ metadata จะระบุโหนดที่ถูกต้อง แล้วระบบจะดึงและประกอบชิ้นส่วนโดยที่ไคลเอนต์ไม่ต้องเห็นความซับซ้อนนั้น ในคลัสเตอร์ขนาดใหญ่อย่าง Ceph หรือ HDFS metadata layer ก็กระจายอยู่บนหลายโหนดเช่นกัน และต้องเป็นเช่นนั้น เพราะเซิร์ฟเวอร์ metadata เพียงตัวเดียวจะกลายเป็นคอขวดที่เรากำลังพยายามหลีกเลี่ยง
ประเภทของระบบ distributed storage
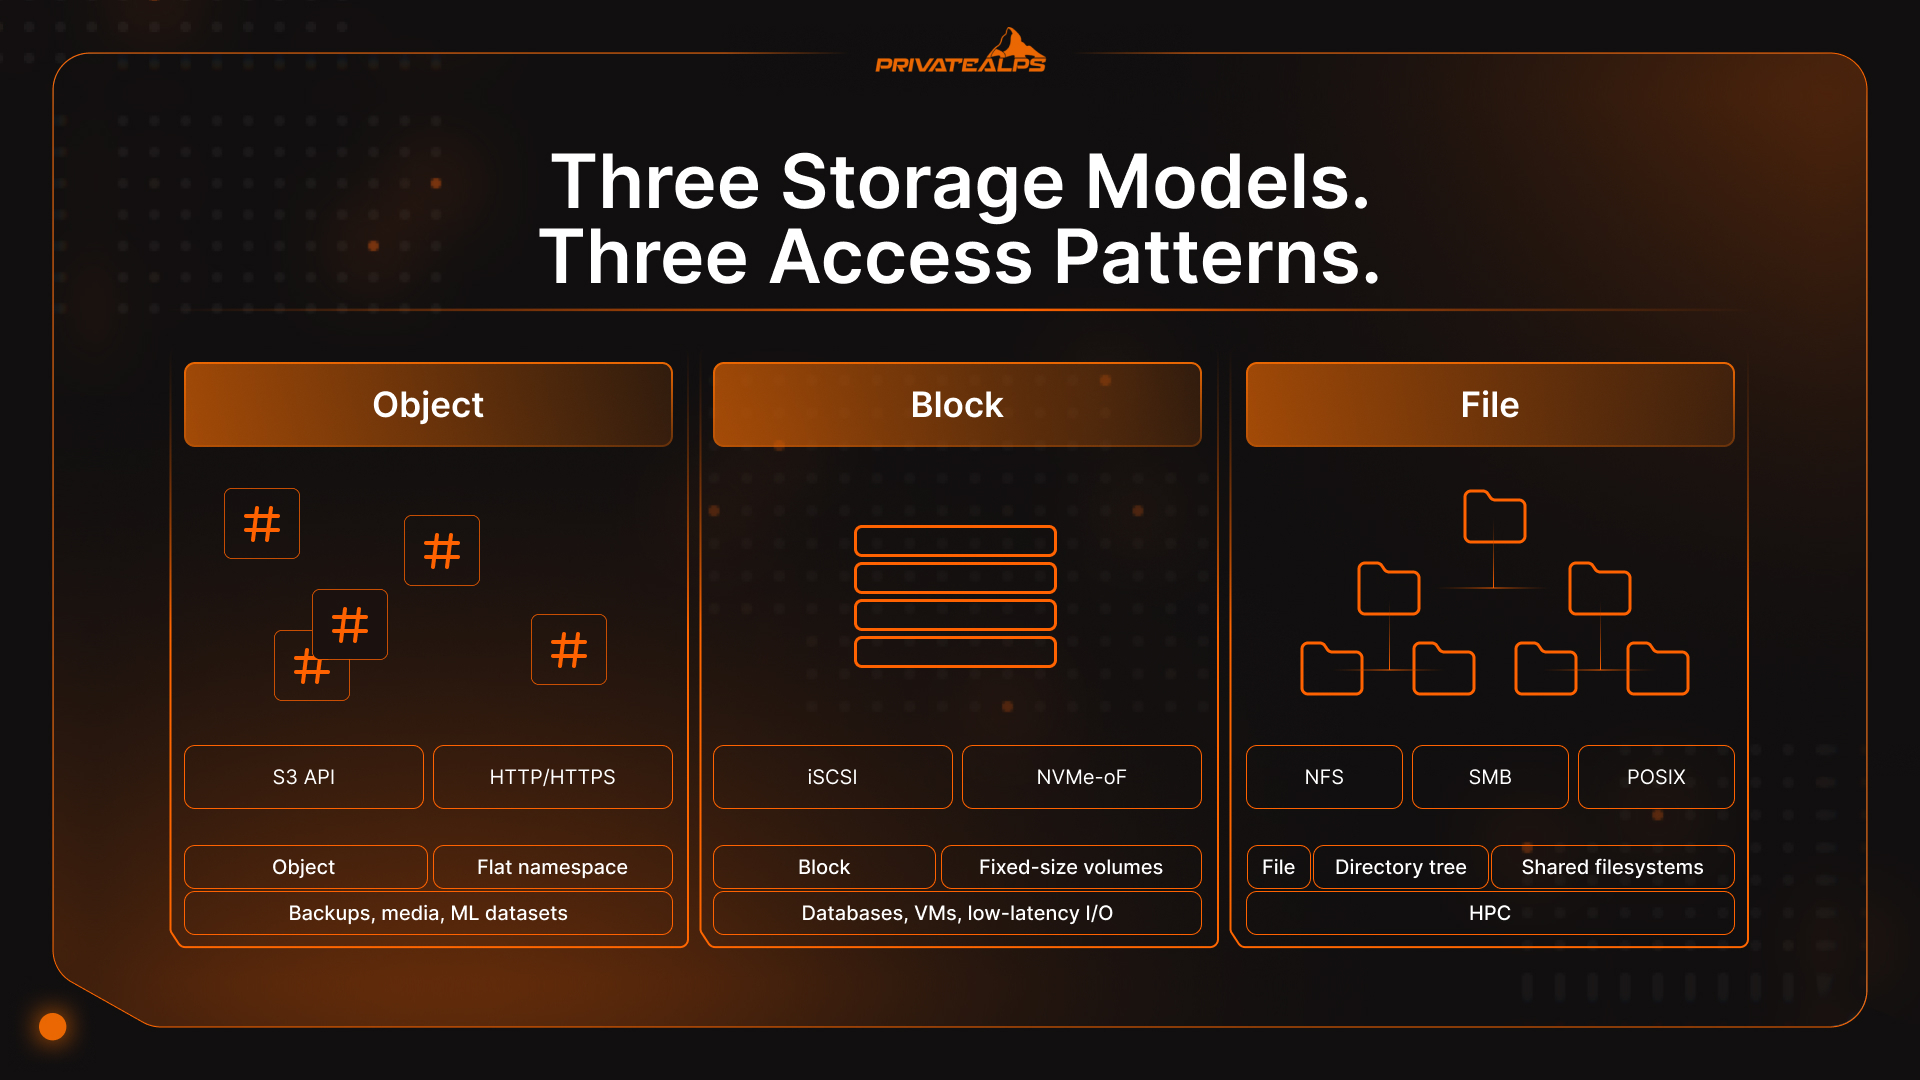
distributed storage ไม่ได้มีรูปแบบเดียว แต่เป็นหมวดหมู่ที่มีโมเดลข้อมูลสามแบบ การเลือกแบบที่ไม่เหมาะกับงานเป็นความผิดพลาดที่พบบ่อยและมีค่าใช้จ่ายสูงอย่างน่าแปลกใจ Object, block และ file storage แต่ละแบบแก้ปัญหาที่ต่างกัน ส่วนฐานข้อมูลแบบกระจาย เช่น Cassandra, CockroachDB และ Google Spanner เป็นประเภทที่สี่ ซึ่งเพิ่มความสามารถด้าน query บนระบบจัดการข้อมูลแบบกระจาย แต่นั่นเป็นหัวข้อแยกต่างหาก
| ประเภท | วิธีจัดเก็บข้อมูล | วิธีเข้าถึง | เหมาะที่สุดกับ | ตัวอย่าง |
|---|---|---|---|---|
| Object | namespace แบบแบน ออบเจกต์มี metadata มาก | API ที่รองรับ S3 (HTTP/HTTPS) | ข้อมูลที่ไม่มีโครงสร้างขนาดใหญ่ เช่น สำรองข้อมูล สื่อ ชุดข้อมูล ML | AWS S3, MinIO, Ceph RADOS |
| Block | วอลุ่มดิบขนาดคงที่ | iSCSI, NVMe-oF, FC | ฐานข้อมูล VM การเข้าถึงสุ่มที่ latency ต่ำ | Ceph RBD, AWS EBS, Lightbits |
| File | โครงสร้างไดเรกทอรีแบบลำดับชั้น | NFS, SMB, POSIX | ระบบไฟล์ที่ใช้ร่วมกัน HPC โฟลเดอร์โฮม | GlusterFS, HDFS, Azure Files |
Distributed Object Storage
distributed object storage จัดเก็บข้อมูลเป็นออบเจกต์แยกที่ไม่เปลี่ยนแปลง วางอยู่บน namespace แบบแบน ไม่มีไดเรกทอรี ไม่มี file path และไม่มีลำดับชั้นให้ดูแล แต่ละออบเจกต์มีตัวระบุเฉพาะ (hash หรือ UUID) และ metadata จำนวนมาก คุณเข้าถึงได้ผ่าน API ที่รองรับ S3 ผ่าน HTTP เพราะออบเจกต์ถูกแทนที่ทั้งชุด ไม่ได้ถูกอัปเดตบางส่วน ปัญหาการล็อกที่จำกัดประสิทธิภาพและความสามารถในการขยายระบบของ block และ file system จึงหายไป นี่คือวิธีที่ AWS S3, Azure Blob และ Ceph ขยายไปถึงระดับเอกซาไบต์ได้ โดยไม่มีภาระการประสานงาน namespace ไม่มีการแย่งล็อก และโหนดใดในคลัสเตอร์ก็ให้บริการคำขอออบเจกต์ใดก็ได้อย่างอิสระ
Distributed Block Storage
block storage มอบวอลุ่มดิบให้เซิร์ฟเวอร์ เป็นบล็อกขนาดคงที่ที่มีที่อยู่เฉพาะ ไม่มี filesystem มาคั่นอยู่ด้านบน แอปพลิเคชันเขียนลงบล็อกโดยตรง ซึ่งให้ การเข้าถึงสุ่มที่มี latency ต่ำและสม่ำเสมอ สำหรับฐานข้อมูล ดิสก์ VM และงานแบบคอนเทนเนอร์ ข้อจำกัดด้านสถาปัตยกรรมข้อหนึ่งที่มักทำให้คนพลาดคือ วอลุ่มแบบ block โดยทั่วไปสามารถ mount ได้โดยเซิร์ฟเวอร์เพียงเครื่องเดียวในแต่ละครั้ง การเข้าถึงร่วมกันจากหลายเซิร์ฟเวอร์ต้องใช้การประสานงานเพิ่มเติมบนระบบ เช่น cluster filesystem ที่วางทับอยู่บนอุปกรณ์ block
Distributed File Storage
file storage นำเสนอ filesystem ที่ใช้ร่วมกันผ่านโปรโตคอลมาตรฐาน ได้แก่ NFS, SMB และการเข้าถึงแบบ POSIX-compatible ไคลเอนต์หลายตัวสามารถ mount วอลุ่มเดียวกันได้พร้อมกัน ทำให้เหมาะกับงานแบบร่วมมือ สภาพแวดล้อม HPC และแอปพลิเคชันเดิมที่คาดหวังโครงสร้างไดเรกทอรี และยังไม่มีแผนเขียนใหม่ในเร็ว ๆ นี้ ข้อแลกเปลี่ยนในโลกจริงคือ การรักษา namespace ไดเรกทอรีให้สอดคล้องกันทั่วโหนดที่กระจายอยู่ สร้าง ภาระการประสานงาน ที่สะสมเพิ่มขึ้นเมื่อขยายระบบ ผู้ให้บริการขนาดใหญ่ส่วนใหญ่ในที่สุดก็ย้ายข้อมูลหลักจาก distributed file storage ไปยัง distributed object storage เมื่อวอลุ่มมีขนาดใหญ่พอ
ทฤษฎี CAP: การแลกเปลี่ยนที่หลีกเลี่ยงไม่ได้ใน distributed storage
CAP theorem ระบุว่าระบบข้อมูลแบบกระจายสามารถรับประกันได้เพียงสองในสามอย่างพร้อมกัน ได้แก่ Consistency (ทุกการอ่านคืนค่าการเขียนล่าสุด) Availability (ทุกคำขอได้รับการตอบสนอง) และ Partition Tolerance (ระบบยังทำงานต่อได้แม้เครือข่ายถูกแบ่งแยก) เครือข่ายถูกแบ่งแยกได้เสมอ ดังนั้น partition tolerance จึงไม่ใช่ตัวเลือก การตัดสินใจที่แท้จริงคือระหว่าง consistency กับ availability เมื่อเกิดความผิดพลาดขึ้น
[Eric Brewer เสนอ CAP ในปี 2000 และ Gilbert กับ Lynch ได้พิสูจน์อย่างเป็นทางการในปี 2002][https://www.scylladb.com/glossary/cap-theorem/] ทฤษฎีนี้ยังคงเป็นการตัดสินใจที่กำหนดทุกอย่างอื่นในสถาปัตยกรรม distributed storage เพราะมันกำหนดว่าระบบจะทำงานอย่างไรในช่วงเวลาที่คุณต้องการมันมากที่สุด คือตอนที่บางอย่างพังอยู่แล้ว
| ระบบ | ประเภท CAP | พฤติกรรมระหว่างเครือข่ายถูกแบ่ง | เหมาะที่สุดกับ |
|---|---|---|---|
| MongoDB | CP (ด้วย majority read/write concern) | ปฏิเสธคำขอจนกว่าจะคืนความสอดคล้อง | บันทึกการเงิน สินค้าคงคลัง การจอง |
| HBase | CP | คืนข้อผิดพลาดแทนที่จะคืนข้อมูลเก่า | การวิเคราะห์แบบมีโครงสร้าง งาน batch ที่สอดคล้องกัน |
| Apache Cassandra | AP | ยังให้บริการต่อได้ อาจคืนข้อมูลเก่า | ฟีดโซเชียล การส่งข้อความ telemetry ของ IoT |
| DynamoDB (default) | AP | ตอบสนองเสมอ และปรับความไม่สอดคล้องแบบอะซิงโครนัส | แอปผู้บริโภคที่มี throughput สูง |
| CockroachDB | CP | ให้ความสำคัญกับ consistency ก่อน ใช้ distributed SQL | งานธุรกรรมระดับโลก |
หลักการปฏิบัติคือ งานของคุณยอมรับ การอ่านข้อมูลเก่า ได้หรือไม่ ยอดเงินในบัญชี การจองที่นั่ง หรือจำนวนสินค้าคงคลัง น่าจะยอมรับไม่ได้ ให้เลือก CP ฟีดโซเชียล สตรีมเหตุการณ์จากเซ็นเซอร์ หรือ telemetry สำหรับการวิเคราะห์ ข้อมูลที่ค้างอยู่สองสามวินาทียอมรับได้ ให้เลือก AP และรักษาการรับประกัน availability ไว้
ความปลอดภัยของ distributed storage: การเข้ารหัสและอธิปไตยของข้อมูล
ความปลอดภัยใน distributed storage ครอบคลุมสามชั้นที่แตกต่างกัน ได้แก่ ข้อมูลขณะจัดเก็บ (data at rest) ข้อมูลขณะส่งผ่านเครือข่าย (data in transit) และ การเป็นเจ้าของคีย์ (key ownership) หากพลาดชั้นใดชั้นหนึ่ง ชั้นอื่นก็ไม่สามารถชดเชยได้ ระบบอาจพร้อมใช้งานอย่างสมบูรณ์ ขณะที่ข้อมูลสำคัญอาจถูกเข้าถึงโดยผู้ที่ไม่ควรเข้าถึงได้อย่างเงียบ ๆ
การเข้ารหัสต้องครอบคลุมทั้งสามชั้น ข้อมูลขณะจัดเก็บมักใช้ AES-256 ซึ่งคีย์อาจถูกจัดการโดยผู้ให้บริการ หรือใช้ customer-managed keys (CMK) ที่ผู้ใช้เป็นผู้จัดการเอง การให้ผู้ให้บริการจัดการคีย์ทำได้ง่ายกว่าในเชิงปฏิบัติการ แต่ผู้ให้บริการพื้นที่เก็บข้อมูลจะถือครองข้อมูลคีย์ ซึ่งเป็นประเด็นด้านความปลอดภัยสำคัญสำหรับอุตสาหกรรมที่อยู่ภายใต้กฎระเบียบและต้องผ่านการตรวจสอบ การเข้ารหัสฝั่งไคลเอนต์ (client-side encryption) ช่วยตัดความเสี่ยงนี้ออกไปทั้งหมด เพราะข้อมูลถูกเข้ารหัสก่อนออกจากเครื่องของผู้ใช้ ผู้ให้บริการจึงไม่เคยเห็นข้อมูลต้นฉบับ ไม่ว่าจะมีคำขอทางกฎหมายรูปแบบใดเข้ามา สำหรับข้อมูลขณะส่งผ่านเครือข่าย TLS 1.3 คือมาตรฐานความปลอดภัยขั้นต่ำ การยังอนุญาตให้ใช้ TLS 1.2 ต้องมีข้อยกเว้นที่บันทึกไว้เป็นลายลักษณ์อักษรภายใต้กรอบการปฏิบัติตามข้อกำหนดส่วนใหญ่ในปัจจุบัน
อธิปไตยของข้อมูล (data sovereignty) เป็นเรื่องที่ทีมงานมักมองข้าม ข้อมูลอยู่ภายใต้กฎหมายของประเทศที่ข้อมูลนั้นถูกจัดเก็บอยู่จริง ไม่ใช่ประเทศของบริษัทหรือที่ตั้งของผู้ใช้ สวิตเซอร์แลนด์ ได้รับสถานะ adequacy ภายใต้ GDPR Article 45 ทำให้การโอนข้อมูลจาก EU มายังสวิตเซอร์แลนด์ดำเนินการได้โดยไม่ต้องมีมาตรการป้องกันตามสัญญาเพิ่มเติม Federal Act on Data Protection (nFADP) ฉบับปรับปรุงทำให้กฎภายในประเทศของสวิตเซอร์แลนด์สอดคล้องกับ GDPR ซึ่งหมายความว่าโครงสร้างพื้นฐานในสวิตเซอร์แลนด์ครอบคลุมการกำกับดูแลทั้งสองกรอบพร้อมกัน
มีประเด็นหนึ่งที่มักถูกเลื่อนออกไป แต่ไม่ควรเป็นเช่นนั้น อัลกอริทึมการเข้ารหัสที่ปกป้องโครงสร้างพื้นฐานการจัดเก็บส่วนใหญ่ในปัจจุบัน ไม่ได้ถูกออกแบบมาให้รับมือกับคอมพิวเตอร์ควอนตัมที่มีความสามารถ NIST ได้ประกาศมาตรฐาน post-quantum cryptography สามฉบับในเดือนสิงหาคม 2024 รวมถึง FIPS 203 (ML-KEM) หาก distributed data storage ของคุณเก็บบันทึกที่ต้องเก็บรักษาเป็นเวลานาน เช่น เวชระเบียน บันทึกทางการเงิน หรือเอกสารทางกฎหมาย รูปแบบภัยคุกคาม “เก็บก่อน ถอดรหัสทีหลัง” ก็กำลังดำเนินอยู่แล้ว การประเมินจึงควรเริ่มก่อนที่ข้อมูลเหล่านั้นจะถึงช่วงที่มีความเสี่ยงสูงมาก
ข้อดีหลักของ distributed storage
- ทนต่อความผิดพลาดโดยไม่หยุดให้บริการ: เมื่อโหนดใดล้มเหลว ระบบจะตรวจจับจาก heartbeat และส่งคำขอไปยังเรพลิกาที่ยังทำงานอยู่โดยอัตโนมัติ ไม่ต้องมีการแทรกแซงด้วยมือ และไม่ต้องกำหนดช่วงเวลาปิดปรับปรุงระบบ
- ขยายขนาดในแนวนอน (horizontal scalability): เพิ่มความจุได้ด้วยการเพิ่มโหนดเข้าสู่คลัสเตอร์ ข้อมูลจะถูกปรับสมดุลอยู่เบื้องหลัง โดยไม่กระทบทราฟฟิกที่ให้บริการอยู่และไม่ต้องหยุดระบบ
- กระจายข้อมูลตามภูมิภาค: การทำสำเนาข้ามภูมิภาคช่วยลดความหน่วงสำหรับผู้ใช้ที่กระจายอยู่ในหลายพื้นที่ และทำให้การปฏิบัติตามกฎเรื่องถิ่นที่อยู่ของข้อมูลกลายเป็นการตั้งค่าการทำงาน ไม่ต้องเป็นโครงการโครงสร้างพื้นฐานขนาดใหญ่
- ประสิทธิภาพ I/O แบบขนาน: หลายโหนดสามารถอ่านและเขียนข้อมูลพร้อมกัน ซึ่งเป็นสถาปัตยกรรมเดียวที่ขยายขนาดได้สำหรับไพพ์ไลน์ AI/ML การแปลงรูปแบบวิดีโอ หรือการสตรีมสื่อในปริมาณการใช้งานจริงระดับสูง
- ไม่ผูกติดกับผู้ให้บริการรายเดียว (no vendor lock-in) ด้วยโปรโตคอลเปิด: API ที่รองรับ S3, NFS และแพลตฟอร์มโอเพนซอร์สอย่าง Ceph ทำให้ทีมงานย้ายระหว่างผู้ให้บริการหรือรันระบบในองค์กรได้ โดยไม่ต้องเขียนโค้ดแอปพลิเคชันใหม่
- คุ้มค่าเมื่อขยายขนาด: ฮาร์ดแวร์ทั่วไปเข้ามาแทนที่อาร์เรย์จัดเก็บข้อมูลเฉพาะทางที่มีราคาแพง และ erasure coding ช่วยลดความจุดิบที่ต้องใช้ได้สูงสุดถึง 50% เมื่อเทียบกับการทำสำเนาเต็มรูปแบบข้ามโหนด
ข้อจำกัดและความท้าทายของ distributed storage
- ความซับซ้อนด้านความสอดคล้องของข้อมูล (consistency): การรักษาสถานะที่สอดคล้องกันระหว่างโหนดต้องปรับแต่ง consistency model, จำนวนสำเนา และการตั้งค่า quorum อย่างรอบคอบ การตั้งค่าที่ผิดพลาดไม่ได้แจ้งเตือนอย่างชัดเจน แต่จะค่อย ๆ ทำให้ข้อมูลคลาดเคลื่อนจากกัน
- ภาระการดำเนินงาน: การดูแลคลัสเตอร์ distributed storage หมายถึงการวางแผนโดเมนความล้มเหลว ขั้นตอนการเปลี่ยนโหนด ไพพ์ไลน์การเฝ้าระวัง และการปรับแต่งประสิทธิภาพ เซิร์ฟเวอร์เครื่องเดียวไม่ต้องการสิ่งเหล่านี้
- การพึ่งพาเครือข่าย: สถาปัตยกรรมทั้งหมดต้องอาศัยการเชื่อมต่อระหว่างโหนดที่เชื่อถือได้และมีแบนด์วิดท์สูง เมื่อเครือข่ายเสื่อมประสิทธิภาพ ความหน่วงและปริมาณงานของการจัดเก็บข้อมูลจะลดลงโดยตรงและตามสัดส่วน
- ความหน่วงสำหรับ I/O แบบสุ่มขนาดเล็ก: distributed storage ถูกปรับให้เหมาะกับการอ่านแบบต่อเนื่องขนาดใหญ่และการประมวลผลแบบขนาน ปริมาณงานที่มี I/O แบบสุ่มขนาดเล็กจำนวนมาก โดยเฉพาะ OLTP databases มักทำงานได้ดีกว่าบน NVMe block storage ที่เชื่อมต่อกับเครื่องโดยตรง
- ขนาดขั้นต่ำที่เหมาะสม: ข้อได้เปรียบด้านต้นทุนและความซับซ้อนของ distributed storage จะไม่เห็นผลในคลัสเตอร์สองโหนด ต่ำกว่าเกณฑ์หนึ่ง บริการจัดเก็บข้อมูลบนคลาวด์แบบจัดการให้ หรือเซิร์ฟเวอร์เครื่องเดียวที่ปรับแต่งดี จะถูกกว่าและดูแลได้ง่ายกว่าอย่างชัดเจน
กรณีการใช้งานจริงของ distributed storage
- สื่อและสตรีมมิง: Netflix และ YouTube ไม่ได้ส่งวิดีโอจากศูนย์กลางแห่งเดียว แต่กระจายเนื้อหาที่เข้ารหัสแล้วไปยังคลัสเตอร์ object storage ที่ตั้งอยู่ใกล้ผู้ชมในแต่ละพื้นที่ ศูนย์ข้อมูลเพียงแห่งเดียวไม่สามารถรองรับการสตรีมพร้อมกันทั่วโลกในระดับนี้ได้ เฉพาะค่าแบนด์วิดท์ก็สูงเกินไป distributed data storage คือสิ่งที่ทำให้เศรษฐศาสตร์ของการสตรีมเป็นไปได้จริง
- สาธารณสุข: การสแกน MRI หนึ่งครั้งสร้างข้อมูลภาพขนาด 500 MB ถึง 1 GB เมื่อคูณกับเครือข่ายโรงพยาบาลขนาดใหญ่ที่มีเครื่องมือหลายประเภท ระยะเวลาจัดเก็บที่ยาวนาน และหลายสาขา ข้อมูลจะสะสมเป็นเพตาไบต์อย่างรวดเร็ว distributed storage ที่ขยายขนาดได้และมีการสำรองข้อมูลข้ามภูมิภาค คือวิธีที่ระบบสาธารณสุขใช้รักษาการเข้าถึงเวชระเบียนผู้ป่วยที่สอดคล้องกับ HIPAA-compliant แม้ศูนย์ข้อมูลในภูมิภาคจะล้มเหลว
- AI และ Machine Learning: การฝึกโมเดลภาษาขนาดใหญ่ต้องป้อนข้อมูลตั้งแต่เทราไบต์ถึงเพตาไบต์ให้คลัสเตอร์ GPU โดยเข้าถึงข้อมูลแบบไม่เรียงลำดับ ซึ่งจะทำให้ระบบจัดเก็บแบบดั้งเดิมอิ่มตัวได้ในทันที Ceph, HDFS และ object store ที่รองรับ S3-compatible กลายเป็นชั้นโครงสร้างพื้นฐานมาตรฐานสำหรับไพพ์ไลน์ ML เพราะปริมาณการอ่านแบบขนานสอดคล้องกับความต้องการของคลัสเตอร์ GPU จริง ๆ
- การสำรองข้อมูลและการกู้คืนจากภัยพิบัติ: การกู้คืนจากภัยพิบัติที่แท้จริงหมายถึงการมีข้อมูลอย่างน้อยสองตำแหน่งที่แยกทางภูมิศาสตร์และมีโดเมนความล้มเหลวเป็นอิสระต่อกัน ไม่ใช่สองตู้แร็คในอาคารเดียวกัน นโยบายการทำสำเนาและกฎการวางตำแหน่งที่ฝังอยู่ในชั้น distributed storage จะกำหนดค่า RPO และ RTO ในระดับโครงสร้างพื้นฐาน โดยไม่ต้องใช้ซอฟต์แวร์สำรองข้อมูลแยกต่างหาก ส่วนประกอบที่เคลื่อนไหวน้อยลงยังหมายถึงพื้นที่การโจมตีที่เล็กลงอีกด้วย
Distributed Storage vs. Decentralized Storage: แตกต่างกันอย่างไร
Distributed storage หมายถึงการกระจายข้อมูลไปยังหลายโหนด แต่องค์กรเดียวยังเป็นเจ้าของและควบคุมทั้งระบบ ทั้งนโยบาย สิทธิ์การเข้าถึง ความสามารถในการลบข้อมูล และบันทึกการตรวจสอบ ส่วน Decentralized storage ตัดอำนาจส่วนกลางนี้ออกไปทั้งหมด ข้อมูลกระจายอยู่ระหว่างผู้เข้าร่วมอิสระ และไม่มีผู้ดำเนินการรายใดเพียงรายเดียวที่สามารถเซ็นเซอร์ เข้าถึง หรือลบข้อมูลได้ฝ่ายเดียว
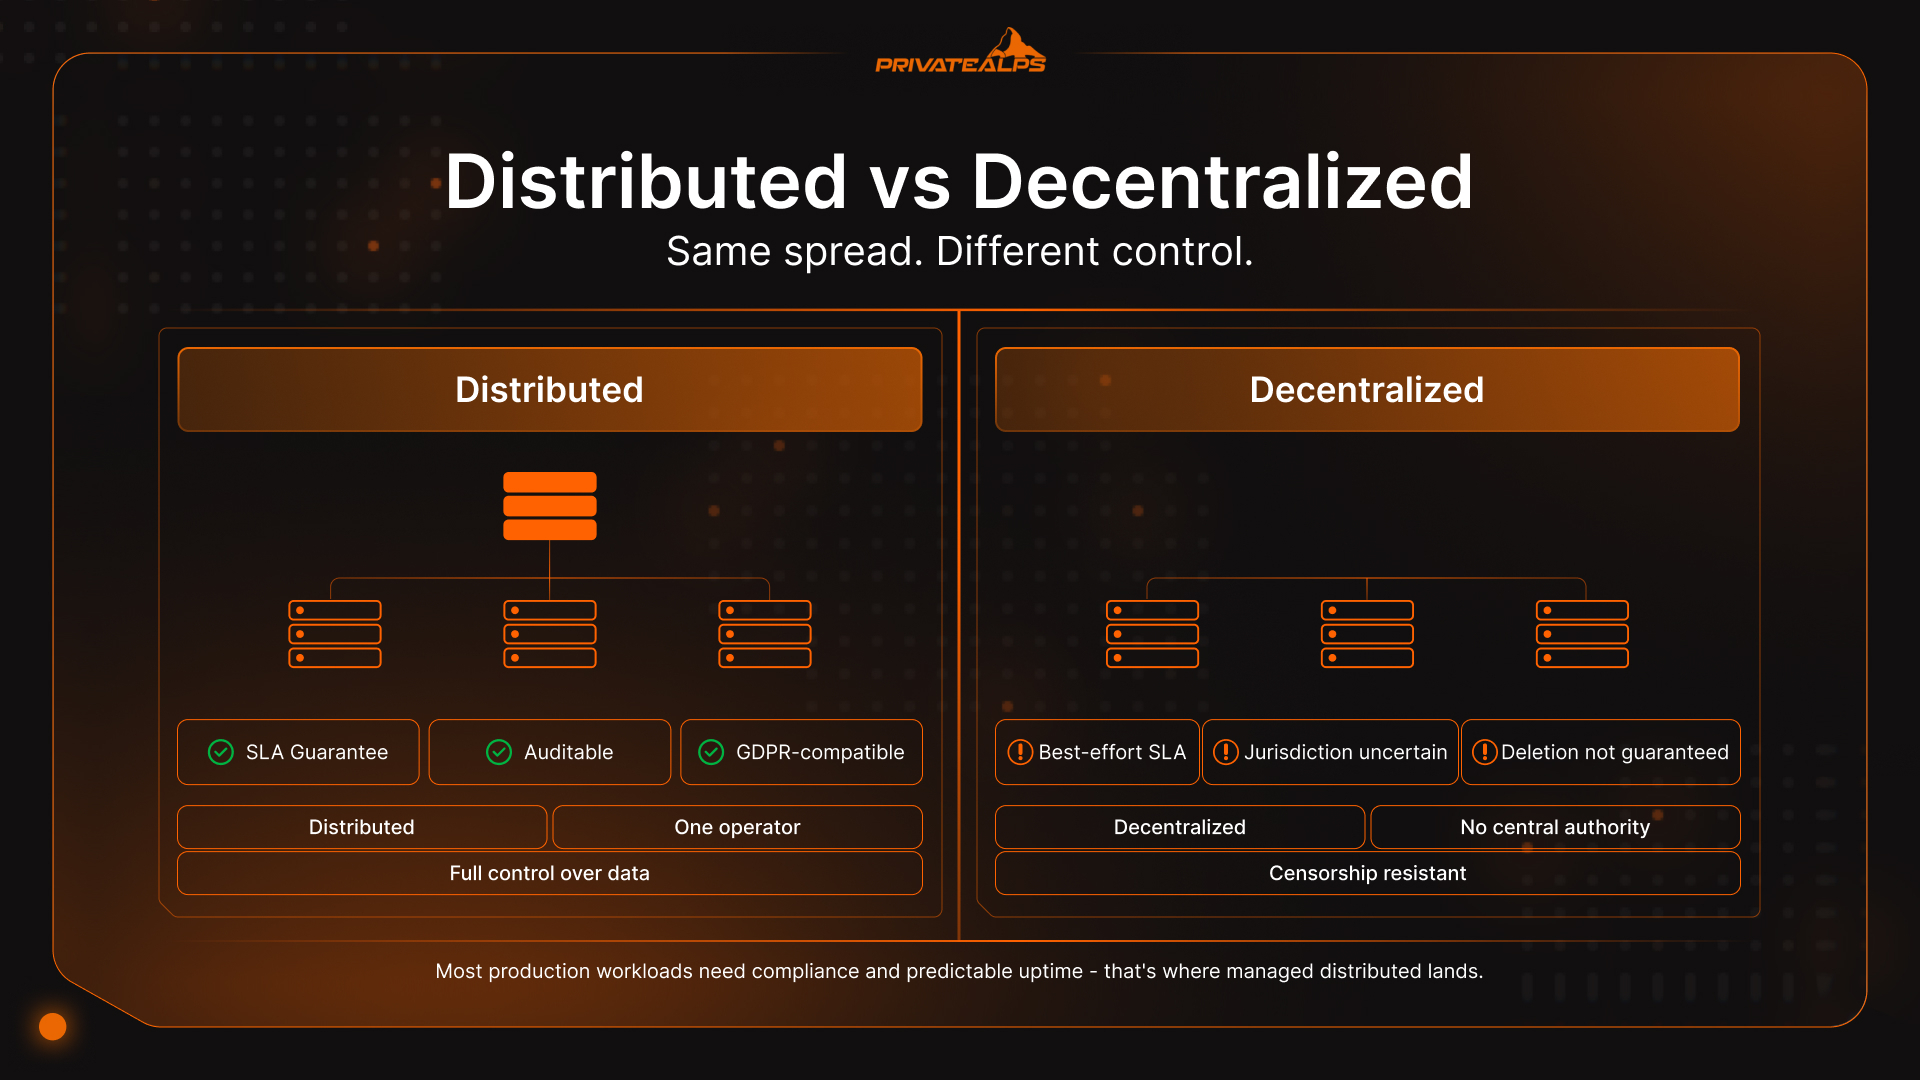
ความแตกต่างนี้ส่งผลต่อการปฏิบัติงานจริง ระบบ distributed ที่บริหารจัดการแบบรวมศูนย์สามารถตรวจสอบ อัปเดตแพตช์ มี SLA รองรับ และปฏิบัติตามข้อกำหนดด้านกฎระเบียบได้ ส่วนระบบ decentralized แลกสิ่งเหล่านี้กับความทนทานต่อการเซ็นเซอร์และการทำงานแบบไม่ต้องไว้วางใจผู้ใดเป็นพิเศษ ซึ่งมีคุณค่าในบริบทเฉพาะ แต่ไม่ใช่สิ่งที่ธุรกิจส่วนใหญ่ที่ใช้โครงสร้างพื้นฐานการจัดเก็บข้อมูลในระบบจริงต้องการ
| มิติ | Distributed Storage | Decentralized Storage |
|---|---|---|
| การควบคุม | บริหารจัดการแบบรวมศูนย์ | ไม่มีอำนาจส่วนกลาง |
| SLA / การรับประกันเวลาทำงาน | สามารถทำสัญญารับประกันได้ | ขึ้นอยู่กับโปรโตคอลและแบบ best-effort |
| การปฏิบัติตามกฎระเบียบ | ตรวจสอบได้, รองรับ GDPR | ขอบเขตเขตอำนาจไม่แน่นอน |
| การลบข้อมูล | รับประกันได้ | ไม่สามารถทำได้เสมอไป |
| การควบคุมการเข้าถึง | อิงบทบาท (role-based), จัดการโดยระบบ | อิงการเข้ารหัส, ไม่ต้องไว้วางใจผู้ใด |
| ตัวอย่าง | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
อีกชั้นหนึ่งที่ควรแยกให้ชัดคือ multi-region cloud storage เช่น AWS S3 ที่ทำ cross-region replication หรือ Azure geo-redundant storage ซึ่งยังคงเป็นโครงสร้างพื้นฐานที่บริหารแบบรวมศูนย์ ผู้ให้บริการเป็นผู้จัดการโหนดและการทำสำเนา ผู้ใช้จึงเป็นเพียงผู้เช่าพื้นที่ทางภูมิศาสตร์ ส่วนแพลตฟอร์ม distributed cloud ที่แท้จริง เช่น Storj หรือ Cubbit จะกระจายข้อมูลไปยังผู้ดำเนินการอิสระ ช่วยลดการผูกติดกับผู้ให้บริการรายเดียว แต่ก็ทำให้เกิดคำถามเรื่อง SLA และบันทึกการตรวจสอบอีกครั้ง สำหรับงานส่วนใหญ่ที่ต้องการเอกสารการปฏิบัติตามกฎระเบียบและเวลาทำงานที่คาดการณ์ได้ แนวทาง distributed ที่มีการจัดการคือคำตอบที่เหมาะสมที่สุด
สรุป
distributed storage ไม่ใช่ผลิตภัณฑ์ แต่เป็นหมวดหมู่ทางสถาปัตยกรรม และรูปแบบที่เหมาะสมขึ้นอยู่กับสิ่งที่คุณใช้งานทั้งหมด Object storage, block storage และ file storage แต่ละแบบมีโมเดลข้อมูลที่ออกแบบมาเพื่อรูปแบบการเข้าถึงและลักษณะของงานที่แตกต่างกัน CAP theorem บังคับให้ต้องแลกระหว่างความสอดคล้องและความพร้อมใช้งานเมื่อเกิดความล้มเหลวของเครือข่าย การตัดสินใจผิดในจุดนี้อาจมีค่าใช้จ่ายสูง ส่วนเรื่อง replication เทียบกับ erasure coding ระดับความร้อนของข้อมูลเป็นตัวกำหนด ข้อมูลที่ใช้บ่อยต้องใช้ replication เพื่อความหน่วงต่ำ ส่วนข้อมูลที่ไม่ค่อยเข้าถึงจะได้ประโยชน์จากประสิทธิภาพการจัดเก็บของ erasure coding สำหรับทีมส่วนใหญ่ โซลูชัน distributed ที่มีการจัดการ ไม่ว่าจะเป็นผู้ให้บริการเอกชนหรือ public cloud ตราบใดที่การควบคุมถิ่นที่อยู่และความปลอดภัยของข้อมูลตรวจสอบได้ จะให้สมดุลที่ดีกว่าระหว่างความสามารถในการขยายระบบ ประสิทธิภาพ และความง่ายในการดูแลรักษาประจำวัน เมื่อเทียบกับคลัสเตอร์ที่ดูแลเอง
จัดเก็บข้อมูลของคุณในสวิตเซอร์แลนด์กับ PrivateAlps
หากงานของคุณต้องการ distributed object storage ที่รองรับ S3 และสามารถตรวจสอบถิ่นที่อยู่ของข้อมูลได้ PrivateAlps ให้บริการโครงสร้างพื้นฐานที่ตั้งในสวิตเซอร์แลนด์ และสอดคล้องกับทั้ง GDPR Article 45 และ nFADP ข้อมูลของคุณจะอยู่ในสวิตเซอร์แลนด์ ไม่มีการแชร์ให้บุคคลที่สาม ไม่มีการส่งผ่านเส้นทางในเขตอำนาจต่างประเทศที่ไม่ชัดเจน และไม่มีเซอร์ไพรส์ ไม่ว่าคุณกำลังย้ายออกจาก hyperscaler หรือสร้างสถาปัตยกรรม distributed storage ที่ให้ความสำคัญกับความเป็นส่วนตัวตั้งแต่ต้น PrivateAlps ก็มอบประสิทธิภาพและความมั่นใจด้านการปฏิบัติตามกฎระเบียบที่งานของคุณต้องการจริง
คำถามที่พบบ่อย
ความแตกต่างระหว่าง distributed storage กับ cloud storage คืออะไร
cloud storage คือรูปแบบการให้บริการ ผู้อื่นเป็นผู้จัดการโครงสร้างพื้นฐาน คุณเข้าถึงผ่านอินเทอร์เน็ตโดยจ่ายตามการใช้งาน ส่วน distributed storage คือสถาปัตยกรรม ที่ข้อมูลกระจายอยู่ในหลายโหนดเพื่อความสำรองและการขยายระบบ ทั้งสองเป็นแนวคิดที่แยกจากกัน คุณสามารถรัน distributed storage ทั้งหมดในองค์กรด้วย Ceph หรือ MinIO ได้ และผู้ให้บริการคลาวด์ก็สามารถให้บริการ centralized storage ผ่าน API ได้เช่นกัน บริการ cloud storage ส่วนใหญ่ใช้สถาปัตยกรรม distributed ภายใน แต่นั่นเป็นรายละเอียดของการพัฒนา ไม่ใช่นิยามของ cloud storage
ระบบ distributed storage ที่ดีที่สุดคืออะไร
ไม่มีคำตอบสากล ขึ้นอยู่กับงานและโมเดลข้อมูล สำหรับข้อมูลที่ไม่มีโครงสร้างและการสำรองข้อมูล object store ที่รองรับ S3 เช่น MinIO หรือ Ceph RADOS คือตัวเลือกมาตรฐาน สำหรับ volume ของฐานข้อมูลและดิสก์ของ VM ที่ต้องการ I/O แบบ block ที่สอดคล้องกันและความหน่วงต่ำ Ceph RBD หรือ Lightbits เหมาะกว่า สำหรับ shared filesystem ใน HPC หรือสภาพแวดล้อมเดิม ทีมงานมักเลือก GlusterFS หรือ HDFS เริ่มจากรูปแบบการเข้าถึงก่อน จากนั้นระบบจัดเก็บที่เหมาะสมจะตามมาเอง
Distributed storage เหมือนกับ RAID หรือไม่
ไม่เหมือน RAID ทำงานภายในเซิร์ฟเวอร์หรืออาร์เรย์จัดเก็บข้อมูลเครื่องเดียว และป้องกันความเสียหายของดิสก์ภายในเครื่องนั้น ส่วน distributed storage ทำงานข้ามโหนดจริงที่แยกกันและเชื่อมต่อผ่านเครือข่าย อาจครอบคลุมหลายอาคารหรือศูนย์ข้อมูลทั้งศูนย์ RAID ไม่ช่วยเมื่อเซิร์ฟเวอร์ทั้งเครื่องล้มเหลว ระบบ distributed storage ถูกออกแบบมาเพื่อรับมือกับความล้มเหลวของโหนด ความล้มเหลวของแร็ค และการหยุดทำงานของศูนย์ข้อมูลทั้งศูนย์โดยเฉพาะ ความแตกต่างด้านขอบเขตนี้เป็นพื้นฐานสำคัญ
Distributed storage จัดการกับความล้มเหลวของโหนดอย่างไร
โหนดจะส่งสัญญาณ heartbeat เป็นระยะไปยังชั้น metadata ของคลัสเตอร์ เมื่อโหนดหยุดตอบสนอง ระบบจะตรวจพบความล้มเหลว โดยทั่วไปภายในไม่กี่วินาที และส่งคำขอไปยังโหนดที่เก็บสำเนาหรือชิ้นส่วนที่ผ่าน erasure coding ในการตั้งค่าที่ใช้ replication กระบวนการกู้คืนเบื้องหลังจะสร้างสำเนาใหม่เพื่อคืนค่าจำนวนสำเนาตามที่กำหนดทั่วทั้งคลัสเตอร์ ทั้งหมดนี้เป็นไปโดยอัตโนมัติ ในคลัสเตอร์ distributed storage ที่ตั้งค่าอย่างถูกต้อง แอปพลิเคชันจะไม่รับรู้ถึงความล้มเหลวนั้นเลย
Distributed storage เหมาะกับธุรกิจขนาดเล็กหรือไม่
บริการ distributed storage แบบจัดการให้ เช่น object storage ที่รองรับ S3 จากผู้ให้บริการคลาวด์ หรือผู้เชี่ยวชาญอย่าง PrivateAlps ใช้งานได้ในทุกขนาดโดยไม่ต้องมีขั้นต่ำของคลัสเตอร์ ส่วนคลัสเตอร์ distributed storage ที่ดูแลเองเป็นเรื่องที่ต่างออกไป การรัน Ceph ในระดับใช้งานจริงมักต้องใช้โหนดอย่างน้อยสามถึงห้าโหนด ก่อนที่ภาระการดำเนินงานจะคุ้มค่า สำหรับทีมขนาดเล็ก บริการแบบจัดการให้ประโยชน์เชิงสถาปัตยกรรมของ distributed storage ครบถ้วน โดยไม่ต้องรับภาระในการจัดการโครงสร้างพื้นฐาน
