


Dağıtık Depolama Nedir?
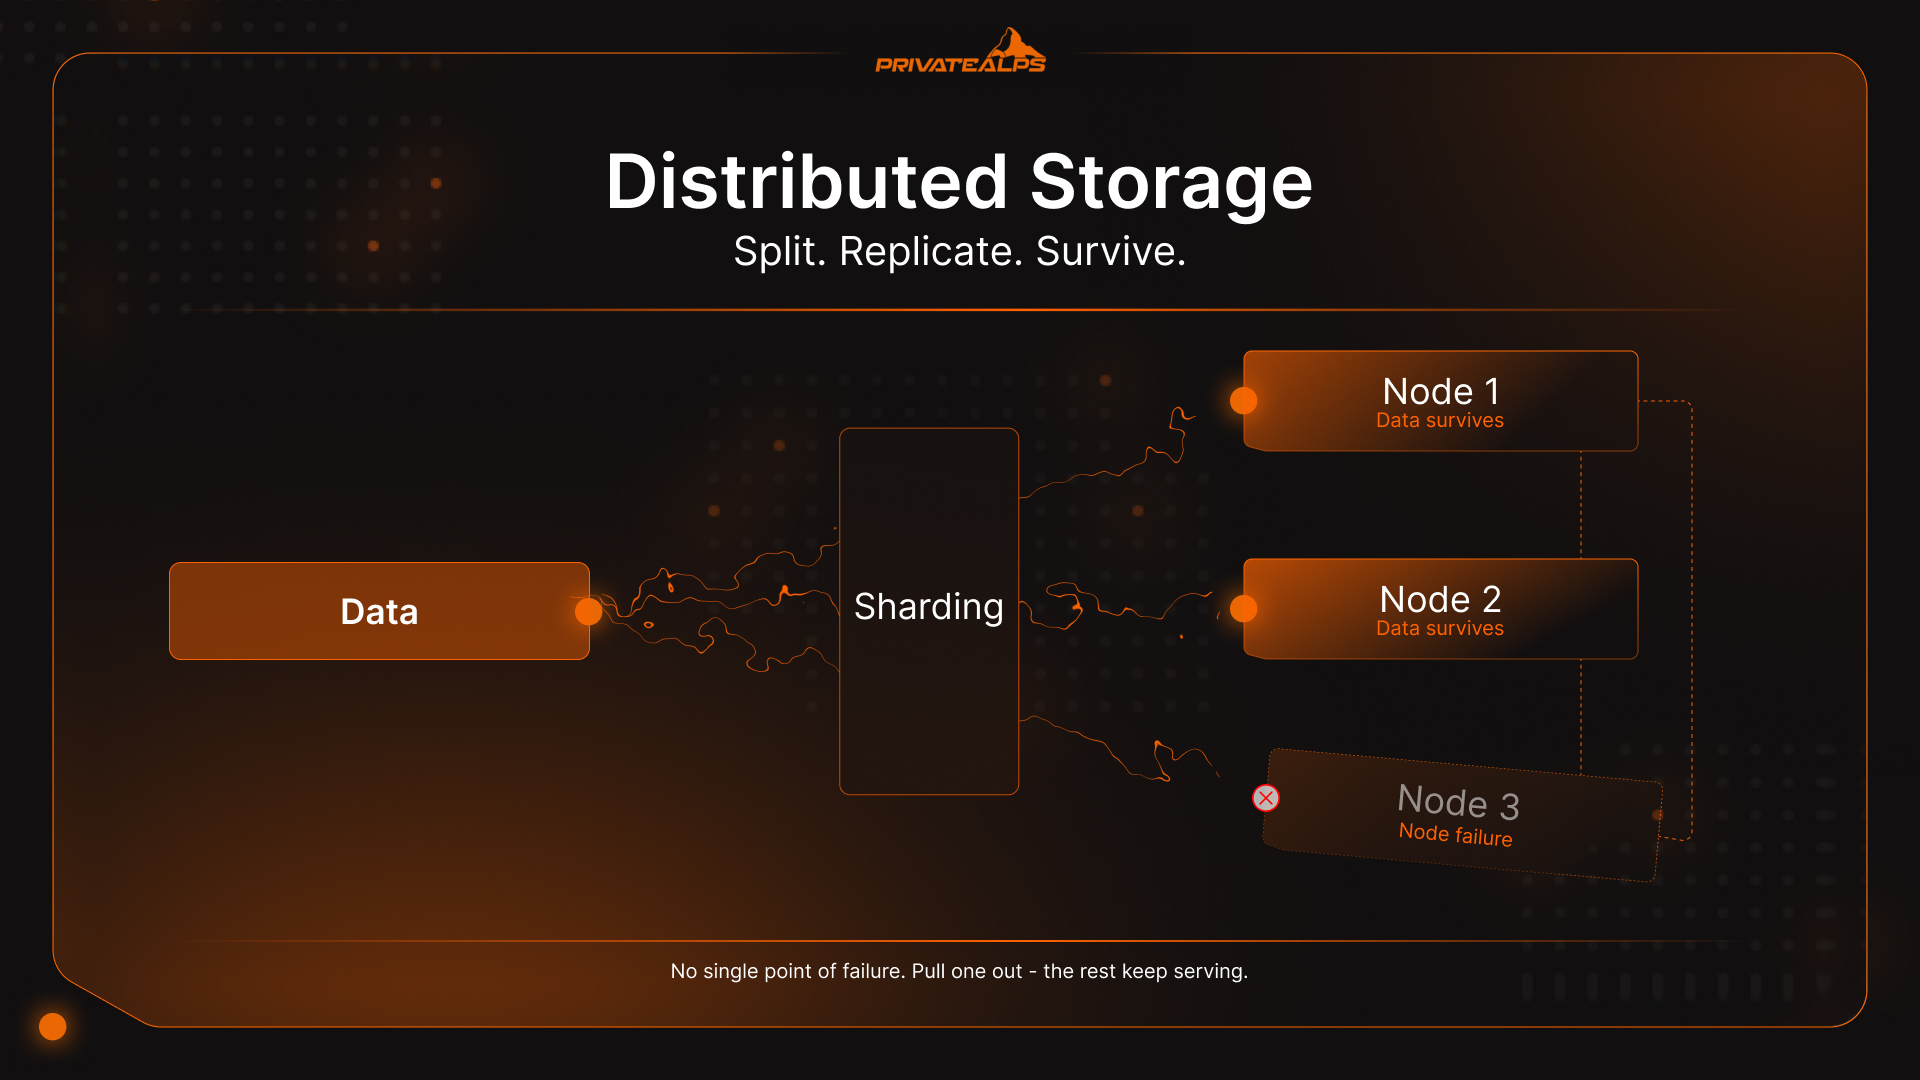
Dağıtık depolama, modern altyapıların tek bir makinede güvenilir biçimde tutulamayacak kadar büyük, kritik veya erişim yoğunluğu yüksek verileri nasıl yönettiğinin yoludur. Her şeyi tek bir sunucuya yazmak yerine sistem, bu verileri birden fazla bağımsız düğüm üzerinde (sunucular, diskler, veri merkezleri) böler, çoğaltır veya kodlar. Düğümler birlikte çalışır, ancak hiçbiri her şeyi tek başına tutmaz. Bir düğüm devre dışı kaldığında diğerleri hizmet vermeye devam eder. Bu rehber, dağıtık depolama sistemlerinin yük altında gerçekte nasıl davrandığını, hangi mimari dengeleri zorunlu kıldığını ve hangi depolama türünün hangi iş yüküne uygun olduğunu ele alıyor.
Yapay Zeka Özeti
Dağıtık depolama, verileri üç temel teknikle birden fazla fiziksel düğüme bölen, yazılım tanımlı bir mimaridir: parçalama (verilerin farklı düğümlere yönlendirilen ayrık parçalara bölünmesi), çoğaltma (hızlı erişim için düğümler arasında birden fazla özdeş kopya tutulması) ve silme kodlaması (verilerin matematiksel eşlik bilgisiyle parçalara kodlanması, böylece herhangi bir alt kümeden bütünün yeniden oluşturulabilmesi).
Dağıtık depolama sistemlerinin üç ana türü vardır: nesne depolama (düz ad alanı, S3 uyumlu API), blok depolama (düşük gecikmeli rastgele G/Ç için sabit boyutlu birimler) ve dosya depolama (NFS veya SMB üzerinden hiyerarşik ad alanı). Her dağıtık veri depolama kurulumu CAP teoremi ile karşılaşır: tutarlılık, erişilebilirlik ve bölünme toleransından aynı anda yalnızca ikisini garanti edebilir.
Temel operasyonel fayda, düğüm arızalarının kesintiye yol açmamasıdır. Sistem istekleri otomatik olarak sağlam kalan kopyalara yönlendirir.
Söz konusu ölçek ise şöyle: insanlık her gün 400 milyon TB'ın üzerinde yeni veri üretiyor. Bu hacim, hiçbir merkezi mimarinin zamanla kendi ağırlığı altında çökmeden taşıyamayacağı bir büyüklük.
Dağıtık Depolama ile Merkezi Depolama Arasındaki Fark
Merkezi depolama, her şeyi tek bir konumda tutar: tek bir sunucu, tek bir SAN, tek bir veri merkezi. Model bu kadar basittir. Bu konumda bir sorun çıktığında her şey durur. Dağıtık depolama bu sorunu doğrudan çözer: veriler birden fazla bağımsız düğüm üzerinde yaşar, dolayısıyla tek bir arıza noktası tüm sistemi çevrimdışı bırakamaz veya tüm erişimi engelleyemez.
Tek bir donanım arızası erişimi durdurur. Tamamen. Ölçeklemek ise genellikle ana sistemi yükseltmek veya değiştirmek anlamına gelir; bu da kesinti ve kimsenin konuşmak istemediği bir yatırım maliyeti tartışması demektir. Dağıtık depolama her ikisinden de tasarım gereği kaçınır: büyümek için bir düğüm eklenir, bir düğüm arızalandığında ise küme onun etrafından yönlendirme yapar. Ne bir sorun çıkar ne de kesinti yaşanır. Veriler, herhangi bir arıza olmadan önce zaten birden fazla düğümdeydi.
| Boyut | Merkezi Depolama | Dağıtık Depolama |
|---|---|---|
| Hata toleransı | Tek arıza noktası | Veriler tekil düğüm kaybından sağ çıkar |
| Ölçeklenebilirlik | Dikey (donanımı yükseltme) | Yatay (düğüm ekleme) |
| Gecikme | Yerel erişimde düşük | Değişken; ağ topolojisine bağlı |
| Küçük ölçekte maliyet | Daha düşük başlangıç maliyeti | Daha yüksek minimum uygulanabilir küme |
| Büyük ölçekte maliyet | Ölçeklemesi pahalı | Standart donanım maliyeti düşürür |
| Coğrafi dağılım | Tek konum | Yapılandırmayla çok bölgeli |
| Operasyonel karmaşıklık | Yönetimi basit | Orkestrasyon araçları gerektirir |
Dağıtık Depolama Sistemleri Nasıl Çalışır?
Dağıtık bir depolama sistemi gelen veriyi alır, parçalara böler, bu parçaları küme genelindeki doğru düğümlere yönlendirir ve her parçayı bir üst veri katmanı aracılığıyla izler. Böylece herhangi bir parça, hangi düğümde tutulduğu fark etmeksizin istendiğinde bulunabilir, alınabilir ve yeniden birleştirilebilir. Temel döngü budur. Bunu dört mekanizma güçlendirir:
- Parçalama (Veri Bölümleme) Veri sisteme ulaştığında, sistem onu daha küçük parçalara (shard veya blok) ayırır ve düğümlere dağıtır. Bu, paralel G/Ç'yi mümkün kılar: birden fazla düğüm aynı anda okuma ve yazma işlemlerini yürütür, böylece verim tek bir makinenin sınırına takılmak yerine küme büyüklüğüyle birlikte artar. Yönlendirme mantığı genellikle tutarlı karma (consistent hashing) kullanır. Bu yöntem, küme büyürken dağılımı dengeli tutar ve her düğüm eklendiğinde her şeyi yeniden düzenlemeyi gerektirmez.
- Çoğaltma Basit ama etkili bir yaklaşım: her parçanın N adet özdeş kopyası ayrı düğümlerde saklanır, genellikle üç adet. Bir düğüm çevrimdışı olduğunda diğer iki kopya hemen hizmet vermeye devam eder. Yeniden oluşturma yok, bekleme yok. Çoğaltma, sıcak veri için doğru tercihtir: aktif veritabanları, gerçek zamanlı akışlar ve okuma sırasında bir milisaniyelik ek gecikmenin gerçekten maliyet yarattığı her durum.
- Silme Kodlaması Depolama verimliliği hesabının ilginçleştiği nokta burasıdır. Sistem, üç tam kopya yerine bir nesneyi $k$ veri parçasına ve $m$ eşlik parçasına kodlar, $k+m$ parçanın tamamını düğümlere dağıtır ve bunların herhangi $k$ tanesinden tam nesneyi yeniden oluşturabilir. Dolayısıyla $m$ düğüm aynı anda arızalansa bile hiçbir veri kaybolmaz. Reed-Solomon RS(6,3) yapılandırması, 3x çoğaltmanın gerektirdiği 18 blok yerine 9 blok depolar ve ham depolama yükünü %200'den yaklaşık %50'ye düşürür. Bunun bedeli, kodlama ve kod çözme işlemlerinin CPU döngüsü tüketmesidir. Silme kodlaması, nadiren değiştirilen veya yüksek sıklıkta erişilmeyen soğuk veride daha iyi performans gösterir. Sık küçük yazma yapan iş yüklerinde ise 3x çoğaltma gecikme açısından hâlâ daha iyidir.
| Koruma Yöntemi | Depolama Yükü | En Uygun Olduğu Durum | Ödün |
|---|---|---|---|
| 3x Çoğaltma | 3x ham kapasite | Sıcak veri, düşük gecikmeli iş yükleri | Ölçekte yüksek depolama maliyeti |
| Silme Kodlaması RS(6,3) | 1,5x ham kapasite | Soğuk veri, arşivleme, büyük nesneler | CPU yükü, daha yüksek yeniden oluşturma gecikmesi |
- Üst Veri Yönlendirmesi Her dağıtık depolama sistemi bir üst veri katmanı tutar. Bu katman temelde hangi parçanın hangi düğümde olduğunu gösteren bir haritadır. İstemci veri talep ettiğinde üst veri servisi doğru düğümleri belirler; sistem parçaları alır ve yeniden birleştirir, istemci ise bu karmaşıklığın hiçbirini görmez. Ceph veya HDFS gibi büyük ölçekli kümelerde üst veri katmanının kendisi de düğümler arasında dağıtılmıştır. Dağıtılmak zorundadır, çünkü tek bir üst veri sunucusu, kaçmaya çalıştığınız darboğaza dönüşür.
Dağıtık Depolama Sistemlerinin Türleri
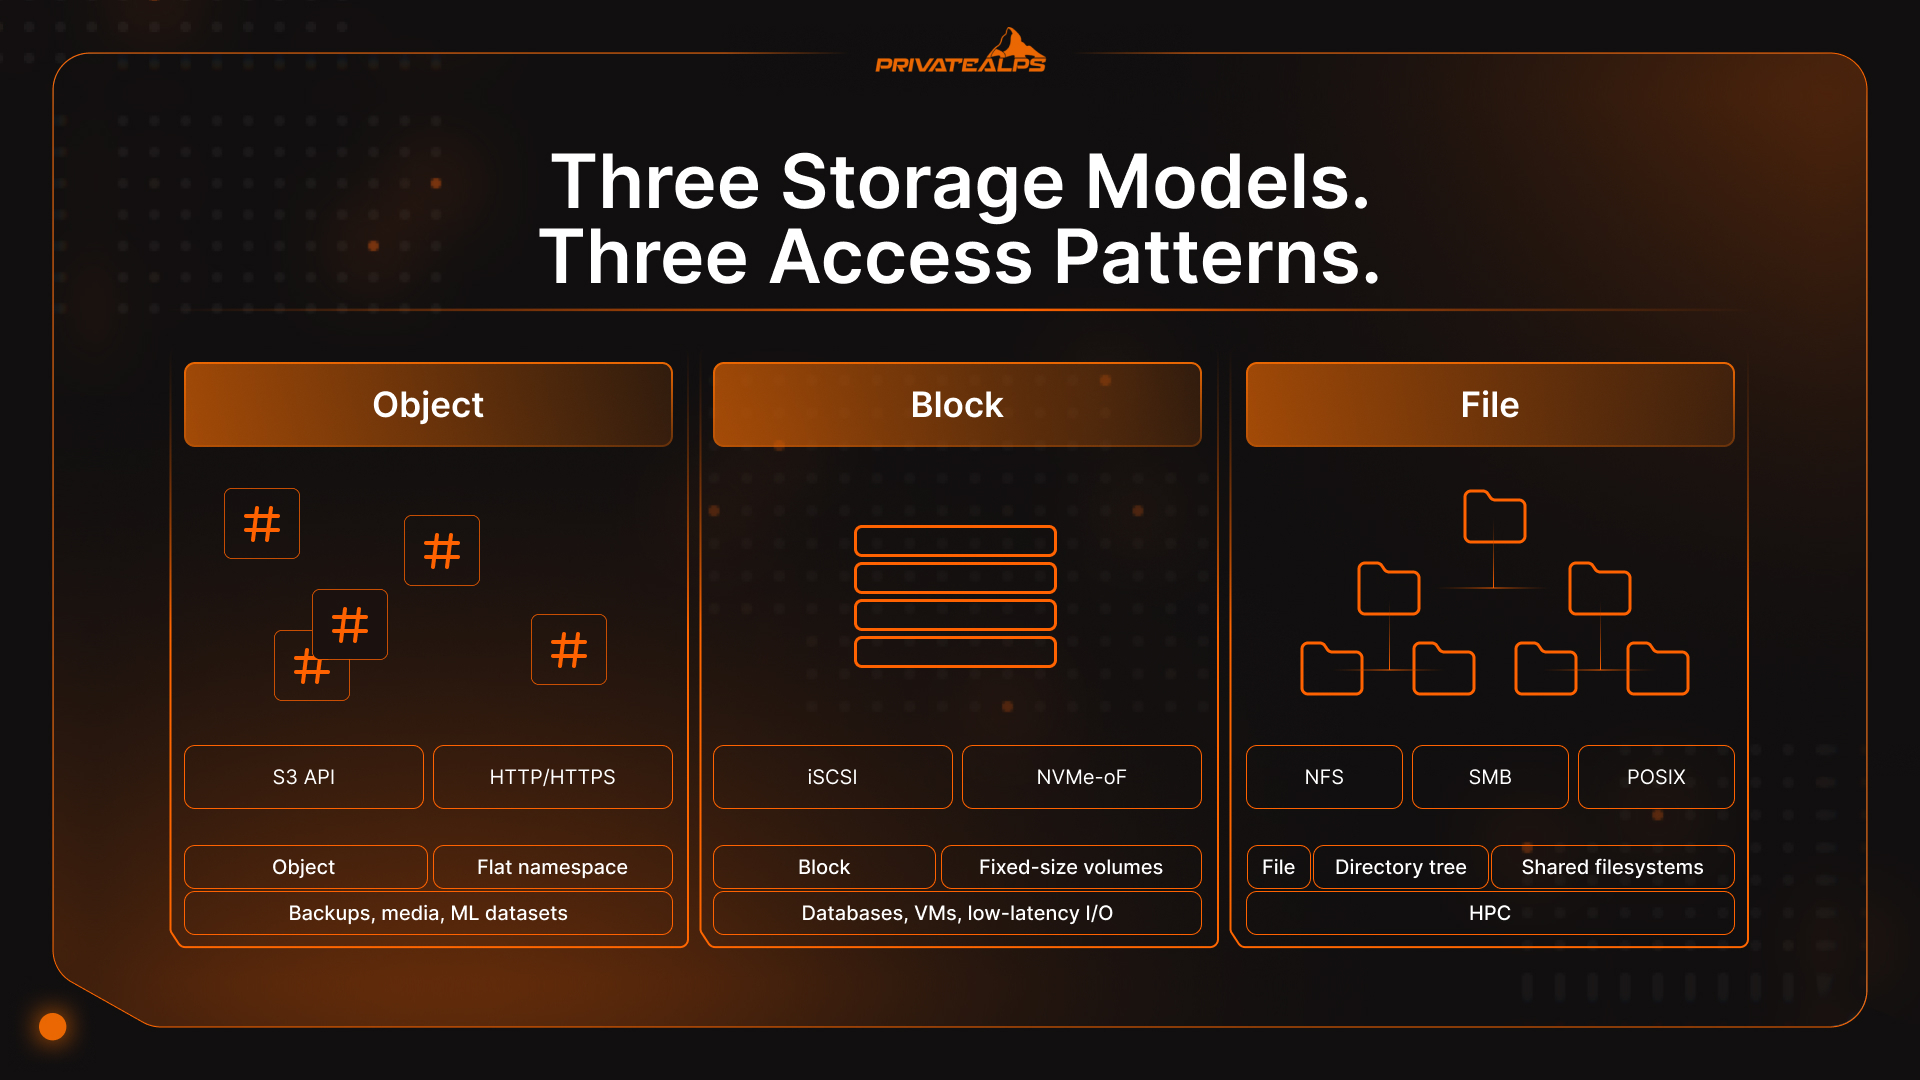
Dağıtık depolama tek bir şey değildir. Altında üç farklı veri modeli bulunan bir kategoridir ve bir iş yükü için yanlış modeli seçmek şaşırtıcı derecede yaygın ve pahalı bir hatadır. Nesne, blok ve dosya depolama, her biri farklı bir problemi çözer. Cassandra, CockroachDB ve Google Spanner gibi dağıtık veritabanları ise dördüncü bir türü temsil eder: dağıtık veri yönetiminin üzerine sorgu anlambilimi ekler. Ancak bu ayrı bir konudur.
| Tür | Verinin Saklanma Biçimi | Erişim Yöntemi | En Uygun Olduğu Durum | Örnekler |
|---|---|---|---|---|
| Nesne | Düz ad alanı, zengin üst verili nesneler | S3 uyumlu API (HTTP/HTTPS) | Ölçekte yapılandırılmamış veri: yedekler, medya, ML veri kümeleri | AWS S3, MinIO, Ceph RADOS |
| Blok | Sabit boyutlu ham birimler | iSCSI, NVMe-oF, FC | Veritabanları, sanal makineler, düşük gecikmeli rastgele G/Ç | Ceph RBD, AWS EBS, Lightbits |
| Dosya | Hiyerarşik dizin ağacı | NFS, SMB, POSIX | Paylaşımlı dosya sistemleri, HPC, ev dizinleri | GlusterFS, HDFS, Azure Files |
Dağıtık Nesne Depolama
Dağıtık nesne depolama, verileri düz bir ad alanında duran bağımsız ve değiştirilemez nesneler olarak düzenler. Dizin yok, dosya yolu yok, korunacak bir hiyerarşi yok. Her nesne benzersiz bir tanımlayıcı (bir karma veya UUID) ile zengin üst veri alır ve ona HTTP üzerinden S3 uyumlu bir API ile ulaşılır. Nesneler kısmen güncellenmek yerine değiştirildiğinden, blok ve dosya sistemlerinde performansı kısıtlayan ve ölçeklenebilirliği sınırlayan kilitlenme sorunu ortadan kalkar. AWS S3, Azure Blob ve Ceph'in exabayt ölçeğine ulaşabilmesinin nedeni de budur: ad alanı koordinasyon yükü yoktur, kilit çekişmesi yoktur ve kümedeki herhangi bir düğüm herhangi bir nesne isteğine bağımsız olarak yanıt verebilir.
Dağıtık Blok Depolama
Blok depolama, sunuculara ham birimler sunar: benzersiz adresleri olan sabit boyutlu bloklar, üzerinde hiçbir dosya sistemi soyutlaması yoktur. Uygulamalar doğrudan bloklara yazar ve bu, veritabanları, sanal makine diskleri ve konteynerli iş yükleri için tutarlı, düşük gecikmeli rastgele G/Ç sağlar. İnsanları şaşırtan bir mimari sınırlama vardır: bir blok birimi normalde aynı anda yalnızca bir sunucu tarafından bağlanabilir. Birden fazla sunucunun ortak erişimi, blok aygıtların üzerine katmanlanmış bir küme dosya sistemi gibi ek orkestrasyon gerektirir.
Dağıtık Dosya Depolama
Dosya depolama, paylaşımlı bir dosya sistemini standart protokollerle sunar: NFS, SMB, POSIX uyumlu erişim. Birden fazla istemci aynı birimi aynı anda bağlayabilir; bu da onu işbirlikçi iş yükleri, HPC ortamları ve bir dizin ağacı bekleyen, yakın zamanda yeniden yazılması planlanmayan eski uygulamalar için doğal bir seçenek hâline getirir. Gerçek dünyadaki ödün şudur: dağıtık düğümler arasında tutarlı bir dizin ad alanını korumak, ölçekte katlanarak büyüyen koordinasyon yükü yaratır. Çoğu hiper ölçekli sağlayıcı, birimler yeterince büyüdüğünde birincil veriler için dağıtık dosya depolamadan dağıtık nesne depolamaya geçer.
CAP Teoremi: Dağıtık Depolamada Kaçınılmaz Denge
CAP teoremi, dağıtık bir veri sisteminin aynı anda üç şeyden yalnızca ikisini garanti edebileceğini söyler: Tutarlılık (her okuma en son yazılan veriyi döndürür), Erişilebilirlik (her istek bir yanıt alır) ve Bölünme Toleransı (sistem ağ bölünmeleri boyunca çalışmaya devam eder). Ağlar bölünür; bu nedenle bölünme toleransı isteğe bağlı değildir. Asıl karar, bir arıza oluştuğunda her zaman tutarlılık ile erişilebilirlik arasındadır.
[Eric Brewer, CAP'i 2000 yılında ortaya attı; Gilbert ve Lynch ise ispatı 2002'de biçimselleştirdi][https://www.scylladb.com/glossary/cap-theorem/]. Bu karar, dağıtık depolama mimarisindeki diğer her şeyi hâlâ şekillendirir; çünkü sistemin tam da en çok ihtiyaç duyduğunuz anda, yani zaten bir şeyin bozulduğu anda nasıl davranacağını belirler.
| Sistem | CAP Türü | Bölünme Sırasındaki Davranış | En Uygun Olduğu Durum |
|---|---|---|---|
| MongoDB | CP (çoğunluk okuma/yazma onayıyla) | Tutarlılık sağlanana kadar istekleri reddeder | Finansal kayıtlar, envanter, rezervasyon |
| HBase | CP | Eski veri yerine hata döndürür | Yapılandırılmış analitik, tutarlı toplu işler |
| Apache Cassandra | AP | Erişilebilir kalır; eski okumalar sunabilir | Sosyal akışlar, mesajlaşma, IoT telemetrisi |
| DynamoDB (varsayılan) | AP | Her zaman yanıt verir; tutarsızlığı eşzamansız uzlaştırır | Yüksek verimli tüketici uygulamaları |
| CockroachDB | CP | Önce tutarlılık, dağıtık SQL | Küresel işlemsel iş yükleri |
Pratik karar şudur: iş yükünüz eski bir okumayı tolere edebilir mi? Bir banka bakiyesi, bir koltuk rezervasyonu, bir envanter sayımı için büyük olasılıkla hayır; CP tercih edin. Bir sosyal akış, bir sensör olay akışı, analitik telemetri için birkaç saniyelik eskilik kabul edilebilir; AP tercih edin ve erişilebilirlik garantisini koruyun.
Dağıtık Depolama Güvenliği: Şifreleme ve Veri Egemenliği
Dağıtık depolamada güvenlik üç ayrı katmanda ele alınır: durağan veri, aktarım halindeki veri ve anahtar sahipliği. Bu katmanlardan birini yanlış kurarsanız diğerleri sizi korumaz. Altyapı kusursuz çalışıyor olabilir, ancak hassas veriler yetkisiz kişilerce fark edilmeden erişilebilir durumda olabilir.
Şifreleme üçüne de uygulanmalıdır. Durağan veri genellikle AES-256 ile şifrelenir; anahtarlar ise ya sağlayıcı tarafından ya da müşteri tarafından yönetilen anahtarlarla (CMK) yönetilir. Sağlayıcı tarafından yönetilen anahtarlar işletme açısından daha kolaydır, ancak anahtar materyali depolama sağlayıcısının elindedir. Bu da denetimlerden geçen düzenlemeye tabi sektörler için kritik bir güvenlik konusudur. İstemci tarafı şifreleme bu riski tamamen ortadan kaldırır: veriler istemciden çıkmadan şifrelenir, dolayısıyla hangi yasal talep gelirse gelsin sağlayıcı açık metne hiçbir zaman erişemez. Aktarım halindeki veriler için TLS 1.3 güvenlik asgarisidir; hâlâ TLS 1.2'ye izin veren her sistem, çoğu güncel uyumluluk çerçevesi kapsamında belgelenmiş bir istisna gerektirir.
Veri egemenliği ekiplerin çoğunu beklenmedik şekilde yakalar. Veriler, şirketin ülkesine ya da kullanıcının konumuna değil, fiziksel olarak bulunduğu yerin yasalarına tabidir. İsviçre, GDPR Madde 45 kapsamında yeterlilik statüsüne sahiptir; dolayısıyla AB'den İsviçre'ye veri aktarımları ek sözleşmesel güvencelere gerek duymadan yapılabilir. Yenilenen Veri Koruma Federal Yasası (nFADP), İsviçre'nin iç mevzuatını GDPR ile uyumlu hale getirir. Bu da İsviçre altyapısının iki çerçeveyi aynı anda karşılayan tutarlı bir düzenleyici kapsam sunduğu anlamına gelir.
Ertelenmesi kolay ama ertelenmemesi gereken bir konu var: bugün çoğu depolama altyapısını koruyan kriptografik algoritmalar, yetenekli bir kuantum bilgisayara dayanacak şekilde tasarlanmamıştır. NIST, Ağustos 2024'te FIPS 203 (ML-KEM) dahil üç kuantum sonrası kriptografi standardını yayımladı. Dağıtık veri depolamanızda tıbbi arşivler, finansal kayıtlar ya da hukuki belgeler gibi uzun saklama süreli kayıtlar varsa "önce topla, sonra çöz" tehdit modeli zaten aktiftir. Değerlendirme sürecine, bu arşivler olgunluk aşamasına gelmeden çok önce başlanmalıdır.
Dağıtık Depolamanın Başlıca Avantajları
- Hizmet kesintisi olmadan hata toleransı: Bir düğümün arızalanması, kalp atışı tespitini ve hayatta kalan kopyalara otomatik yönlendirmeyi tetikler. Manuel müdahale ya da bakım penceresi gerekmez.
- Yatay ölçeklenebilirlik: Yeni depolama kapasitesi, kümeye düğüm eklenerek sağlanır. Veriler, canlı trafiğe dokunmadan ve kesinti gerektirmeden arka planda yeniden dengelenir.
- Coğrafi dağıtım: Bölgeler arası replikasyon, coğrafi olarak dağınık kullanıcılar için gecikmeyi azaltır ve veri konumu uyumluluğunu bir altyapı projesi olmaktan çıkarıp bir yapılandırma kararına dönüştürür.
- Paralel I/O verimi: Birden fazla düğüm okuma ve yazma işlemlerini aynı anda gerçekleştirir. Bu, gerçek üretim hacminde YZ/ML eğitim süreçleri, video kodlama veya medya akışı için ölçeklenebilen tek mimaridir.
- Açık protokollerle satıcı bağımlılığı olmaması: S3 uyumlu API'ler, NFS ve Ceph gibi açık kaynaklı platformlar, ekiplerin uygulama kodunu yeniden yazmadan sağlayıcılar arasında geçiş yapmasına ya da altyapıyı şirket içinde çalıştırmasına olanak tanır.
- Ölçekte maliyet verimliliği: Standart donanım, pahalı tescilli depolama dizilerinin yerini alır. Silme kodlaması (erasure coding), düğümler arasındaki tam replikasyona kıyasla ham kapasite gereksinimini %50'ye kadar daha da azaltır.
Dağıtık Depolamanın Sınırlamaları ve Zorlukları
- Tutarlılık karmaşıklığı: Düğümler arasında tutarlı bir durumu korumak; tutarlılık modellerinin, replikasyon faktörlerinin ve çoğunluk (quorum) ayarlarının dikkatli biçimde yapılandırılmasını gerektirir. Yanlış yapılandırma yüksek sesle kendini belli etmez, verileri sessizce ayrışmaya sürükler.
- Operasyonel yük: Dağıtık bir depolama kümesini işletmek; arıza alanı planlaması, düğüm değiştirme prosedürleri, izleme süreçleri ve performans ayarlarının sorumluluğunu üstlenmek anlamına gelir. Tek bir sunucu sizden bunların hiçbirini istemez.
- Ağ bağımlılığı: Tüm mimari, düğümler arasında güvenilir ve yüksek bant genişlikli bağlantı varsayar. Ağdaki bozulma, doğrudan ve orantılı olarak depolama gecikmesine ve verim kaybına dönüşür.
- Küçük rastgele I/O'da gecikme: Dağıtık depolama, büyük ardışık okumalar ve paralel verim için optimize edilmiştir. Yoğun küçük rastgele I/O içeren iş yükleri, özellikle OLTP veritabanları, genellikle yerel bağlı NVMe blok depolama üzerinde daha iyi performans gösterir.
- Asgari uygulanabilir ölçek: Dağıtık depolamanın maliyet ve karmaşıklık avantajları iki düğümlü bir kümede görünmez. Belirli bir eşiğin altında, yönetilen bir bulut depolama hizmeti ya da iyi ayarlanmış tek bir sunucu, basitçe daha ucuz ve işletilmesi daha kolaydır.
Dağıtık Depolamanın Gerçek Dünya Kullanım Alanları
- Medya ve Yayın Netflix ve YouTube, videoları merkezi bir konumdan sunmaz; kodlanmış içeriği izleyicilere coğrafi olarak yakın nesne depolama kümelerine dağıtır. Tek bir veri merkezi, eşzamanlı küresel yayın talebini ölçekte karşılayamaz; yalnızca bant genişliği maliyetleri bile yasaklayıcı olurdu. Dağıtık veri depolama, yayıncılığın ekonomisini gerçekten işler kılan unsurdur.
- Sağlık Tek bir MR çalışması 500 MB ile 1 GB arasında görüntüleme verisi üretir. Bunu büyük bir hastane ağıyla çarpın; farklı modaliteler, uzun saklama gereksinimleri ve birden fazla lokasyon bir araya geldiğinde hızla petabaytlar biriktiğini görürsünüz. Coğrafi yedeklilikle ölçeklenebilen dağıtık depolama, bölgesel bir veri merkezi arızalandığında bile sağlık sistemlerinin hasta kayıtlarına HIPAA uyumlu erişimi sürdürmesinin yoludur.
- YZ ve Makine Öğrenmesi Büyük bir dil modelini eğitmek, GPU kümelerine terabaytlar ila petabaytlar arasında veri beslemek anlamına gelir. Bu veriler, geleneksel bir depolama sistemini neredeyse anında doyuma ulaştıracak ardışık olmayan desenlerle erişilir. Ceph, HDFS ve S3 uyumlu nesne depoları, paralel okuma verimleri GPU kümelerinin gerçekten tükettiği hızla eşleştiği için ML süreçlerinin standart altyapı katmanı haline geldi.
- Yedekleme ve Felaket Kurtarma Gerçek felaket kurtarma, verilerin en az iki coğrafi olarak ayrı konumda ve bağımsız arıza alanlarında bulunması demektir; aynı binadaki iki raf bunun yerini tutmaz. Doğrudan dağıtık depolama katmanına yerleşik replikasyon politikaları ve yerleşim kuralları, ayrı bir yedekleme yazılımı yığınına ihtiyaç duymadan RPO ve RTO değerlerini altyapı düzeyinde belirler. Daha az hareketli parça, daha küçük bir saldırı yüzeyi anlamına da gelir.
Dağıtık Depolama ile Merkezi Olmayan Depolama Arasındaki Fark Nedir?
Dağıtık depolama, verilerin birçok düğüme yayılması anlamına gelir; ancak tüm sistemin politikaları, erişim hakları, silme yetkisi ve denetim kayıtları hâlâ tek bir kuruluşun sahipliği ve kontrolü altındadır. Merkezi olmayan depolama ise bu merkezi otoriteyi tamamen kaldırır. Veriler bağımsız eşler arasında dağıtılır ve tek bir operatör bu verileri tek taraflı olarak sansürleyemez, erişemez ya da silemez.
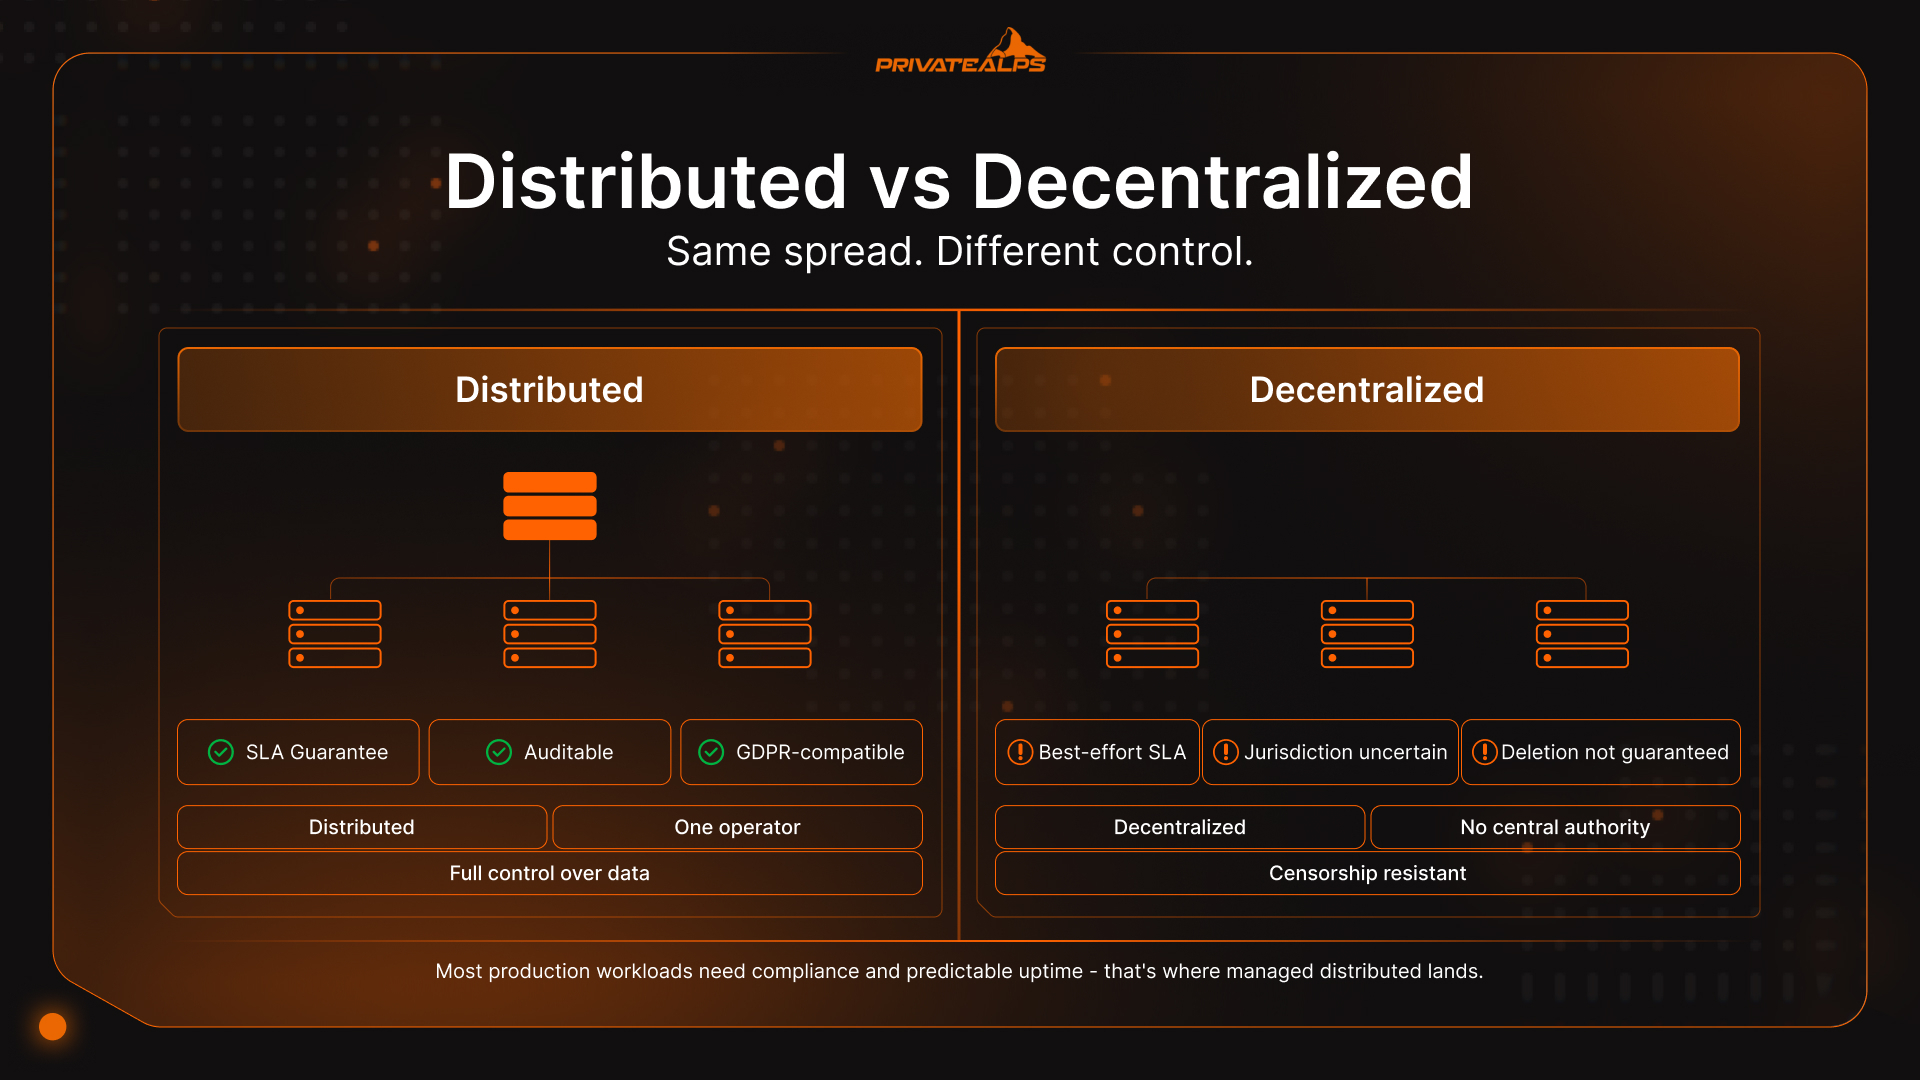
Bu ayrımın gerçek operasyonel sonuçları vardır. Merkezi olarak yönetilen bir dağıtık sistem denetlenebilir, yamalanabilir, SLA ile güvence altına alınabilir ve düzenleyici uyumluluğa getirilebilir. Merkezi olmayan bir sistem ise tüm bunlardan vazgeçerek sansür direnci ve güvene dayanmayan işletim sağlar. Bu özellik belirli bağlamlarda değerlidir, ancak üretim depolama altyapısı işleten çoğu işletmenin gerçekten ihtiyaç duyduğu şey değildir.
| Boyut | Dağıtık Depolama | Merkezi Olmayan Depolama |
|---|---|---|
| Kontrol | Merkezi olarak yönetilir | Merkezi otorite yoktur |
| SLA / çalışma süresi garantileri | Sözleşmesel garanti mümkündür | En iyi çaba esaslı, protokole bağlı |
| Uyumluluk | Denetlenebilir, GDPR uyumlu | Yargı alanı belirsiz |
| Veri silme | Garanti edilir | Her zaman mümkün değildir |
| Erişim kontrolü | Rol tabanlı, yönetilen | Kriptografik, güvene dayanmayan |
| Örnekler | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Ayrıca ayrı düşünülmesi gereken bir katman daha var: çok bölgeli bulut depolama (bölgeler arası replikasyonlu AWS S3, Azure coğrafi yedekli depolama) yine de merkezi olarak yönetilen bir altyapıdır. Sağlayıcı düğümleri ve replikasyonu yönetir; siz esasen coğrafyayı kiralamış olursunuz. Storj ya da Cubbit gibi gerçek dağıtık bulut platformları ise verileri bağımsız operatörler arasında yönlendirir. Bu yaklaşım sağlayıcı bağımlılığını ortadan kaldırır, ancak SLA ve denetim izleriyle ilgili soruları yeniden gündeme getirir. Uyumluluk belgelerine ve öngörülebilir çalışma süresine ihtiyaç duyan çoğu iş yükü için yönetilen dağıtık yaklaşım en uygun seçenektir.
Özet
Dağıtık depolama bir ürün değil, bir mimari kategoridir ve doğru türü tamamen neyi çalıştırdığınıza bağlıdır. Nesne, blok ve dosya depolama, farklı erişim desenleri ve iş yükü yapıları için tasarlanmış birer veri modeline sahiptir. CAP teoremi, ağ arızaları oluştuğu anda tutarlılık ile erişilebilirlik arasında gerçek bir ödünleşme yapılmasını zorunlu kılar; bu kararı yanlış vermek pahalıya mal olabilir. Replikasyon ile silme kodlaması karşılaştırıldığında ise veri sıcaklığı belirleyicidir: sık erişilen sıcak veriler gecikme için replikasyona ihtiyaç duyar, nadiren erişilen soğuk veriler ise silme kodlamasının depolama verimliliğinden yararlanır. Çoğu ekip için; veri konumu ve güvenlik kontrolleri doğrulanabilir olduğu sürece özel sağlayıcı ya da genel bulut fark etmeksizin yönetilen bir dağıtık çözüm, ölçeklenebilirlik, performans ve günlük operasyonel sadelik açısından kendi kurduğu bir kümeden daha iyi bir denge sunar.
Verilerinizi İsviçre'de Saklayın: PrivateAlps ile
İş yükünüz, doğrulanabilir veri konumuyla birlikte S3 uyumlu dağıtık nesne depolamaya ihtiyaç duyuyorsa, PrivateAlps hem GDPR Madde 45 hem de nFADP ile tam uyumlu, İsviçre merkezli altyapı işletmektedir. Verileriniz İsviçre'de kalır; üçüncü taraflarla paylaşılmaz, yabancı yargı alanları üzerinden belirsiz bir yönlendirmeye tabi tutulmaz. Bir hiperscaler'dan geçiş yapıyor olsanız da ya da sıfırdan gizlilik odaklı bir dağıtık depolama mimarisi kuruyor olsanız da PrivateAlps, iş yükünüzün gerçekten ihtiyaç duyduğu performansı ve uyumluluk güvencesini sunar.
Sıkça Sorulan Sorular
Dağıtık Depolama ile Bulut Depolama Arasındaki Fark Nedir?
Bulut depolama bir sunum modelidir: altyapıyı başka biri yönetir, siz de kullandıkça öde esasına göre internet üzerinden erişirsiniz. Dağıtık depolama ise bir mimaridir: yedeklilik ve ölçeklenebilirlik için veriler birden fazla düğüme yayılır. İki kavram birbirinden bağımsızdır. Dağıtık depolamayı Ceph veya MinIO ile tamamen şirket içinde çalıştırabilirsiniz; bir bulut sağlayıcısı da teknik olarak merkezi depolamayı bir API arkasından sunabilir. Çoğu bulut depolama hizmeti iç yapısında dağıtık mimariler kullanır, ancak bu bir uygulama ayrıntısıdır, bulut depolamanın tanımı değildir.
En İyi Dağıtık Depolama Sistemi Hangisidir?
Evrensel bir cevap yoktur; iş yüküne ve veri modeline bağlıdır. Yapılandırılmamış veriler ve yedeklemeler için MinIO veya Ceph RADOS gibi S3 uyumlu nesne depoları standart seçimdir. Tutarlı ve düşük gecikmeli blok I/O gerektiren veritabanı birimleri ve VM diskleri için Ceph RBD veya Lightbits daha uygun bir seçenektir. HPC ortamlarında ya da eski sistemlerde paylaşılan dosya sistemleri için ekipler genellikle GlusterFS veya HDFS'te karar kılar. Erişim desenini belirleyerek başlayın; depolama sistemi bunun ardından gelir.
Dağıtık Depolama, RAID ile Aynı Şey mi?
Hayır. RAID tek bir sunucu ya da depolama dizisi içinde çalışır ve bir makine içindeki disk arızalarına karşı koruma sağlar. Dağıtık depolama ise ağ üzerinden bağlı, ayrı fiziksel düğümler arasında çalışır ve birden fazla bina ya da tüm veri merkezlerine yayılabilir. Sunucunun kendisi arızalandığında RAID yardımcı olmaz. Dağıtık depolama sistemleri ise düğüm arızalarına, raf arızalarına ve tam veri merkezi kesintilerine dayanacak şekilde özel olarak tasarlanmıştır. Kapsamdaki fark temeldir.
Dağıtık Depolama Düğüm Arızalarını Nasıl Yönetir?
Düğümler, kümenin üst veri katmanına düzenli olarak kalp atışı sinyalleri gönderir. Bir düğüm yanıt vermeyi kestiğinde sistem arızayı tespit eder (genellikle birkaç saniye içinde) ve istekleri, replikaları ya da silme kodlamalı parçaları tutan düğümlere yönlendirir. Replikasyona dayalı kurulumlarda arka plandaki bir kurtarma süreci, küme genelinde yapılandırılmış replikasyon faktörünü geri kazanmak için yeni kopyalar oluşturur. Tüm bu süreç otomatiktir; iyi yapılandırılmış bir dağıtık depolama kümesinde uygulamalar arızayı hiç fark etmez.
Dağıtık Depolama Küçük İşletmeler İçin Uygun mu?
Yönetilen dağıtık depolama hizmetleri (bir bulut sağlayıcısının ya da PrivateAlps gibi uzman bir sağlayıcının sunduğu S3 uyumlu nesne depolama) minimum küme gereksinimi olmadan her ölçekte çalışır. Kendi sunucunuzda kurduğunuz dağıtık depolama kümeleri ise farklı bir durumdur: Ceph'i üretimde çalıştırmak, operasyonel yükün kendini haklı çıkarmaya başlamasından önce genellikle en az üç ila beş düğüm gerektirir. Küçük ekipler için yönetilen hizmetler, altyapı yönetimi yükü olmadan dağıtık depolamanın mimari faydalarının tamamını sunar.
