


Hvad er distribueret lagring?
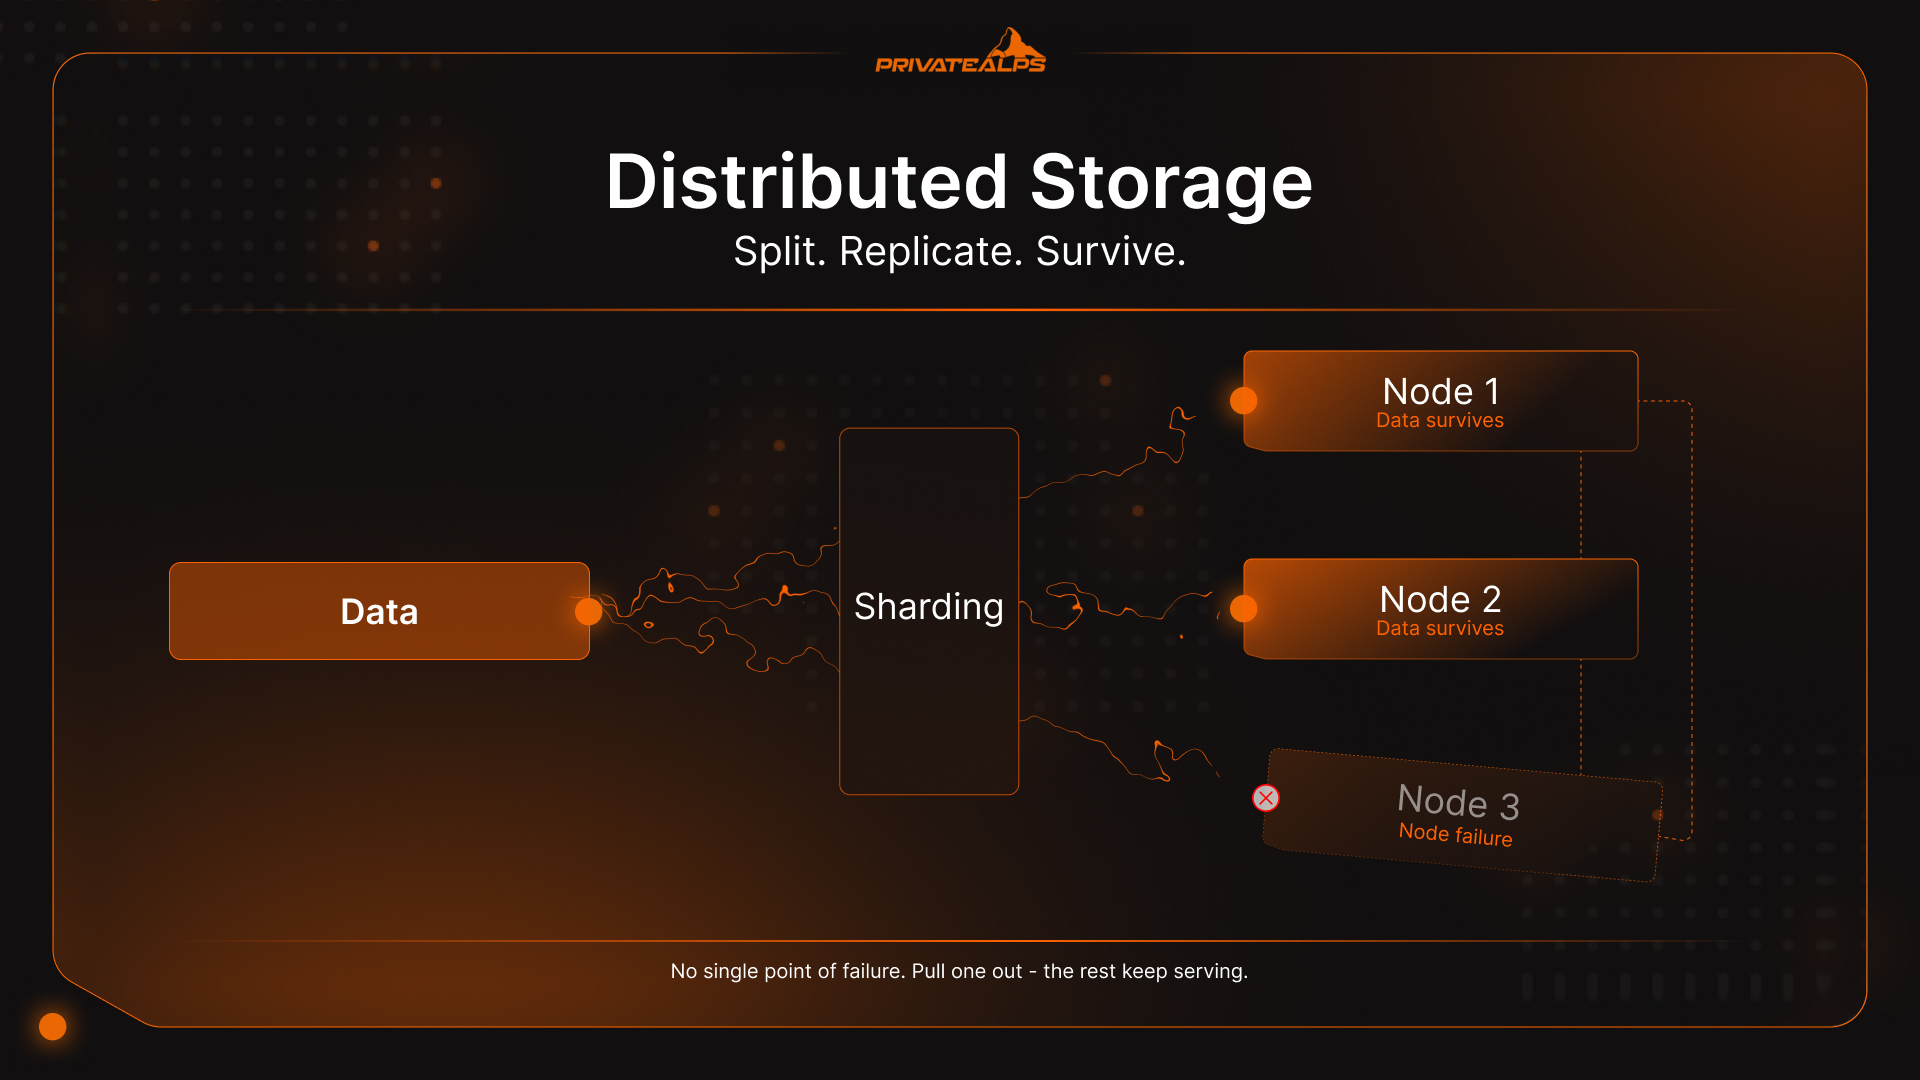
Distribueret lagring er den måde, moderne infrastruktur håndterer data, der simpelthen er for stor, for kritisk eller for hyppigt tilgået til, at én maskine kan holde dem pålideligt. I stedet for at skrive alt til én server deler, replikerer eller koder systemet dataene på tværs af flere uafhængige noder – servere, diske, datacentre. De arbejder sammen, men ingen enkelt node har det hele. Fjerner du én, fortsætter resten med at levere. Denne guide gennemgår, hvordan systemer til distribueret lagring faktisk opfører sig under belastning, hvilke arkitektoniske afvejninger de medfører, og hvilken lagringstype der passer til hvilken arbejdsbyrde.
AI-resumé
Distribueret lagring er en softwaredefineret arkitektur, der opdeler data på tværs af flere fysiske noder ved hjælp af tre centrale teknikker: sharding (opdeling af data i afgrænsede bidder, der sendes til forskellige noder), replikering (flere identiske kopier på tværs af noder for hurtig adgang) og erasure coding (kodning af data i fragmenter med matematisk paritet, så enhver delmængde kan genskabe helheden).
Der findes tre hovedtyper af systemer til distribueret lagring: objektlagring (fladt namespace, S3-kompatibel API), bloklagring (volumener med fast størrelse til lav-latens tilfældig I/O) og filelagring (hierarkisk namespace via NFS eller SMB). Enhver opsætning af distribueret datalagring støder på CAP theorem – det kan kun garantere to af konsistens, tilgængelighed og partitionstolerance samtidigt.
Den væsentligste operationelle fordel er, at nodefejl ikke forårsager nedetid; systemet sender automatisk forespørgsler videre til de replikaer, der stadig kører. Omfanget af det, der står på spil: Menneskeheden genererer over 400 millioner terabyte ny data hver eneste dag – en mængde, som ingen centraliseret arkitektur kan absorbere uden til sidst at kollapse under sin egen vægt.
Distribueret lagring vs. centraliseret lagring
Centraliseret lagring samler alt ét sted – én server, ét SAN, ét datacenter. Det er hele modellen. Når det sted får et problem, stopper alt. Distribueret lagring løser netop dette: Data ligger spredt over flere uafhængige noder, så ingen enkelt fejlkilde kan lukke hele systemet ned eller blokere al adgang.
Én hardwarefejl, og adgangen stopper. Punktum. Skalering betyder at opgradere eller udskifte det primære system, hvilket typisk indebærer nedetid og en samtale om investeringsomkostninger, som ingen har lyst til. Distribueret lagring undgår begge dele by design: Tilføj en node for at vokse, og når en node dør, kører klyngen uden om den. Ingen drama, ingen nedetid. Dataene lå allerede på flere noder, før noget gik i stykker.
| Dimension | Centraliseret lagring | Distribueret lagring |
|---|---|---|
| Fejltolerance | Enkelt fejlpunkt | Data overlever tab af enkelte noder |
| Skalerbarhed | Vertikal (opgrader hardware) | Horisontal (tilføj noder) |
| Latens | Lav ved lokal adgang | Varierer; afhænger af netværkstopologi |
| Omkostning i lille skala | Lavere startomkostning | Højere minimum for en brugbar klynge |
| Omkostning i stor skala | Dyrt at skalere | Standardhardware reducerer omkostningen |
| Geografisk fordeling | Enkelt lokation | Multi-region efter konfiguration |
| Driftskompleksitet | Simpel at administrere | Kræver orkestreringsværktøj |
Sådan fungerer systemer til distribueret lagring
Et system til distribueret lagring tager indkommende data, deler dem op i bidder, sender bidderne til de rigtige noder i klyngen og følger hvert stykke via et metadatalag. Derfor kan ethvert fragment findes, hentes og samles igen efter behov, uanset hvilken node der har det. Det er det grundlæggende kredsløb. Fire mekanismer driver det:
- Sharding (datapartitionering) Når data ankommer, skærer systemet dem i mindre stykker – shards eller blokke – og fordeler dem på noderne. Det er det, der muliggør parallel I/O: Flere noder håndterer læsninger og skrivninger samtidigt, så gennemstrømningen skalerer med klyngens størrelse i stedet for at ramme loftet for én maskine. Routinglogikken er typisk consistent hashing, som holder fordelingen jævn, efterhånden som klyngen vokser, uden at alt skal omfordeles, hver gang en node tilføjes.
- Replikering Den enkle, men effektive metode: Gem N identiske kopier af hver shard på separate noder, typisk tre. Hvis én node går offline, leverer de to andre straks videre. Ingen genopbygning, ingen ventetid. Replikering er det rigtige valg til hot data – aktive databaser, realtidsfeeds, alt hvor et ekstra millisekund ved læsning reelt koster dig noget.
- Erasure coding Her bliver regnestykket om lagringseffektivitet interessant. I stedet for tre fulde kopier koder systemet et objekt til $k$ datafragmenter plus $m$ paritetsfragmenter, fordeler alle $k+m$ på tværs af noderne og kan genskabe hele objektet ud fra et hvilket som helst $k$ af dem. Så kan $m$ noder fejle samtidigt, uden at noget går tabt. En Reed-Solomon RS(6,3)-konfiguration gemmer 9 blokke i stedet for de 18, som 3x replikering kræver, og reducerer den rå lagringsoverhead fra 200 % til cirka 50 %. Haken er, at kodning og dekodning bruger CPU-cyklusser, og erasure coding fungerer bedst på kolde data – indhold, der sjældent ændres eller tilgås med høj frekvens. Ved arbejdsbyrder med hyppige små skrivninger vinder 3x replikering stadig på latens.
| Beskyttelsesmetode | Lagringsoverhead | Bedst til | Afvejning |
|---|---|---|---|
| 3x replikering | 3x rå kapacitet | Hot data, arbejdsbyrder med lav latens | Høje lagringsomkostninger i stor skala |
| Erasure coding RS(6,3) | 1,5x rå kapacitet | Kolde data, arkivering, store objekter | CPU-overhead, længere genopbygningstid |
- Metadata-routing Ethvert system til distribueret lagring har et metadatalag – grundlæggende et kort over, hvilken shard der ligger på hvilken node. Når en klient anmoder om data, finder metadatatjenesten de rigtige noder, og systemet henter og samler fragmenterne uden, at klienten nogensinde ser kompleksiteten. I store klynger som Ceph eller HDFS er metadatalaget selv distribueret over noderne. Det må det være. En enkelt metadataserver bliver flaskehalsen, du forsøgte at komme væk fra.
Typer af systemer til distribueret lagring
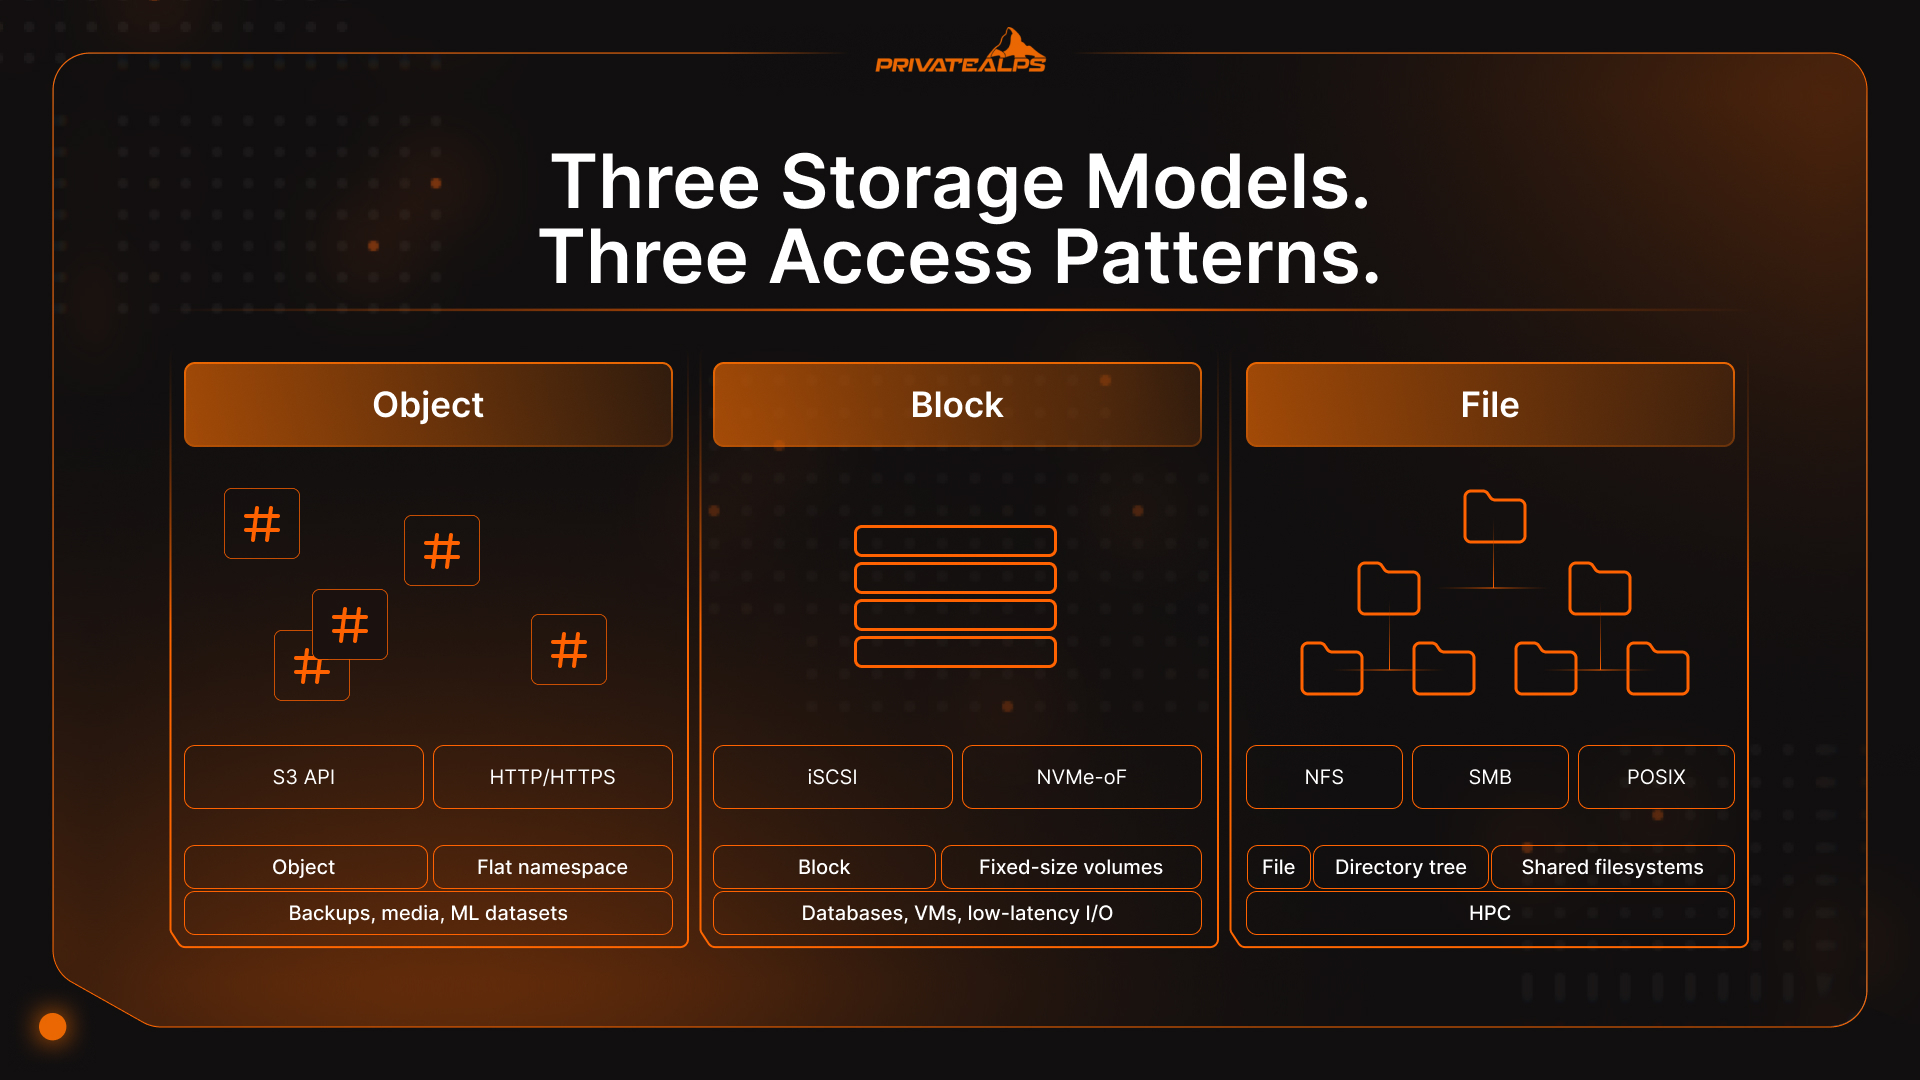
Distribueret lagring er ikke én ting. Det er en kategori med tre forskellige datamodeller under sig, og at vælge den forkerte til en arbejdsbyrde er en overraskende almindelig og dyr fejl. Objekt-, blok- og filelagring løser hver sit problem. Distribuerede databaser – Cassandra, CockroachDB, Google Spanner – udgør en fjerde type, der lægger forespørgselssemantik oven på distribueret datahåndtering, men det er en separat diskussion.
| Type | Sådan gemmes data | Adgangsmetode | Bedst til | Eksempler |
|---|---|---|---|---|
| Objekt | Fladt namespace, metadatarige objekter | S3-kompatibel API (HTTP/HTTPS) | Ustrukturerede data i stor skala: backups, medier, ML-datasæt | AWS S3, MinIO, Ceph RADOS |
| Blok | Råvolumener med fast størrelse | iSCSI, NVMe-oF, FC | Databaser, VM'er, lav-latens tilfældig I/O | Ceph RBD, AWS EBS, Lightbits |
| Fil | Hierarkisk mappetræ | NFS, SMB, POSIX | Delte filsystemer, HPC, hjemmemapper | GlusterFS, HDFS, Azure Files |
Distribueret objektlagring
Distribueret objektlagring organiserer data som individuelle, uforanderlige objekter i et fladt namespace – ingen mapper, ingen filstier, intet hierarki at vedligeholde. Hvert objekt får en unik identifikator (en hash eller UUID) plus rige metadata, og du når det via en S3-kompatibel API over HTTP. Fordi objekter erstattes i stedet for delvist opdateres, forsvinder låseproblemet, der begrænser ydeevnen og skalerbarheden i blok- og filsystemer. Sådan skalerer AWS S3, Azure Blob og Ceph til exabyte: Der er ingen overhead til koordinering af namespace, ingen låsekonflikter, og enhver node i klyngen kan selvstændigt besvare enhver objektforespørgsel.
Distribueret bloklagring
Bloklagring leverer rå volumener til servere – blokke med fast størrelse og unikke adresser uden et filsystem ovenpå. Applikationer skriver direkte til blokkene, og det er det, der giver konsistent, lav-latens tilfældig I/O til databaser, VM-diske og containeriserede arbejdsbyrder. Én arkitektonisk begrænsning, der overrasker folk: Et blokvolumen kan normalt kun monteres af én server ad gangen. Delt adgang fra flere servere kræver ekstra orkestrering ovenpå, for eksempel et klyngefilsystem lagt over blokenhederne.
Distribueret filelagring
Filelagring præsenterer et delt filsystem via standardprotokoller – NFS, SMB, POSIX-kompatibel adgang. Flere klienter kan montere det samme volumen samtidigt, hvilket gør det til det naturlige valg til samarbejdsbaserede arbejdsbyrder, HPC-miljøer og ældre applikationer, der forventer et mappetræ, og som ikke bliver omskrevet llige med det samme. Den reelle afvejning: At vedligeholde et konsistent mappe-namespace på tværs af distribuerede noder skaber koordineringsoverhead, som vokser med skalaen. De fleste hyperscalere migrerer til sidst fra distribueret filelagring til distribueret objektlagring for primære data, når volumenerne bliver store nok.
CAP theorem: Den uundgåelige afvejning i distribueret lagring
CAP theorem siger, at et distribueret datasystem kun kan garantere to af tre ting samtidigt: Konsistens (enhver læsning returnerer den seneste skrivning), Tilgængelighed (enhver forespørgsel får et svar) og Partitionstolerance (systemet kører videre gennem netværksdelinger). Netværk deles – partitionstolerance er ikke valgfri. Den reelle beslutning står altid mellem konsistens og tilgængelighed, når en fejl rammer.
[Eric Brewer introducerede CAP i 2000; Gilbert og Lynch formaliserede beviset i 2002][https://www.scylladb.com/glossary/cap-theorem/]. Det er stadig den beslutning, der former alt andet i arkitekturen for distribueret lagring, fordi den afgør, hvordan systemet opfører sig præcis dér, hvor du mest har brug for det – når noget allerede er gået i stykker.
| System | CAP-type | Adfærd under partition | Bedst til |
|---|---|---|---|
| MongoDB | CP (med majoritetslæse-/skrivekonfiguration) | Afviser forespørgsler, indtil konsistens er genoprettet | Finansielle poster, lager, booking |
| HBase | CP | Returnerer fejl i stedet for forældede data | Strukturerede analyser, konsistente batchjobs |
| Apache Cassandra | AP | Forbliver tilgængelig; kan levere forældede læsninger | Sociale feeds, beskeder, IoT-telemetri |
| DynamoDB (standard) | AP | Svarer altid; udligner inkonsistens asynkront | Forbrugerapps med høj gennemstrømning |
| CockroachDB | CP | Konsistens først, distribueret SQL | Globale transaktionsarbejdsbyrder |
Den praktiske beslutning: Kan din arbejdsbyrde tåle en forældet læsning? En bankssaldo, en pladsreservation, en lageropgørelse – sandsynligvis ikke. Vælg CP. Et socialt feed, en sensorhændelsesstrøm, analysetelemetri – nogle sekunders forældede data er fint. Vælg AP og behold garantien for tilgængelighed.
Sikkerhed i distribueret lagring: kryptering og datasuverænitet
Sikkerhed i distribueret lagring har tre lag: data i hvile, data under transport og ejerskab af nøgler. Hvis du fejler på ét af dem, redder de andre ikke situationen. Infrastrukturen kan være helt oppe at køre, mens følsomme data stille og roligt er tilgængelige for de forkerte personer.
Kryptering skal dække alle tre lag. Data i hvile bruger typisk AES-256, enten med nøgler, som udbyderen administrerer, eller med kundestyrede nøgler (CMK). Udbyderstyrede nøgler er nemmere at drive i praksis, men lagerleverandøren har så selv nøglematerialet. Det er en kritisk sikkerhedsovervejelse for regulerede brancher, der skal igennem revisioner. Klientsidekryptering fjerner den risiko helt. Data krypteres, før de forlader klienten, så udbyderen aldrig ser klartekst, uanset hvilke juridiske anmodninger der dukker op. Til data under transport er TLS 1.3 minimumskravet. Systemer, der stadig tillader TLS 1.2, kræver en dokumenteret undtagelse under de fleste aktuelle compliance-rammer.
Datasuverænitet overrasker ofte teams. Data er underlagt lovgivningen dér, hvor de fysisk ligger, ikke i virksomhedens land og heller ikke dér, hvor brugeren befinder sig. Schweiz har adequacy-status efter GDPR artikel 45, så dataoverførsler fra EU til Schweiz kan ske uden ekstra kontraktlige garantier. Den reviderede schweiziske databeskyttelseslov (nFADP) bringer de schweiziske regler i overensstemmelse med GDPR. Det betyder, at schweizisk infrastruktur giver ensartet regulatorisk dækning under begge rammer samtidig.
Der er én ting, man let udskyder, men ikke bør: De kryptografiske algoritmer, der i dag beskytter det meste lagringsinfrastruktur, er ikke designet til at modstå en kraftig kvantecomputer. NIST godkendte tre standarder for post-kvantekryptografi i august 2024, herunder FIPS 203 (ML-KEM). Hvis din distribuerede datalagring rummer data med lang opbevaringstid, fx medicinske arkiver, finansielle optegnelser eller juridiske dokumenter, er trusselsmodellen „harvest now, decrypt later“ allerede aktiv. Evalueringen bør derfor starte længe før arkiverne når modenhed.
Vigtigste fordele ved distribueret lagring
- Fejltolerance uden driftsafbrydelse: Hvis en node fejler, registrerer heartbeat-overvågningen det, og trafikken sendes automatisk videre til de replikaer, der stadig kører. Der kræves ingen manuel indgriben og intet vedligeholdelsesvindue.
- Horisontal skalerbarhed: Ny lagerkapacitet kommer fra at tilføje noder til klyngen. Data fordeles igen i baggrunden uden at påvirke live-trafik eller kræve nedetid.
- Geografisk fordeling: Replikering på tværs af regioner reducerer latens for geografisk spredte brugere. Samtidig gør det overholdelse af krav til datalokation til en konfigurationsbeslutning i stedet for et infrastrukturprojekt.
- Parallel I/O-gennemstrømning: Flere noder håndterer læsninger og skrivninger samtidig. Det er den eneste skalerbare arkitektur til AI/ML-træningspipelines, videotranscoding og mediestreaming i reelle produktionsvolumener.
- Ingen leverandørlåsning med åbne protokoller: S3-kompatible API'er, NFS og open source-platforme som Ceph gør det muligt at flytte mellem udbydere eller køre infrastrukturen on-premises uden at omskrive applikationskoden.
- Omkostningseffektivitet i stor skala: Standardhardware erstatter dyre proprietære lagringsarrays. Erasure coding reducerer desuden det rå kapacitetsbehov med op til 50 % sammenlignet med fuld replikering på tværs af noder.
Begrænsninger og udfordringer ved distribueret lagring
- Kompleks konsistens: At holde en ensartet tilstand på tværs af noder kræver omhyggelig justering af konsistensmodeller, replikeringsfaktorer og quorum-indstillinger. En fejlkonfiguration larmer ikke. Den får blot data til stille og roligt at glide fra hinanden.
- Driftsbyrde: Med en distribueret lagringsklynge skal du selv planlægge fejldomæner, udskiftning af noder, overvågning og performancejustering. En enkelt server kræver ikke alt det af dig.
- Netværksafhængighed: Hele arkitekturen forudsætter pålidelig forbindelse med høj båndbredde mellem noderne. Forringet netværk slår direkte og proportionalt igennem som højere lagerlatens og tabt gennemstrømning.
- Latens ved små, tilfældige I/O-operationer: Distribueret lagring er optimeret til store sekventielle læsninger og parallel gennemstrømning. Arbejdsbelastninger med mange små, tilfældige I/O-operationer, især OLTP-databaser, klarer sig ofte bedre på lokalt tilsluttet NVMe-blokslager.
- Minimum for en fornuftig skala: Fordelene ved omkostninger og kompleksitet viser sig ikke i en klynge med to noder. Under en vis grænse er en administreret cloud-lagringstjeneste eller en velkonfigureret enkelt server simpelthen billigere og nemmere at drive.
Brugsscenarier for distribueret lagring i praksis
- Medier og streaming: Netflix og YouTube leverer ikke video fra ét centralt sted. De distribuerer kodet indhold på tværs af objektlagringsklynger, placeret geografisk tæt på seerne. Et enkelt datacenter kan ikke håndtere samtidige globale streams i stor skala, og båndbreddeomkostningerne alene ville være uoverkommelige. Distribueret datalagring er det, der får økonomien i streaming til at fungere.
- Sundhed: Ét MR-studie genererer 500 MB til 1 GB billeddata. Gang det op på tværs af et stort hospitalsnetværk med forskellige modaliteter, lange opbevaringskrav og flere lokationer, og du står med petabytes, der hober sig op hurtigt. Skalerbar distribueret lagring med geografisk redundans er den måde, sundhedssystemer sikrer HIPAA-kompatibel adgang til patientjournaler, også når et regionalt datacenter går ned.
- AI og maskinlæring: Træning af en stor sprogmodel betyder, at GPU-klynger skal mades med terabytes til petabytes af data, læst i ikke-sekventielle mønstre, som hurtigt ville overbelaste et traditionelt lagringssystem. Ceph, HDFS og S3-kompatible objektlagre er blevet standardinfrastrukturen for ML-pipelines, fordi deres parallelle læsegennemstrømning faktisk matcher det, GPU-klyngerne bruger.
- Backup og katastrofeberedskab: Reel katastrofeberedskab betyder, at data findes på mindst to geografisk adskilte lokationer med uafhængige fejldomæner, ikke to rack i samme bygning. Replikeringspolitikker og placeringsregler, der er bygget direkte ind i det distribuerede lagringslag, definerer RPO og RTO på infrastrukturniveau, uden at du har brug for en separat backupsoftware. Færre bevægelige dele betyder også en mindre angrebsflade.
Distribueret vs. decentraliseret lagring: hvad er forskellen?
Distribueret lagring betyder, at data er spredt over mange noder, men én organisation stadig ejer og styrer det hele: politikker, adgangsrettigheder, sletning og auditlogs. Decentraliseret lagring fjerner den centrale autoritet helt. Data ligger spredt over uafhængige peers, og ingen enkelt operatør kan censurere, få adgang til eller slette dem på egen hånd.
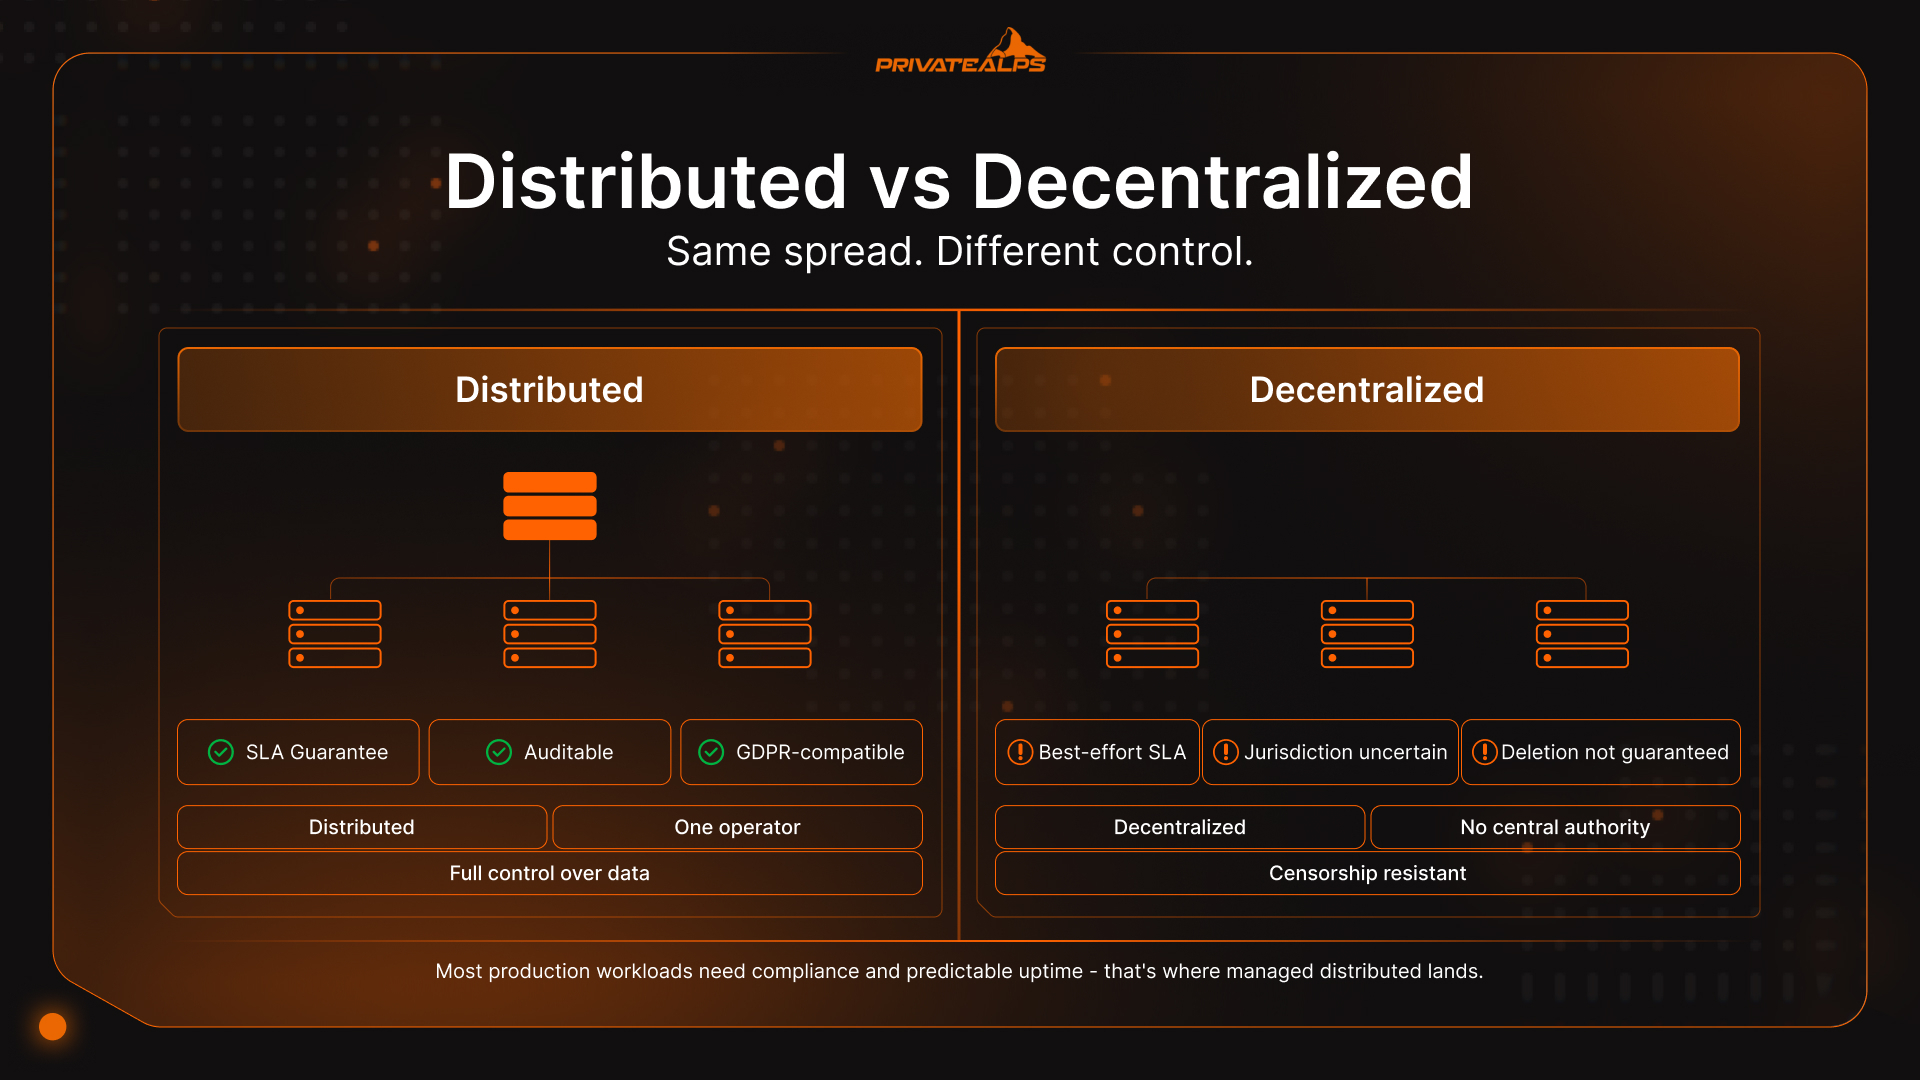
Forskellen har reelle driftsmæssige konsekvenser. Et centralt styret distribueret system kan revideres, patches, dækkes af SLA'er og bringes i overensstemmelse med regler. Et decentraliseret system bytter alt det for modstandsdygtighed over for censur og tillidsløs drift. Det er værdifuldt i bestemte sammenhænge, men det er ikke det, de fleste virksomheder, der kører produktionslagring, har brug for.
| Dimension | Distribueret lagring | Decentraliseret lagring |
|---|---|---|
| Kontrol | Centralt administreret | Ingen central autoritet |
| SLA / oppetidsgarantier | Kontraktlige garantier mulige | Best effort, protokolafhængig |
| Compliance | Reviderbar, GDPR-kompatibel | Jurisdiktion usikker |
| Datasletning | Garanteret | Ikke altid mulig |
| Adgangskontrol | Rollebaseret, administreret | Kryptografisk, tillidsløs |
| Eksempler | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Et lag mere er værd at skille ud: multi-region cloudlagring, fx AWS S3 med cross-region-replikering eller Azure geo-redundant storage, er stadig centralt administreret infrastruktur. Udbyderen styrer noderne og replikeringen, og du lejer i praksis geografi. Ægte distribuerede cloudplatforme som Storj eller Cubbit fordeler data på tværs af uafhængige operatører. Det fjerner leverandørlåsning, men rejser spørgsmål om SLA'er og auditspor igen. For de fleste arbejdsbelastninger, der kræver compliance-dokumentation og forudsigelig oppetid, er den administrerede distribuerede løsning det sted, man ender.
Opsummering
Distribueret lagring er ikke et produkt. Det er en arkitektonisk kategori, og den rigtige variant afhænger helt af, hvad du kører. Objekt-, blok- og fillagring har hver deres datamodel, bygget til forskellige adgangsmønstre og arbejdsbelastninger. CAP-teoremet tvinger et reelt valg mellem konsistens og tilgængelighed, så snart netværksfejl opstår. Og når det gælder replikering kontra erasure coding, afgør datatemperaturen valget. Varme data har brug for replikering for at opnå lav latens, mens kolde data drager fordel af erasure codings besparelser på lagerplads. For de fleste teams giver en administreret distribueret løsning, enten hos en privat udbyder eller i en offentlig cloud, så længe datalokation og sikkerhedskontroller kan verificeres, en bedre balance mellem skalerbarhed, performance og daglig driftsenkelhed end en selvhostet klynge.
Gem dine data i Schweiz – med PrivateAlps
Hvis din arbejdsbelastning har brug for S3-kompatibel distribueret objektlagring med verificerbar datalokation, kører PrivateAlps schweizisk baseret infrastruktur, der fuldt ud overholder både GDPR artikel 45 og nFADP. Dine data bliver i Schweiz. Ingen deling med tredjepart, ingen uklar routing gennem udenlandske jurisdiktioner og ingen overraskelser. Uanset om du flytter væk fra en hyperscaler eller bygger en privatlivsfokuseret distribueret lagringsarkitektur fra bunden, leverer PrivateAlps den performance og compliance-sikkerhed, din arbejdsbelastning faktisk kræver.
FAQ
Hvad er forskellen mellem distribueret lagring og cloudlagring?
Cloudlagring er en leveringsmodel. Nogen andre administrerer infrastrukturen, og du tilgår den over internettet efter betaling pr. brug. Distribueret lagring er en arkitektur, hvor data er spredt over flere noder for redundans og skalerbarhed. Det er uafhængige begreber. Du kan køre distribueret lagring helt on-premises med Ceph eller MinIO, og en cloududbyder kan teknisk set levere centraliseret lagring bag en API. De fleste cloudlagringstjenester bruger internt distribuerede arkitekturer, men det er en implementeringsdetalje og ikke definitionen af cloudlagring.
Hvad er det bedste distribuerede lagringssystem?
Der findes intet universelt svar. Det afhænger af arbejdsbelastningen og datamodellen. Til ustrukturerede data og backups er S3-kompatible objektlagre som MinIO eller Ceph RADOS standardvalget. Til databasevolumener og VM-diske, der kræver konsistent I/O med lav latens, er Ceph RBD eller Lightbits et bedre valg. Til delte filsystemer i HPC-miljøer eller ældre miljøer ender teams typisk med GlusterFS eller HDFS. Start med adgangsmønsteret. Lagringssystemet følger af det.
Er distribueret lagring det samme som RAID?
Nej. RAID fungerer inden for én enkelt server eller ét lagringsarray og beskytter mod diskfejl inde i én maskine. Distribueret lagring fungerer på tværs af separate fysiske noder forbundet over et netværk, og det kan strække sig over flere bygninger eller hele datacentre. RAID hjælper ikke, når selve serveren fejler. Distribuerede lagringssystemer er specifikt designet til at tåle nodefejl, rackfejl og fulde datacenter-nedbrud. Forskellen i omfang er fundamental.
Hvordan håndterer distribueret lagring nodefejl?
Noderne sender regelmæssigt heartbeat-signaler til klyngens metadatalag. Når en node holder op med at svare, registrerer systemet fejlen, typisk inden for få sekunder, og sender forespørgsler videre til de noder, der har replikaerne eller erasure-coded fragmenterne. I replikeringsbaserede opsætninger starter en baggrundsgenopretning derefter nye kopier for at genoprette den konfigurerede replikeringsfaktor på tværs af klyngen. Det hele er automatisk. I en veloptimeret distribueret lagringsklynge opdager applikationerne slet ikke fejlen.
Er distribueret lagring egnet til små virksomheder?
Administrerede distribuerede lagringstjenester, fx S3-kompatibel objektlagring fra en cloududbyder eller en specialist som PrivateAlps, fungerer i enhver skala uden krav om en minimumsklynge. Selvhostede distribuerede lagringsklynger er en anden historie. At køre Ceph i produktion kræver typisk mindst tre til fem noder, før driftsbyrden begynder at kunne retfærdiggøres. For små teams giver administrerede tjenester de fulde arkitektoniske fordele ved distribueret lagring uden byrden ved at administrere infrastrukturen selv.\\
