


Ano ang Distributed Storage?
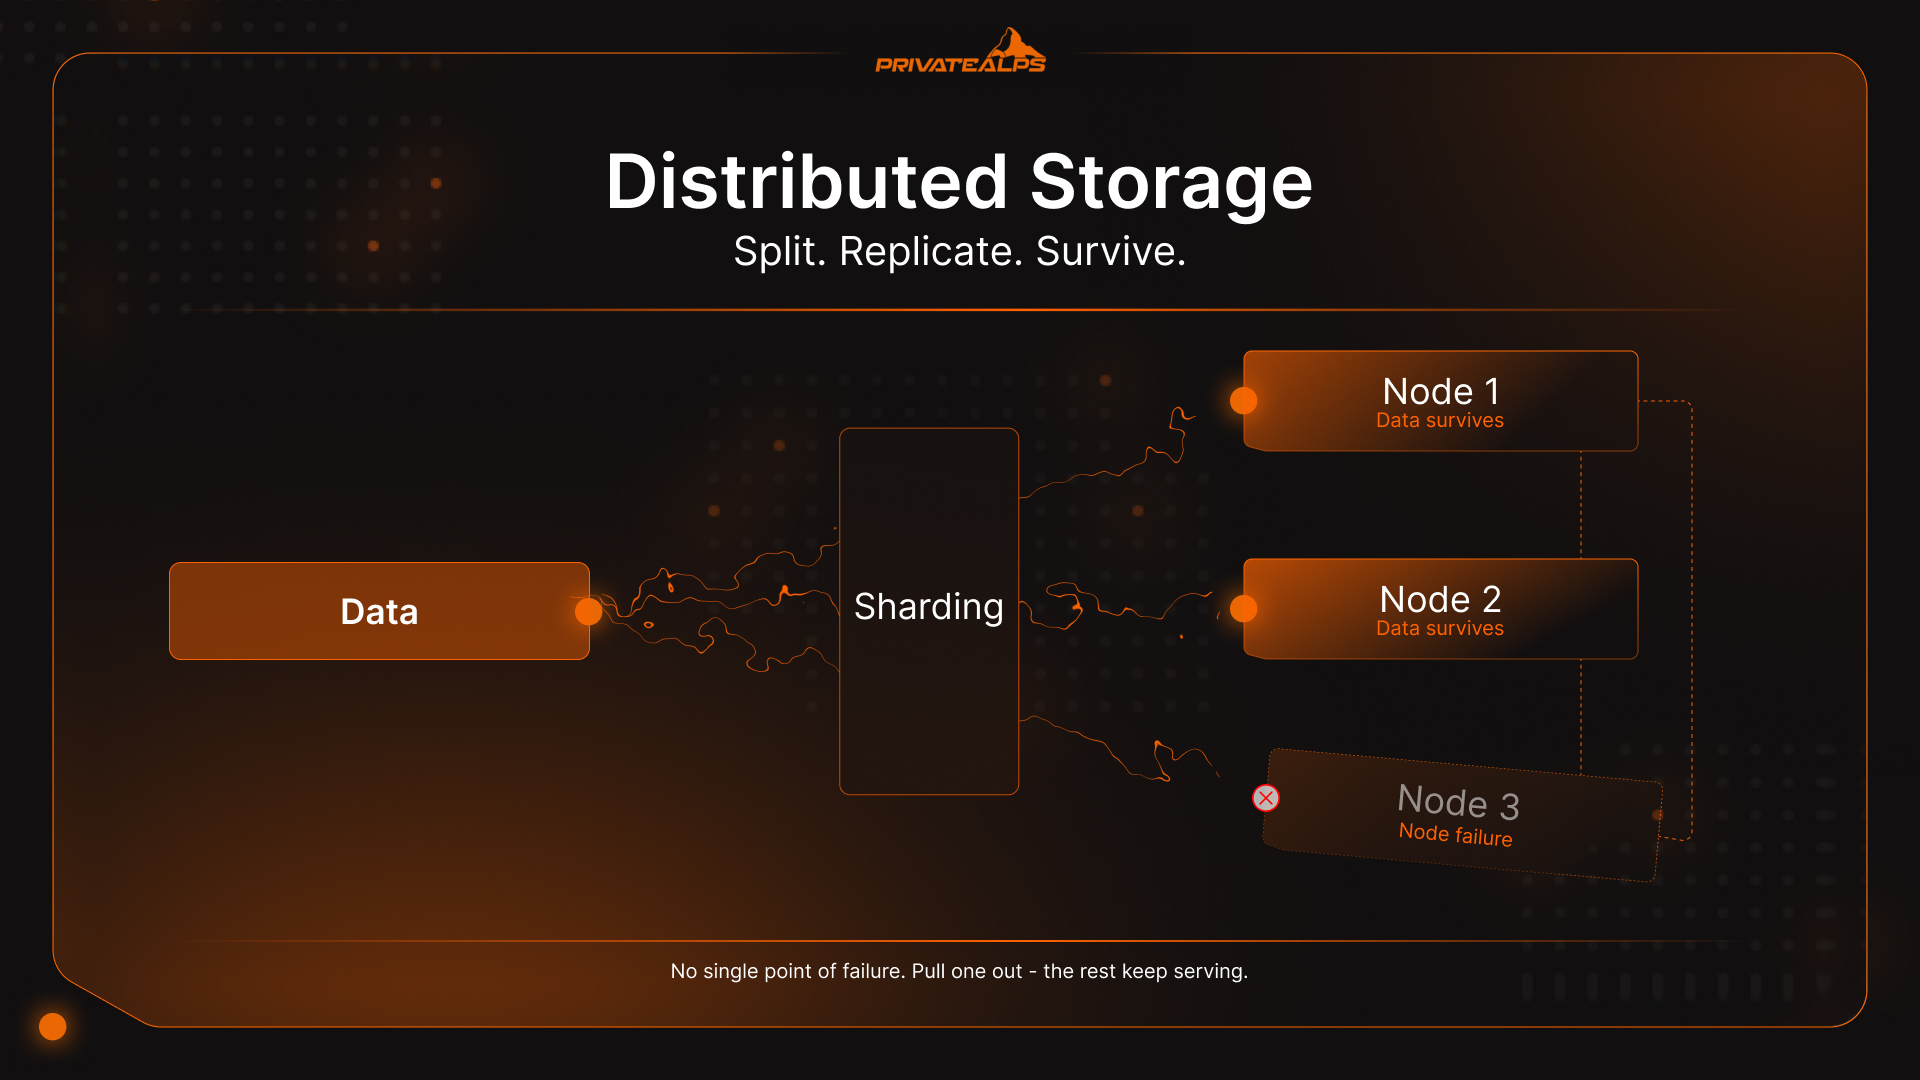
Ang distributed storage ang paraan ng modernong infrastructure para hawakan ang data na sobrang laki, sobrang kritikal, o sobrang dami ng access para mapanatili nang maaasahan ng iisang machine. Sa halip na isulat ang lahat sa iisang server, hinahati, kinokopya, o kinocode ng system ang data sa maraming independent node: servers, drives, data centers. Sabay-sabay silang gumagana, pero walang iisang node na may hawak ng lahat. Kapag may isang tinanggal, patuloy pa rin ang serbisyo ng iba. Tinatalakay ng gabay na ito kung paano talaga umaandar ang mga distributed storage system sa ilalim ng load, anong mga architectural trade-off ang kailangan nilang tanggapin, at aling uri ng storage ang bagay sa anong workload.
AI Summary
Ang distributed storage ay isang software-defined architecture na naghahati ng data sa maraming pisikal na node gamit ang tatlong pangunahing teknik: sharding (paghahati ng data sa magkakahiwalay na chunk na ipinapadala sa iba't ibang node), replication (pagpapanatili ng maraming magkakaparehong kopya sa iba't ibang node para sa mabilis na access), at erasure coding (pag-encode ng data sa mga fragment na may mathematical parity, kaya kayang buuin muli ang buong data mula sa anumang bahagi nito).
May tatlong pangunahing uri ng distributed storage system: object storage (flat namespace, S3-compatible API), block storage (fixed-size volumes para sa low-latency random I/O), at file storage (hierarchical namespace sa pamamagitan ng NFS o SMB). Bawat distributed data storage setup ay humaharap sa CAP theorem: dalawa lang sa consistency, availability, at partition tolerance ang kayang garantiyahan nang sabay.
Ang pangunahing bentahe sa operasyon ay hindi nagdudulot ng outage ang pagkabigo ng node; awtomatikong ire-redirect ng system ang mga request sa mga natitirang replica. Ang laki ng nakataya: ang sangkatauhan ay gumagawa ng mahigit 400 milyong terabytes ng bagong data bawat araw. Ito ay volume na hindi kayang sipsipin ng anumang centralized architecture nang hindi unti-unting bumibigay sa sarili nitong bigat.
Distributed Storage vs. Centralized Storage
Inilalagay ng centralized storage ang lahat sa iisang lugar: isang server, isang SAN, isang data center. Ganoon lang kasimple ang buong modelo. Kapag may problema ang lugar na iyon, tumitigil ang lahat. Direktang tinutugunan ito ng distributed storage: nakakalat ang data sa maraming independent node, kaya walang iisang failure point na makapagpapatigil sa buong system o makapagbabara sa lahat ng access.
Isang hardware failure at tumitigil ang access. Ganoon kasimple. Ang pag-scale ay nangangahulugang pag-upgrade o pagpapalit ng primary system, na kadalasang may kasamang downtime at usapin ng capital expenditure na walang gustong harapin. Iniiwasan ito ng distributed storage sa pamamagitan ng disenyo: magdagdag lang ng node para lumaki, at kapag may node na namatay, iikutan ito ng cluster. Walang gulo, walang outage. Nasa maraming node na ang data bago pa man may masira.
| Aspeto | Centralized Storage | Distributed Storage |
|---|---|---|
| Fault tolerance | Single point of failure | Nananatili ang data kahit mawala ang isang node |
| Scalability | Vertical (mag-upgrade ng hardware) | Horizontal (magdagdag ng node) |
| Latency | Mababa para sa local access | Nagbabago; nakadepende sa network topology |
| Gastos sa maliit na scale | Mas mababang upfront cost | Mas mataas na minimum na viable cluster |
| Gastos sa malaking scale | Mahal kapag nag-scale | Binabawasan ng commodity hardware ang gastos |
| Geographic distribution | Iisang lokasyon | Multi-region depende sa configuration |
| Operational complexity | Simpleng i-manage | Kailangan ng orchestration tooling |
Paano Gumagana ang Distributed Storage System
Kinukuha ng distributed storage system ang papasok na data, hinahati ito sa mga chunk, ipinapadala ang mga chunk sa tamang node sa buong cluster, at sinusubaybayan ang bawat piraso sa pamamagitan ng metadata layer. Sa ganitong paraan, mahahanap, makukuha, at mabubuo muli ang anumang fragment kapag kinailangan, anuman ang node na may hawak nito. Iyan ang pangunahing takbo. Apat na mekaniks ang nagpapagana nito:
- Sharding (Data Partitioning) Pagdating ng data, hinihiwa ito ng system sa mas maliliit na piraso (shards o blocks) at ikinakalat sa mga node. Dito nagiging posible ang parallel I/O: sabay-sabay na humahawak ng read at write ang maraming node, kaya lumalaki ang throughput kasabay ng laki ng cluster sa halip na maabot lang ang limitasyon ng iisang machine. Karaniwang consistent hashing ang routing logic, na nagpapanatiling pantay ang distribusyon habang lumalaki ang cluster nang hindi kinakailangang ayusin muli ang lahat sa tuwing may node na idinadagdag.
- Replication Simple ngunit epektibong paraan: mag-imbak ng N magkakaparehong kopya ng bawat shard sa magkakahiwalay na node, karaniwan ay tatlo. Kapag may isang node na nag-offline, patuloy na naglilingkod agad ang dalawa pa. Walang reconstruction, walang paghihintay. Ang replication ang tamang piliin para sa hot data, tulad ng mga aktibong database, real-time feed, at anumang bagay na talagang may halaga ang kahit isang dagdag na millisecond sa pagbasa.
- Erasure Coding Dito nagiging kawili-wili ang matematika ng storage efficiency. Sa halip na tatlong buong kopya, ico-encode ng system ang isang object sa $k$ data fragment at $m$ parity fragment, ipinamamahagi ang lahat ng $k+m$ sa mga node, at kaya nitong buuin muli ang buong object mula sa anumang $k$ sa mga ito. Ibig sabihin, puwedeng sabay na mamatay ang $m$ na node at walang mawawala. Ang RS(6,3) na configuration ng Reed-Solomon ay nag-iimbak ng 9 na block sa halip na 18 na kailangan ng 3x replication, kaya bumababa ang raw storage overhead mula 200% patungong humigit-kumulang 50%. Ang kapalit ay kumokonsumo ng CPU cycles ang encode/decode, at mas mainam ang erasure coding sa cold data, ibig sabihin, content na bihirang baguhin o i-access nang madalas. Para sa mga workload na madalas ang maliliit na write, mas panalo pa rin ang 3x replication pagdating sa latency.
| Paraan ng Proteksyon | Storage Overhead | Pinakabagay Para sa | Trade-Off |
|---|---|---|---|
| 3x Replication | 3x raw capacity | Hot data, low-latency na workload | Mataas na storage cost kapag malaki na ang scale |
| Erasure Coding RS(6,3) | 1.5x raw capacity | Cold data, archival, malalaking object | CPU overhead, mas mataas na rebuild latency |
- Metadata Routing Laging may metadata layer ang bawat distributed storage system, sa madaling salita, isang mapa kung aling shard ang nasa aling node. Kapag humingi ng data ang client, tutukuyin ng metadata service ang tamang mga node, at kukunin at bubuuin muli ng system ang mga fragment nang hindi nakikita ng client ang kumplikasyon. Sa malalaking cluster tulad ng Ceph o HDFS, nakakalat din sa mga node ang mismong metadata layer. Dapat ganoon. Ang iisang metadata server ay magiging bottleneck na pilit mong iniiwasan.
Mga Uri ng Distributed Storage System
Hindi iisa ang distributed storage. Isa itong kategorya na may tatlong magkakaibang data model sa ilalim, at ang pagpili ng maling uri para sa isang workload ay isang nakakagulat na karaniwan at magastos na pagkakamali. Bawat isa sa object, block, at file storage ay may sariling problemang nilulutas. Kasama ng mga ito ang distributed databases gaya ng Cassandra, CockroachDB, at Google Spanner bilang ikaapat na uri, dahil nagdaragdag sila ng query semantics sa ibabaw ng distributed data management, pero hiwalay na usapin iyon.
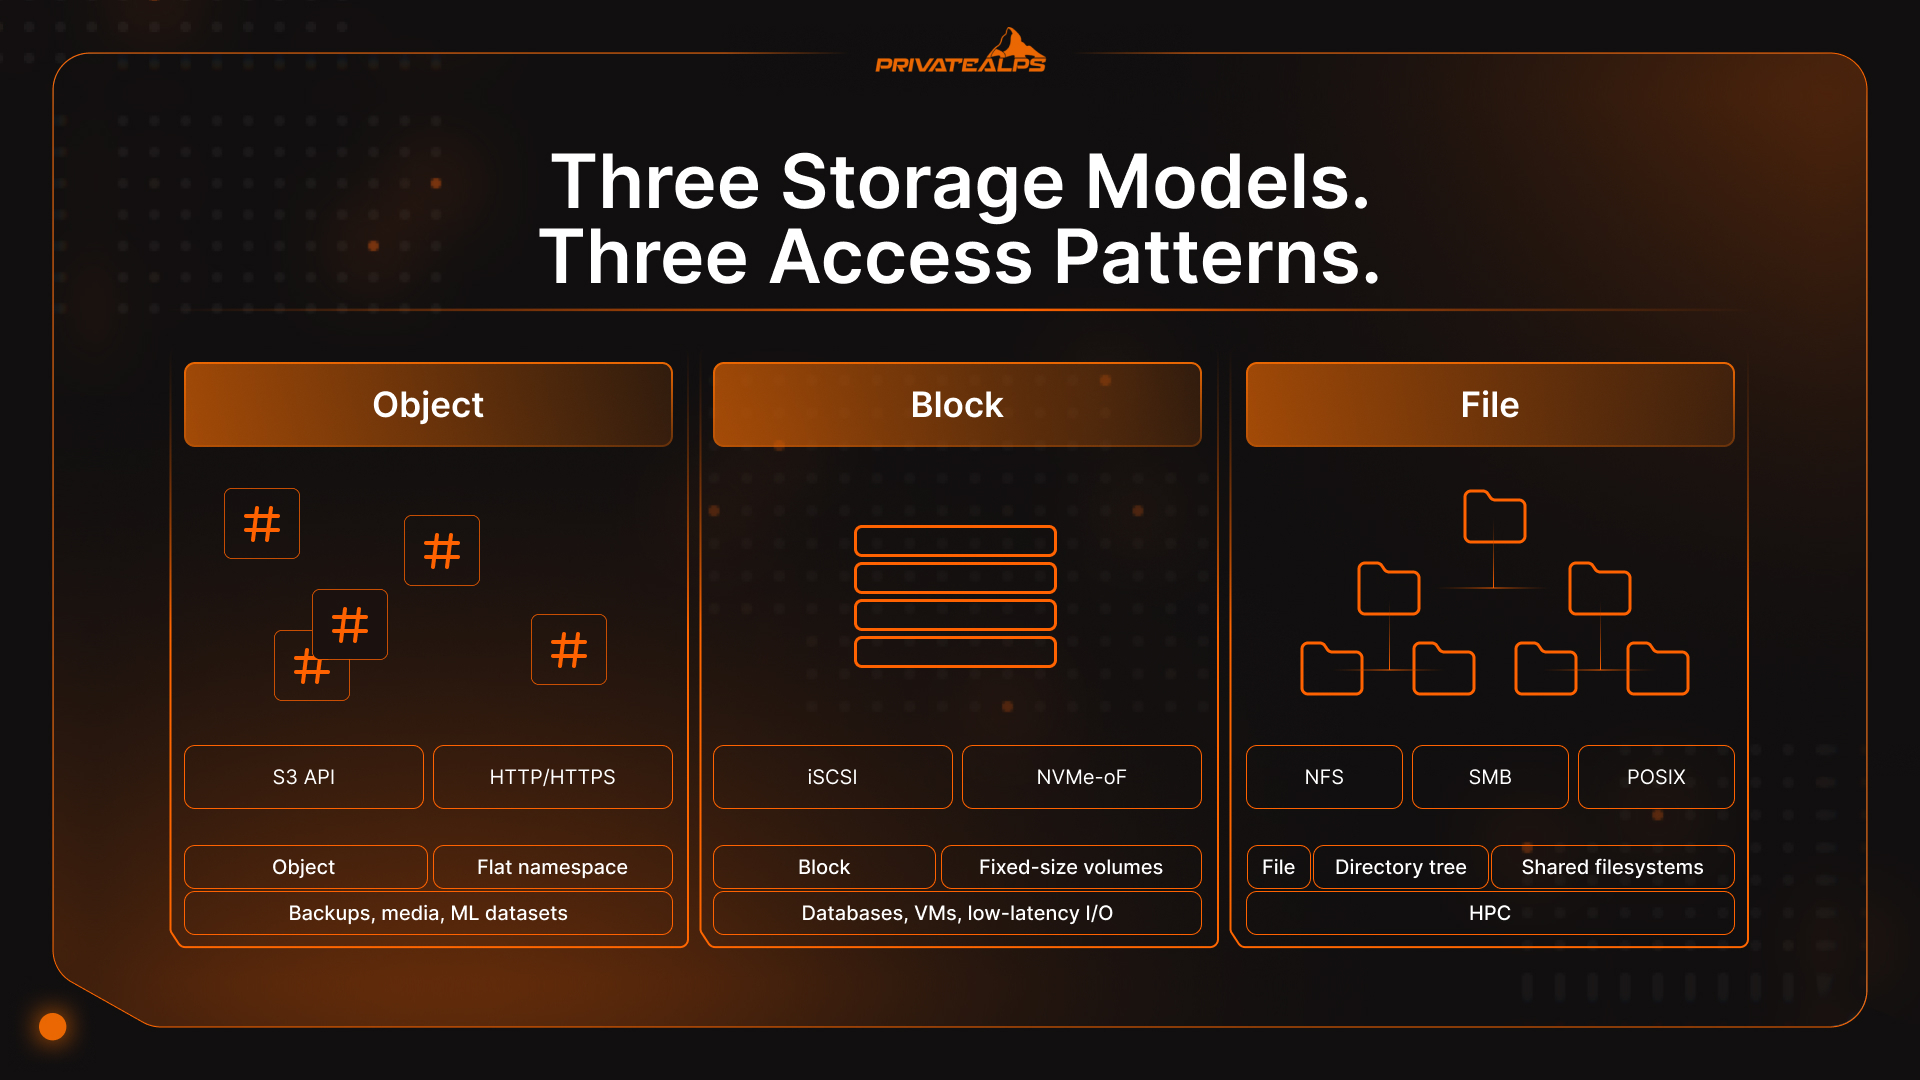
| Uri | Paano Iniimbak ang Data | Paraan ng Access | Pinakabagay Para sa | Mga Halimbawa |
|---|---|---|---|---|
| Object | Flat namespace, mga object na mayaman sa metadata | S3-compatible API (HTTP/HTTPS) | Unstructured data sa malaking scale: backups, media, ML datasets | AWS S3, MinIO, Ceph RADOS |
| Block | Raw volumes na fixed ang laki | iSCSI, NVMe-oF, FC | Databases, VMs, low-latency random I/O | Ceph RBD, AWS EBS, Lightbits |
| File | Hierarchical na directory tree | NFS, SMB, POSIX | Shared filesystems, HPC, home directories | GlusterFS, HDFS, Azure Files |
Distributed Object Storage
Inaayos ng distributed object storage ang data bilang magkakahiwalay na immutable na object sa isang flat namespace: walang directory, walang file path, walang hierarchy na kailangang panatilihin. Bawat object ay may natatanging identifier (hash o UUID) at mayamang metadata, at maaabot ito sa pamamagitan ng S3-compatible API sa ibabaw ng HTTP. Dahil pinapalitan ang object sa halip na bahagyang ina-update, nawawala na ang locking problem na naglilimita sa performance at scalability sa block at file systems. Ganito nagiging kayang mag-scale ng AWS S3, Azure Blob, at Ceph hanggang exabytes: walang overhead sa namespace coordination, walang lock contention, at kayang sagutin ng kahit anong node sa cluster ang anumang object request nang mag-isa.
Distributed Block Storage
Nagbibigay ang block storage ng raw volumes sa mga server: fixed-size na block na may natatanging address, walang filesystem abstraction sa ibabaw. Diretsong sumusulat ang mga application sa mga block, kaya nakukuha ang pare-pareho at low-latency random I/O para sa mga database, VM disk, at containerized workload. May isang limitasyon sa arkitektura na madalas nakakagulat: kadalasan, isang server lang ang puwedeng mag-mount ng block volume sa isang pagkakataon. Kailangan ng dagdag na orchestration para sa sabayang access ng maraming server, gaya ng cluster filesystem na nakapatong sa mga block device.
Distributed File Storage
Nagpapakita ang file storage ng shared filesystem sa pamamagitan ng karaniwang protocol gaya ng NFS, SMB, at POSIX-compatible access. Maraming client ang puwedeng mag-mount ng parehong volume nang sabay, kaya ito ang natural na pagpipilian para sa collaborative workload, HPC environment, at legacy application na umaasa sa directory tree at hindi pa rin nire-rewrite sa malapit na panahon. Ang totoong trade-off: ang pagpapanatili ng pare-parehong directory namespace sa mga distributed node ay lumilikha ng coordination overhead na lalong bumibigat habang lumalaki. Karamihan sa hyperscaler ay unti-unting lumilipat mula distributed file storage patungong distributed object storage para sa primary data kapag sapat na ang laki ng volume.
Ang CAP Theorem: Ang Hindi Maiiwasang Trade-Off sa Distributed Storage
Sinasabi ng CAP theorem na sa isang distributed data system, dalawa lang sa tatlong bagay ang kayang garantiyahan nang sabay: Consistency (lagi nang ibinabalik ng bawat read ang pinakabagong write), Availability (bawat request ay may sagot), at Partition Tolerance (patuloy na gumagana ang system kahit may network split). Nagkakaroon talaga ng network split, kaya hindi opsyonal ang partition tolerance. Ang tunay na desisyon ay palaging nasa pagitan ng consistency at availability kapag may nangyaring failure.
[Ipinakilala ni Eric Brewer ang CAP noong 2000; pormal na pinatunayan nina Gilbert at Lynch ang proof noong 2002][https://www.scylladb.com/glossary/cap-theorem/]. Ito pa rin ang desisyong humuhubog sa lahat ng iba pa sa distributed storage architecture, dahil tinutukoy nito kung paano kikilos ang system sa eksaktong sandaling pinakakailangan mo ito, iyon ay kapag may sira na.
| Sistema | CAP Type | Kilos Habang May Partition | Pinakabagay Para sa |
|---|---|---|---|
| MongoDB | CP (na may majority read/write concern) | Tinatanggihan ang mga request hanggang maibalik ang consistency | Financial records, inventory, booking |
| HBase | CP | Nagbabalik ng error sa halip na lumang data | Structured analytics, consistent batch jobs |
| Apache Cassandra | AP | Nananatiling available; maaaring magbigay ng lumang read | Social feeds, messaging, IoT telemetry |
| DynamoDB (default) | AP | Laging sumasagot; inaayos ang inconsistency nang asynchronous | High-throughput consumer apps |
| CockroachDB | CP | Consistency muna, distributed SQL | Global transactional workloads |
Ang praktikal na tanong: kaya bang tiisin ng workload mo ang isang stale read? Ang balanse ng bangko, reservation ng upuan, o bilang ng inventory, malamang hindi. Piliin ang CP. Ang social feed, sensor event stream, o analytics telemetry, ayos lang ang ilang segundong pagkaluma ng data. Piliin ang AP at panatilihin ang availability guarantee.
Seguridad ng Distributed Storage: Encryption at Data Sovereignty
Nakabatay ang seguridad sa distributed storage sa tatlong magkakahiwalay na layer: data at rest, data in transit, at key ownership. Kapag mali ang isa sa mga ito, hindi ka maililigtas ng iba. Puwedeng maayos at available ang infrastructure, pero tahimik na napapasok ng maling tao ang sensitibong data.
Kailangang sakupin ng encryption ang lahat ng tatlo. Karaniwang gumagamit ang data at rest ng AES-256, alinman sa provider-managed keys o customer-managed keys (CMK). Mas simple ang provider-managed sa operasyon, pero hawak ng storage vendor ang key material, at mahalagang security consideration ito para sa mga regulated industry na dumadaan sa audit. Ganap na inaalis ng client-side encryption ang exposure na ito. Naka-encrypt ang data bago ito umalis sa client, kaya hindi kailanman makikita ng provider ang plaintext, anuman ang legal request na dumating. Para sa data in transit, ang TLS 1.3 ang pinakamababang security standard. Ang anumang sistemang pumapayag pa sa TLS 1.2 ay nangangailangan ng dokumentadong exception sa karamihan ng kasalukuyang compliance framework.
Madalas mabigla ang mga team sa data sovereignty. Sakop ang data ng batas ng lugar kung saan ito pisikal na nakalagay, hindi ng bansa ng kumpanya o ng lokasyon ng user. May adequacy status ang Switzerland sa ilalim ng GDPR Article 45, kaya tuloy-tuloy ang paglipat ng data mula EU papuntang Switzerland nang walang karagdagang contractual safeguards. Inaayon ng binagong Federal Act on Data Protection (nFADP) ang lokal na patakaran ng Switzerland sa GDPR, kaya pareho at sabay na sakop ng Swiss infrastructure ang dalawang framework.
Isang bagay na madaling ipagpaliban pero hindi dapat: hindi idinisenyo para makaligtas sa isang kapable na quantum computer ang mga cryptographic algorithm na nagpoprotekta sa karamihan ng storage infrastructure ngayon. Inilabas ng NIST ang tatlong post-quantum cryptography standard noong Agosto 2024, kasama ang FIPS 203 (ML-KEM). Kung ang distributed data storage mo ay may mga rekord na kailangang itago nang matagal, tulad ng medical archive, financial record, o legal document, aktibo na ang threat model na "harvest now, decrypt later". Dapat magsimula ang evaluation nang mas maaga pa sa panahong umabot na sa maturity ang mga archive na ito.
Mga Pangunahing Bentahe ng Distributed Storage
- Fault tolerance nang walang service interruption: Kapag may node na pumalya, nade-detect ito ng heartbeat at awtomatikong nire-reroute ang trapiko sa mga natitirang replica. Walang manual na intervention at walang kailangang maintenance window.
- Horizontal scalability: Nagmumula ang bagong storage capacity sa pagdagdag ng node sa cluster. Kusang nag-rebalance ang data sa background nang hindi naaapektuhan ang live traffic at nang hindi kinakailangan ng downtime.
- Geographic distribution: Binabawasan ng replication sa iba't ibang rehiyon ang latency para sa mga user na magkakalayo ang lokasyon, at ginagawang configuration na lang ang data residency compliance sa halip na malaking infrastructure project.
- Parallel I/O throughput: Sabay-sabay na humahawak ng read at write ang maraming node. Ito lang ang architecture na sumasabay sa laki ng AI/ML training pipeline, video transcoding, o media streaming sa totoong production volume.
- Walang vendor lock-in sa mga open protocol: Nakakapagpalipat ng provider o nakakapagpatakbo ng infrastructure on-premises ang mga team gamit ang S3-compatible API, NFS, at mga open-source platform tulad ng Ceph, nang hindi kinakailangang isulat muli ang application code.
- Cost efficiency sa malakihang scale: Pinapalitan ng commodity hardware ang mamahaling proprietary storage array. Mas binabawasan pa ng erasure coding ang raw capacity na kailangan, hanggang 50%, kumpara sa full replication sa mga node.
Mga Limitasyon at Hamon ng Distributed Storage
- Kumplikadong consistency: Kailangang maingat na i-tune ang consistency model, replication factor, at quorum setting para manatiling consistent ang state sa pagitan ng mga node. Hindi agad nagpapakita ang maling configuration. Tahimik itong nagdudulot ng unti-unting pagkakaiba ng data.
- Operational overhead: Ang pagpapatakbo ng distributed storage cluster ay nangangahulugang ikaw ang gagawa ng failure domain planning, mga prosedurang pamalit ng node, monitoring pipeline, at performance tuning. Hindi ganito kalaki ang hinihingi sa iyo ng iisang server.
- Network dependency: Ipinapalagay ng buong architecture ang maaasahan at mataas na bandwidth na koneksyon sa pagitan ng mga node. Direkta at proporsyonal na nagiging mas mataas na storage latency at mas mababang throughput ang anumang pagbagsak ng network.
- Latency para sa maliliit at random na I/O: Ino-optimize ang distributed storage para sa malalaking sequential read at parallel throughput. Kadalasan mas maganda ang performance ng mga workload na maraming maliliit at random na I/O, lalo na ang OLTP databases, kapag nasa lokal na nakakabit na NVMe block storage.
- Pinakamaliit na praktikal na scale: Hindi lumalabas ang cost at complexity advantage ng distributed storage sa two-node cluster. Sa ilalim ng isang threshold, mas mura at mas madaling patakbuhin ang managed cloud storage service o isang maayos na na-tune na single server.
Mga Totoong Gamit ng Distributed Storage
- Media at Streaming: Hindi nagse-serve ng video mula sa iisang lokasyon ang Netflix at YouTube. Ipinapamahagi nila ang encoded content sa mga object storage cluster na nakalagay malapit sa mga manonood. Hindi kayang hawakan ng iisang data center ang sabay-sabay na global stream sa ganitong scale. Ang bandwidth cost pa lang ay sobrang mahal na. Ang distributed data storage ang nagpapatakbo nang kumikita sa negosyo ng streaming.
- Healthcare: Ang isang MRI study ay nakakalikha ng 500 MB hanggang 1 GB na imaging data. I-multiply iyan sa malaking hospital network, na may iba't ibang modality, mahabang retention requirement, at maraming site, at mabilis na mapupunta sa petabytes ang naiipon. Ang scalable distributed storage na may geographic redundancy ang paraan para mapanatili ng health system ang HIPAA-compliant na access sa patient record, kahit bumagsak ang isang regional data center.
- AI at Machine Learning: Ang pag-train ng malaking language model ay nangangahulugang pagpapakain sa GPU cluster ng terabytes hanggang petabytes na data, na binabasa nang hindi sunud-sunod. Mabilis nitong mapapagod ang tradisyonal na storage system. Naging standard na infrastructure layer para sa ML pipeline ang Ceph, HDFS, at S3-compatible object store, dahil ang parallel read throughput nila ay tumutugma sa dami ng data na kinokonsumo ng GPU cluster.
- Backup at Disaster Recovery: Ang totoong disaster recovery ay nangangahulugang may data sa hindi bababa sa dalawang magkahiwalay na lokasyon na may kanya-kanyang failure domain. Hindi sapat ang dalawang rack sa iisang gusali. Ang replication policy at placement rule na nakabuo mismo sa distributed storage layer ang nagtatakda ng RPO at RTO sa antas ng infrastructure, nang hindi kinakailangan ng hiwalay na backup software stack. Mas kaunting gumagalaw na bahagi ay nangangahulugan din ng mas maliit na attack surface.
Distributed Storage vs. Decentralized Storage: Ano ang Pagkakaiba?
Ibig sabihin ng distributed storage na nakakalat ang data sa maraming node, pero iisang organisasyon pa rin ang may-ari at kumokontrol sa kabuuan, kasama ang mga patakaran, access rights, kakayahang magbura, at audit log. Tinatanggal naman ng decentralized storage nang buo ang sentral na awtoridad. Nakakalat ang data sa mga independent peer, at walang iisang operator na puwedeng mag-censor, mag-access, o magbura nito nang mag-isa.
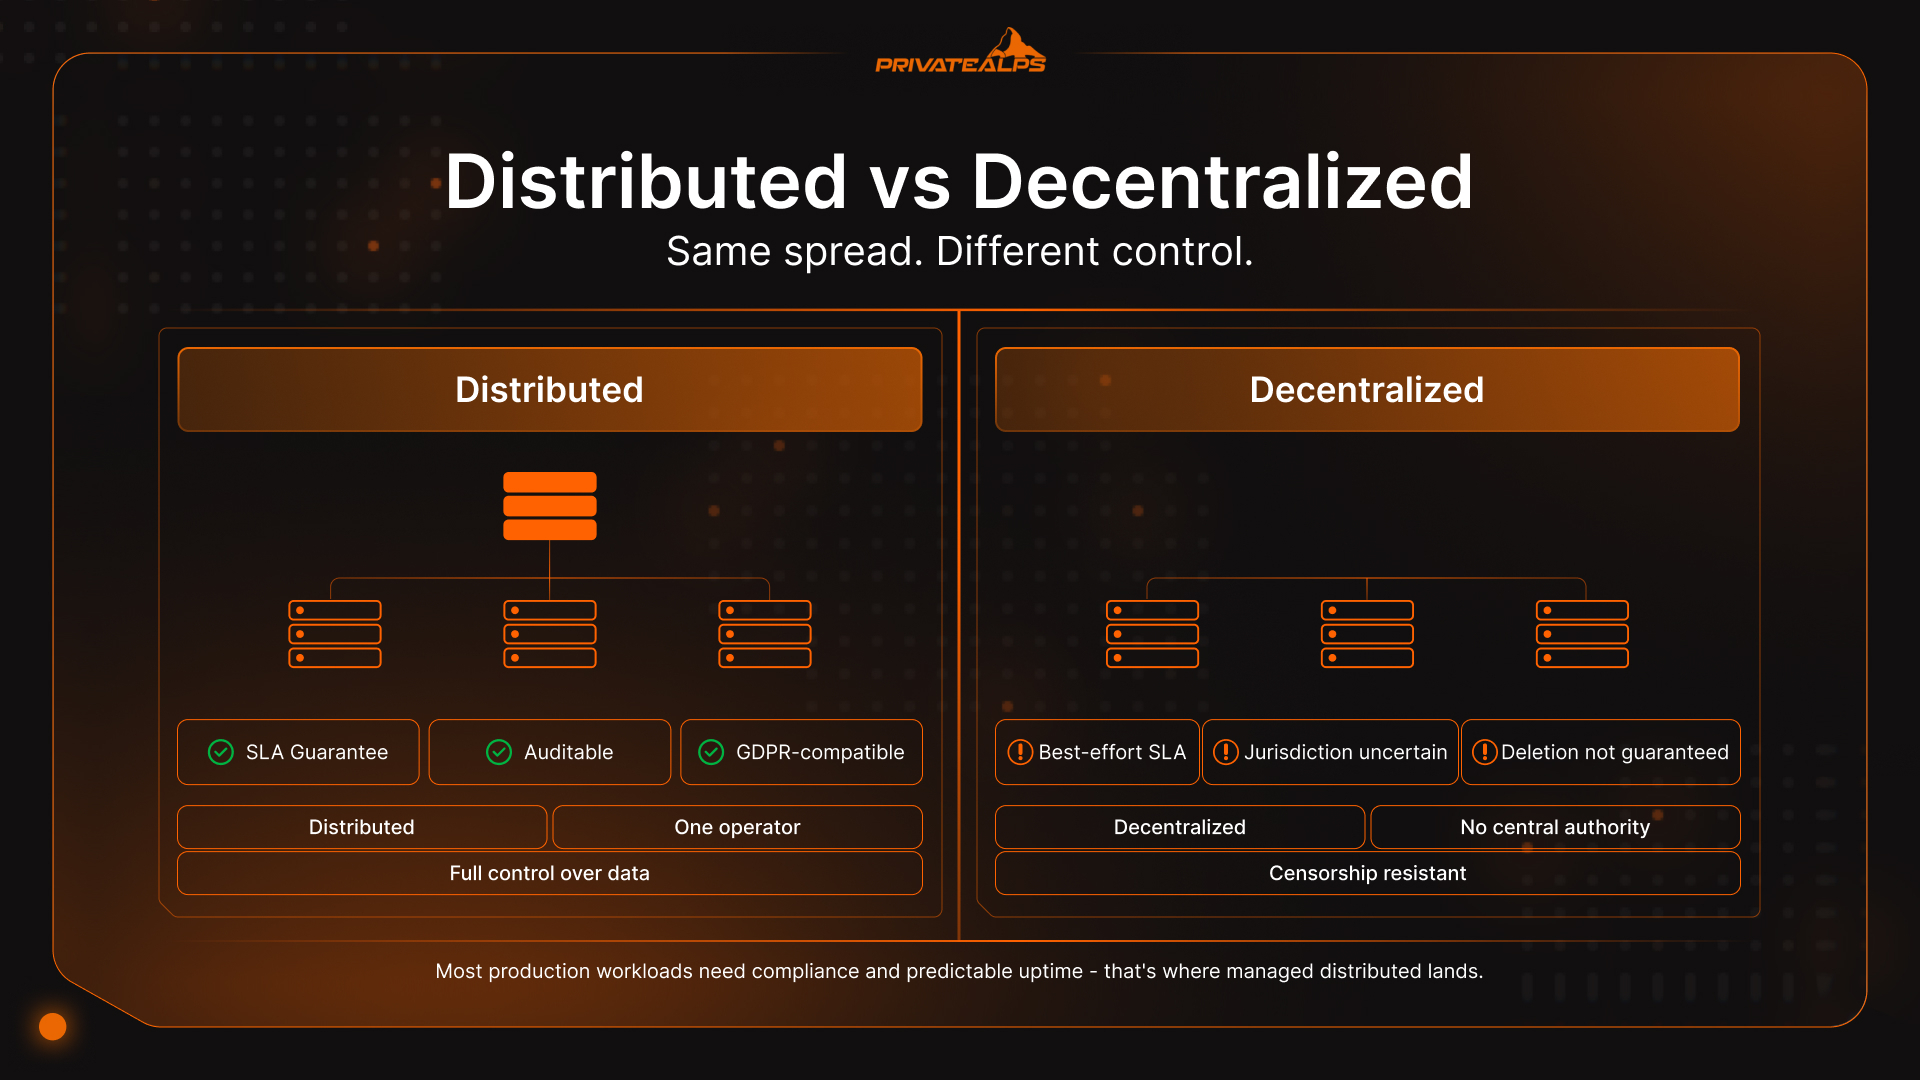
May totoong epekto sa operasyon ang pagkakaibang ito. Puwedeng i-audit, i-patch, bigyan ng SLA, at gawing sumusunod sa regulasyon ang centrally managed na distributed system. Ipinagpapalit naman ng decentralized system ang lahat ng iyon para sa censorship resistance at trustless operation. Mahalaga ito sa ilang partikular na konteksto, pero hindi ito ang kailangan ng karamihan sa mga negosyong nagpapatakbo ng production storage infrastructure.
| Dimension | Distributed Storage | Decentralized Storage |
|---|---|---|
| Control | Centrally administered | No central authority |
| SLA / uptime guarantees | Contractual guarantees possible | Best-effort, protocol-dependent |
| Compliance | Auditable, GDPR-compatible | Jurisdiction uncertain |
| Data deletion | Guaranteed | Not always possible |
| Access control | Role-based, managed | Cryptographic, trustless |
| Examples | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
May isa pang layer na sulit paghiwalayin: ang multi-region cloud storage, gaya ng AWS S3 na may cross-region replication at Azure geo-redundant storage, ay centrally administered pa rin. Ang provider ang namamahala sa mga node at replication. Sa madaling salita, nagre-rent ka lang ng heograpiya. Ang tunay na distributed cloud platform tulad ng Storj o Cubbit ay nagre-route ng data sa pamamagitan ng mga independent operator. Naaalis nito ang provider lock-in, pero muling bumabalik ang mga tanong tungkol sa SLA at audit trail. Para sa karamihan ng workload na nangangailangan ng compliance documentation at predictable uptime, ang managed distributed approach ang pinakamainam na pagpipilian.
Buod
Hindi product ang distributed storage. Architectural category ito, at nakadepende nang lubos sa kung ano ang pinapatakbo mo ang tamang uri. May kanya-kanyang data model ang object, block, at file storage na idinisenyo para sa magkakaibang access pattern at workload. Pinipilit ng CAP theorem na pumili nang totoo sa pagitan ng consistency at availability sa sandaling mangyari ang network failure. Mahal ang magiging kapalit kapag mali ang pagpiling ito. Pagdating sa replication kumpara sa erasure coding, nagpapasya ang "temperature" ng data. Kailangan ng hot data ang replication para sa latency, habang nakikinabang ang cold data sa storage efficiency ng erasure coding. Para sa karamihan ng team, mas magandang balanse ng scalability, performance, at pang-araw-araw na operational simplicity ang managed distributed solution, maging private provider man ito o public cloud, basta mabe-verify ang data residency at security control, kaysa sa self-hosted na cluster.
Itago ang Iyong Data sa Switzerland, kasama ang PrivateAlps
Kung kailangan ng workload mo ang S3-compatible distributed object storage na may mabe-verify na data residency, ang PrivateAlps ay nagpapatakbo ng infrastructure na nakabase sa Switzerland at ganap na sumusunod sa GDPR Article 45 at nFADP. Mananatili ang data mo sa Switzerland, walang third-party sharing, walang malabong routing sa mga foreign jurisdiction, at walang sorpresa. Lumilipat ka man mula sa hyperscaler o bumubuo ng privacy-first na distributed storage architecture mula sa simula, naghahatid ang PrivateAlps ng performance at compliance na kailangan talaga ng workload mo.
FAQ
Ano ang Pagkakaiba ng Distributed Storage at Cloud Storage?
Delivery model ang cloud storage. May ibang tao na namamahala ng infrastructure, at ina-access mo ito sa internet sa pay-per-use na batayan. Architecture naman ang distributed storage, kung saan nakakalat ang data sa maraming node para sa redundancy at scalability. Magkahiwalay na konsepto ang dalawa. Puwede kang magpatakbo ng distributed storage nang buo on-premises gamit ang Ceph o MinIO, at puwede ring mag-serve ang cloud provider ng centralized storage sa likod ng API. Karamihan sa cloud storage service ay gumagamit ng distributed architecture sa loob, pero implementation detail lang iyon at hindi ang mismong depinisyon ng cloud storage.
Ano ang Pinakamagandang Distributed Storage System?
Walang iisang sagot. Nakadepende ito sa workload at data model. Para sa unstructured data at backup, karaniwang pinipili ang S3-compatible object store gaya ng MinIO o Ceph RADOS. Para sa database volume at VM disk na nangangailangan ng consistent at low-latency block I/O, mas angkop ang Ceph RBD o Lightbits. Para sa shared filesystem sa HPC o mga legacy environment, kadalasang napupunta ang mga team sa GlusterFS o HDFS. Magsimula sa access pattern, at susunod na ang pipiliing storage system.
Pareho ba ang Distributed Storage sa RAID?
Hindi. Gumagana ang RAID sa loob ng iisang server o storage array, at pinoprotektahan nito ang data laban sa pagkasira ng disk sa loob ng isang makina. Gumagana naman ang distributed storage sa pagitan ng magkakahiwalay na pisikal na node na konektado sa network, at posibleng sumasaklaw sa maraming gusali o buong data center. Hindi nakakatulong ang RAID kapag ang mismong server ang pumalya. Idinisenyo ang distributed storage system para tiisin ang pagkabigo ng node, rack, at buong data center. Pundamental ang pagkakaiba sa saklaw nila.
Paano Hinahawakan ng Distributed Storage ang Pagkabigo ng Node?
Nagpapadala ang mga node ng regular na heartbeat signal sa metadata layer ng cluster. Kapag tumigil sa pagsagot ang isang node, nade-detect ito ng system, kadalasan sa loob lang ng ilang segundo. Pagkatapos, ire-reroute nito ang mga request sa mga node na may hawak na replica o erasure-coded fragment. Sa mga setup na nakabase sa replication, nagsisimula ang background recovery process ng mga bagong kopya para maibalik ang configured replication factor sa buong cluster. Awtomatiko ang buong prosesong ito. Sa maayos na naka-configure na distributed storage cluster, hindi man lang nakikita ng mga application ang pagkabigo.
Angkop ba ang Distributed Storage para sa Maliliit na Negosyo?\\
Gumagana ang managed distributed storage services, gaya ng S3-compatible object storage mula sa cloud provider o sa espesyalistang tulad ng PrivateAlps, sa anumang laki ng negosyo at walang minimum na cluster requirement. Iba ang kuwento ng self-hosted na distributed storage cluster. Ang productive na pagpapatakbo ng Ceph ay karaniwang nangangailangan ng hindi bababa sa tatlo hanggang limang node bago maging sulit ang operational overhead. Para sa maliliit na team, ibinibigay ng managed service ang buong architectural benefit ng distributed storage nang hindi binibigatan ng infrastructure management.
