


Wat is gedistribueerde opslag?
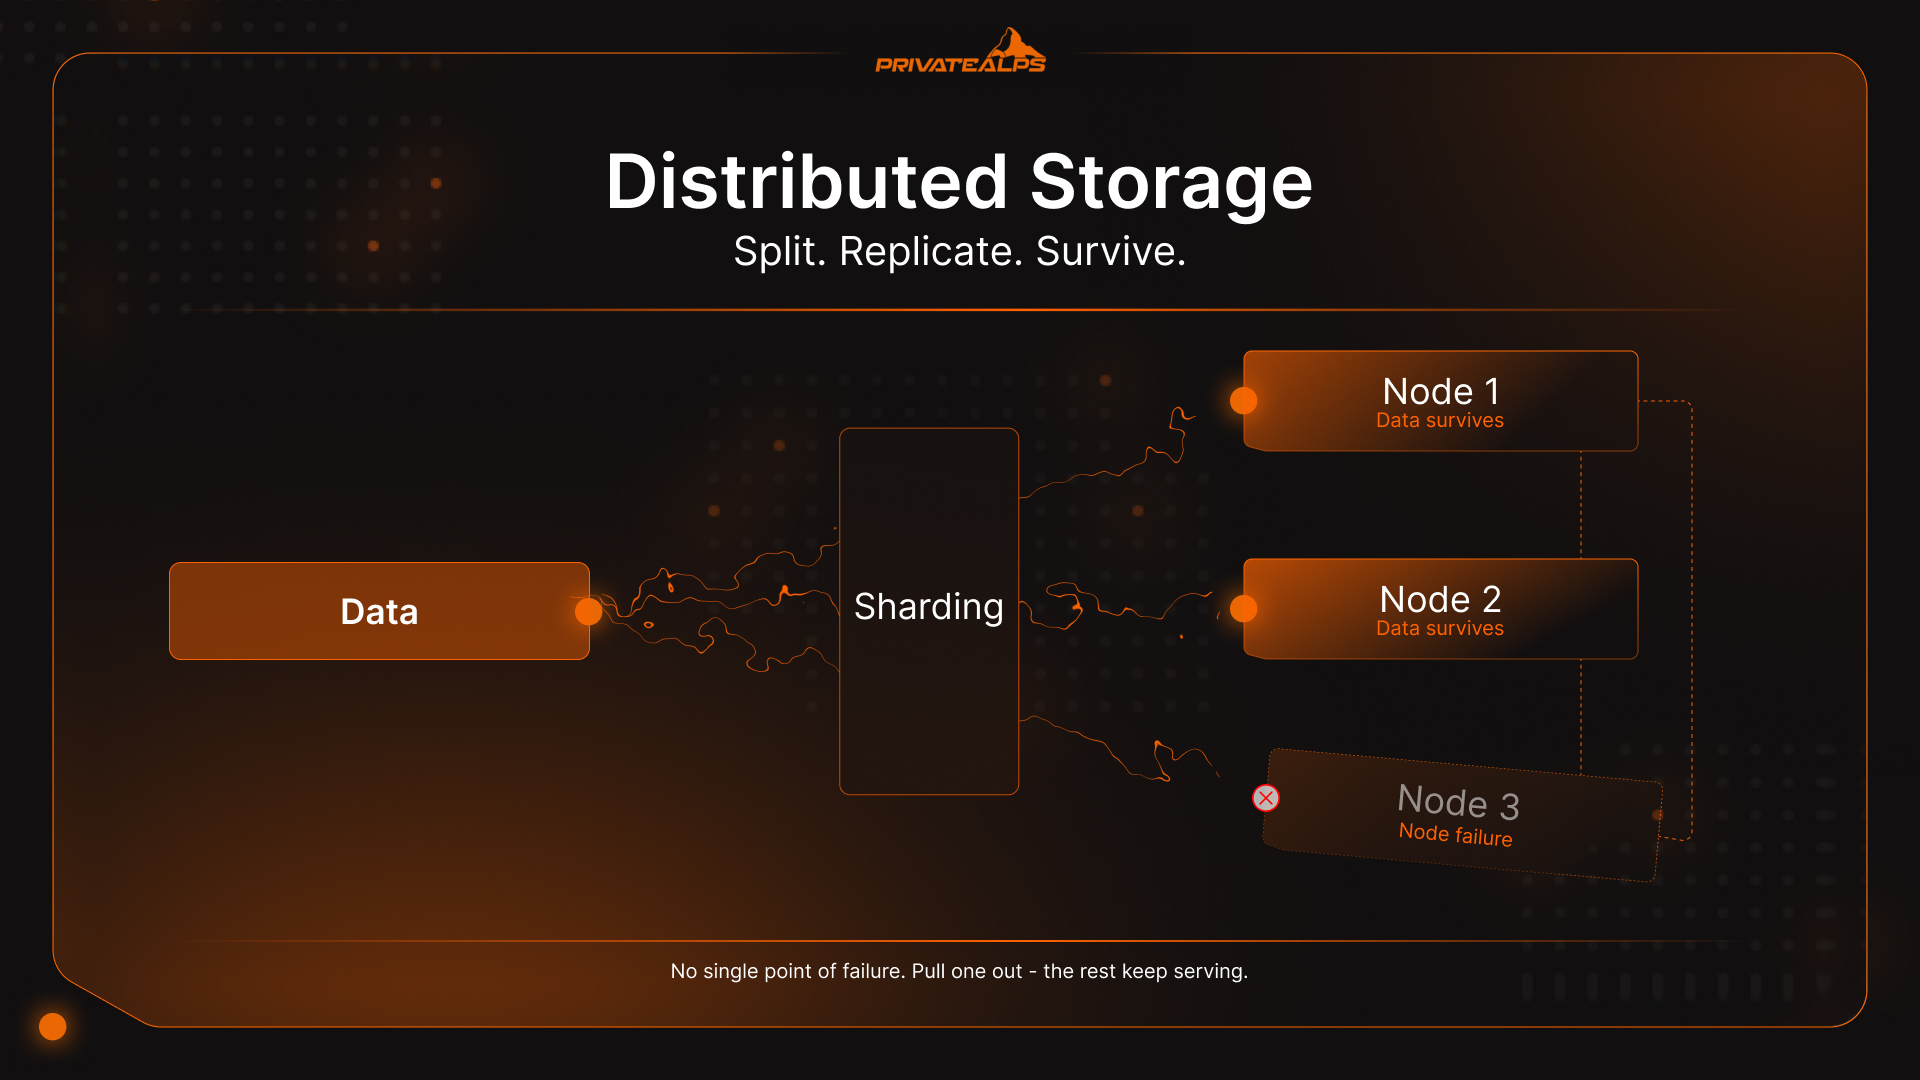
Gedistribueerde opslag is hoe moderne infrastructuur omgaat met data die simpelweg te groot, te kritiek of te zwaar belast is om betrouwbaar op één machine te bewaren. In plaats van alles naar één server te schrijven, splitst, repliceert of codeert het systeem die data over meerdere onafhankelijke nodes: servers, schijven, datacenters. Ze werken samen, maar geen enkele node bevat alles. Haal je er één uit, dan blijven de rest gewoon diensten leveren. In deze gids lees je hoe gedistribueerde opslagsystemen zich in de praktijk gedragen onder belasting, welke architectuurafwegingen ze met zich meebrengen en welk opslagtype bij welke workload past.
AI-samenvatting
Gedistribueerde opslag is een software-gedefinieerde architectuur die data verdeelt over meerdere fysieke nodes, met drie kerntechnieken: sharding (data opdelen in afzonderlijke stukken die naar verschillende nodes worden gestuurd), replicatie (meerdere identieke kopieën over nodes verspreiden voor snelle toegang) en erasure coding (data coderen in fragmenten met wiskundige pariteit, zodat elke voldoende grote subset het geheel kan reconstrueren).
Er bestaan drie hoofdtypen gedistribueerde opslagsystemen: objectopslag (platte namespace, S3-compatibele API), blockopslag (volumes met vaste grootte voor willekeurige I/O met lage latentie) en bestandsopslag (hiërarchische namespace via NFS of SMB). Elke gedistribueerde dataopslag loopt tegen het CAP-theorema aan: het kan slechts twee van consistentie, beschikbaarheid en partitietolerantie tegelijk garanderen.
Het grootste operationele voordeel is dat een uitval van een node geen storing veroorzaakt. Het systeem stuurt verzoeken automatisch door naar de overgebleven replica's. De schaal van wat op het spel staat: de mensheid genereert elke dag meer dan 400 miljoen terabyte aan nieuwe data. Geen enkele gecentraliseerde architectuur kan dat volume verwerken zonder uiteindelijk onder het eigen gewicht te bezwijken.
Gedistribueerde opslag vs. gecentraliseerde opslag
Gecentraliseerde opslag zet alles op één plek: één server, één SAN, één datacenter. Meer is het model niet. Als die plek problemen heeft, staat alles stil. Gedistribueerde opslag pakt dit direct aan: data staat verspreid over meerdere onafhankelijke nodes, dus geen enkel storingspunt kan het hele systeem offline halen of alle toegang blokkeren.
Eén hardwarefout en de toegang valt weg. Punt. Opschalen betekent het primaire systeem upgraden of vervangen, wat meestal downtime kost en een investeringsdiscussie waar niemand zin in heeft. Gedistribueerde opslag omzeilt beide problemen per ontwerp: voeg een node toe om te groeien, en als een node uitvalt, past het cluster zich eromheen aan. Geen gedoe, geen uitval. De data stond al op meerdere nodes voordat er iets misging.
| Dimensie | Gecentraliseerde opslag | Gedistribueerde opslag |
|---|---|---|
| Fouttolerantie | Enkel storingspunt | Data overleeft het verlies van een node |
| Schaalbaarheid | Verticaal (hardware upgraden) | Horizontaal (nodes toevoegen) |
| Latentie | Laag voor lokale toegang | Variabel; hangt af van de netwerktopologie |
| Kosten op kleine schaal | Lagere initiële kosten | Hogere minimale clustergrootte |
| Kosten op grote schaal | Duur om op te schalen | Standaardhardware verlaagt de kosten |
| Geografische spreiding | Eén locatie | Meerdere regio's via configuratie |
| Operationele complexiteit | Eenvoudig te beheren | Vereist orkestratietooling |
Hoe gedistribueerde opslagsystemen werken
Een gedistribueerd opslagsysteem neemt binnenkomende data, breekt die op in stukken, stuurt de stukken naar de juiste nodes in het cluster en houdt elk deel bij via een metadatalaag. Zo kan elk fragment worden gevonden, opgehaald en op verzoek weer samengevoegd, ongeacht welke node het bewaart. Dat is de basislus. Vier mechanismen maken dit mogelijk:
- Sharding (datapartitionering) Zodra data binnenkomt, snijdt het systeem die in kleinere stukken (shards of blokken) en verspreidt die over nodes. Daarmee ontstaat parallelle I/O: meerdere nodes verwerken tegelijk lees- en schrijfacties, waardoor de doorvoer meegroeit met de clustergrootte in plaats van vast te lopen op het plafond van één machine. De routeringslogica is meestal consistent hashing. Die houdt de verdeling gelijkmatig terwijl het cluster groeit, zonder dat alles opnieuw geschud wordt telkens als er een node bijkomt.
- Replicatie De botte maar effectieve aanpak: sla N identieke kopieën van elke shard op aparte nodes op, meestal drie. Valt één node uit, dan blijven de andere twee direct diensten leveren. Geen reconstructie, geen wachttijd. Replicatie is de juiste keuze voor hot data, zoals actieve databases, realtime feeds en alles waarbij een extra milliseconde bij het lezen echt geld kost.
- Erasure coding Hier wordt de rekenkunde van opslagefficiëntie interessant. In plaats van drie volledige kopieën codeert het systeem een object in $k$ datafragmenten plus $m$ pariteitsfragmenten, verspreidt alle $k+m$ fragmenten over nodes en kan het volledige object reconstrueren uit elke $k$ van die fragmenten. Zo kunnen er $m$ nodes tegelijk uitvallen zonder dat er data verloren gaat. Een Reed-Solomon RS(6,3)-configuratie slaat 9 blokken op in plaats van de 18 die 3x replicatie vereist, waardoor de ruwe opslagoverhead daalt van 200% naar ongeveer 50%. Het addertje: coderen en decoderen kost CPU-cycli, en erasure coding presteert beter op cold data, dat wil zeggen content die zelden wordt gewijzigd of met hoge frequentie wordt benaderd. Bij workloads met veel kleine schrijfacties wint 3x replicatie nog steeds op latentie.
| Beschermingsmethode | Opslagoverhead | Het best voor | Afweging |
|---|---|---|---|
| 3x replicatie | 3x ruwe capaciteit | Hot data, workloads met lage latentie | Hoge opslagkosten op schaal |
| Erasure coding RS(6,3) | 1,5x ruwe capaciteit | Cold data, archivering, grote objecten | CPU-overhead, hogere hersteltijd |
- Metadata-routering Elk gedistribueerd opslagsysteem houdt een metadatalaag bij: in feite een kaart van welke shard op welke node staat. Wanneer een client data opvraagt, bepaalt de metadataservice welke nodes de juiste zijn, en haalt het systeem de fragmenten op en voegt ze samen, zonder dat de client de complexiteit ooit ziet. In grootschalige clusters zoals Ceph of HDFS is de metadatalaag zelf over nodes verdeeld. Dat moet ook. Eén metadataserver wordt de bottleneck waar je juist van wilde af komen.
Typen gedistribueerde opslagsystemen
Gedistribueerde opslag is niet één ding. Het is een categorie met drie verschillende datamodellen eronder, en het kiezen van het verkeerde model voor een workload is een verrassend veelvoorkomende en dure fout. Object-, block- en bestandsopslag lossen elk een ander probleem op. Gedistribueerde databases, zoals Cassandra, CockroachDB en Google Spanner, vormen een vierde type. Die voegen queryfunctionaliteit toe bovenop gedistribueerd datamanagement, maar dat is een apart onderwerp.
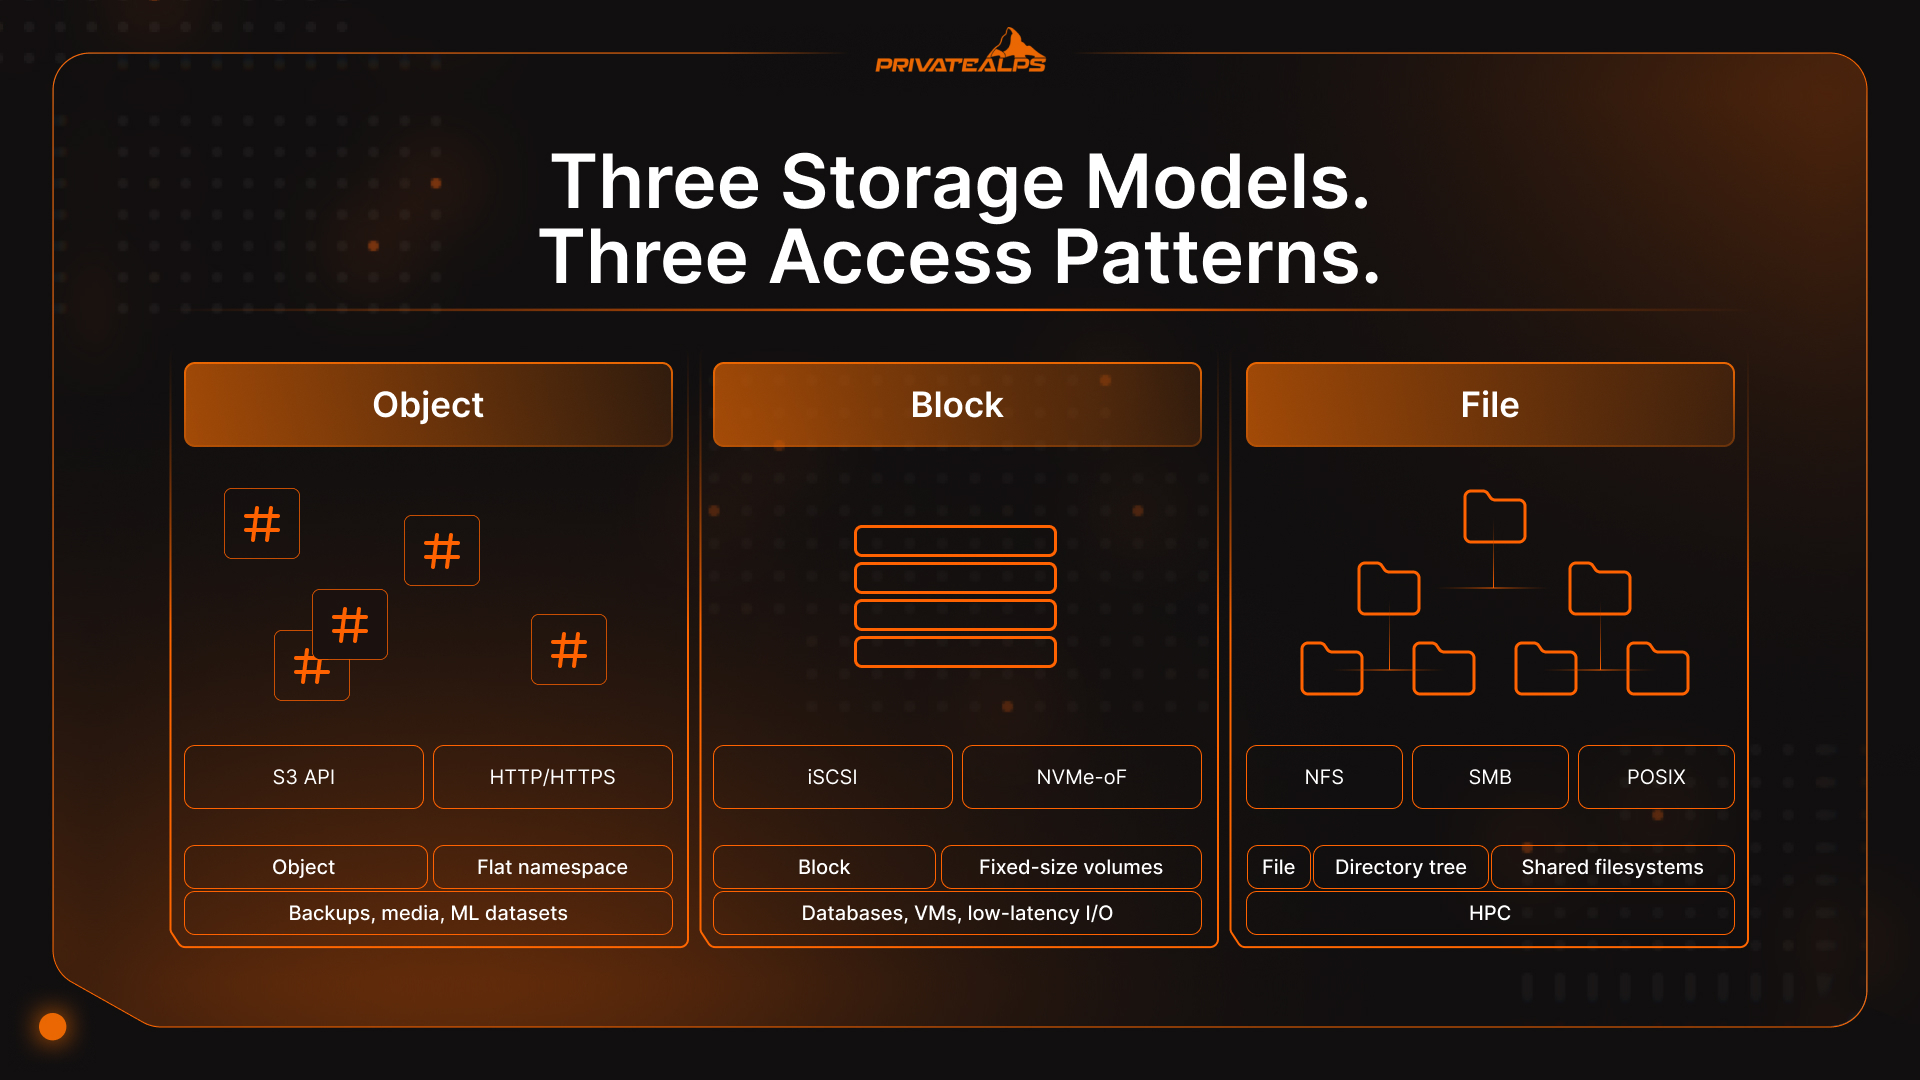
| Type | Hoe data wordt opgeslagen | Toegangsmethode | Het best voor | Voorbeelden |
|---|---|---|---|---|
| Object | Platte namespace, objecten rijk aan metadata | S3-compatibele API (HTTP/HTTPS) | Ongestructureerde data op schaal: backups, media, ML-datasets | AWS S3, MinIO, Ceph RADOS |
| Block | Ruwe volumes met vaste grootte | iSCSI, NVMe-oF, FC | Databases, VM's, willekeurige I/O met lage latentie | Ceph RBD, AWS EBS, Lightbits |
| File | Hiërarchische mappenstructuur | NFS, SMB, POSIX | Gedeelde bestandssystemen, HPC, homedirectories | GlusterFS, HDFS, Azure Files |
Gedistribueerde objectopslag
Gedistribueerde objectopslag organiseert data als afzonderlijke, onveranderlijke objecten in een platte namespace: geen mappen, geen bestandspaden, geen hiërarchie om bij te houden. Elk object krijgt een unieke identifier (een hash of UUID) plus rijke metadata, en je benadert het via een S3-compatibele API over HTTP. Omdat objecten worden vervangen in plaats van gedeeltelijk bijgewerkt, verdwijnt het lockprobleem dat in block- en bestandssystemen de prestaties beperkt en de schaalbaarheid afremt. Zo schalen AWS S3, Azure Blob en Ceph naar exabytes: geen coördinatie-overhead van de namespace, geen lockconflicten en elke node in het cluster kan elk objectverzoek zelfstandig afhandelen.
Gedistribueerde blockopslag
Blockopslag levert ruwe volumes aan servers: blokken met vaste grootte en unieke adressen, zonder bestandssysteemlaag erbovenop. Applicaties schrijven rechtstreeks naar blokken, en dat levert consistente willekeurige I/O met lage latentie op voor databases, VM-schijven en gecontaineriseerde workloads. Eén architectuurbeperking pakt mensen vaak onverwacht: een blockvolume kan normaal gesproken maar door één server tegelijk worden gemount. Gedeelde toegang door meerdere servers vereist extra orkestratie, zoals een clusterbestandssysteem bovenop de blockdevices.
Gedistribueerde bestandsopslag
Bestandsopslag biedt een gedeeld bestandssysteem via standaardprotocollen: NFS, SMB en POSIX-compatibele toegang. Meerdere clients kunnen tegelijk hetzelfde volume mounten, wat het een natuurlijke keuze maakt voor samenwerkingsworkloads, HPC-omgevingen en legacy-applicaties die een mappenstructuur verwachten en niet snel worden herschreven. De afweging in de praktijk: een consistente mappenstructuur over gedistribueerde nodes onderhouden levert coördinatie-overhead op die bij schaal toeneemt. De meeste hyperscalers migreren uiteindelijk van gedistribueerde bestandsopslag naar gedistribueerde objectopslag voor primaire data, zodra de volumes groot genoeg zijn.
Het CAP-theorema: de onvermijdelijke afweging in gedistribueerde opslag
Het CAP-theorema stelt dat een gedistribueerd datasysteem maar twee van drie dingen tegelijk kan garanderen: consistentie (elke read geeft de laatste write terug), beschikbaarheid (elk verzoek krijgt een antwoord) en partitietolerantie (het systeem blijft draaien bij netwerksplitsingen). Netwerken splitsen nu eenmaal, dus partitietolerantie is niet optioneel. De echte keuze is altijd tussen consistentie en beschikbaarheid wanneer er een storing optreedt.
[Eric Brewer introduceerde CAP in 2000; Gilbert en Lynch formaliseerden het bewijs in 2002][https://www.scylladb.com/glossary/cap-theorem/]. Het is nog steeds de beslissing die alles andere in gedistribueerde opslagarchitectuur bepaalt, omdat het bepaalt hoe het systeem zich gedraagt op precies het moment dat je het het meest nodig hebt: wanneer er al iets kapot is.
| Systeem | CAP-type | Gedrag tijdens een partitie | Het best voor |
|---|---|---|---|
| MongoDB | CP (met majority read/write concern) | Wijst verzoeken af totdat consistentie is hersteld | Financiële gegevens, voorraad, boekingen |
| HBase | CP | Geeft fouten terug in plaats van verouderde data | Gestructureerde analyses, consistente batchjobs |
| Apache Cassandra | AP | Blijft beschikbaar; kan verouderde reads teruggeven | Social feeds, berichtenverkeer, IoT-telemetrie |
| DynamoDB (standaard) | AP | Reageert altijd; corrigeert inconsistenties asynchroon | Consumentenapps met hoge doorvoer |
| CockroachDB | CP | Consistentie eerst, gedistribueerde SQL | Wereldwijde transactionele workloads |
De praktische vraag: kan je workload een verouderde read verdragen? Een banksaldo, een stoelreservering, een voorraadtelling: waarschijnlijk niet. Kies dan voor CP. Een social feed, een stream van sensorgegevens of analysetelemetrie: een paar seconden verouderde data is prima. Kies dan voor AP en behoud de garantie op beschikbaarheid.
Beveiliging van gedistribueerde opslag: encryptie en dataeigendom
Beveiliging van gedistribueerde opslag rust op drie lagen: data in rust, data in transit en sleutelbeheer. Als je één laag verkeerd inricht, helpen de andere twee je niet. De infrastructuur kan prima beschikbaar zijn terwijl gevoelige data stilletjes toegankelijk is voor de verkeerde mensen.
Encryptie moet alle drie de lagen dekken. Data in rust gebruikt meestal AES-256, met sleutels die door de provider worden beheerd of met customer-managed keys (CMK). Provider-managed sleutels zijn operationeel eenvoudiger, maar de opslagaanbieder heeft dan het sleutelmateriaal in handen. Voor sectoren met regelgeving en audits is dat een kritiek beveiligingspunt. Client-side encryptie neemt dat risico volledig weg: de data wordt versleuteld voordat die de client verlaat, dus de provider ziet nooit onversleutelde gegevens, wat voor juridische verzoeken ook gelden. Voor data in transit is TLS 1.3 het minimum. Wie nog TLS 1.2 toestaat, heeft volgens de meeste actuele compliancekaders een gedocumenteerde uitzondering nodig.
Datasoevereiniteit verrast teams vaak. Data valt onder de wetten van de plek waar die fysiek staat, niet onder het land van het bedrijf of de locatie van de gebruiker. Zwitserland heeft een adequaatheidsbesluit onder artikel 45 AVG, dus gegevensoverdracht van de EU naar Zwitserland kan zonder extra contractuele waarborgen. De herziene Federal Act on Data Protection (nFADP) brengt de Zwitserse binnenlandse regels in lijn met de AVG. Zwitserse infrastructuur biedt daardoor tegelijk een consistente regelgevende dekking onder beide kaders.
Iets wat je makkelijk uitstelt, maar niet zou moeten: de cryptografische algoritmes die de meeste opslaginfrastructuur nu beschermen, zijn niet ontworpen om een krachtige quantumcomputer te doorstaan. NIST heeft in augustus 2024 drie standaarden voor post-quantumcryptografie afgerond, waaronder FIPS 203 (ML-KEM). Als je gedistribueerde dataopslag gegevens bewaart met een lange bewaartermijn, zoals medische archieven, financiële administratie of juridische documenten, dan is het dreigingsmodel „harvest now, decrypt later” nu al actief. Begin met evalueren ruim voordat die archieven hun houdbaarheidsgrens bereiken.
Belangrijkste voordelen van gedistribueerde opslag
- Fouttolerantie zonder dienstonderbreking: Als een node uitvalt, detecteert het systeem dat via heartbeats en worden verzoeken automatisch doorgestuurd naar de overgebleven replica's. Er is geen handmatige ingreep nodig en geen onderhoudsvenster.
- Horizontale schaalbaarheid: Extra opslagcapaciteit komt van nieuwe nodes in het cluster. De data verdeelt zich op de achtergrond opnieuw, zonder dat live verkeer wordt geraakt of er downtime nodig is.
- Geografische spreiding: Replicatie over regio's verkort de latentie voor gebruikers die verspreid zitten en maakt van dataresidentie een configuratiekeuze in plaats van een infrastructuurproject.
- Parallelle I/O-doorvoer: Meerdere nodes verwerken lees- en schrijfbewerkingen tegelijk. Dat is de enige schaalbare architectuur voor AI/ML-trainingspipelines, videotranscodering of mediastreaming op echte productievolumes.
- Geen vendor lock-in dankzij open protocollen: S3-compatibele API's, NFS en open-sourceplatforms zoals Ceph laten teams van provider wisselen of on-premises draaien zonder applicatiecode te herschrijven.
- Kostenefficiëntie op schaal: Standaardhardware vervangt dure, propriëtaire opslagarrays. Erasure coding verlaagt de benodigde ruwe capaciteit bovendien met tot 50% vergeleken met volledige replicatie over nodes.
Beperkingen en uitdagingen van gedistribueerde opslag
- Complexiteit van consistentie: Een consistente status over nodes vraagt zorgvuldige afstemming van consistentiemodellen, replicatiefactoren en quorum-instellingen. Een verkeerde configuratie geeft niet luid alarm. Ze laat de data stilletjes uiteenlopen.
- Operationele last: Een gedistribueerd opslagcluster beheren betekent dat je zelf failure domain-planning, vervanging van nodes, monitoringpipelines en performancetuning verzorgt. Een enkele server vraagt daar lang niet zoveel van je.
- Netwerkafhankelijkheid: De hele architectuur gaat uit van betrouwbare, breedbandige verbindingen tussen nodes. Netwerkproblemen vertalen zich direct en evenredig naar verlies van latentie en doorvoer.
- Latentie bij kleine willekeurige I/O: Gedistribueerde opslag is geoptimaliseerd voor grote sequentiële reads en parallelle doorvoer. Workloads met veel kleine willekeurige I/O, vooral OLTP-databases, presteren vaak beter op lokaal aangesloten NVMe-blockopslag.
- Minimale werkbare schaal: De kosten- en complexiteitsvoordelen van gedistribueerde opslag komen niet tot uiting in een cluster van twee nodes. Onder een bepaalde drempel is een beheerde cloudopslagdienst of een goed afgestemde enkele server simpelweg goedkoper en makkelijker te beheren.
Praktijkvoorbeelden van gedistribueerde opslag
- Media en streaming: Netflix en YouTube leveren video niet vanuit één centrale locatie. Ze verspreiden gecodeerde content over objectopslagclusters die geografisch dicht bij de kijkers staan. Eén datacenter kan wereldwijde streams op schaal niet aan. Alleen de bandbreedtekosten zouden al onbetaalbaar zijn. Gedistribueerde dataopslag is wat de economie van streaming echt laat werken.
- Zorg: Eén MRI-onderzoek levert 500 MB tot 1 GB aan beelddata op. Vermenigvuldig dat over een groot ziekenhuisnetwerk, met verschillende modaliteiten, lange bewaartermijnen en meerdere locaties, en je komt snel op petabytes die zich ophopen. Schaalbare gedistribueerde opslag met geografische redundantie zorgt ervoor dat zorginstellingen HIPAA-conforme toegang tot patiëntendossiers houden, ook als een regionaal datacenter uitvalt.
- AI en machine learning: Een groot taalmodel trainen betekent dat GPU-clusters terabytes tot petabytes aan data moeten voeden, met niet-sequentiële toegangspatronen die een traditioneel opslagsysteem vrijwel meteen overbelasten. Ceph, HDFS en S3-compatibele objectstores zijn de standaard infrastructuurlaag voor ML-pipelines geworden, omdat hun parallelle leesdoorvoer precies aansluit op wat GPU-clusters verbruiken.
- Back-up en disaster recovery: Echte disaster recovery betekent dat data op minstens twee geografisch gescheiden locaties bestaat, met onafhankelijke failure domains. Twee racks in hetzelfde gebouw tellen niet mee. Replicatiebeleid en plaatsingsregels die in de gedistribueerde opslaglaag zijn ingebouwd, bepalen RPO en RTO op infrastructuurniveau, zonder een apart back-upsoftwarepakket. Minder bewegende delen betekent ook een kleiner aanvalsoppervlak.
Gedistribueerde opslag vs. gedecentraliseerde opslag: wat is het verschil?
Gedistribueerde opslag betekent dat data over veel nodes is verspreid, maar dat één organisatie het geheel nog steeds bezit en beheert: het beleid, de toegangsrechten, de mogelijkheid tot verwijderen en de auditlogs. Gedecentraliseerde opslag schaft die centrale autoriteit helemaal af. Data staat verspreid over onafhankelijke peers, en geen enkele operator kan die data eenzijdig censureren, openen of verwijderen.
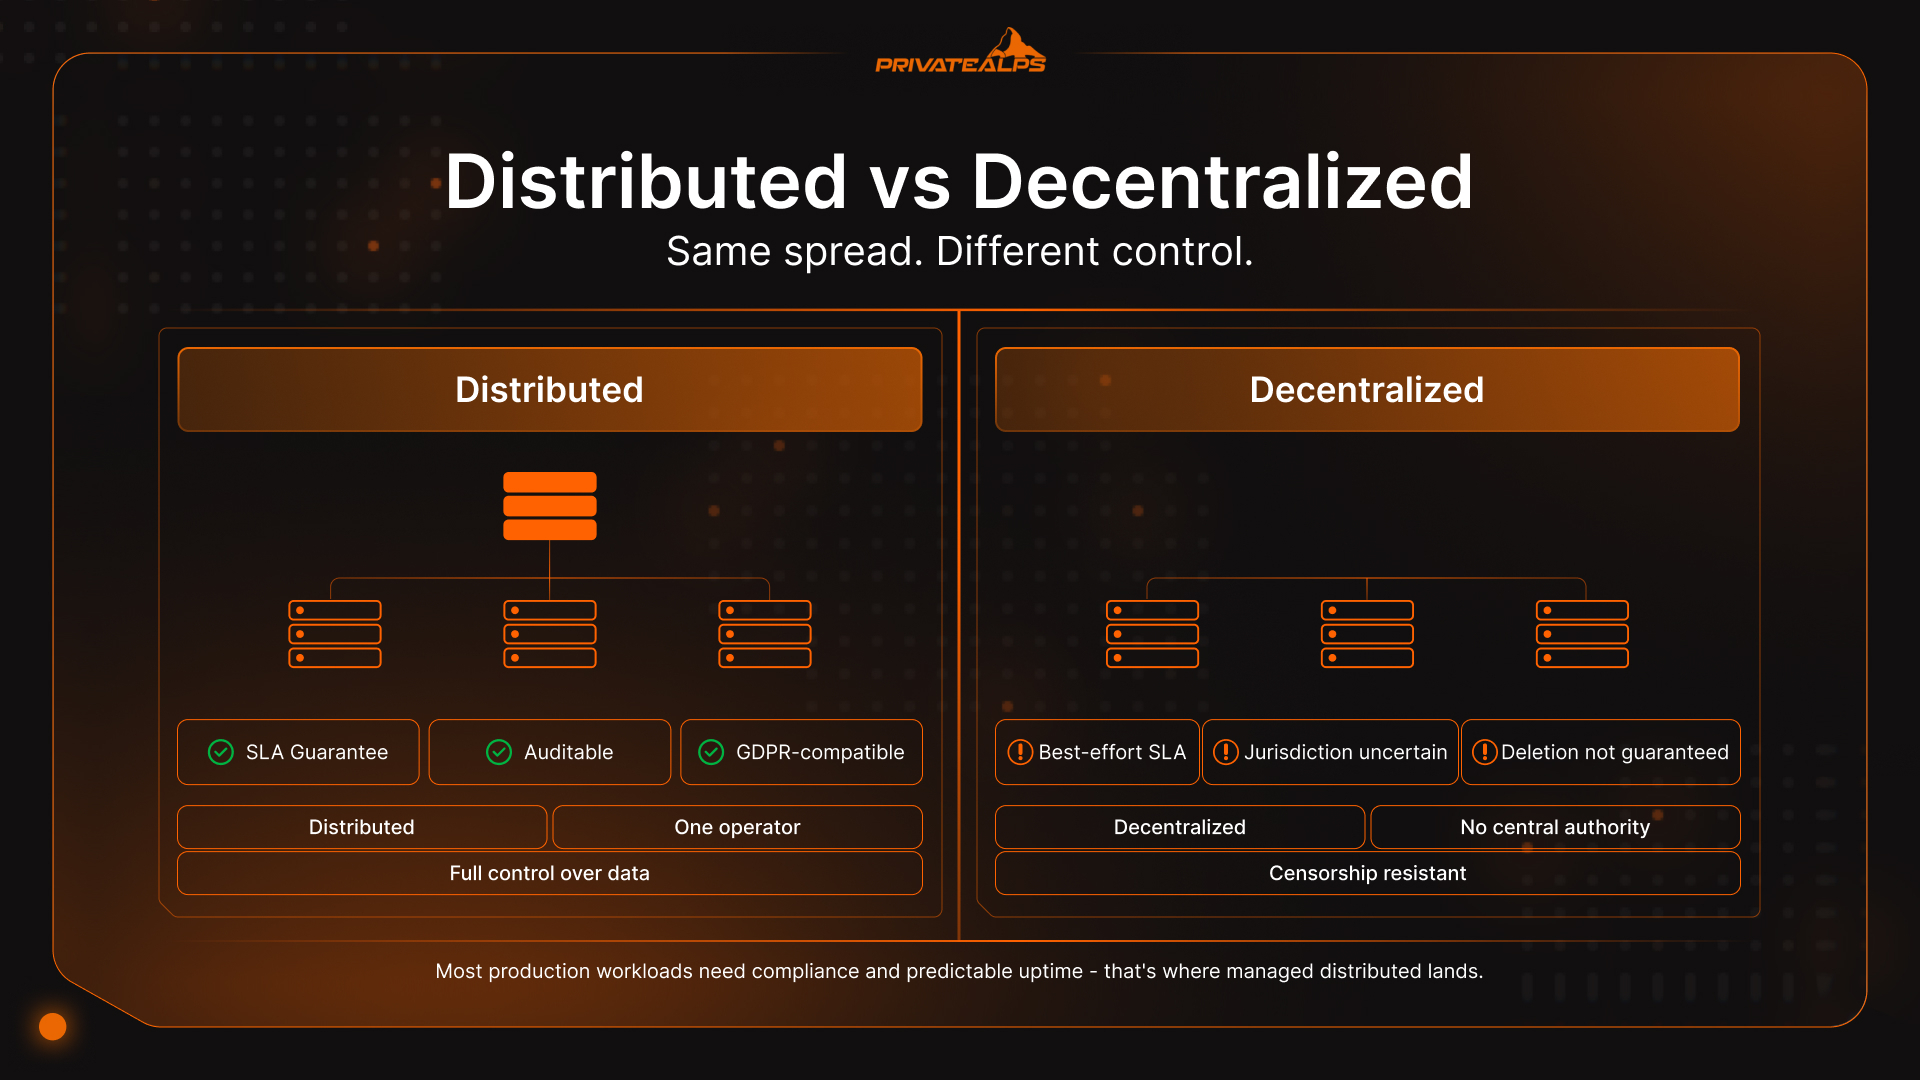
Dit onderscheid heeft concrete gevolgen in de praktijk. Een centraal beheerd gedistribueerd systeem kan worden geaudit, gepatcht, voorzien van een SLA en in regelgevende compliance gebracht. Een gedecentraliseerd systeem ruilt dat allemaal in voor censuurbestendigheid en vertrouwensloze werking. Dat is in specifieke contexten waardevol, maar het is niet wat de meeste bedrijven met productieopslag echt nodig hebben.
| Dimensie | Gedistribueerde opslag | Gedecentraliseerde opslag |
|---|---|---|
| Beheer | Centraal beheerd | Geen centrale autoriteit |
| SLA / uptimegaranties | Contractuele garanties mogelijk | Best effort, afhankelijk van protocol |
| Compliance | Controleerbaar, AVG-compatibel | Jurisdictie onzeker |
| Gegevens verwijderen | Gegarandeerd | Niet altijd mogelijk |
| Toegangscontrole | Op rollen gebaseerd, beheerd | Cryptografisch, vertrouwensloos |
| Voorbeelden | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Eén laag verdient nog een aparte vermelding: multi-region cloudopslag, zoals AWS S3 met cross-region replicatie of Azure geo-redundant storage, blijft centraal beheerde infrastructuur. De provider beheert de nodes en de replicatie. Je huurt in feite geografie. Echte gedistribueerde cloudplatforms zoals Storj of Cubbit verdelen data over onafhankelijke operators. Daarmee verdwijnt de lock-in bij één provider, maar komen vragen over SLA's en auditsporen weer terug. Voor de meeste workloads die compliancedocumentatie en voorspelbare uptime nodig hebben, is de beheerde gedistribueerde aanpak de logische keuze.
Samenvatting
Gedistribueerde opslag is geen product. Het is een architectuurcategorie, en welke variant past, hangt volledig af van wat je draait. Object-, block- en file storage hebben elk een datamodel dat is gebouwd voor andere toegangspatronen en workloads. Het CAP-theorema dwingt een echte afweging tussen consistentie en beschikbaarheid af zodra netwerkstoringen optreden. Een verkeerde keuze kan duur uitpakken. Bij replicatie versus erasure coding bepaalt de „temperatuur” van de data de keuze: hot data heeft replicatie nodig voor latentie, cold data profiteert van de opslagefficiëntie van erasure coding. Voor de meeste teams vindt een beheerde gedistribueerde oplossing, van een privéprovider of publieke cloud, zolang dataresidentie en beveiligingsmaatregelen controleerbaar zijn, een betere balans tussen schaalbaarheid, prestaties en dagelijkse operationele eenvoud dan een zelf gehost cluster.
Sla je data op in Zwitserland, met PrivateAlps
Heb je S3-compatibele gedistribueerde objectopslag nodig met controleerbare dataresidentie? Dan draait PrivateAlps Zwitserse infrastructuur die volledig voldoet aan zowel artikel 45 AVG als de nFADP. Je data blijft in Zwitserland. Er is geen delen met derden, geen onduidelijke routering via buitenlandse jurisdicties en geen verrassingen. Of je nu wegmigreert van een hyperscaler of een privacygerichte architectuur voor gedistribueerde opslag vanaf nul bouwt, PrivateAlps levert de prestaties en de compliancezekerheid die je workload echt nodig heeft.
FAQ
Wat is het verschil tussen gedistribueerde opslag en cloudopslag?
Cloudopslag is een leveringsmodel. Iemand anders beheert de infrastructuur en je gebruikt die via internet, meestal betaald naar gebruik. Gedistribueerde opslag is een architectuur: data verdeeld over meerdere nodes voor redundantie en schaalbaarheid. Het zijn onafhankelijke concepten. Je kunt gedistribueerde opslag volledig on-premises draaien met Ceph of MinIO, en een cloudprovider kan technisch gezien gecentraliseerde opslag achter een API aanbieden. De meeste cloudopslagdiensten gebruiken intern een gedistribueerde architectuur, maar dat is een implementatiedetail en niet de definitie van cloudopslag.
Wat is het beste systeem voor gedistribueerde opslag?
Er is geen universeel antwoord. Het hangt af van de workload en het datamodel. Voor ongestructureerde data en back-ups is een S3-compatibele objectstore, zoals MinIO of Ceph RADOS, de standaardkeuze. Voor databasevolumes en VM-schijven die consistente blockl-I/O met lage latentie nodig hebben, past Ceph RBD of Lightbits beter. Voor gedeelde bestandssystemen in HPC- of legacyomgevingen kiezen teams meestal voor GlusterFS of HDFS. Begin met het toegangspatroon. Het opslagsysteem volgt daaruit.
Is gedistribueerde opslag hetzelfde als RAID?
Nee. RAID werkt binnen één server of opslagarray en beschermt tegen een schijfstoring in één machine. Gedistribueerde opslag werkt over afzonderlijke fysieke nodes die via een netwerk zijn verbonden, mogelijk verspreid over meerdere gebouwen of hele datacenters. RAID helpt niet als de server zelf uitvalt. Gedistribueerde opslagsystemen zijn juist ontworpen om storingen van nodes, racks en complete datacenters te overleven. Het verschil in schaal is fundamenteel.
Hoe gaat gedistribueerde opslag om met uitval van nodes?
Nodes sturen regelmatig heartbeatsignalen naar de metadatalaag van het cluster. Stopt een node met reageren, dan detecteert het systeem de storing, meestal binnen enkele seconden, en stuurt het verzoeken door naar de nodes met de replica's of erasure-coded fragmenten. Bij op replicatie gebaseerde opstellingen start een herstelproces op de achtergrond nieuwe kopieën om de ingestelde replicatiefactor over het cluster te herstellen. Het hele proces is automatisch. In een goed geconfigureerd gedistribueerd opslagcluster merken applicaties de storing helemaal niet.
Is gedistribueerde opslag geschikt voor kleine bedrijven?
Beheerde gedistribueerde opslagdiensten, zoals S3-compatibele objectopslag van een cloudprovider of een specialist als PrivateAlps, werken op elke schaal en vereisen geen minimaal cluster. Zelf gehoste gedistribueerde opslagclusters zijn een ander verhaal. Ceph in productie draaien vraagt meestal minstens drie tot vijf nodes voordat de operationele last zich begint terug te verdienen. Voor kleine teams leveren beheerde diensten de volledige architectuurvoordelen van gedistribueerde opslag zonder de last van infrastructuurbeheer.\\
