


Ce este stocarea distribuită?
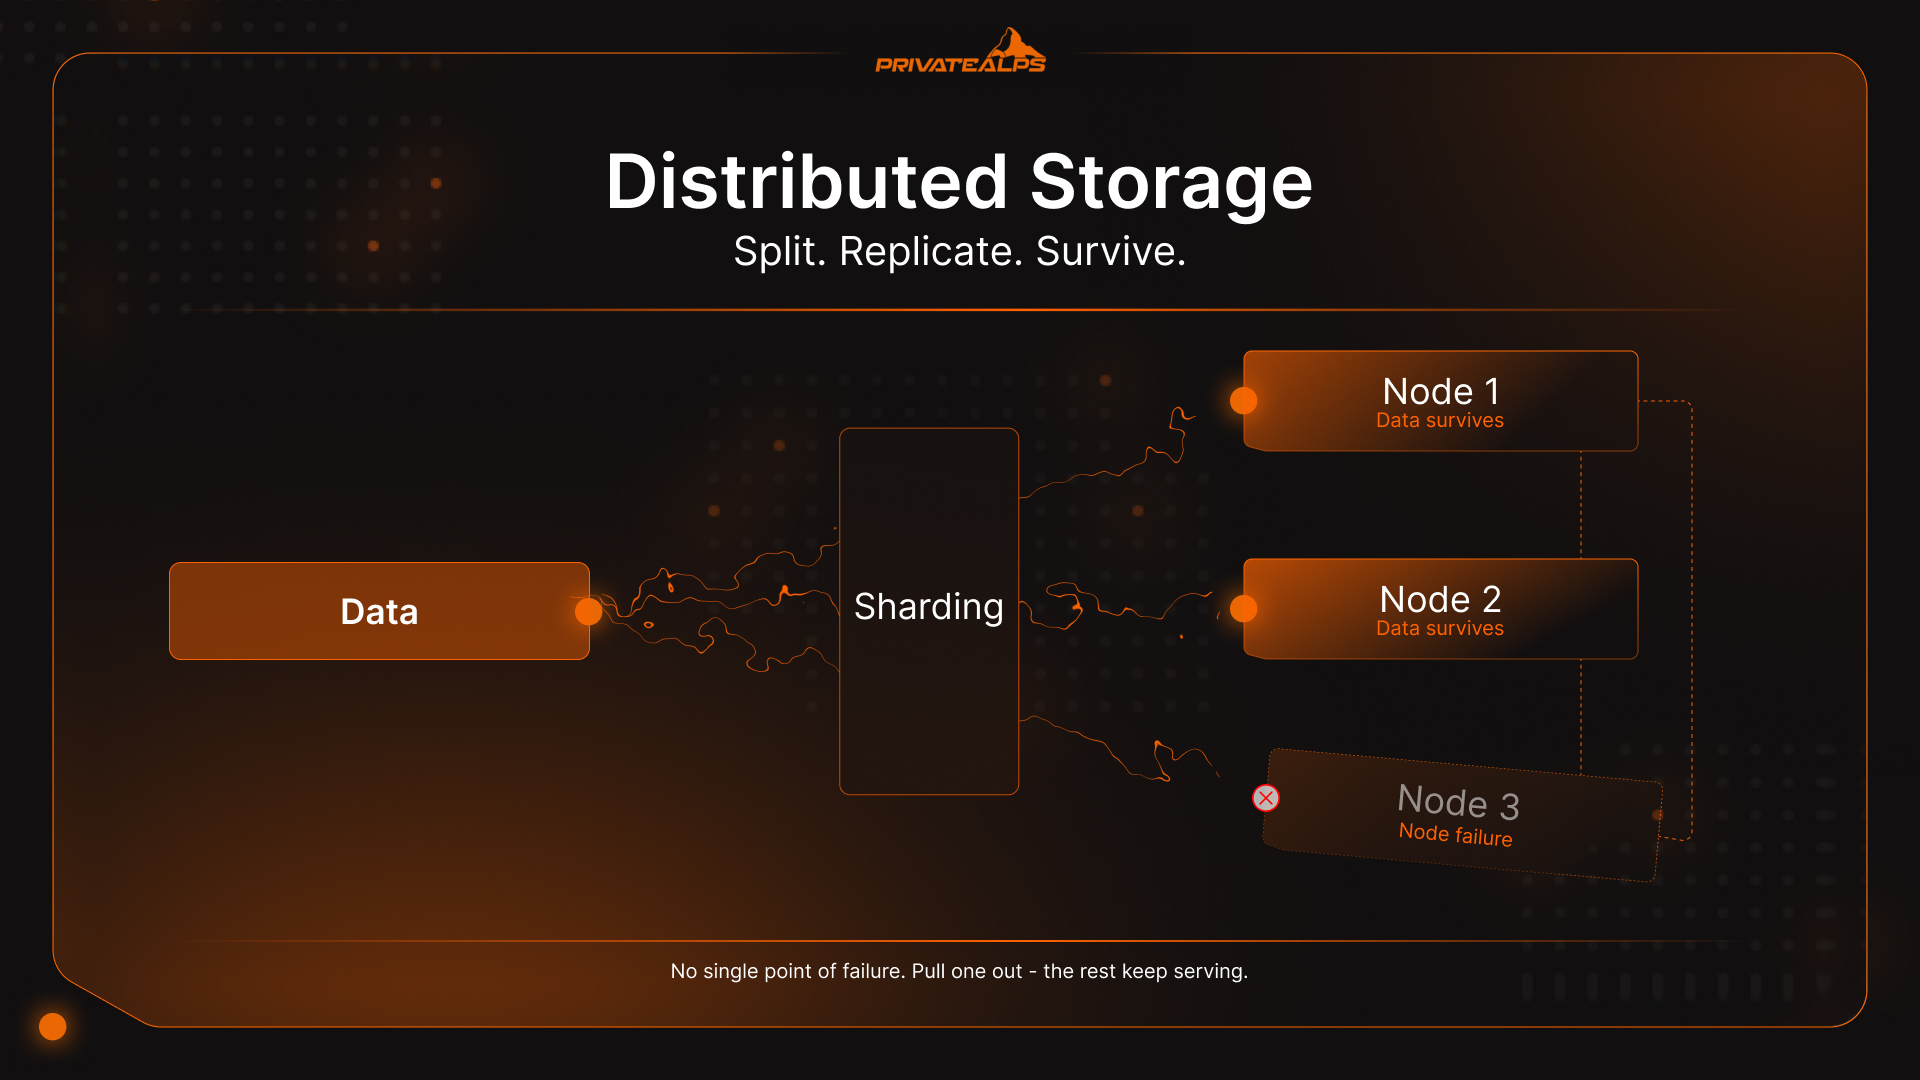
Stocarea distribuită este modul în care infrastructura modernă gestionează date care sunt pur și simplu prea mari, prea critice sau prea solicitate pentru ca o singură mașină să le țină în mod fiabil. În loc să scrie totul pe un singur server, sistemul împarte, replică sau codifică acele date între mai multe noduri independente – servere, discuri, centre de date. Acestea lucrează împreună, dar niciun nod nu deține totul. Dacă scoți unul din funcțiune, celelalte continuă să servească datele. Acest ghid explică modul în care sistemele de stocare distribuită se comportă de fapt sub sarcină, ce compromisuri arhitecturale impun și ce tip de stocare se potrivește fiecărei sarcini de lucru.
Rezumat AI
Stocarea distribuită este o arhitectură definită prin software, care partiționează datele pe mai multe noduri fizice folosind trei tehnici de bază: sharding (împărțirea datelor în bucăți discrete, direcționate către noduri diferite), replicare (menținerea mai multor copii identice pe noduri diferite pentru acces rapid) și erasure coding (codificarea datelor în fragmente cu paritate matematică, astfel încât orice subset să poată reconstitui întregul).
Există trei tipuri principale de sisteme de stocare distribuită: stocare de obiecte (spațiu de nume plat, API compatibil cu S3), stocare pe blocuri (volume de dimensiune fixă pentru operațiuni I/O aleatorii cu latență redusă) și stocare de fișiere (spațiu de nume ierarhic prin NFS sau SMB). Orice configurație de stocare distribuită a datelor se lovește de teorema CAP: poate garanta simultan doar două dintre consistență, disponibilitate și toleranță la partiționare.
Principalul beneficiu operațional este că defectarea unui nod nu provoacă întreruperi; sistemul redirecționează automat cererile către replicile disponibile.
Dimensiunea a ceea ce este în joc: omenirea generează peste 400 de milioane de terabytes de date noi în fiecare zi – un volum pe care nicio arhitectură centralizată nu îl poate absorbi fără să se prăbușească, în cele din urmă, sub propria greutate.
Stocare distribuită vs. stocare centralizată
Stocarea centralizată pune totul într-o singură locație – un server, un SAN, un centru de date. Acesta este întregul model. Când acea locație are o problemă, totul se oprește. Stocarea distribuită abordează direct această problemă: datele sunt răspândite pe mai multe noduri independente, astfel încât niciun punct unic de defectare nu poate scoate întregul sistem din funcțiune sau bloca tot accesul.
O defecțiune hardware și accesul se oprește. Punct. Scalarea presupune upgrade sau înlocuirea sistemului principal, ceea ce implică de obicei timp de indisponibilitate și o discuție despre investiții de capital pe care nimeni nu vrea să o poarte. Stocarea distribuită ocolește ambele probleme prin design: adaugi un nod pentru a crește capacitatea, iar când un nod cade, clusterul ocolește defecțiunea. Fără panică, fără întrerupere. Datele se aflau deja pe mai multe noduri înainte ca ceva să se strice.
| Dimensiune | Stocare centralizată | Stocare distribuită |
|---|---|---|
| Toleranță la defecte | Punct unic de defectare | Datele supraviețuiesc pierderii unui nod |
| Scalabilitate | Verticală (upgrade hardware) | Orizontală (adăugare de noduri) |
| Latență | Scăzută pentru acces local | Variabilă; depinde de topologia rețelei |
| Cost la scară mică | Cost inițial mai mic | Cluster minim viabil mai costisitor |
| Cost la scară mare | Scalare costisitoare | Hardware comercial reduce costul |
| Distribuție geografică | O singură locație | Multi-regiune, prin configurare |
| Complexitate operațională | Simplu de administrat | Necesită instrumente de orchestrare |
Cum funcționează sistemele de stocare distribuită
Un sistem de stocare distribuită preia datele primite, le împarte în bucăți, direcționează acele bucăți către nodurile potrivite din cluster și urmărește fiecare fragment printr-un strat de metadate – astfel încât orice fragment poate fi localizat, recuperat și reasamblat la cerere, indiferent de nodul care îl deține. Aceasta este bucla de bază. Patru mecanisme o alimentează:
- Sharding (partiționarea datelor) Când datele ajung în sistem, acesta le taie în bucăți mai mici – shard-uri sau blocuri – și le distribuie pe noduri. Acesta este mecanismul care deblochează I/O paralel: mai multe noduri gestionează simultan citirile și scrierile, astfel încât debitul crește odată cu dimensiunea clusterului, în loc să atingă plafonul unei singure mașini. Logica de rutare este de obicei hashing consistent, care menține distribuția uniformă pe măsură ce clusterul crește, fără a reașeza totul de fiecare dată când se adaugă un nod.
- Replicarea Abordarea directă, dar eficientă: stochezi N copii identice ale fiecărui shard pe noduri separate, de obicei trei. Un nod se oprește – celelalte două continuă să servească imediat. Fără reconstrucție, fără așteptare. Replicarea este alegerea corectă pentru datele fierbinți – baze de date active, fluxuri în timp real, orice unde o milisecundă în plus la citire chiar costă ceva.
- Erasure coding Aici matematica eficienței stocării devine interesantă. În loc de trei copii complete, sistemul codifică un obiect în $k$ fragmente de date plus $m$ fragmente de paritate, distribuie toate cele $k+m$ pe noduri și poate reconstitui obiectul complet din oricare $k$ dintre ele. Astfel, $m$ noduri pot cădea simultan și nu se pierde nimic. O configurație Reed-Solomon RS(6,3) stochează 9 blocuri în loc de cele 18 necesare replicării 3x, reducând supraîncărcarea brută de stocare de la 200% la aproximativ 50%. Dezavantajul este că codificarea și decodificarea consumă cicluri de procesor, iar erasure coding-ul are performanțe mai bune pe datele reci – conținut rareori modificat sau accesat cu frecvență mare. Pentru sarcinile de lucru cu scrieri frecvente, mici, replicarea 3x rămâne mai bună din punct de vedere al latenței.
| Metodă de protecție | Supraîncărcare de stocare | Cel mai potrivit pentru | Compromis |
|---|---|---|---|
| Replicare 3x | 3x capacitate brută | Date fierbinți, sarcini cu latență redusă | Cost ridicat de stocare la scară mare |
| Erasure coding RS(6,3) | 1,5x capacitate brută | Date reci, arhivare, obiecte mari | Supraîncărcare CPU, latență mai mare la reconstrucție |
- Rutarea prin metadate Fiecare sistem de stocare distribuită păstrează un strat de metadate – practic o hartă a nodului pe care se află fiecare shard. Când un client solicită date, serviciul de metadate identifică nodurile potrivite, iar sistemul recuperează și reasamblează fragmentele fără ca clientul să vadă vreodată complexitatea. În clusterele de mare scară, precum Ceph sau HDFS, stratul de metadate este el însuși distribuit pe mai multe noduri. Trebuie să fie așa. Un singur server de metadate devine blocajul de la care încercai să scapi.
Tipuri de sisteme de stocare distribuită
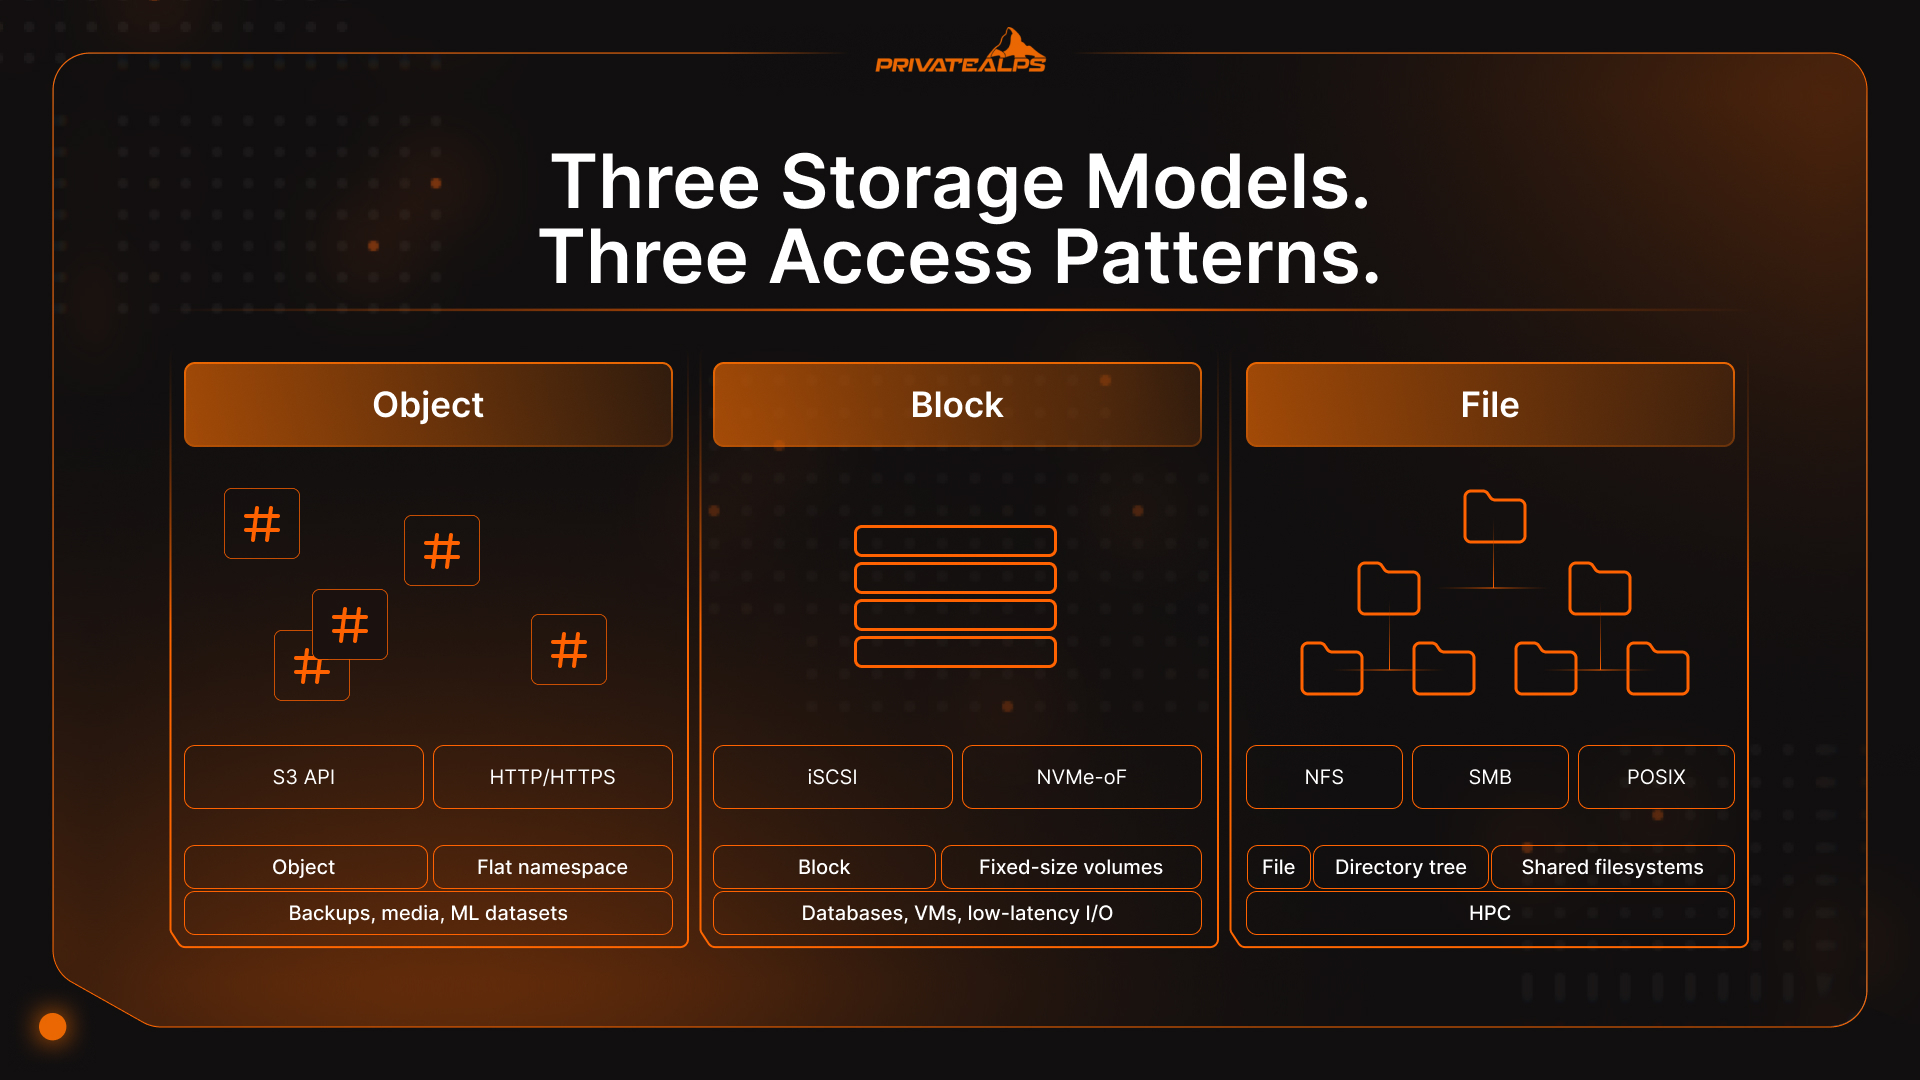
Stocarea distribuită nu este un singur lucru. Este o categorie cu trei modele de date distincte în spate, iar alegerea greșită a unuia pentru o sarcină de lucru este o greșeală surprinzător de frecventă și costisitoare. Stocarea de obiecte, stocarea pe blocuri și stocarea de fișiere rezolvă fiecare o problemă diferită. Bazele de date distribuite – Cassandra, CockroachDB, Google Spanner – reprezintă un al patrulea tip, care adaugă semantică de interogare peste gestionarea datelor distribuite, dar aceasta este o discuție separată.
| Tip | Cum sunt stocate datele | Metodă de acces | Cel mai potrivit pentru | Exemple |
|---|---|---|---|---|
| Obiect | Spațiu de nume plat, obiecte bogate în metadate | API compatibil S3 (HTTP/HTTPS) | Date nestructurate la scară mare: backup-uri, media, seturi de date ML | AWS S3, MinIO, Ceph RADOS |
| Bloc | Volume brute de dimensiune fixă | iSCSI, NVMe-oF, FC | Baze de date, mașini virtuale, I/O aleatoriu cu latență redusă | Ceph RBD, AWS EBS, Lightbits |
| Fișier | Arbore ierarhic de directoare | NFS, SMB, POSIX | Sisteme de fișiere partajate, HPC, directoare home | GlusterFS, HDFS, Azure Files |
Stocare distribuită de obiecte
Stocarea distribuită de obiecte organizează datele ca obiecte individuale, imutabile, situate într-un spațiu de nume plat – fără directoare, fără căi de fișiere, fără ierarhie de întreținut. Fiecare obiect primește un identificator unic (un hash sau un UUID) și metadate bogate, iar accesul se face printr-un API compatibil S3 prin HTTP. Deoarece obiectele sunt înlocuite, nu actualizate parțial, problema blocărilor, care limitează performanța și scalabilitatea în sistemele pe blocuri și de fișiere, dispare pur și simplu. Astfel reușesc AWS S3, Azure Blob și Ceph să ajungă la exabytes: fără costul coordonării spațiului de nume, fără contencție pe blocări, iar orice nod din cluster poate deservi independent orice cerere de obiect.
Stocare distribuită pe blocuri
Stocarea pe blocuri oferă servere volume brute – blocuri de dimensiune fixă, cu adrese unice, fără o abstracție de sistem de fișiere deasupra. Aplicațiile scriu direct pe blocuri, iar aceasta asigură I/O aleatoriu consistent și cu latență redusă pentru baze de date, discuri de mașini virtuale și sarcini containerizate. O limitare arhitecturală care surprinde pe mulți: un volum de bloc poate fi, de regulă, montat de un singur server la un moment dat. Accesul partajat de pe mai multe servere necesită orchestrare suplimentară, cum ar fi un sistem de fișiere de cluster stratificat peste dispozitivele de bloc.
Stocare distribuită de fișiere
Stocarea de fișiere prezintă un sistem de fișiere partajat prin protocoale standard – acces NFS, SMB, compatibil POSIX. Mai mulți clienți pot monta același volum simultan, ceea ce o face alegerea firească pentru sarcini colaborative, medii HPC și aplicații vechi care se așteaptă la un arbore de directoare și nu vor fi rescrise prea curând. Compromisul din lumea reală: menținerea unui spațiu de nume de directoare consistent pe noduri distribuite creează supraîncărcare de coordonare, care se amplifică la scară. Majoritatea hyperscaler-elor migrează, în cele din urmă, de la stocarea distribuită de fișiere la cea de obiecte pentru datele primare, odată ce volumele devin suficient de mari.
Teorema CAP: compromisul inevitabil din stocarea distribuită
Teorema CAP afirmă că un sistem de date distribuit poate garanta doar două din trei lucruri simultan: consistență (fiecare citire returnează ultima scriere), disponibilitate (fiecare cerere primește un răspuns) și toleranță la partiționare (sistemul continuă să funcționeze în timpul fragmentărilor de rețea). Rețelele se fragmentează – toleranța la partiționare nu este opțională. Decizia reală este întotdeauna între consistență și disponibilitate atunci când apare o defecțiune.
[Eric Brewer a introdus teorema CAP în 2000; Gilbert și Lynch au formalizat demonstrația în 2002][https://www.scylladb.com/glossary/cap-theorem/]. Ea rămâne decizia care modelează tot restul în arhitectura stocării distribuite, pentru că determină cum se comportă sistemul exact în momentul în care ai cea mai mare nevoie de el – când ceva este deja defect.
| Sistem | Tip CAP | Comportament în timpul partiționării | Cel mai potrivit pentru |
|---|---|---|---|
| MongoDB | CP (cu read/write concern de majoritate) | Respinge cererile până la restabilirea consistenței | Înregistrări financiare, inventar, rezervări |
| HBase | CP | Returnează erori în loc de date vechi | Analize structurate, joburi batch consistente |
| Apache Cassandra | AP | Rămâne disponibil; poate servi citiri vechi | Fluxuri sociale, mesagerie, telemetrie IoT |
| DynamoDB (implicit) | AP | Răspunde întotdeauna; reconciliază inconsistențele asincron | Aplicații de consum cu debit mare |
| CockroachDB | CP | Consistența înainte de toate, SQL distribuit | Sarcini tranzacționale globale |
Decizia practică: poate sarcina ta de lucru să tolereze o citire veche? Un sold bancar, o rezervare de loc, un număr din inventar – probabil că nu. Alege CP. Un flux social, un flux de evenimente de la senzori, telemetrie analitică – câteva secunde de întârziere sunt acceptabile. Alege AP și păstrează garanția de disponibilitate.
Securitatea stocării distribuite: criptare și suveranitatea datelor
Securitatea în stocarea distribuită acoperă trei straturi distincte: datele în repaus, datele în tranzit și controlul asupra cheilor. Dacă greșești la oricare dintre ele, celelalte nu te mai pot proteja. Infrastructura poate fi perfect disponibilă, iar datele sensibile pot fi accesate discret de persoane nepotrivite.
Criptarea trebuie să acopere toate cele trei straturi. Datele în repaus folosesc, de obicei, AES-256, fie cu chei gestionate de furnizor, fie cu chei gestionate de client (CMK). Gestionarea de către furnizor este mai simplu de operat, dar furnizorul de stocare deține materialul criptografic, ceea ce reprezintă o considerație de securitate critică pentru industriile reglementate, supuse auditurilor. Criptarea pe partea clientului elimină complet această expunere: datele sunt criptate înainte de a părăsi clientul, astfel încât furnizorul nu vede niciodată textul clar, indiferent de cererile legale primite. Pentru datele în tranzit, TLS 1.3 este nivelul minim de securitate; orice configurație care mai permite TLS 1.2 necesită o excepție documentată, conform majorității cadrelor de conformitate actuale.
Suveranitatea datelor îi surprinde adesea pe echipe. Datele se supun legilor țării în care se află fizic, nu țării companiei și nici locației utilizatorului. Elveția are statutul de adecvare conform articolului 45 din GDPR, astfel că transferurile de date din UE în Elveția se desfășoară fără garanții contractuale suplimentare. Noua Lege federală privind protecția datelor (nFADP) aliniază regulile elvețiene interne cu GDPR, ceea ce înseamnă că infrastructura din Elveția oferă o acoperire de reglementare consecventă în ambele cadre, simultan.
Există un aspect ușor de amânat, dar care nu ar trebui: algoritmii criptografici care protejează majoritatea infrastructurilor de stocare de astăzi nu au fost proiectați să reziste unui calculator cuantic capabil. NIST a finalizat trei standarde de criptografie post-cuantică în august 2024, inclusiv FIPS 203 (ML-KEM). Dacă stocarea ta distribuită a datelor păstrează înregistrări cu un termen lung de retenție (arhive medicale, documente financiare, documente juridice), modelul de amenințare „colectează acum, decriptează mai târziu” este deja activ. Evaluarea ar trebui începută cu mult înainte ca arhivele respective să ajungă la maturitate.
Principalele avantaje ale stocării distribuite
- Toleranță la defecte fără întreruperea serviciului: Defectarea unui nod declanșează detectarea prin semnale de tip heartbeat și redirecționarea automată către replicile disponibile, fără intervenție manuală și fără fereastră de mentenanță.
- Scalabilitate orizontală: Capacitatea nouă de stocare vine din adăugarea de noduri în cluster; datele se redistribuie în fundal, fără a afecta traficul live și fără a necesita oprire.
- Distribuție geografică: Replicarea între regiuni reduce latența pentru utilizatorii dispersați geografic și transformă conformitatea privind rezidența datelor dintr-un proiect de infrastructură într-o decizie de configurare.
- Debit I/O paralel: Mai multe noduri gestionează simultan citirile și scrierile, ceea ce face această arhitectură singura scalabilă pentru pipeline-urile de antrenare AI/ML, transcodarea video sau streamingul media la volume reale de producție.
- Fără dependență de furnizor, prin protocoale deschise: API-urile compatibile cu S3, NFS și platformele open-source precum Ceph permit echipelor să migreze între furnizori sau să ruleze infrastructura on-premises fără rescrierea codului aplicației.
- Eficiență a costurilor la scară: Hardware comercial înlocuiește matricile de stocare proprietare scumpe; codarea prin ștergere (erasure coding) reduce și mai mult cerința de capacitate brută, cu până la 50% față de replicarea completă între noduri.
Limitările și provocările stocării distribuite
- Complexitatea consistenței: Menținerea unei stări consistente între noduri necesită o reglare atentă a modelelor de consistență, a factorilor de replicare și a setărilor de quorum. O configurare greșită nu se anunță zgomotos; ea duce treptat datele către divergență.
- Sarcină operațională: Administrarea unui cluster de stocare distribuită implică planificarea domeniilor de defect, procedurile de înlocuire a nodurilor, pipeline-urile de monitorizare și reglarea performanței. Un singur server nu îți cere nimic din toate acestea.
- Dependența de rețea: Întreaga arhitectură presupune conectivitate fiabilă și de mare lățime de bandă între noduri. Degradarea rețelei se traduce direct și proporțional în creșterea latenței de stocare și în pierderea debitului.
- Latența pentru I/O mic și aleatoriu: Stocarea distribuită este optimizată pentru citiri secvențiale mari și debit paralel. Sarcinile cu multe operații I/O mici și aleatorii, în special bazele de date OLTP, funcționează adesea mai bine pe stocare bloc NVMe atașată local.
- Scara minimă viabilă: Avantajele de cost și complexitate ale stocării distribuite nu apar pe un cluster cu două noduri. Sub un anumit prag, un serviciu de stocare cloud gestionat sau un server singur, bine reglat, este pur și simplu mai ieftin și mai ușor de operat.
Cazuri reale de utilizare a stocării distribuite
- Media și streaming: Netflix și YouTube nu livrează videoclipurile dintr-o locație centrală; ele distribuie conținutul codat în clustere de stocare de obiecte, plasate geografic aproape de spectatori. Un singur centru de date nu poate gestiona simultan fluxuri globale la scară, doar costurile de lățime de bandă ar fi prohibitive. Stocarea distribuită a datelor este ceea ce face economia streamingului să funcționeze cu adevărat.
- Sănătate: Un singur studiu RMN generează între 500 MB și 1 GB de date imagistice. Înmulțește aceasta pe o rețea mare de spitale, cu modalități diferite, cerințe lungi de retenție și mai multe locații, și vei ajunge rapid la petabytes. Stocarea distribuită scalabilă, cu redundanță geografică, este modul în care sistemele de sănătate mențin accesul conform HIPAA la dosarele pacienților, chiar și atunci când un centru de date regional cedează.
- AI și învățare automată: Antrenarea unui model lingvistic mare înseamnă alimentarea clusterelor GPU cu terabytes până la petabytes de date, accesate în tipare nesecvențiale, care ar satura aproape imediat un sistem de stocare tradițional. Ceph, HDFS și magazinele de obiecte compatibile cu S3 au devenit stratul de infrastructură standard pentru pipeline-urile ML, deoarece debitul lor de citire paralelă corespunde efectiv a ceea ce consumă clusterele GPU.
- Backup și recuperare în caz de dezastru: Recuperarea reală în caz de dezastru înseamnă ca datele să existe în cel puțin două locații separate geografic, cu domenii de defect independente, nu două rafturi în aceeași clădire. Politicile de replicare și regulile de plasare integrate direct în stratul de stocare distribuită definesc RPO și RTO la nivel de infrastructură, fără a necesita o stivă separată de software de backup. Mai puține componente în mișcare înseamnă și o suprafață de atac mai mică.
Stocare distribuită vs. stocare descentralizată: care este diferența?
Stocarea distribuită înseamnă că datele sunt împărțite pe mai multe noduri, dar o singură organizație deține și controlează întregul sistem: politicile, drepturile de acces, capacitatea de ștergere și jurnalele de audit. Stocarea descentralizată elimină complet această autoritate centrală. Datele trăiesc pe peer-uri independente, iar niciun operator unic nu poate cenzura, accesa sau șterge unilateral.
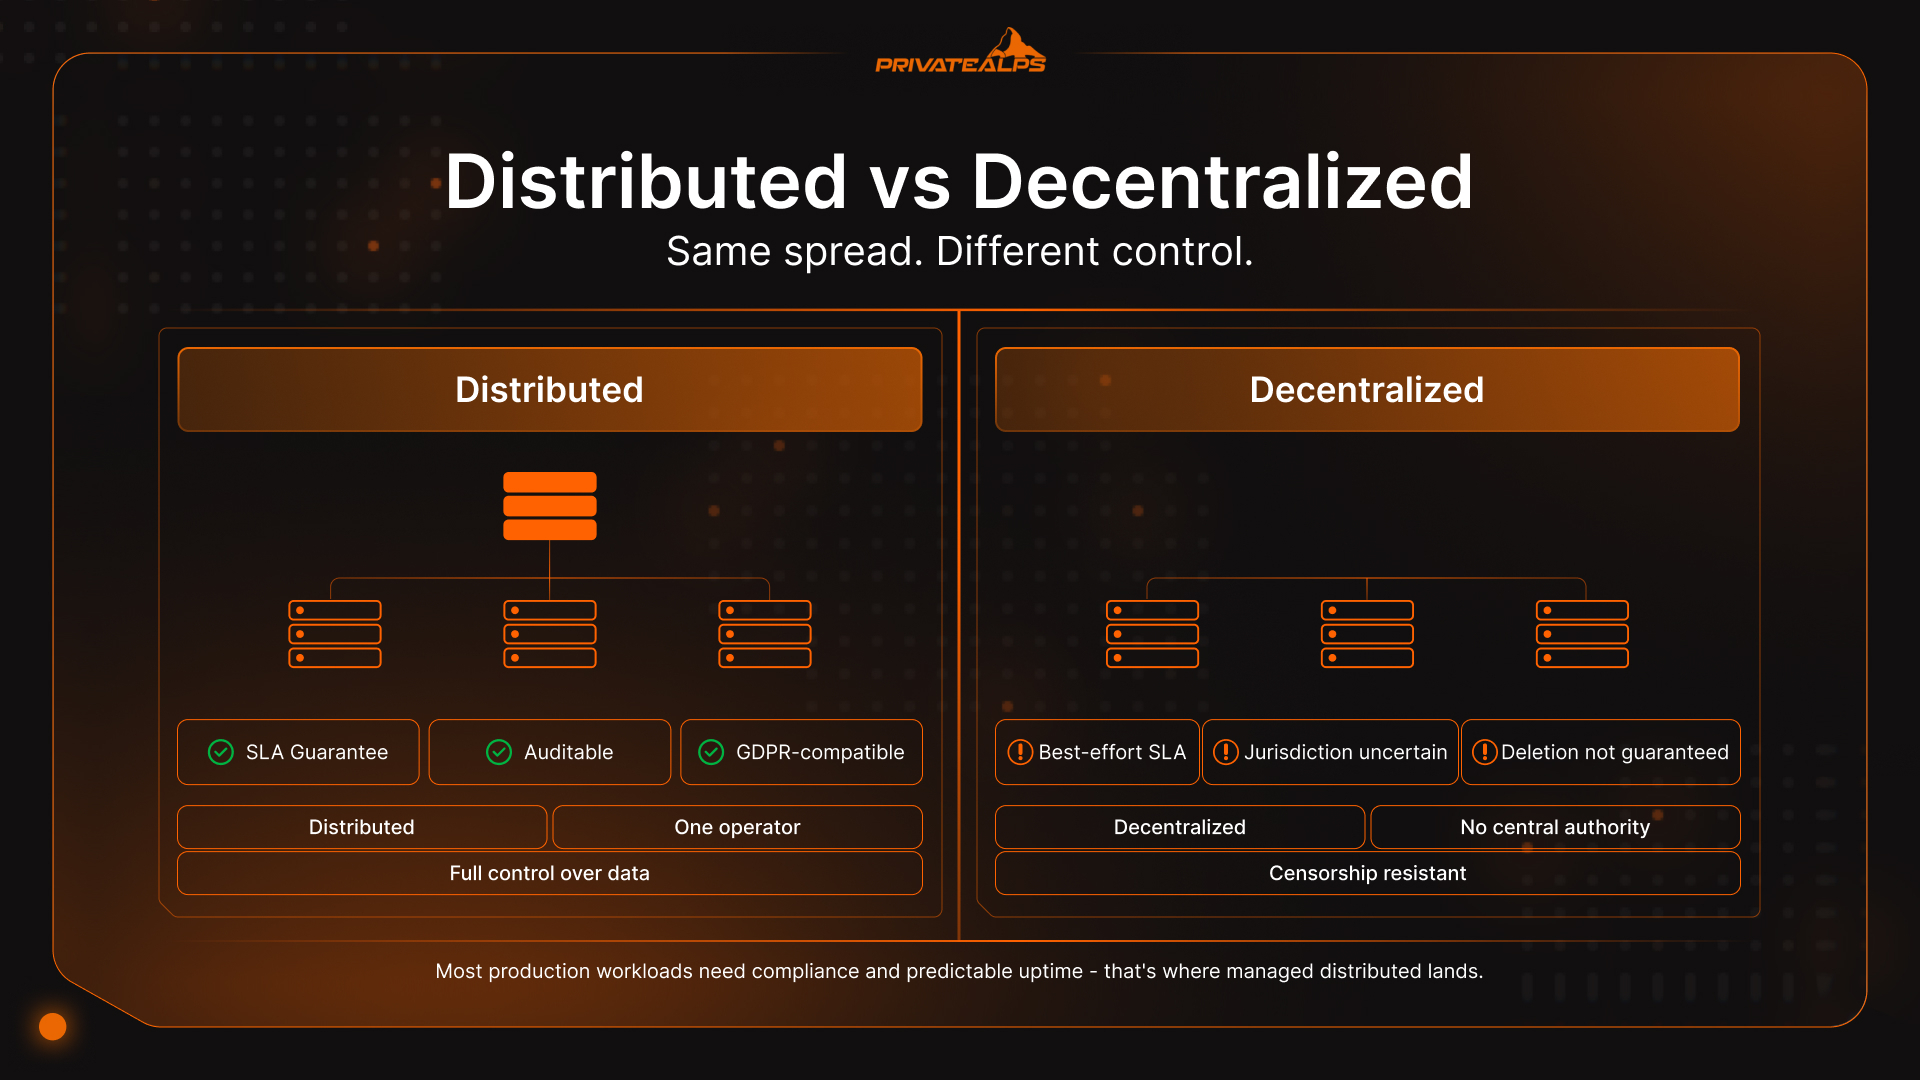
Diferența are consecințe operaționale reale. Un sistem distribuit administrat central poate fi auditat, actualizat, acoperit de un SLA și adus în conformitate cu reglementările. Un sistem descentralizat renunță la toate acestea în schimbul rezistenței la cenzură și al funcționării fără încredere (trustless), ceea ce este valoros în contexte specifice, dar nu este ceea ce au nevoie, de regulă, companiile care rulează infrastructură de stocare în producție.
| Dimensiune | Stocare distribuită | Stocare descentralizată |
|---|---|---|
| Control | Administrată central | Fără autoritate centrală |
| SLA / garanții de uptime | Garanții contractuale posibile | Best-effort, în funcție de protocol |
| Conformitate | Auditabilă, compatibilă GDPR | Jurisdicție incertă |
| Ștergerea datelor | Garantată | Nu întotdeauna posibilă |
| Control al accesului | Pe roluri, gestionat | Criptografic, fără încredere |
| Exemple | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Mai există un strat care merită separat: stocarea cloud multi-regiune, cum ar fi AWS S3 cu replicare între regiuni sau stocarea geo-redundantă Azure, este tot infrastructură administrată central. Furnizorul gestionează nodurile și replicarea; tu, de fapt, închiriezi geografie. Platformele cloud distribuite veritabile, precum Storj sau Cubbit, distribuie datele între operatori independenți, eliminând dependența de furnizor, dar redeschizând întrebările legate de SLA-uri și de jurnalele de audit. Pentru majoritatea sarcinilor care necesită documentație de conformitate și uptime previzibil, abordarea distribuită gestionată este soluția cea mai potrivită.
Rezumat
Stocarea distribuită nu este un produs, ci o categorie arhitecturală, iar varianta potrivită depinde în totalitate de ce rulezi. Stocarea de obiecte, stocarea pe bloc și stocarea de fișiere au fiecare un model de date construit pentru tipare de acces și forme de sarcini diferite. Teorema CAP impune un compromis real între consistență și disponibilitate în momentul în care apar defecte de rețea; a greși această alegere poate fi costisitor. Iar când vine vorba de replicare versus codare prin ștergere, temperatura datelor decide: datele „fierbinți” au nevoie de replicare pentru latență, iar datele „reci” beneficiază de eficiența de stocare a codării prin ștergere. Pentru majoritatea echipelor, o soluție distribuită gestionată, de la un furnizor privat sau dintr-un cloud public, atâta timp cât rezidența datelor și controalele de securitate pot fi verificate, oferă un echilibru mai bun între scalabilitate, performanță și simplitate operațională zilnică decât un cluster auto-găzduit.
Stochează-ți datele în Elveția, cu PrivateAlps
Dacă sarcina ta de lucru necesită stocare distribuită de obiecte compatibilă cu S3 și cu rezidență verificabilă a datelor, PrivateAlps rulează infrastructură cu sediul în Elveția, complet conformă atât cu articolul 45 din GDPR, cât și cu nFADP. Datele tale rămân în Elveția: fără partajare cu terțe părți, fără rutare neclară prin jurisdicții străine, fără surprize. Fie că migrezi de la un hyperscaler, fie că construiești de la zero o arhitectură de stocare distribuită orientată spre confidențialitate, PrivateAlps oferă performanța și certitudinea conformității de care are nevoie efectiv sarcina ta de lucru.
Întrebări frecvente
Care este diferența dintre stocarea distribuită și stocarea cloud?
Stocarea cloud este un model de livrare: altcineva gestionează infrastructura, iar tu o accesezi prin internet, pe bază de plată pe utilizare. Stocarea distribuită este o arhitectură: datele sunt împărțite pe mai multe noduri pentru redundanță și scalabilitate. Sunt concepte independente. Poți rula stocare distribuită integral on-premises, cu Ceph sau MinIO, iar un furnizor cloud poate, tehnic, să ofere stocare centralizată în spatele unui API. Majoritatea serviciilor de stocare cloud folosesc intern arhitecturi distribuite, dar acesta este un detaliu de implementare, nu definiția stocării cloud.
Care este cel mai bun sistem de stocare distribuită?
Nu există un răspuns universal; depinde de sarcina de lucru și de modelul de date. Pentru date nestructurate și backup-uri, magazinele de obiecte compatibile cu S3, precum MinIO sau Ceph RADOS, sunt alegerea standard. Pentru volume de baze de date și discuri VM care necesită I/O bloc consistent și cu latență redusă, Ceph RBD sau Lightbits este o potrivire mai bună. Pentru sistemele de fișiere partajate în medii HPC sau legacy, echipele ajung de obicei la GlusterFS sau HDFS. Începe cu tiparul de acces; sistemul de stocare decurge din acesta.
Stocarea distribuită este același lucru cu RAID?
Nu. RAID funcționează în interiorul unui singur server sau al unei matrice de stocare și protejează împotriva defectării unui disc din acea mașină. Stocarea distribuită funcționează pe noduri fizice separate, conectate printr-o rețea, care pot acoperi mai multe clădiri sau chiar centre de date întregi. RAID nu ajută atunci când serverul în sine cedează. Sistemele de stocare distribuită sunt proiectate special pentru a tolera defectarea nodurilor, a rafturilor și pene totale ale centrelor de date. Diferența de scop este fundamentală.
Cum gestionează stocarea distribuită defectarea nodurilor?
Nodurile trimit semnale heartbeat regulate către stratul de metadate al clusterului. Când un nod nu mai răspunde, sistemul detectează defectul, de obicei în câteva secunde, și redirecționează cererile către nodurile care dețin replicile sau fragmentele codate prin ștergere. În configurațiile bazate pe replicare, un proces de recuperare în fundal creează apoi copii noi pentru a restabili factorul de replicare configurat în cluster. Totul este automat; într-un cluster de stocare distribuită bine configurat, aplicațiile nu observă defectul deloc.
Stocarea distribuită este potrivită pentru întreprinderile mici?
Serviciile de stocare distribuită gestionate, cum ar fi stocarea de obiecte compatibilă cu S3 de la un furnizor cloud sau de la un specialist precum PrivateAlps, funcționează la orice scară, fără cerință minimă de cluster. Clusterele de stocare distribuită auto-găzduite sunt o altă poveste: rularea productivă a Ceph necesită, de regulă, cel puțin trei până la cinci noduri, înainte ca sarcina operațională să înceapă să merite. Pentru echipele mici, serviciile gestionate oferă toate beneficiile arhitecturale ale stocării distribuite, fără povara administrării infrastructurii.
