


Что такое распределенное хранилище данных?
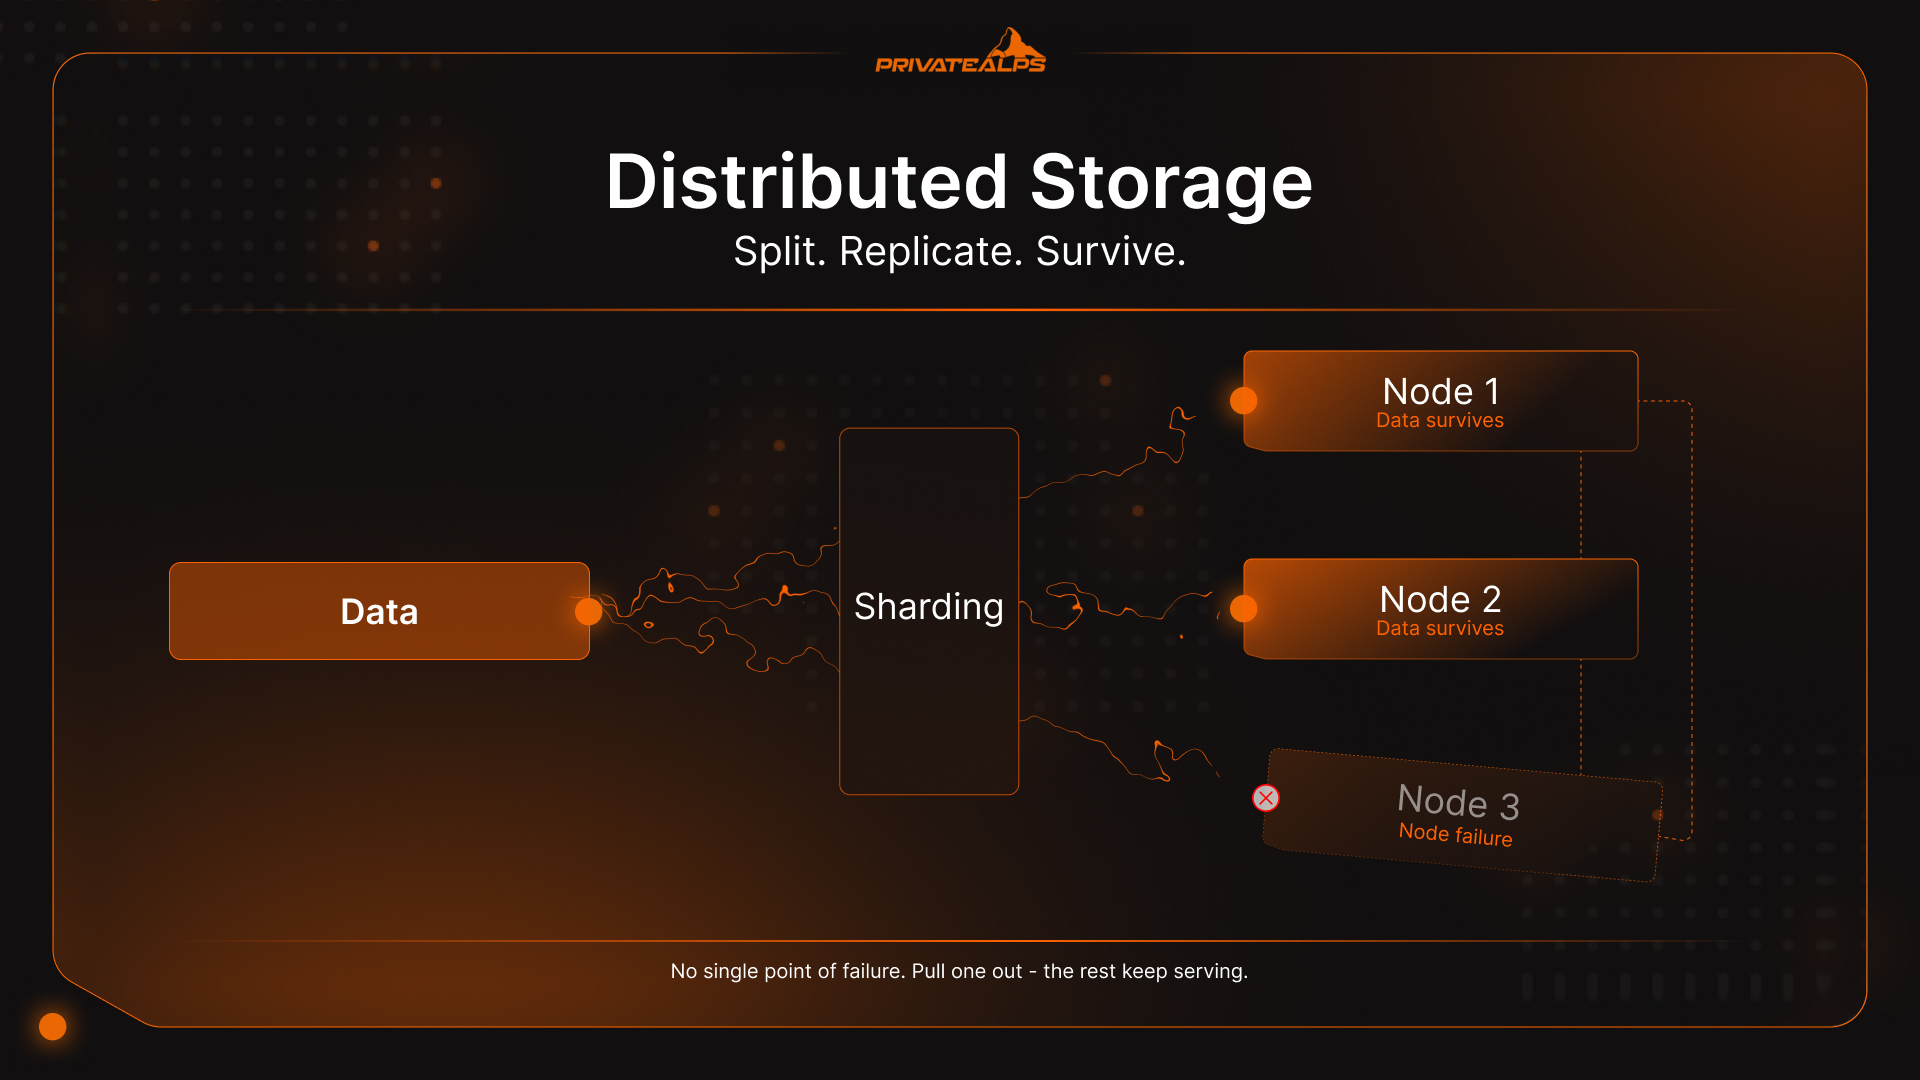
Распределенное хранилище данных — это способ, которым современная инфраструктура работает с объемами данных, которые слишком велики, слишком критичны или слишком часто запрашиваются, чтобы надежно удерживать их на одной машине. Вместо того чтобы записывать всё на один сервер, система разбивает, реплицирует или кодирует эти данные и распределяет их по нескольким независимым узлам: серверам, дискам, дата-центрам. Узлы работают совместно, но ни один из них не хранит всё целиком. Отключите один узел, и остальные продолжают обслуживать запросы. В этом руководстве рассказано, как распределенные системы хранения ведут себя под нагрузкой на практике, какие архитектурные компромиссы они предполагают и какой тип хранилища подходит для каждой задачи.
Краткое резюме (AI)
Распределенное хранилище — это программно определяемая архитектура, которая разделяет данные между несколькими физическими узлами с помощью трех ключевых методов: шардирование (разбиение данных на дискретные части, которые направляются на разные узлы), репликация (хранение нескольких идентичных копий на разных узлах для быстрого доступа) и эразюр-кодирование (кодирование данных во фрагменты с математической проверкой четности, благодаря которой любой достаточный набор фрагментов позволяет восстановить целое).
Существуют три основных типа распределенных систем хранения: объектное хранилище (плоское пространство имен, API, совместимый с S3), блочное хранилище (тома фиксированного размера для операций ввода-вывода с низкой задержкой) и файловое хранилище (иерархическое пространство имен через NFS или SMB). Любая установка распределенного хранилища данных сталкивается с теоремой CAP: одновременно можно гарантировать только два из трех свойств — согласованность, доступность и устойчивость к разделению сети.
Ключевое эксплуатационное преимущество в том, что отказ узла не приводит к простою: система автоматически перенаправляет запросы на исправные реплики. Масштаб проблемы: человечество ежедневно создает более 400 млн ТБ новых данных — объем, который никакая централизованная архитектура не способна вместить без того, чтобы в конечном счете не рухнуть под собственным весом.
Распределенное и централизованное хранилище: в чем разница
Централизованное хранилище помещает всё в одно место: один сервер, одну SAN-сеть, один дата-центр. Это и есть вся модель. Когда в этом месте возникает проблема, останавливается всё. Распределенное хранилище решает эту проблему напрямую: данные находятся на нескольких независимых узлах, поэтому ни одна точка отказа не может отключить систему целиком или заблокировать весь доступ.
Один аппаратный сбой — и доступ прекращается. Полностью. Масштабирование означает модернизацию или замену основной системы, что обычно связано с простоем и капитальными затратами, о которых никто не хочет говорить. Распределенное хранилище обходит оба этих ограничения по своей конструкции: чтобы расшириться, добавьте узел, а когда узел выходит из строя, кластер перенаправляет трафик в обход него. Без паники и без простоя. Данные уже хранились на нескольких узлах до того, как что-либо вышло из строя.
| Параметр | Централизованное хранилище | Распределенное хранилище |
|---|---|---|
| Отказоустойчивость | Единая точка отказа | Данные сохраняются при потере отдельного узла |
| Масштабируемость | Вертикальная (модернизация железа) | Горизонтальная (добавление узлов) |
| Задержка | Низкая при локальном доступе | Переменная; зависит от топологии сети |
| Стоимость в малом масштабе | Ниже первоначальные затраты | Выше минимальный жизнеспособный кластер |
| Стоимость в большом масштабе | Дорогое масштабирование | Стандартное оборудование снижает стоимость |
| Географическое распределение | Одна локация | Несколько регионов по конфигурации |
| Сложность эксплуатации | Простое управление | Требуются инструменты оркестрации |
Как работают распределенные системы хранения
Распределенная система хранения принимает входящие данные, разбивает их на части, направляет эти части на нужные узлы кластера и отслеживает каждый фрагмент через слой метаданных. Благодаря этому любой фрагмент можно найти, получить и собрать обратно по запросу, независимо от того, на каком узле он находится. Это базовый цикл. Работу обеспечивают четыре механизма:
- Шардирование (разделение данных). Когда данные поступают в систему, она нарезает их на более мелкие части — шарды или блоки — и распределяет по узлам. Именно это открывает возможность параллельного ввода-вывода: несколько узлов одновременно обрабатывают чтение и запись, поэтому пропускная способность растет вместе с размером кластера, а не упирается в потолок одной машины. Логика маршрутизации обычно основана на консистентном хешировании, которое поддерживает равномерное распределение по мере роста кластера и не требует перетасовывать все данные каждый раз, когда добавляется новый узел.
- Репликация. Простой, но эффективный подход: хранить N идентичных копий каждого шарда на разных узлах, обычно три. Если один узел выходит из строя, два других сразу продолжают обслуживать запросы. Ни восстановления, ни ожидания. Репликация — правильный выбор для горячих данных: активных баз данных, потоков данных в реальном времени и всего, где лишняя миллисекунда при чтении действительно чего-то стоит.
- Эразюр-кодирование. Здесь математика эффективности хранения становится интересной. Вместо трех полных копий система кодирует объект в $k$ фрагментов данных и $m$ фрагментов четности, распределяет все $k+m$ фрагментов по узлам и может восстановить полный объект из любых $k$ из них. Таким образом, $m$ узлов могут выйти из строя одновременно, и ничего не будет потеряно. Конфигурация Рида — Соломона RS(6,3) хранит 9 блоков вместо 18, которые требуются при трехкратной репликации, снижая накладные расходы на сырую емкость с 200% примерно до 50%. Подвох в том, что кодирование и декодирование расходуют процессорное время, а эразюр-кодирование лучше подходит для холодных данных — контента, который редко изменяется или запрашивается с высокой частотой. Для нагрузок с частой записью небольших объемов трехкратная репликация по-прежнему выигрывает по задержке.
| Метод защиты | Накладные расходы на хранение | Лучше всего подходит | Компромисс |
|---|---|---|---|
| Трехкратная репликация | 3x от сырой емкости | Горячие данные, нагрузки с низкой задержкой | Высокая стоимость хранения при масштабе |
| Эразюр-кодирование RS(6,3) | 1,5x от сырой емкости | Холодные данные, архивы, крупные объекты | Нагрузка на процессор, более долгое восстановление |
- Маршрутизация по метаданным. Каждая распределенная система хранения ведет слой метаданных, по сути карту того, на каком узле находится каждый шард. Когда клиент запрашивает данные, сервис метаданных определяет нужные узлы, а система извлекает и собирает фрагменты так, что клиент никогда не видит всей сложности. В крупных кластерах, таких как Ceph или HDFS, сам слой метаданных распределен по узлам. Иначе и быть не может: один сервер метаданных становится тем самым узким местом, от которого вы пытались уйти.
Типы распределенных систем хранения
Распределенное хранилище — это не одна технология. Это категория с тремя различными моделями данных, и выбор неподходящей модели для конкретной нагрузки — удивительно частая и дорогая ошибка. Объектное, блочное и файловое хранилище решают разные задачи. Распределенные базы данных — Cassandra, CockroachDB, Google Spanner — представляют четвертый тип: они добавляют семантику запросов поверх распределенного управления данными, но это отдельная тема.
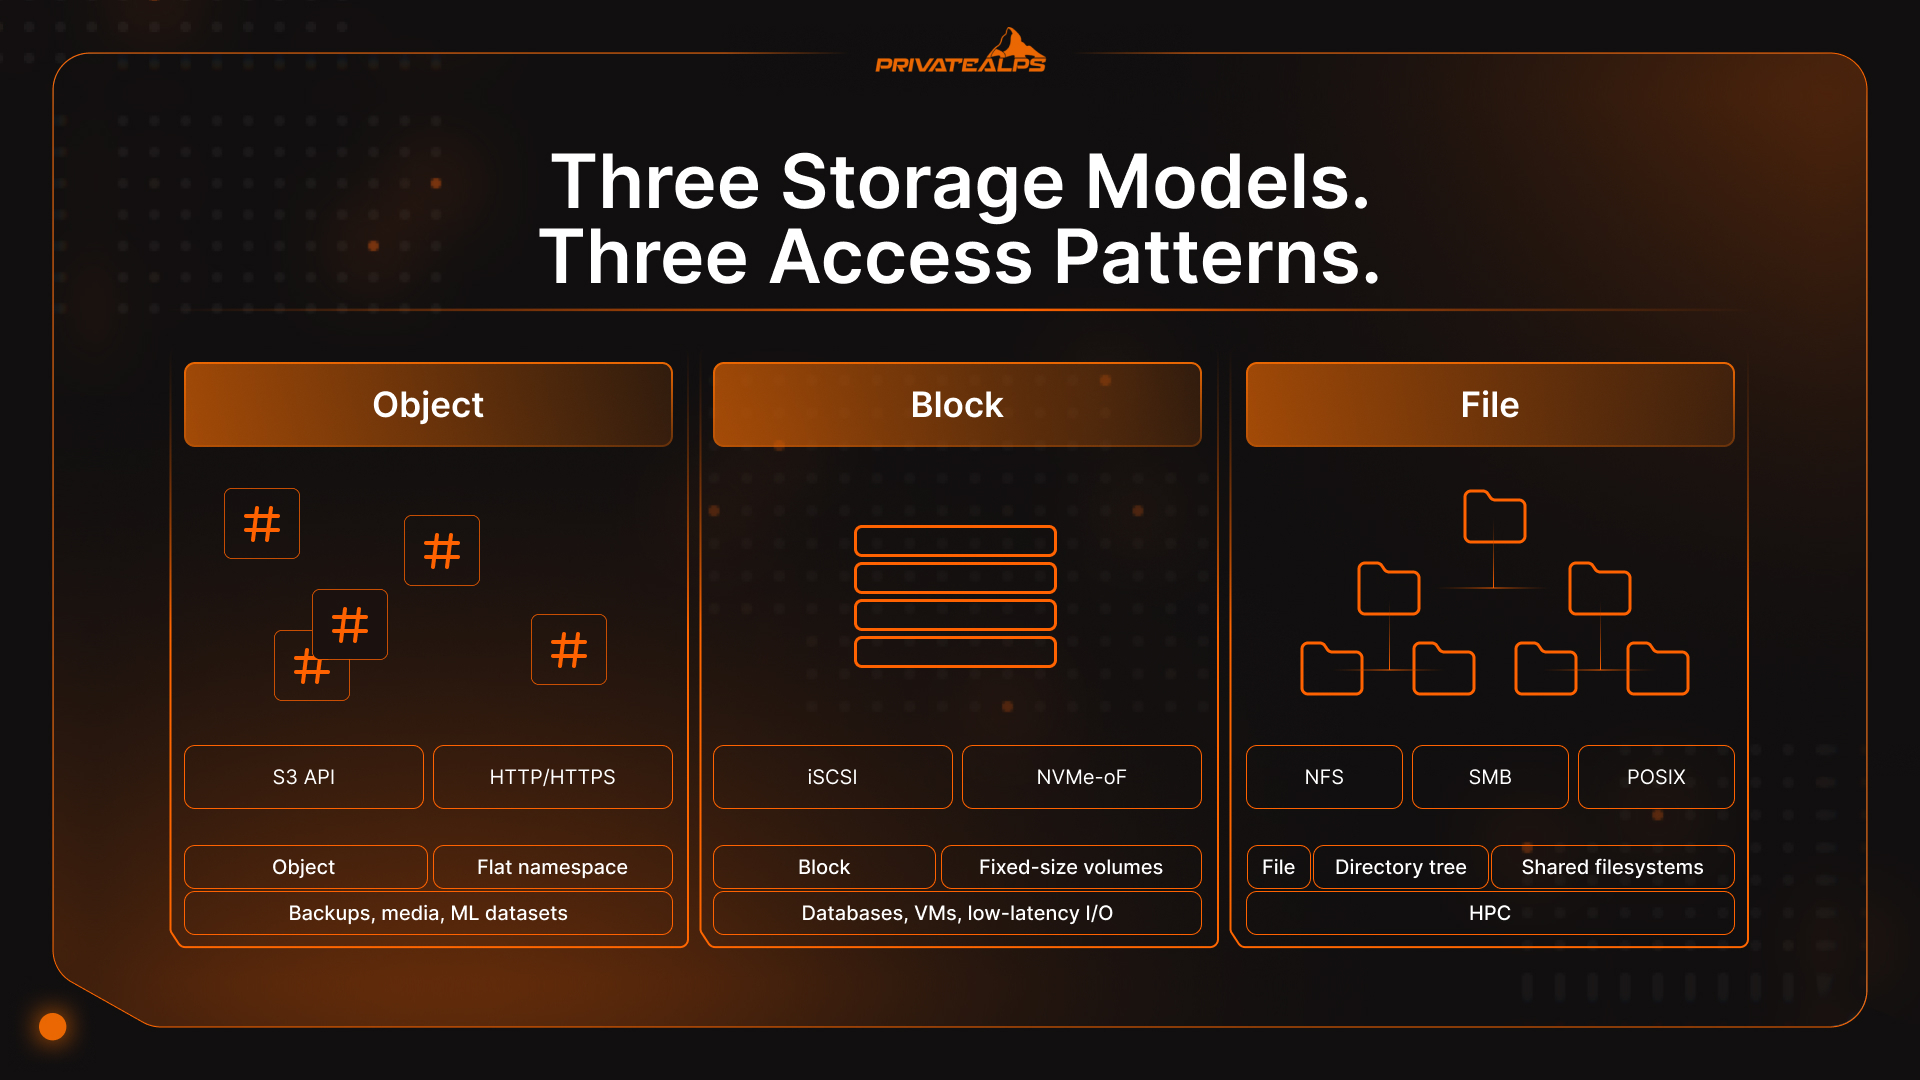
| Тип | Как хранятся данные | Метод доступа | Лучше всего подходит | Примеры |
|---|---|---|---|---|
| Объектное | Плоское пространство имен, объекты с богатыми метаданными | API, совместимый с S3 (HTTP/HTTPS) | Неструктурированные данные в большом объеме: резервные копии, медиа, наборы данных для ML | AWS S3, MinIO, Ceph RADOS |
| Блочное | Сырые тома фиксированного размера | iSCSI, NVMe-oF, FC | Базы данных, виртуальные машины, операции ввода-вывода с низкой задержкой | Ceph RBD, AWS EBS, Lightbits |
| Файловое | Иерархическое дерево каталогов | NFS, SMB, POSIX | Общие файловые системы, HPC, домашние каталоги | GlusterFS, HDFS, Azure Files |
Распределенное объектное хранилище
Распределенное объектное хранилище организует данные в виде отдельных неизменяемых объектов, находящихся в плоском пространстве имен: без каталогов, без путей к файлам и без иерархии, которую нужно поддерживать. Каждый объект получает уникальный идентификатор (хеш или UUID) и богатый набор метаданных, а доступ к нему осуществляется через API, совместимый с S3, по протоколу HTTP. Поскольку объекты заменяются, а не обновляются частично, проблема блокировок, которая ограничивает производительность и масштабируемость блочных и файловых систем, просто исчезает. Именно так AWS S3, Azure Blob и Ceph масштабируются до экзабайтов: нет накладных расходов на координацию пространства имен, нет конкуренции за блокировки, и любой узел кластера может независимо обработать любой запрос к объекту.
Распределенное блочное хранилище
Блочное хранилище предоставляет серверам сырые тома: блоки фиксированного размера с уникальными адресами, без абстракции файловой системы поверх. Приложения записывают данные непосредственно в блоки, что обеспечивает стабильный ввод-вывод с низкой задержкой и произвольным доступом для баз данных, дисков виртуальных машин и контейнеризированных нагрузок. Одно архитектурное ограничение, которое часто застает врасплох: блочный том обычно может быть смонтирован только одним сервером в каждый момент времени. Для совместного доступа с нескольких серверов нужна дополнительная оркестрация, например кластерная файловая система поверх блочных устройств.
Распределенное файловое хранилище
Файловое хранилище предоставляет общую файловую систему через стандартные протоколы: NFS, SMB, доступ, совместимый с POSIX. Несколько клиентов могут одновременно смонтировать один и тот же том, что делает его естественным выбором для совместной работы, сред HPC и устаревших приложений, которые ожидают дерево каталогов и не будут переписаны в ближайшее время. Реальный компромисс: поддержание согласованного пространства имен каталогов на распределенных узлах создает накладные расходы на координацию, которые с ростом масштаба только усиливаются. Большинство гиперскейлеров в конечном итоге переходят с распределенного файлового хранилища на распределенное объектное для основных данных, когда объемы становятся достаточно большими.
Теорема CAP: неизбежный компромисс в распределенном хранилище
Теорема CAP утверждает, что распределенная система данных может гарантировать одновременно только два из трех свойств: согласованность (каждое чтение возвращает последнюю запись), доступность (каждый запрос получает ответ) и устойчивость к разделению сети (система продолжает работать при разрыве сети). Сети разделяются, поэтому устойчивость к разделению не опциональна. Реальный выбор всегда стоит между согласованностью и доступностью в момент сбоя.
[Эрик Брюер представил CAP в 2000 году; Гилберт и Линч формально доказали теорему в 2002 году][https://www.scylladb.com/glossary/cap-theorem/]. Она по-прежнему определяет всё остальное в архитектуре распределенного хранилища, потому что задает поведение системы именно в тот момент, когда вы больше всего в ней нуждаетесь, — когда что-то уже сломано.
| Система | Тип CAP | Поведение при разделении сети | Лучше всего подходит |
|---|---|---|---|
| MongoDB | CP (при majority read/write concern) | Отклоняет запросы, пока согласованность не восстановлена | Финансовые записи, складской учет, бронирование |
| HBase | CP | Возвращает ошибки вместо устаревших данных | Структурированная аналитика, согласованные пакетные задания |
| Apache Cassandra | AP | Остается доступной; может отдавать устаревшие данные | Ленты новостей, мессенджеры, телеметрия IoT |
| DynamoDB (по умолчанию) | AP | Всегда отвечает; несогласованность устраняет асинхронно | Высоконагруженные потребительские приложения |
| CockroachDB | CP | Согласованность в приоритете, распределенный SQL | Глобальные транзакционные нагрузки |
Практический вывод: может ли ваша нагрузка мириться с устаревшим чтением? Баланс на банковском счете, бронирование места, остаток на складе — скорее всего, нет. Выбирайте CP. Лента новостей, поток событий с датчиков, телеметрия аналитики — задержка в несколько секунд допустима. Выбирайте AP и сохраняйте гарантию доступности.
Безопасность распределенного хранилища данных: шифрование и суверенитет данных
Безопасность в распределенном хранилище строится на трех уровнях: данные в покое, данные при передаче и владение ключами. Если ошибиться на любом из них, два других уже не спасут. Инфраструктура может работать безупречно, а к конфиденциальным данным при этом тихо получают доступ не те люди.
Шифрование должно охватывать все три уровня. Для данных в покое обычно используется AES-256, с ключами, которыми управляет провайдер, или с ключами под управлением клиента (CMK). Управление ключами провайдером проще в эксплуатации, но ключевой материал хранит поставщик хранилища. Для регулируемых отраслей, которые проходят аудиты, это серьезный фактор риска. Клиентское шифрование устраняет эту проблему полностью: данные шифруются до того, как покинут клиента, поэтому провайдер никогда не видит открытого текста, какие бы законные запросы ни поступали. Для данных при передаче TLS 1.3 является минимальным требованием безопасности. Любое соединение, которое еще допускает TLS 1.2, по большинству действующих стандартов соответствия требует задокументированного исключения.
Суверенитет данных часто застает команды врасплох. На данные распространяются законы той страны, где они физически находятся, а не страны компании или местоположения пользователя. Швейцария имеет статус адекватности по статье 45 GDPR, поэтому передача данных из ЕС в Швейцарию осуществляется без дополнительных договорных гарантий. Обновленный Федеральный закон о защите данных (nFADP) приводит швейцарские внутренние правила в соответствие с GDPR, а значит, швейцарская инфраструктура обеспечивает единое нормативное покрытие сразу по обеим системам.
Есть вопрос, который легко отложить, но откладывать не стоит: криптографические алгоритмы, защищающие большую часть современной инфраструктуры хранения, не были рассчитаны на устойчивость к мощному квантовому компьютеру. NIST утвердил три стандарта постквантовой криптографии в августе 2024 года, включая FIPS 203 (ML-KEM). Если ваше распределенное хранилище данных содержит записи с длительным сроком хранения, например медицинские архивы, финансовые документы или юридические материалы, модель угрозы «собрать сейчас, расшифровать позже» уже действует. Планирование перехода стоит начинать задолго до того, как эти архивы начнут терять актуальность.
Ключевые преимущества распределенного хранилища
- Отказоустойчивость без прерывания сервиса: при отказе узла система обнаруживает его по сигналам heartbeat и автоматически перенаправляет запросы на работающие реплики. Ручное вмешательство не требуется, окно для обслуживания тоже.
- Горизонтальная масштабируемость: новая емкость появляется за счет добавления узлов в кластер. Данные перераспределяются в фоновом режиме, не затрагивая живой трафик и не требуя простоя.
- Географическое распределение: репликация между регионами снижает задержки для удаленно расположенных пользователей, а соблюдение требований к местонахождению данных становится вопросом конфигурации, а не отдельного инфраструктурного проекта.
- Параллельная пропускная способность ввода-вывода: несколько узлов одновременно обрабатывают чтение и запись. Это единственная масштабируемая архитектура для конвейеров обучения ИИ и машинного обучения, транскодирования видео и потокового медиа при реальных производственных объемах.
- Отсутствие привязки к вендору благодаря открытым протоколам: S3-совместимые API, NFS и открытые платформы вроде Ceph позволяют переезжать между провайдерами или развертывать инфраструктуру on-premises без переписывания кода приложений.
- Экономическая эффективность при масштабе: стандартное оборудование заменяет дорогие проприетарные системы хранения. Кодирование с исправлением ошибок (erasure coding) дополнительно сокращает требуемую сырую емкость до 50 % по сравнению с полной репликацией между узлами.
Ограничения и сложности распределенного хранилища
- Сложность согласованности: поддержание согласованного состояния между узлами требует тщательной настройки моделей согласованности, коэффициентов репликации и параметров кворума. Ошибка в конфигурации не заявляет о себе громко. Она незаметно приводит к расхождению данных.
- Операционные издержки: эксплуатация кластера распределенного хранилища означает планирование доменов отказа, процедуры замены узлов, конвейеры мониторинга и настройку производительности. Один сервер не требует всего этого.
- Зависимость от сети: вся архитектура опирается на надежное соединение с высокой пропускной способностью между узлами. Деградация сети напрямую и пропорционально ведет к росту задержек хранилища и потере пропускной способности.
- Задержки при мелких случайных операциях ввода-вывода: распределенное хранилище оптимизировано для больших последовательных чтений и параллельной пропускной способности. Нагрузки с большим количеством мелких случайных операций ввода-вывода, особенно OLTP-базы данных, часто работают лучше на локально подключенном блочном хранилище на NVMe.
- Минимальный разумный масштаб: преимущества распределенного хранилища по стоимости и сложности не проявляются на кластере из двух узлов. Ниже определенного порога управляемый облачный сервис хранения или хорошо настроенный одиночный сервер просто дешевле и проще в эксплуатации.
Примеры использования распределенного хранилища
- Медиа и стриминг: Netflix и YouTube не раздают видео из одного центра. Они распределяют закодированный контент по кластерам объектного хранилища, размещенным географически близко к зрителям. Один дата-центр не справится с одновременными глобальными трансляциями в таком масштабе, а одни только расходы на пропускную способность были бы непомерными. Распределенное хранилище данных делает экономику стриминга реально работоспособной.
- Здравоохранение: одно МРТ-исследование генерирует от 500 МБ до 1 ГБ данных изображений. Умножьте это на сеть крупной больницы с разными типами оборудования, длительными сроками хранения и несколькими площадками, и объем быстро достигнет петабайтов. Масштабируемое распределенное хранилище с географическим резервированием помогает медицинским системам сохранять доступ к данным пациентов, соответствующий требованиям HIPAA, даже при отказе регионального дата-центра.
- ИИ и машинное обучение: обучение большой языковой модели означает подачу на GPU-кластеры данных объемом от терабайтов до петабайтов. Доступ к ним происходит в непоследовательном порядке, который почти сразу перегрузил бы традиционную систему хранения. Ceph, HDFS и S3-совместимые объектные хранилища стали стандартным уровнем инфраструктуры для конвейеров ML, поскольку их параллельная пропускная способность чтения действительно соответствует тому, что потребляют GPU-кластеры.
- Резервное копирование и аварийное восстановление: настоящее аварийное восстановление означает, что данные существуют как минимум в двух географически разнесенных локациях с независимыми доменами отказа, а не в двух стойках одного здания. Политики репликации и правила размещения, встроенные непосредственно в уровень распределенного хранилища, определяют RPO и RTO на уровне инфраструктуры без отдельного стека программ для резервного копирования. Меньше подвижных частей также означает меньшую поверхность атаки.
Распределенное и децентрализованное хранилище: в чем разница?
Распределенное хранилище означает, что данные разнесены по множеству узлов, но вся система по-прежнему принадлежит одной организации и контролируется ею: политики, права доступа, возможность удаления, журналы аудита. Децентрализованное хранилище полностью убирает центральный орган управления. Данные хранятся на независимых равноправных узлах, и ни один оператор не может единолично цензурировать, получить доступ к данным или удалить их.
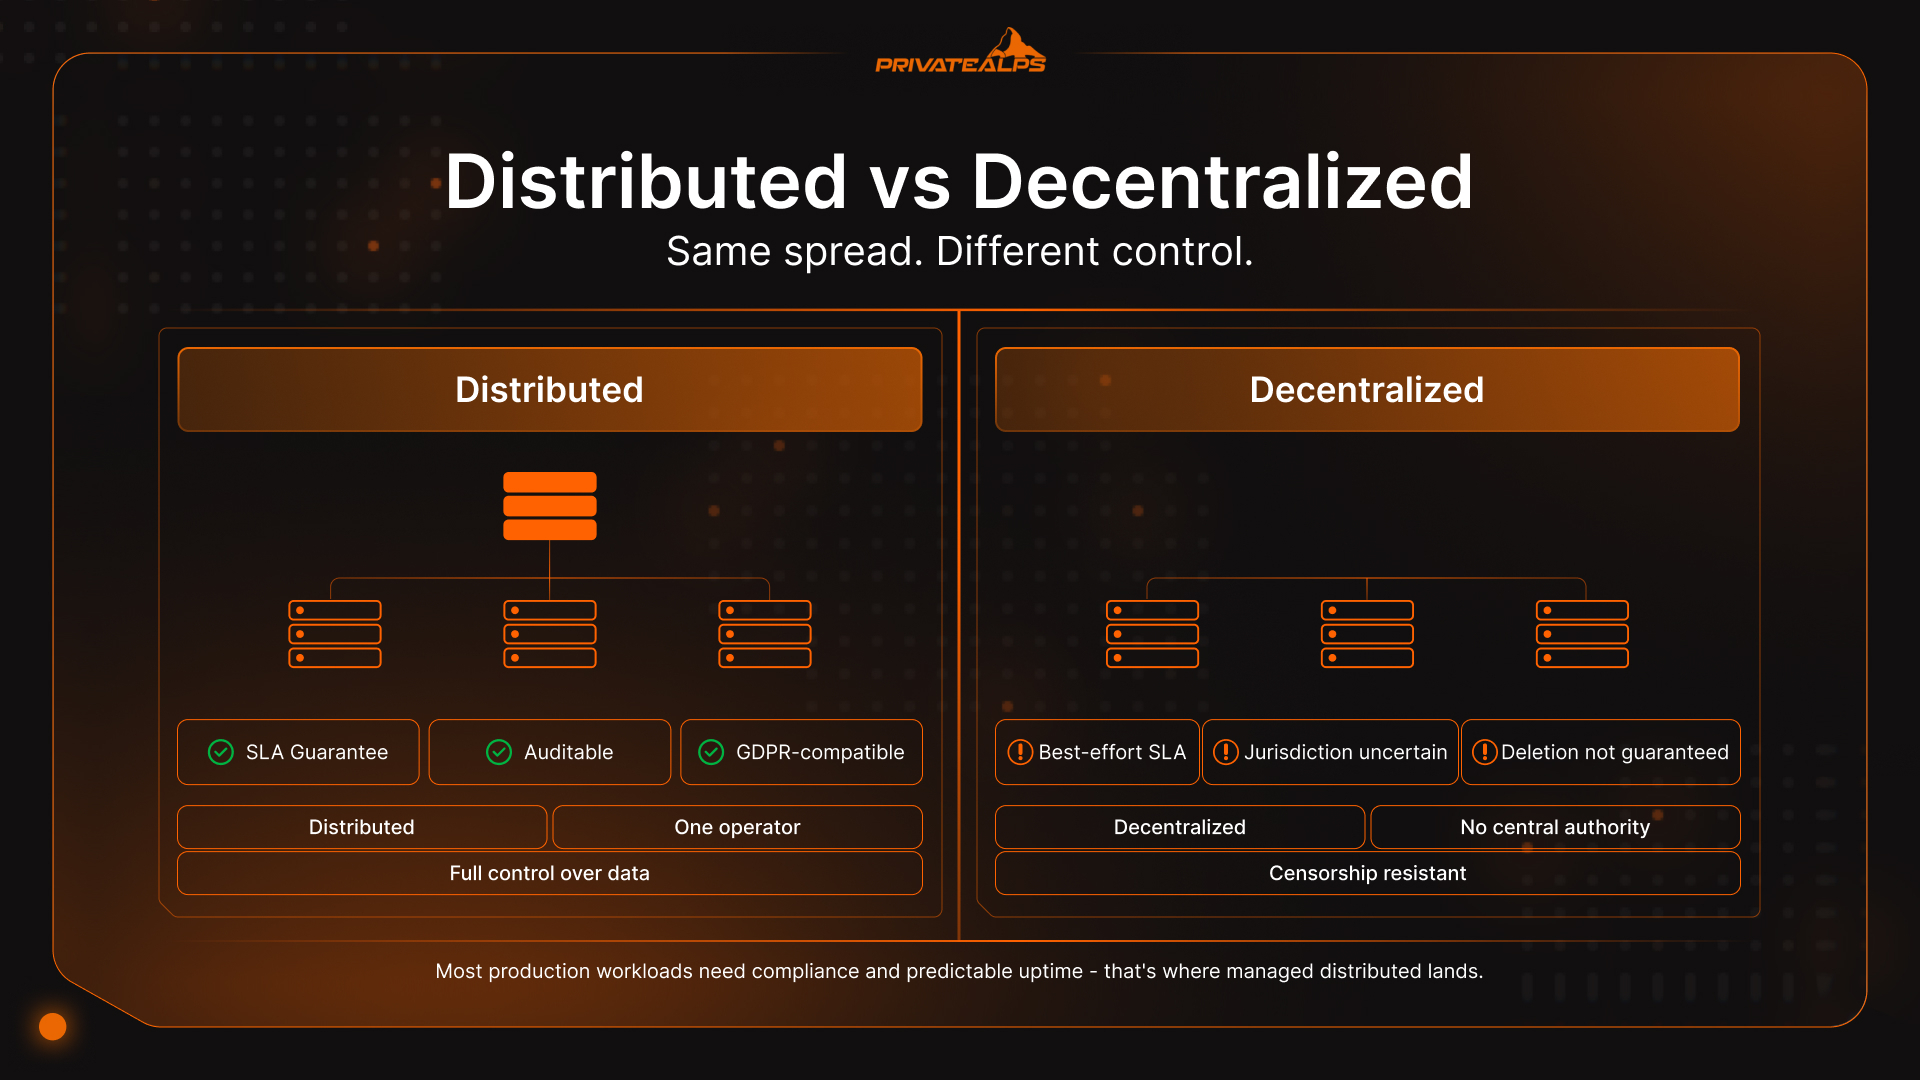
Это различие имеет реальные операционные последствия. Централизованно управляемую распределенную систему можно аудировать, обновлять, обеспечивать SLA и приводить в соответствие с нормативными требованиями. Децентрализованная система взамен всего этого дает устойчивость к цензуре и работу без доверия к посредникам. Это ценно в определенных сценариях, но большинству компаний, которые эксплуатируют инфраструктуру хранения в продакшене, такой вариант на самом деле не нужен.
| Параметр | Распределенное хранилище | Децентрализованное хранилище |
|---|---|---|
| Управление | Централизованное | Без центрального органа |
| SLA / гарантии доступности | Возможны договорные гарантии | Best-effort, зависит от протокола |
| Соответствие требованиям | Аудируемо, совместимо с GDPR | Юрисдикция не определена |
| Удаление данных | Гарантировано | Не всегда возможно |
| Контроль доступа | Ролевой, управляемый | Криптографический, без доверия |
| Примеры | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Есть еще один уровень, который стоит выделить: мультирегиональное облачное хранилище, например AWS S3 с межрегиональной репликацией или Azure с геоизбыточным хранением, по-прежнему является централизованно управляемой инфраструктурой. Провайдер управляет узлами и репликацией, а вы фактически арендуете географию. Настоящие распределенные облачные платформы, такие как Storj или Cubbit, направляют данные через независимых операторов. Это снимает привязку к провайдеру, но возвращает вопросы о SLA и журналах аудита. Для большинства задач, которым нужны документы о соответствии требованиям и предсказуемая доступность, оптимальным выбором остается управляемый распределенный подход.
Итоги
Распределенное хранилище — это не продукт, а архитектурная категория, и подходящий вариант полностью зависит от того, что вы запускаете. Объектное, блочное и файловое хранилище имеют модели данных, созданные для разных шаблонов доступа и типов нагрузки. Теорема CAP вынуждает выбирать между согласованностью и доступностью в тот момент, когда возникают сетевые сбои, и ошибка в этом выборе может обойтись дорого. Что касается выбора между репликацией и кодированием с исправлением ошибок, решает «температура» данных: горячим данным нужна репликация ради низких задержек, а холодным выгодна экономия места, которую дает erasure coding. Для большинства команд управляемое распределенное решение, будь то частный провайдер или публичное облако, при условии, что контроль местонахождения и безопасности данных можно проверить, обеспечивает лучший баланс масштабируемости, производительности и простоты повседневной эксплуатации, чем самостоятельно развернутый кластер.
Храните данные в Швейцарии — с PrivateAlps
Если вашей нагрузке нужно S3-совместимое распределенное объектное хранилище с проверяемым местонахождением данных, PrivateAlps предлагает швейцарскую инфраструктуру, полностью соответствующую статье 45 GDPR и nFADP. Ваши данные остаются в Швейцарии: без передачи третьим сторонам, без неясной маршрутизации через зарубежные юрисдикции и без неожиданностей. Переходите ли вы с гиперскейлера или создаете архитектуру распределенного хранилища с приоритетом приватности с нуля, PrivateAlps обеспечивает производительность и уверенность в соответствии требованиям, которые действительно нужны вашей нагрузке.
Часто задаваемые вопросы
В чем разница между распределенным хранилищем и облачным хранилищем?
Облачное хранилище — это модель предоставления услуги: инфраструктурой управляет кто-то другой, а доступ к ней вы получаете через интернет с оплатой по факту использования. Распределенное хранилище — это архитектура, при которой данные разнесены по нескольким узлам для отказоустойчивости и масштабирования. Это независимые понятия. Распределенное хранилище можно полностью развернуть on-premises на Ceph или MinIO, а облачный провайдер может технически предоставлять централизованное хранилище через API. Большинство облачных хранилищ внутри используют распределенную архитектуру, но это деталь реализации, а не определение облачного хранилища.
Какая распределенная система хранения лучше всего?
Универсального ответа нет: все зависит от нагрузки и модели данных. Для неструктурированных данных и резервных копий стандартным выбором являются S3-совместимые объектные хранилища, например MinIO или Ceph RADOS. Для томов баз данных и дисков виртуальных машин, которым нужен согласованный блочный ввод-вывод с низкими задержками, лучше подходит Ceph RBD или Lightbits. Для общих файловых систем в HPC или унаследованных средах команды обычно выбирают GlusterFS или HDFS. Начните с шаблона доступа, а выбор системы хранения последует из него.
Является ли распределенное хранилище тем же самым, что и RAID?
Нет. RAID работает внутри одного сервера или дискового массива и защищает от отказа дисков внутри одной машины. Распределенное хранилище работает между отдельными физическими узлами, соединенными по сети, которые могут находиться в разных зданиях или даже в разных дата-центрах. RAID не помогает, если отказывает сам сервер. Распределенные системы хранения специально создаются для того, чтобы выдерживать отказ узлов, стоек и полную недоступность дата-центра. Разница в масштабе принципиальная.
Как распределенное хранилище справляется с отказом узлов?
Узлы регулярно отправляют сигналы heartbeat метаданным кластера. Когда узел перестает отвечать, система обнаруживает сбой, обычно в течение нескольких секунд, и перенаправляет запросы на узлы, которые хранят реплики или фрагменты с кодированием с исправлением ошибок. В системах на основе репликации фоновый процесс восстановления затем создает новые копии, чтобы вернуть заданный коэффициент репликации по всему кластеру. Все происходит автоматически. В хорошо настроенном кластере распределенного хранилища приложения вообще не замечают сбоя.
Подходит ли распределенное хранилище малому бизнесу?\\
Управляемые сервисы распределенного хранилища, то есть S3-совместимое объектное хранилище от облачного провайдера или специализированной компании вроде PrivateAlps, работают на любом масштабе и не требуют минимального размера кластера. Самостоятельно развернутые кластеры распределенного хранилища — это другая история: для продуктивной работы Ceph обычно нужно минимум от трех до пяти узлов, прежде чем операционные издержки начинают окупаться. Для небольших команд управляемые сервисы дают все архитектурные преимущества распределенного хранилища без нагрузки на управление инфраструктурой.
