


Lưu trữ phân tán là gì?
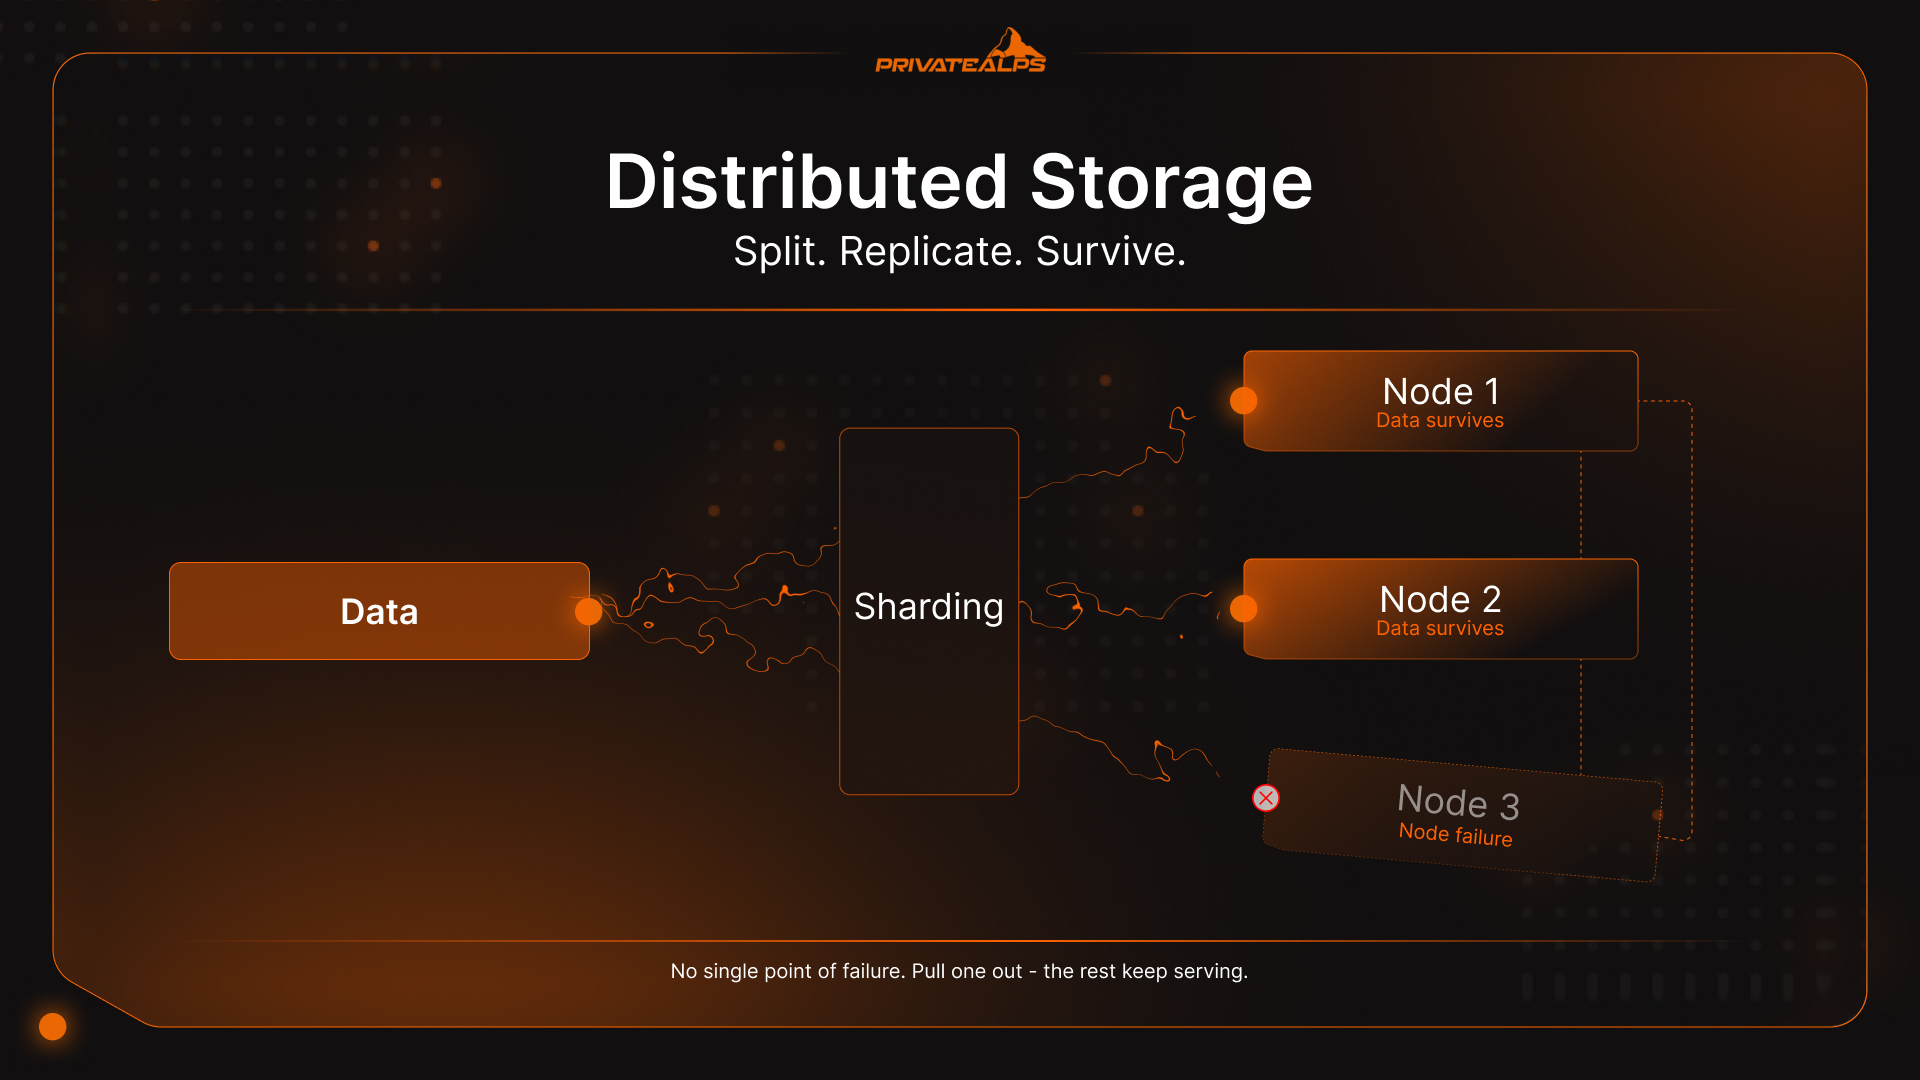
Lưu trữ phân tán là cách hạ tầng hiện đại xử lý dữ liệu quá lớn, quá quan trọng hoặc có lượng truy cập quá cao để một máy đơn lẻ có thể giữ an toàn. Thay vì ghi mọi thứ lên một máy chủ duy nhất, hệ thống sẽ chia, sao chép hoặc mã hóa dữ liệu rồi phân bổ lên nhiều node độc lập, bao gồm máy chủ, ổ đĩa và trung tâm dữ liệu. Các node này cùng hoạt động, nhưng không node nào giữ toàn bộ dữ liệu. Nếu rút ra một node, các node còn lại vẫn tiếp tục phục vụ. Bài viết này giải thích hệ thống lưu trữ phân tán thực sự vận hành ra sao khi chịu tải, những đánh đổi về kiến trúc mà chúng buộc phải chấp nhận, và loại lưu trữ nào phù hợp với từng khối lượng công việc.
Tóm tắt AI
Lưu trữ phân tán là một kiến trúc được định nghĩa bằng phần mềm, phân chia dữ liệu trên nhiều node vật lý dựa trên ba kỹ thuật cốt lõi: sharding (chia dữ liệu thành các phần rời rạc và định tuyến đến các node khác nhau), replication (giữ nhiều bản sao giống hệt nhau trên các node để truy cập nhanh) và erasure coding (mã hóa dữ liệu thành các mảnh có bit chẵn lẻ toán học, nhờ đó một tập con bất kỳ có thể khôi phục toàn bộ).
Có ba loại hệ thống lưu trữ phân tán chính: lưu trữ đối tượng (không gian tên phẳng, API tương thích S3), lưu trữ khối (volume kích thước cố định cho I/O ngẫu nhiên có độ trễ thấp) và lưu trữ tệp (không gian tên phân cấp qua NFS hoặc SMB). Mọi thiết lập lưu trữ dữ liệu phân tán đều phải đối mặt với định lý CAP: hệ thống chỉ có thể đảm bảo đồng thời hai trong ba tính chất gồm nhất quán, sẵn sàng và chịu được phân vùng mạng.
Lợi ích vận hành cốt lõi là lỗi của một node không gây ra gián đoạn dịch vụ. Hệ thống tự động chuyển các yêu cầu sang các bản sao còn hoạt động. Quy mô của bài toán rất lớn: mỗi ngày, nhân loại tạo ra hơn 400 triệu TB dữ liệu mới, một khối lượng mà không kiến trúc tập trung nào có thể gánh nổi mà không sớm sụp đổ dưới chính sức nặng của nó.
Lưu trữ phân tán và lưu trữ tập trung
Lưu trữ tập trung đặt mọi thứ ở một nơi: một máy chủ, một SAN, một trung tâm dữ liệu. Đó là toàn bộ mô hình. Khi nơi đó gặp sự cố, mọi thứ đều ngừng hoạt động. Lưu trữ phân tán giải quyết trực tiếp vấn đề này: dữ liệu nằm trên nhiều node độc lập, nên không có điểm lỗi đơn lẻ nào có thể đưa toàn bộ hệ thống ngoại tuyến hoặc chặn mọi quyền truy cập.
Chỉ một lỗi phần cứng là truy cập bị gián đoạn, dừng hẳn. Muốn mở rộng thì phải nâng cấp hoặc thay thế hệ thống chính, thường kéo theo thời gian ngừng hoạt động và một cuộc trao đổi về chi phí đầu tư mà không ai muốn có. Lưu trữ phân tán tránh cả hai vấn đề này ngay từ thiết kế: muốn tăng dung lượng thì thêm node, và khi một node hỏng, cụm sẽ tự định tuyến vòng qua nó. Không rắc rối, không gián đoạn. Dữ liệu đã được lưu trên nhiều node trước khi sự cố xảy ra.
| Tiêu chí | Lưu trữ tập trung | Lưu trữ phân tán |
|---|---|---|
| Khả năng chịu lỗi | Một điểm lỗi duy nhất | Dữ liệu vẫn tồn tại khi mất một node |
| Khả năng mở rộng | Theo chiều dọc (nâng cấp phần cứng) | Theo chiều ngang (thêm node) |
| Độ trễ | Thấp khi truy cập cục bộ | Thay đổi; phụ thuộc vào cấu trúc mạng |
| Chi phí ở quy mô nhỏ | Chi phí ban đầu thấp hơn | Cụm tối thiểu khả dụng có chi phí cao hơn |
| Chi phí ở quy mô lớn | Mở rộng tốn kém | Phần cứng phổ thông giúp giảm chi phí |
| Phân bố địa lý | Một vị trí duy nhất | Đa vùng theo cấu hình |
| Độ phức tạp vận hành | Dễ quản lý | Cần công cụ điều phối |
Hệ thống lưu trữ phân tán hoạt động như thế nào
Một hệ thống lưu trữ phân tán nhận dữ liệu đầu vào, chia thành các khối, định tuyến các khối đến đúng node trong cụm, và theo dõi từng phần thông qua lớp metadata. Nhờ vậy, bất kỳ mảnh dữ liệu nào cũng có thể được định vị, truy xuất và ghép lại khi cần, bất kể node nào đang giữ nó. Đó là vòng lặp cơ bản. Bốn cơ chế giúp hệ thống vận hành:
- Sharding (phân vùng dữ liệu) Khi dữ liệu được ghi vào, hệ thống cắt nó thành các mảnh nhỏ hơn (shard hoặc block) và phân tán chúng trên các node. Điều này mở ra khả năng I/O song song: nhiều node cùng xử lý đọc và ghi, nên thông lượng tăng theo quy mô cụm thay vì bị giới hạn bởi năng lực của một máy. Logic định tuyến thường dùng consistent hashing, giúp việc phân bổ luôn đều khi cụm mở rộng mà không phải xáo trộn lại toàn bộ mỗi khi thêm một node.
- Replication (sao chép) Cách tiếp cận đơn giản nhưng hiệu quả: lưu N bản sao giống hệt nhau của mỗi shard trên các node riêng biệt, thường là ba bản. Khi một node ngừng hoạt động, hai node còn lại tiếp tục phục vụ ngay lập tức. Không cần tái tạo, không cần chờ đợi. Replication là lựa chọn đúng cho dữ liệu nóng, như cơ sở dữ liệu đang hoạt động, luồng dữ liệu thời gian thực, và bất kỳ thứ gì mà thêm một phần nghìn giây cho mỗi lần đọc cũng thực sự gây tốn kém.
- Erasure Coding (mã hóa xóa) Đây là nơi phép tính hiệu quả lưu trữ trở nên thú vị. Thay vì ba bản sao đầy đủ, hệ thống mã hóa một đối tượng thành $k$ mảnh dữ liệu cộng với $m$ mảnh chẵn lẻ, phân bổ tất cả $k+m$ mảnh trên các node, và có thể khôi phục toàn bộ đối tượng từ bất kỳ $k$ mảnh nào trong số đó. Vì vậy, $m$ node có thể hỏng cùng lúc mà không mất dữ liệu nào. Cấu hình Reed-Solomon RS(6,3) lưu 9 block thay vì 18 block mà 3x replication yêu cầu, giảm chi phí lưu trữ thô từ 200% xuống khoảng 50%. Điểm bất lợi là quá trình mã hóa và giải mã tiêu tốn chu kỳ CPU, và erasure coding hoạt động tốt hơn với dữ liệu nguội, tức nội dung ít khi được sửa đổi hoặc truy cập với tần suất cao. Với khối lượng công việc có nhiều lần ghi nhỏ, thường xuyên, 3x replication vẫn có độ trễ tốt hơn.
| Phương pháp bảo vệ | Chi phí lưu trữ | Phù hợp nhất | Đánh đổi |
|---|---|---|---|
| 3x Replication | 3x dung lượng thô | Dữ liệu nóng, khối lượng công việc độ trễ thấp | Chi phí lưu trữ cao khi mở rộng |
| Erasure Coding RS(6,3) | 1,5x dung lượng thô | Dữ liệu nguội, lưu trữ lâu dài, đối tượng lớn | Tốn CPU, độ trễ khôi phục cao hơn |
- Định tuyến metadata Mọi hệ thống lưu trữ phân tán đều duy trì một lớp metadata, về cơ bản là một bản đồ cho biết shard nào nằm ở node nào. Khi một client yêu cầu dữ liệu, dịch vụ metadata xác định đúng các node, và hệ thống truy xuất rồi ghép các mảnh lại mà client không hề thấy sự phức tạp bên dưới. Trong các cụm quy mô lớn như Ceph hoặc HDFS, chính lớp metadata cũng được phân tán trên nhiều node. Điều này là bắt buộc. Một máy chủ metadata duy nhất sẽ trở thành nút thắt cổ chai mà bạn đang cố gắng thoát khỏi.
Các loại hệ thống lưu trữ phân tán
Lưu trữ phân tán không phải là một thứ duy nhất. Đó là một danh mục gồm ba mô hình dữ liệu khác nhau, và việc chọn sai mô hình cho một khối lượng công việc là một lỗi phổ biến đến bất ngờ và tốn kém. Lưu trữ đối tượng, lưu trữ khối và lưu trữ tệp mỗi loại giải quyết một bài toán khác nhau. Cơ sở dữ liệu phân tán như Cassandra, CockroachDB và Google Spanner đại diện cho loại thứ tư, khi xây thêm ngữ nghĩa truy vấn lên trên quản lý dữ liệu phân tán, nhưng đó là một chủ đề riêng.
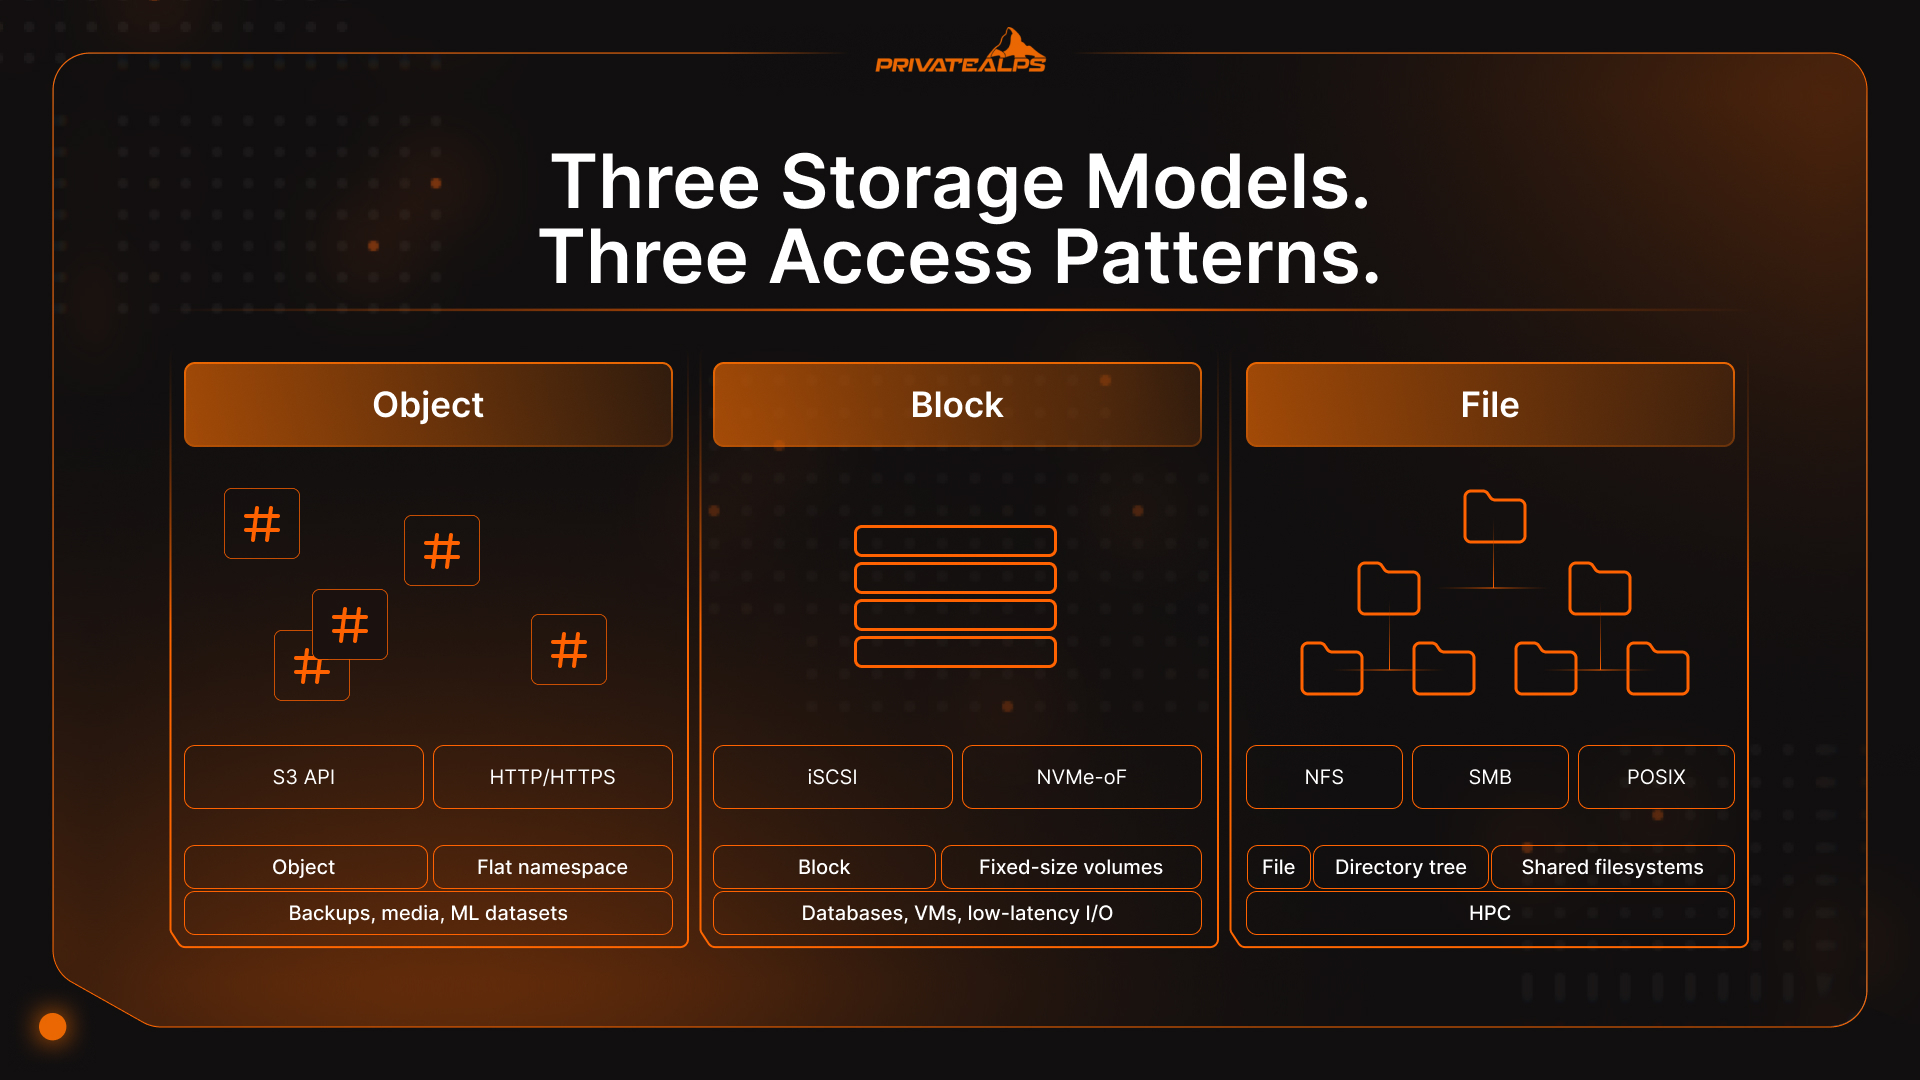
| Loại | Cách lưu dữ liệu | Phương thức truy cập | Phù hợp nhất | Ví dụ |
|---|---|---|---|---|
| Đối tượng | Không gian tên phẳng, đối tượng giàu metadata | API tương thích S3 (HTTP/HTTPS) | Dữ liệu phi cấu trúc quy mô lớn: sao lưu, media, tập dữ liệu ML | AWS S3, MinIO, Ceph RADOS |
| Khối | Volume thô kích thước cố định | iSCSI, NVMe-oF, FC | Cơ sở dữ liệu, máy ảo, I/O ngẫu nhiên độ trễ thấp | Ceph RBD, AWS EBS, Lightbits |
| Tệp | Cây thư mục phân cấp | NFS, SMB, POSIX | Hệ thống tệp dùng chung, HPC, thư mục home | GlusterFS, HDFS, Azure Files |
Lưu trữ đối tượng phân tán
Lưu trữ đối tượng phân tán tổ chức dữ liệu thành các đối tượng riêng lẻ, bất biến, nằm trong một không gian tên phẳng, không có thư mục, không có đường dẫn tệp và không có cấu trúc phân cấp nào cần duy trì. Mỗi đối tượng có một định danh duy nhất (hash hoặc UUID) cùng metadata phong phú, và bạn truy cập qua API tương thích S3 qua HTTP. Vì các đối tượng được thay thế chứ không được cập nhật một phần, bài toán khóa vốn hạn chế hiệu năng và giới hạn khả năng mở rộng trong hệ thống khối và hệ thống tệp đơn giản biến mất. Đó là cách AWS S3, Azure Blob và Ceph mở rộng tới exabyte: không có chi phí phối hợp không gian tên, không có tranh chấp khóa, và bất kỳ node nào trong cụm cũng có thể phục vụ bất kỳ yêu cầu đối tượng nào một cách độc lập.
Lưu trữ khối phân tán
Lưu trữ khối cấp các volume thô cho máy chủ: các khối kích thước cố định với địa chỉ riêng, không có lớp trừu tượng hệ thống tệp phía trên. Ứng dụng ghi trực tiếp vào các khối, và đó là điều mang lại I/O ngẫu nhiên độ trễ thấp, ổn định cho cơ sở dữ liệu, ổ đĩa máy ảo và các khối lượng công việc container hóa. Một hạn chế về kiến trúc thường khiến người dùng bất ngờ: một volume khối thường chỉ có thể được gắn vào một máy chủ tại một thời điểm. Để nhiều máy chủ cùng truy cập chung, cần thêm lớp điều phối, chẳng hạn một hệ thống tệp cụm xếp trên các thiết bị khối.
Lưu trữ tệp phân tán
Lưu trữ tệp cung cấp một hệ thống tệp dùng chung qua các giao thức chuẩn, như NFS, SMB và truy cập tương thích POSIX. Nhiều client có thể gắn cùng một volume đồng thời, nên đây là lựa chọn tự nhiên cho khối lượng công việc cộng tác, môi trường HPC và các ứng dụng cũ vẫn cần cây thư mục và chưa được viết lại trong thời gian tới. Đánh đổi thực tế là: duy trì một không gian tên thư mục nhất quán trên các node phân tán tạo ra chi phí phối hợp tăng dần khi quy mô lớn. Hầu hết các nhà cung cấp hyperscale cuối cùng cũng chuyển dữ liệu chính từ lưu trữ tệp phân tán sang lưu trữ đối tượng phân tán khi khối lượng đủ lớn.
Định lý CAP: đánh đổi không thể tránh trong lưu trữ phân tán
Định lý CAP nói rằng một hệ thống dữ liệu phân tán chỉ có thể đảm bảo cùng lúc hai trong ba tính chất: Nhất quán (mọi lần đọc đều trả về lần ghi mới nhất), Sẵn sàng (mọi yêu cầu đều nhận được phản hồi) và Chịu được phân vùng (hệ thống tiếp tục hoạt động khi mạng bị chia cắt). Mạng thì luôn có lúc bị chia cắt, nên khả năng chịu phân vùng không phải là thứ có thể bỏ qua. Quyết định thực sự luôn là giữa nhất quán và sẵn sàng khi sự cố xảy ra.
[Eric Brewer đưa ra CAP năm 2000; Gilbert và Lynch chính thức hóa chứng minh vào năm 2002][https://www.scylladb.com/glossary/cap-theorem/]. Đây vẫn là quyết định định hình mọi thứ khác trong kiến trúc lưu trữ phân tán, vì nó quyết định cách hệ thống hành xử đúng vào thời điểm bạn cần nó nhất, khi có thứ gì đó đã bị hỏng.
| Hệ thống | Loại CAP | Hành vi khi phân vùng | Phù hợp nhất |
|---|---|---|---|
| MongoDB | CP (với read/write concern đa số) | Từ chối yêu cầu cho đến khi nhất quán được khôi phục | Hồ sơ tài chính, tồn kho, đặt chỗ |
| HBase | CP | Trả về lỗi thay vì dữ liệu cũ | Phân tích có cấu trúc, batch job nhất quán |
| Apache Cassandra | AP | Vẫn sẵn sàng; có thể trả về dữ liệu cũ | Nguồn cấp tin xã hội, nhắn tin, telemetry IoT |
| DynamoDB (mặc định) | AP | Luôn phản hồi; đối soát bất nhất theo kiểu bất đồng bộ | Ứng dụng người dùng có thông lượng cao |
| CockroachDB | CP | Ưu tiên nhất quán, SQL phân tán | Khối lượng công việc giao dịch toàn cầu |
Cách quyết định trong thực tế: khối lượng công việc của bạn có chịu được lần đọc dữ liệu cũ không? Số dư tài khoản ngân hàng, việc giữ chỗ, số lượng tồn kho thì gần như chắc chắn là không. Hãy chọn CP. Nguồn cấp tin xã hội, luồng sự kiện cảm biến, telemetry phân tích thì chậm vài giây vẫn ổn. Hãy chọn AP và giữ cam kết về tính sẵn sàng.
Bảo mật lưu trữ phân tán: mã hóa và chủ quyền dữ liệu
Bảo mật trong lưu trữ phân tán gồm ba lớp riêng biệt: dữ liệu khi lưu trữ (data at rest), dữ liệu khi truyền đi (data in transit) và quyền sở hữu khóa. Chỉ cần sai ở một lớp là hai lớp còn lại cũng không còn tác dụng bảo vệ. Hạ tầng có thể hoạt động ổn định hoàn toàn, nhưng dữ liệu nhạy cảm vẫn có thể bị người không liên quan truy cập mà không ai hay biết.
Mã hóa phải bao phủ cả ba lớp. Dữ liệu khi lưu trữ thường dùng AES-256, với khóa do nhà cung cấp quản lý hoặc khóa do khách hàng quản lý (CMK). Cách nhà cung cấp quản lý khóa đơn giản hơn khi vận hành, nhưng nhà cung cấp lưu trữ nắm giữ vật liệu khóa, và đây là điểm bảo mật quan trọng với các ngành bị quản lý chặt và phải qua kiểm toán. Mã hóa phía client loại bỏ hoàn toàn rủi ro này: dữ liệu được mã hóa trước khi rời khỏi máy khách, nên nhà cung cấp không bao giờ tiếp cận được dữ liệu gốc, bất kể có yêu cầu pháp lý nào. Với dữ liệu khi truyền đi, TLS 1.3 là mức bảo mật tối thiểu. Hệ thống nào vẫn cho phép TLS 1.2 thì theo phần lớn khung tuân thủ hiện nay phải có văn bản ngoại lệ được ghi rõ.
Chủ quyền dữ liệu thường khiến các đội kỹ thuật bất ngờ. Dữ liệu chịu sự điều chỉnh của luật pháp nơi nó thực sự được lưu trữ, chứ không phải theo quốc gia của công ty hay vị trí của người dùng. Thụy Sĩ được GDPR Article 45 công nhận mức bảo vệ tương đương, nên việc chuyển dữ liệu từ EU sang Thụy Sĩ không cần thêm biện pháp bảo vệ theo hợp đồng. Đạo luật Bảo vệ Dữ liệu Liên bang (nFADP) sửa đổi đã đồng bộ các quy định trong nước của Thụy Sĩ với GDPR, nghĩa là hạ tầng đặt tại Thụy Sĩ đáp ứng đồng thời nhất quán cả hai khung pháp lý.
Có một việc dễ trì hoãn nhưng không nên như vậy: các thuật toán mật mã bảo vệ phần lớn hạ tầng lưu trữ hiện nay không được thiết kế để chống lại máy tính lượng tử đủ mạnh. NIST đã ban hành ba tiêu chuẩn mật mã hậu lượng tử vào tháng 8 năm 2024, trong đó có FIPS 203 (ML-KEM). Nếu hệ thống lưu trữ dữ liệu phân tán của bạn giữ các bản ghi cần lưu giữ lâu dài, như hồ sơ y tế, hồ sơ tài chính hay tài liệu pháp lý, thì mô hình đe dọa “thu thập bây giờ, giải mã sau” đã hiện hữu. Kế hoạch đánh giá nên bắt đầu sớm, trước khi các kho lưu trữ này đến giai đoạn cần bảo vệ nghiêm ngặt nhất.
Những ưu điểm chính của lưu trữ phân tán
- Chịu lỗi mà không gián đoạn dịch vụ: Khi một node gặp sự cố, hệ thống phát hiện qua cơ chế heartbeat và tự động chuyển hướng yêu cầu sang các bản sao còn hoạt động. Không cần can thiệp thủ công, cũng không cần khung giờ bảo trì.
- Mở rộng theo chiều ngang: Muốn tăng dung lượng lưu trữ chỉ cần thêm node vào cụm. Dữ liệu tự cân bằng lại ở nền mà không ảnh hưởng đến lưu lượng đang chạy và không cần ngừng hoạt động.
- Phân tán theo địa lý: Nhân bản dữ liệu qua nhiều khu vực giúp giảm độ trễ cho người dùng ở các nơi khác nhau, đồng thời biến việc tuân thủ quy định về vị trí lưu trữ dữ liệu thành một quyết định cấu hình, thay vì một dự án hạ tầng riêng.
- Thông lượng I/O song song: Nhiều node cùng xử lý đọc và ghi dữ liệu. Đây là kiến trúc có khả năng mở rộng duy nhất cho các pipeline huấn luyện AI/ML, mã hóa lại video hay phát trực tuyến nội dung đa phương tiện ở quy mô sản xuất thực tế.
- Không bị phụ thuộc nhà cung cấp nhờ giao thức mở: Các API tương thích S3, NFS và nền tảng mã nguồn mở như Ceph cho phép đội kỹ thuật chuyển đổi giữa các nhà cung cấp hoặc vận hành hạ tầng tại chỗ mà không phải viết lại mã ứng dụng.
- Hiệu quả chi phí khi quy mô lớn: Phần cứng phổ thông thay thế các mảng lưu trữ độc quyền đắt đỏ. Erasure coding còn giảm yêu cầu dung lượng thô tới 50% so với việc nhân bản đầy đủ trên các node.
Hạn chế và thách thức của lưu trữ phân tán
- Độ phức tạp về tính nhất quán: Giữ trạng thái dữ liệu nhất quán giữa các node đòi hỏi tinh chỉnh cẩn thận mô hình nhất quán, hệ số nhân bản và cài đặt quorum. Cấu hình sai không báo lỗi rõ ràng mà âm thầm làm dữ liệu lệch nhau.
- Chi phí vận hành: Vận hành cụm lưu trữ phân tán đồng nghĩa với việc phải lo lập kế hoạch miền lỗi, quy trình thay thế node, hệ thống giám sát và tinh chỉnh hiệu năng. Một máy chủ đơn lẻ không đòi hỏi bạn làm tất cả những việc này.
- Phụ thuộc vào mạng: Toàn bộ kiến trúc giả định các node kết nối với nhau ổn định và có băng thông cao. Khi mạng suy giảm, độ trễ và thông lượng lưu trữ cũng giảm trực tiếp và tương ứng.
- Độ trễ với I/O ngẫu nhiên nhỏ: Lưu trữ phân tán được tối ưu cho việc đọc tuần tự khối lớn và xử lý song song. Các khối lượng công việc có nhiều I/O ngẫu nhiên nhỏ, đặc biệt là cơ sở dữ liệu OLTP, thường chạy tốt hơn trên NVMe gắn trực tiếp vào máy.
- Quy mô tối thiểu hợp lý: Lợi thế về chi phí và sự đơn giản của lưu trữ phân tán không thể hiện rõ trên cụm hai node. Dưới một ngưỡng nhất định, dịch vụ lưu trữ đám mây được quản lý hoặc một máy chủ đơn được cấu hình tốt sẽ rẻ hơn và dễ vận hành hơn.
Các trường hợp sử dụng thực tế của lưu trữ phân tán
- Truyền thông và phát trực tuyến: Netflix và YouTube không phát video từ một vị trí trung tâm. Họ phân phối nội dung đã mã hóa qua các cụm lưu trữ đối tượng đặt gần người xem về mặt địa lý. Một trung tâm dữ liệu đơn lẻ không thể đáp ứng đồng thời lượng lớn luồng phát toàn cầu, riêng chi phí băng thông đã quá cao. Lưu trữ dữ liệu phân tán là yếu tố giúp mô hình kinh tế của phát trực tuyến thực sự khả thi.
- Y tế: Một lần chụp MRI tạo ra 500 MB đến 1 GB dữ liệu hình ảnh. Nhân con số này lên trên một mạng lưới bệnh viện lớn, với nhiều loại thiết bị chụp, yêu cầu lưu giữ lâu dài và nhiều cơ sở khác nhau, lượng dữ liệu sẽ tích lũy rất nhanh lên đến hàng petabyte. Lưu trữ phân tán có khả năng mở rộng kết hợp dự phòng theo địa lý là cách các hệ thống y tế duy trì quyền truy cập hồ sơ bệnh nhân tuân thủ HIPAA, ngay cả khi một trung tâm dữ liệu khu vực gặp sự cố.
- AI và học máy: Huấn luyện một mô hình ngôn ngữ lớn cần cung cấp cho các cụm GPU từ terabyte đến petabyte dữ liệu, truy cập theo kiểu không tuần tự, điều mà một hệ thống lưu trữ truyền thống sẽ nhanh chóng quá tải. Ceph, HDFS và các kho lưu trữ đối tượng tương thích S3 đã trở thành lớp hạ tầng tiêu chuẩn cho pipeline ML, vì thông lượng đọc song song của chúng thực sự đáp ứng được nhu cầu của cụm GPU.
- Sao lưu và khôi phục sau thảm họa: Khôi phục sau thảm họa thực sự nghĩa là dữ liệu tồn tại ở ít nhất hai địa điểm cách xa nhau về mặt địa lý, với các miền lỗi độc lập, chứ không phải hai giá máy trong cùng một tòa nhà. Chính sách nhân bản và quy tắc đặt dữ liệu được tích hợp trực tiếp vào lớp lưu trữ phân tán sẽ xác định RPO và RTO ở cấp độ hạ tầng, mà không cần một ngăn xếp phần mềm sao lưu riêng. Ít thành phần chuyển động hơn cũng đồng nghĩa với bề mặt tấn công nhỏ hơn.
Lưu trữ phân tán và lưu trữ phi tập trung: khác nhau ở đâu?
Lưu trữ phân tán nghĩa là dữ liệu được trải ra trên nhiều node, nhưng vẫn chỉ một tổ chức sở hữu và kiểm soát toàn bộ hệ thống, bao gồm chính sách, quyền truy cập, khả năng xóa và nhật ký kiểm toán. Lưu trữ phi tập trung loại bỏ hoàn toàn thẩm quyền trung tâm đó. Dữ liệu nằm trên các peer độc lập, và không một bên vận hành nào có thể tự ý kiểm duyệt, truy cập hay xóa.
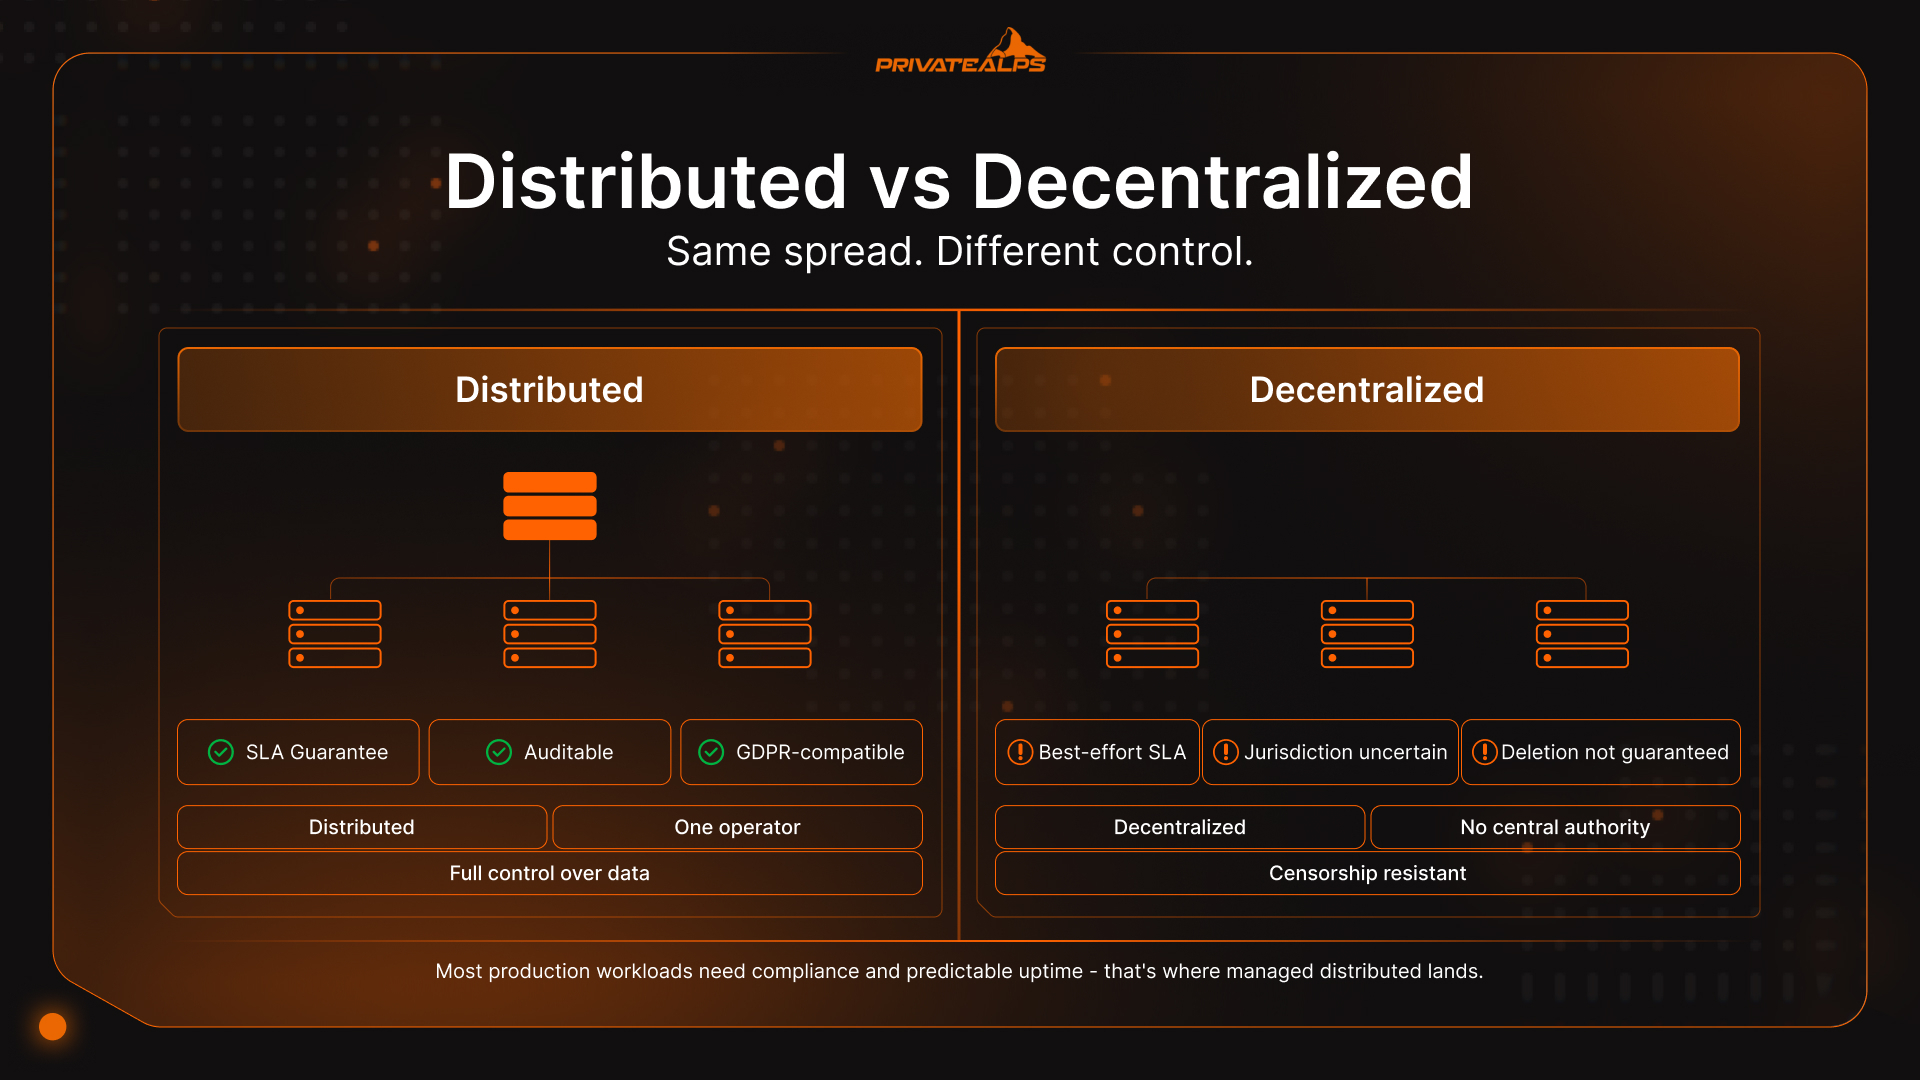
Sự khác biệt này có hệ quả vận hành thực tế. Một hệ thống phân tán được quản lý tập trung có thể được kiểm toán, vá lỗi, đảm bảo SLA và đưa vào tuân thủ quy định. Hệ thống phi tập trung đánh đổi tất cả những điều đó để lấy khả năng chống kiểm duyệt và hoạt động không cần tin cậy bên thứ ba. Cách đánh đổi này có giá trị trong một số bối cảnh cụ thể, nhưng không phải thứ mà phần lớn doanh nghiệp vận hành hạ tầng lưu trữ sản xuất cần.
| Tiêu chí | Lưu trữ phân tán | Lưu trữ phi tập trung |
|---|---|---|
| Quyền kiểm soát | Quản lý tập trung | Không có thẩm quyền trung tâm |
| SLA / cam kết uptime | Có thể cam kết bằng hợp đồng | Nỗ lực tối đa, phụ thuộc giao thức |
| Tuân thủ quy định | Có thể kiểm toán, tương thích GDPR | Không rõ thẩm quyền pháp lý |
| Xóa dữ liệu | Được đảm bảo | Không phải lúc nào cũng thực hiện được |
| Kiểm soát truy cập | Dựa trên vai trò, được quản lý | Mật mã học, không cần tin cậy |
| Ví dụ | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Còn một lớp nữa cần phân biệt: lưu trữ đám mây đa vùng, chẳng hạn AWS S3 với sao chép chéo vùng hay Azure geo-redundant storage, vẫn là hạ tầng quản lý tập trung. Nhà cung cấp quản lý các node và việc nhân bản; về thực chất bạn đang thuê vị trí địa lý. Các nền tảng đám mây phân tán thực sự như Storj hay Cubbit định tuyến dữ liệu qua các nhà vận hành độc lập, loại bỏ sự phụ thuộc vào một nhà cung cấp, nhưng lại đặt ra các câu hỏi về SLA và nhật ký kiểm toán. Với hầu hết khối lượng công việc cần tài liệu tuân thủ và uptime ổn định, cách tiếp cận phân tán được quản lý là lựa chọn phù hợp nhất.
Tóm tắt
Lưu trữ phân tán không phải là một sản phẩm cụ thể mà là một nhóm kiến trúc, và lựa chọn phù hợp phụ thuộc hoàn toàn vào những gì bạn đang vận hành. Lưu trữ đối tượng, lưu trữ khối và lưu trữ tệp mỗi loại có mô hình dữ liệu được thiết kế cho các kiểu truy cập và đặc thù khối lượng công việc khác nhau. Định lý CAP buộc bạn phải đánh đổi thực sự giữa tính nhất quán và tính sẵn sàng ngay khi xảy ra lỗi mạng. Nếu chọn sai, cái giá có thể rất đắt. Còn khi phải quyết định giữa nhân bản và erasure coding, yếu tố quyết định là mức độ “nóng” của dữ liệu: dữ liệu nóng cần nhân bản để đảm bảo độ trễ thấp, còn dữ liệu nguội hưởng lợi từ hiệu quả lưu trữ của erasure coding. Với hầu hết đội kỹ thuật, một giải pháp phân tán được quản lý, từ nhà cung cấp riêng hoặc đám mây công cộng, miễn là có thể xác minh được vị trí lưu trữ và các biện pháp bảo mật, sẽ mang lại sự cân bằng tốt hơn giữa khả năng mở rộng, hiệu năng và sự đơn giản khi vận hành hàng ngày so với một cụm tự triển khai.
Lưu trữ dữ liệu tại Thụy Sĩ cùng PrivateAlps
Nếu khối lượng công việc của bạn cần lưu trữ đối tượng phân tán tương thích S3 với vị trí dữ liệu có thể xác minh, PrivateAlps vận hành hạ tầng đặt tại Thụy Sĩ, tuân thủ đầy đủ cả GDPR Article 45 và nFADP. Dữ liệu của bạn ở lại Thụy Sĩ, không chia sẻ cho bên thứ ba, không định tuyến mơ hồ qua các khu vực pháp lý nước ngoài và không có bất ngờ nào. Dù bạn đang chuyển khỏi một nhà cung cấp đám mây lớn hay xây dựng kiến trúc lưu trữ phân tán ưu tiên quyền riêng tư từ đầu, PrivateAlps mang lại hiệu năng và sự chắc chắn về tuân thủ mà khối lượng công việc của bạn thực sự cần.
FAQ
Sự khác biệt giữa lưu trữ phân tán và lưu trữ đám mây là gì?
Lưu trữ đám mây là một mô hình cung cấp dịch vụ: một bên khác quản lý hạ tầng, còn bạn truy cập qua internet và trả tiền theo mức sử dụng. Lưu trữ phân tán là một kiến trúc: dữ liệu được trải trên nhiều node để đảm bảo dự phòng và khả năng mở rộng. Hai khái niệm này độc lập với nhau. Bạn có thể triển khai lưu trữ phân tán hoàn toàn tại chỗ với Ceph hoặc MinIO, và một nhà cung cấp đám mây về mặt kỹ thuật vẫn có thể cung cấp lưu trữ tập trung phía sau một API. Phần lớn dịch vụ lưu trữ đám mây dùng kiến trúc phân tán bên trong, nhưng đó chỉ là chi tiết triển khai, không phải định nghĩa của lưu trữ đám mây.
Hệ thống lưu trữ phân tán nào tốt nhất?
Không có đáp án chung cho tất cả. Câu trả lời phụ thuộc vào khối lượng công việc và mô hình dữ liệu. Với dữ liệu phi cấu trúc và sao lưu, các kho lưu trữ đối tượng tương thích S3 như MinIO hoặc Ceph RADOS là lựa chọn tiêu chuẩn. Với volume cơ sở dữ liệu và ổ đĩa máy ảo cần I/O khối nhất quán và độ trễ thấp, Ceph RBD hoặc Lightbits phù hợp hơn. Với hệ thống tệp dùng chung trong HPC hoặc môi trường cũ, GlusterFS hoặc HDFS thường là lựa chọn của đa số đội kỹ thuật. Hãy bắt đầu từ kiểu truy cập, rồi hệ thống lưu trữ sẽ được chọn từ đó.
Lưu trữ phân tán có giống RAID không?
Không. RAID hoạt động trong phạm vi một máy chủ hoặc một mảng lưu trữ, bảo vệ chống lại lỗi ổ đĩa bên trong một máy. Lưu trữ phân tán hoạt động trên nhiều máy vật lý riêng biệt kết nối qua mạng, có thể trải dài qua nhiều tòa nhà hoặc cả trung tâm dữ liệu. RAID không giúp được gì khi chính máy chủ bị hỏng. Hệ thống lưu trữ phân tán được thiết kế riêng để chịu được lỗi node, lỗi rack và sự cố toàn bộ trung tâm dữ liệu. Sự khác biệt về phạm vi này mang tính nền tảng.
Hệ thống lưu trữ phân tán xử lý lỗi node như thế nào?
Các node gửi tín hiệu heartbeat định kỳ tới tầng metadata của cụm. Khi một node ngừng phản hồi, hệ thống phát hiện lỗi, thường trong vài giây, rồi chuyển hướng yêu cầu sang các node đang giữ bản sao hoặc các mảnh erasure-coded. Với cấu hình dựa trên nhân bản, một tiến trình khôi phục chạy nền sẽ tạo bản sao mới để khôi phục hệ số nhân bản đã cấu hình trên toàn cụm. Toàn bộ quá trình diễn ra tự động. Trong một cụm lưu trữ phân tán được cấu hình tốt, ứng dụng hầu như không nhận thấy sự cố xảy ra.
Lưu trữ phân tán có phù hợp với doanh nghiệp nhỏ không?
Có. Các dịch vụ lưu trữ phân tán được quản lý, như lưu trữ đối tượng tương thích S3 từ nhà cung cấp đám mây hoặc đơn vị chuyên biệt như PrivateAlps, hoạt động ở mọi quy mô và không yêu cầu cụm tối thiểu. Cụm lưu trữ phân tán tự triển khai thì khác: để vận hành Ceph hiệu quả, thường cần từ ba đến năm node trước khi chi phí vận hành bắt đầu được bù đắp. Với các đội nhỏ, dịch vụ được quản lý mang lại đầy đủ lợi ích kiến trúc của lưu trữ phân tán mà không phải gánh gánh nặng quản lý hạ tầng.
