


Was ist verteilter Speicher?
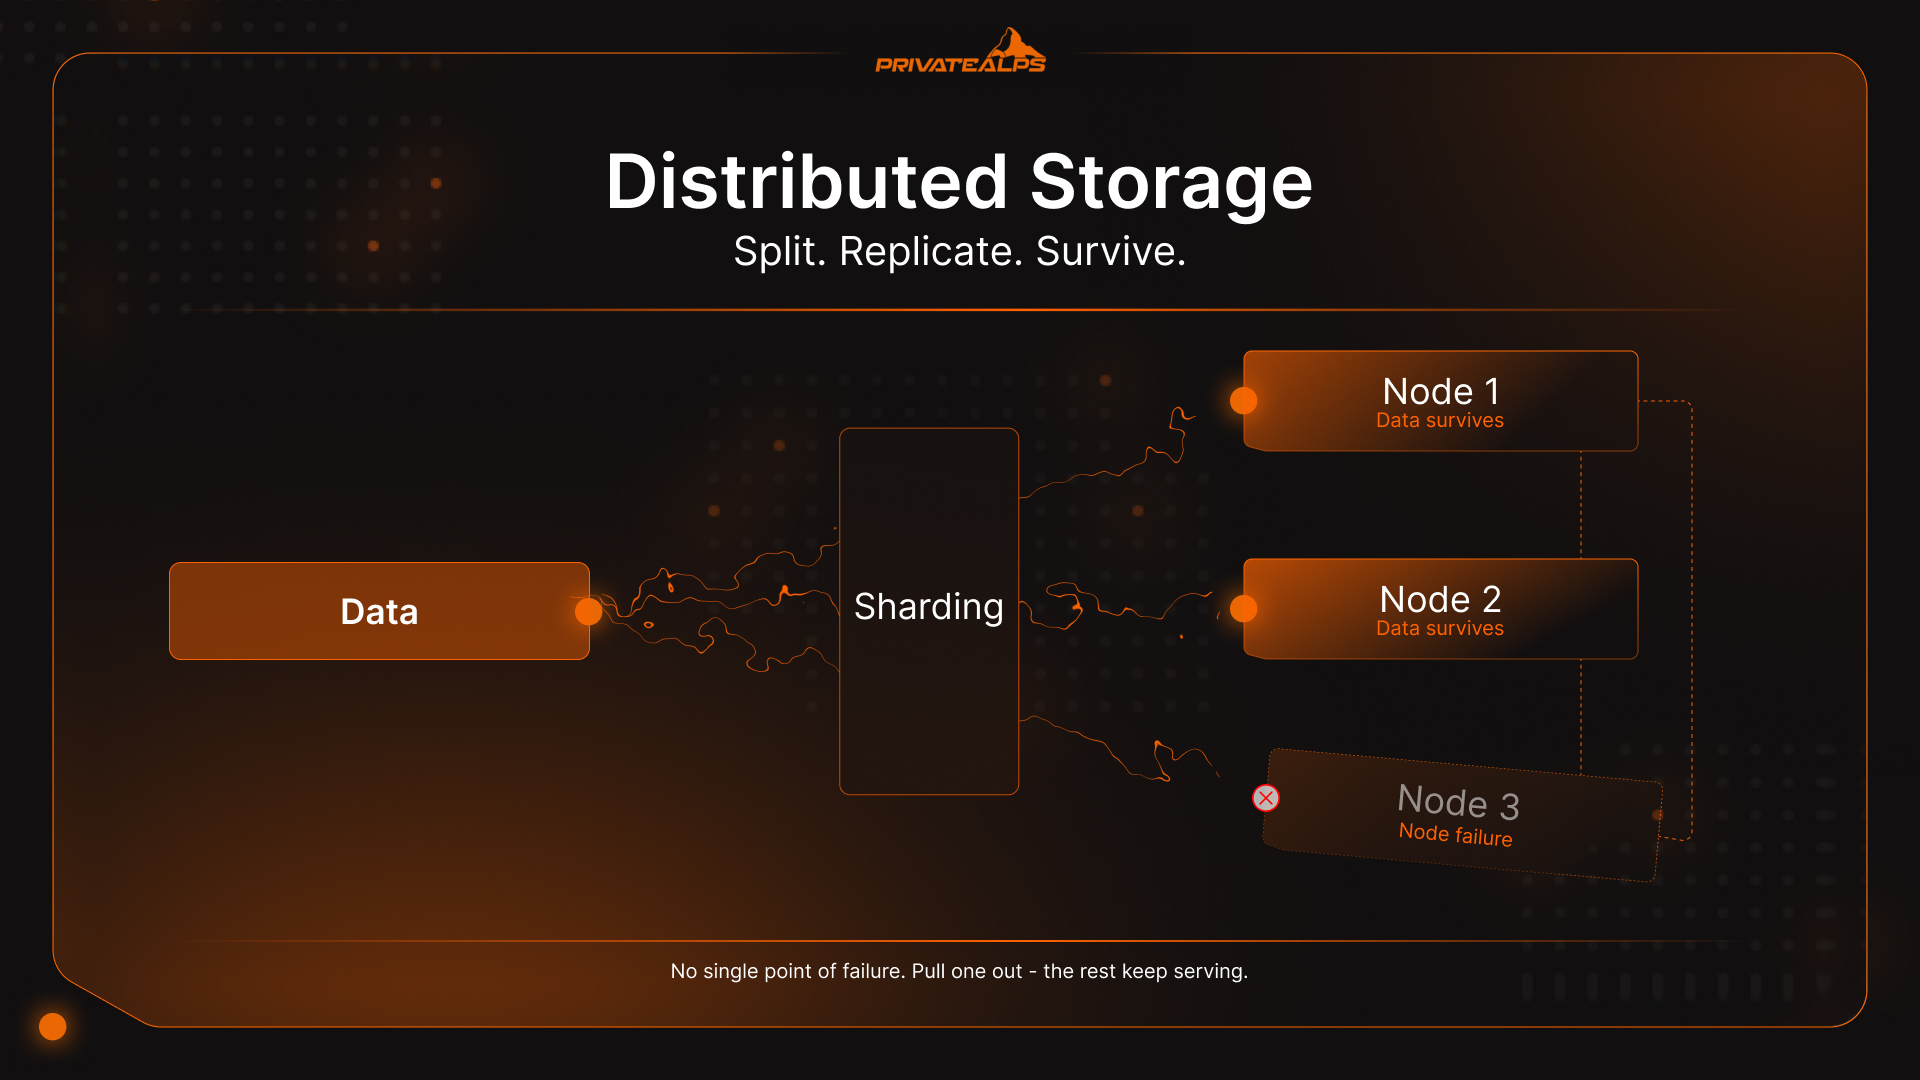
Verteilter Speicher ist die Art, wie moderne Infrastruktur Daten verwaltet, die für einen einzelnen Rechner zu groß, zu kritisch oder zu stark frequentiert sind, um sie zuverlässig zu speichern. Anstatt alles auf einen einzigen Server zu schreiben, teilt das System die Daten auf, repliziert sie oder kodiert sie und verteilt sie auf mehrere unabhängige Knoten: Server, Laufwerke, Rechenzentren. Diese arbeiten gemeinsam, doch kein einzelner Knoten hält alles. Fällt einer aus, liefern die übrigen weiterhin Daten. Dieser Leitfaden zeigt, wie sich verteilte Speichersysteme unter Last tatsächlich verhalten, welche architektonischen Kompromisse sie erzwingen und welcher Speichertyp zu welcher Arbeitslast passt.
KI-Zusammenfassung
Verteilter Speicher ist eine softwaredefinierte Architektur, die Daten über mehrere physische Knoten verteilt. Dabei kommen drei Kerntechniken zum Einsatz: Sharding (Daten werden in einzelne Teile zerlegt, die an verschiedene Knoten geleitet werden), Replikation (identische Kopien werden auf mehreren Knoten gehalten, um schnellen Zugriff zu ermöglichen) und Erasure Coding (Daten werden in Fragmente mit mathematischer Paritätsinformation kodiert, sodass jede ausreichende Teilmenge das Ganze rekonstruieren kann).
Es gibt drei Haupttypen verteilter Speichersysteme: Object Storage (flacher Namensraum, S3-kompatible API), Block Storage (Volumes fester Größe für latenzarmen zufälligen I/O) und File Storage (hierarchischer Namensraum über NFS oder SMB). Jedes verteilte Datenspeichersystem stößt auf das CAP-Theorem: Es kann nur zwei der drei Eigenschaften Konsistenz, Verfügbarkeit und Partitionstoleranz gleichzeitig garantieren.
Der zentrale betriebliche Vorteil: Der Ausfall eines Knotens führt nicht zu einem Ausfall des Dienstes. Das System leitet Anfragen automatisch an verbleibende Replikate weiter.
Was auf dem Spiel steht, zeigt die Menge: Die Menschheit erzeugt jeden Tag über 400 Millionen Terabyte neue Daten. Keine zentralisierte Architektur kann dieses Volumen auf Dauer aufnehmen, ohne unter der eigenen Last zusammenzubrechen.
Verteilter Speicher vs. zentraler Speicher
Zentraler Speicher bündelt alles an einem Ort: einem Server, einem SAN, einem Rechenzentrum. Mehr steckt im Grundprinzip nicht. Tritt an dieser Stelle ein Problem auf, steht alles still. Verteilter Speicher setzt genau hier an: Die Daten liegen auf mehreren unabhängigen Knoten, sodass kein einzelner Ausfallpunkt das gesamte System lahmlegen oder den Zugriff vollständig blockieren kann.
Fällt eine Hardwarekomponente aus, endet der Zugriff. Punkt. Skalierung bedeutet, das primäre System aufzurüsten oder zu ersetzen, was meist Ausfallzeiten und eine Investitionsentscheidung nach sich zieht, über die niemand gern spricht. Verteilter Speicher umgeht beides bereits im Design: Um zu wachsen, fügen Sie einen Knoten hinzu. Fällt ein Knoten aus, leitet der Cluster den Verkehr um. Ohne Aufsehen und ohne Ausfall. Die Daten lagen schon vor dem Fehler auf mehreren Knoten.
| Dimension | Zentraler Speicher | Verteilter Speicher |
|---|---|---|
| Fehlertoleranz | Single Point of Failure | Daten überleben den Verlust einzelner Knoten |
| Skalierbarkeit | Vertikal (Hardware aufrüsten) | Horizontal (Knoten hinzufügen) |
| Latenz | Gering bei lokalem Zugriff | Variabel; abhängig von der Netzwerktopologie |
| Kosten im kleinen Maßstab | Geringere Anfangsinvestition | Höheres minimales Cluster |
| Kosten im großen Maßstab | Teure Skalierung | Standardhardware senkt die Kosten |
| Geografische Verteilung | Ein Standort | Mehrere Regionen durch Konfiguration |
| Betriebliche Komplexität | Einfach zu verwalten | Erfordert Orchestrierungswerkzeuge |
So funktionieren verteilte Speichersysteme
Ein verteiltes Speichersystem nimmt eingehende Daten entgegen, zerlegt sie in Blöcke, leitet diese an die richtigen Knoten im Cluster weiter und erfasst jedes Teil über eine Metadatenschicht. So lässt sich jedes Fragment finden, abrufen und bei Bedarf wieder zusammensetzen, unabhängig davon, auf welchem Knoten es liegt. Das ist die Grundlogik. Vier Mechanismen tragen sie:
- Sharding (Datenpartitionierung) Sobald Daten eingehen, zerteilt das System sie in kleinere Stücke, sogenannte Shards oder Blöcke, und verteilt sie auf die Knoten. Dadurch wird paralleler I/O möglich: Mehrere Knoten verarbeiten gleichzeitig Lese- und Schreibvorgänge. Der Durchsatz wächst also mit der Clustergröße, statt an der Grenze eines einzelnen Rechners zu enden. Die Routing-Logik basiert meist auf Consistent Hashing. Sie sorgt für eine gleichmäßige Verteilung, auch wenn der Cluster wächst, ohne dass bei jedem neuen Knoten alles neu verteilt werden muss.
- Replikation Der einfache, aber wirksame Ansatz: Jeder Shard wird in N identischen Kopien auf verschiedenen Knoten gespeichert, meist dreifach. Fällt ein Knoten aus, liefern die beiden anderen sofort weiter. Es ist keine Rekonstruktion nötig und man muss nicht warten. Replikation eignet sich am besten für heiße Daten, etwa aktive Datenbanken, Echtzeit-Feeds oder alles, bei dem eine zusätzliche Millisekunde beim Lesen tatsächlich etwas kostet.
- Erasure Coding Hier wird die Rechnung für die Speichereffizienz interessant. Statt dreier vollständiger Kopien kodiert das System ein Objekt in $k$ Datenfragmente und $m$ Paritätsfragmente, verteilt alle $k+m$ auf die Knoten und kann das vollständige Objekt aus beliebigen $k$ davon rekonstruieren. Somit können $m$ Knoten gleichzeitig ausfallen, ohne dass Daten verloren gehen. Eine Reed-Solomon-Konfiguration RS(6,3) speichert 9 Blöcke statt der 18, die eine 3-fache Replikation benötigt. Dadurch sinkt der rohe Speicheraufwand von 200 % auf etwa 50 %. Der Haken: Das Kodieren und Dekodieren kostet CPU-Leistung. Erasure Coding eignet sich besser für kalte Daten, also Inhalte, die selten geändert oder mit hoher Frequenz abgerufen werden. Bei Arbeitslasten mit häufigen kleinen Schreibvorgängen ist die 3-fache Replikation bei der Latenz weiterhin im Vorteil.
| Schutzmethode | Speicheraufwand | Geeignet für | Kompromiss |
|---|---|---|---|
| 3-fache Replikation | 3-fache Rohkapazität | Heiße Daten, latenzkritische Lasten | Hohe Speicherkosten im großen Maßstab |
| Erasure Coding RS(6,3) | 1,5-fache Rohkapazität | Kalte Daten, Archivierung, große Objekte | CPU-Aufwand, längere Rekonstruktionszeit |
- Metadaten-Routing Jedes verteilte Speichersystem führt eine Metadatenschicht, im Grunde eine Karte, welcher Shard auf welchem Knoten liegt. Fordert ein Client Daten an, ermittelt der Metadatendienst die richtigen Knoten. Das System ruft die Fragmente ab und setzt sie wieder zusammen, ohne dass der Client die Komplexität sieht. In großen Clustern wie Ceph oder HDFS ist die Metadatenschicht selbst über Knoten verteilt. Das muss so sein. Ein einzelner Metadatenserver würde zum Engpass, dem Sie eigentlich entkommen wollten.
Arten verteilter Speichersysteme
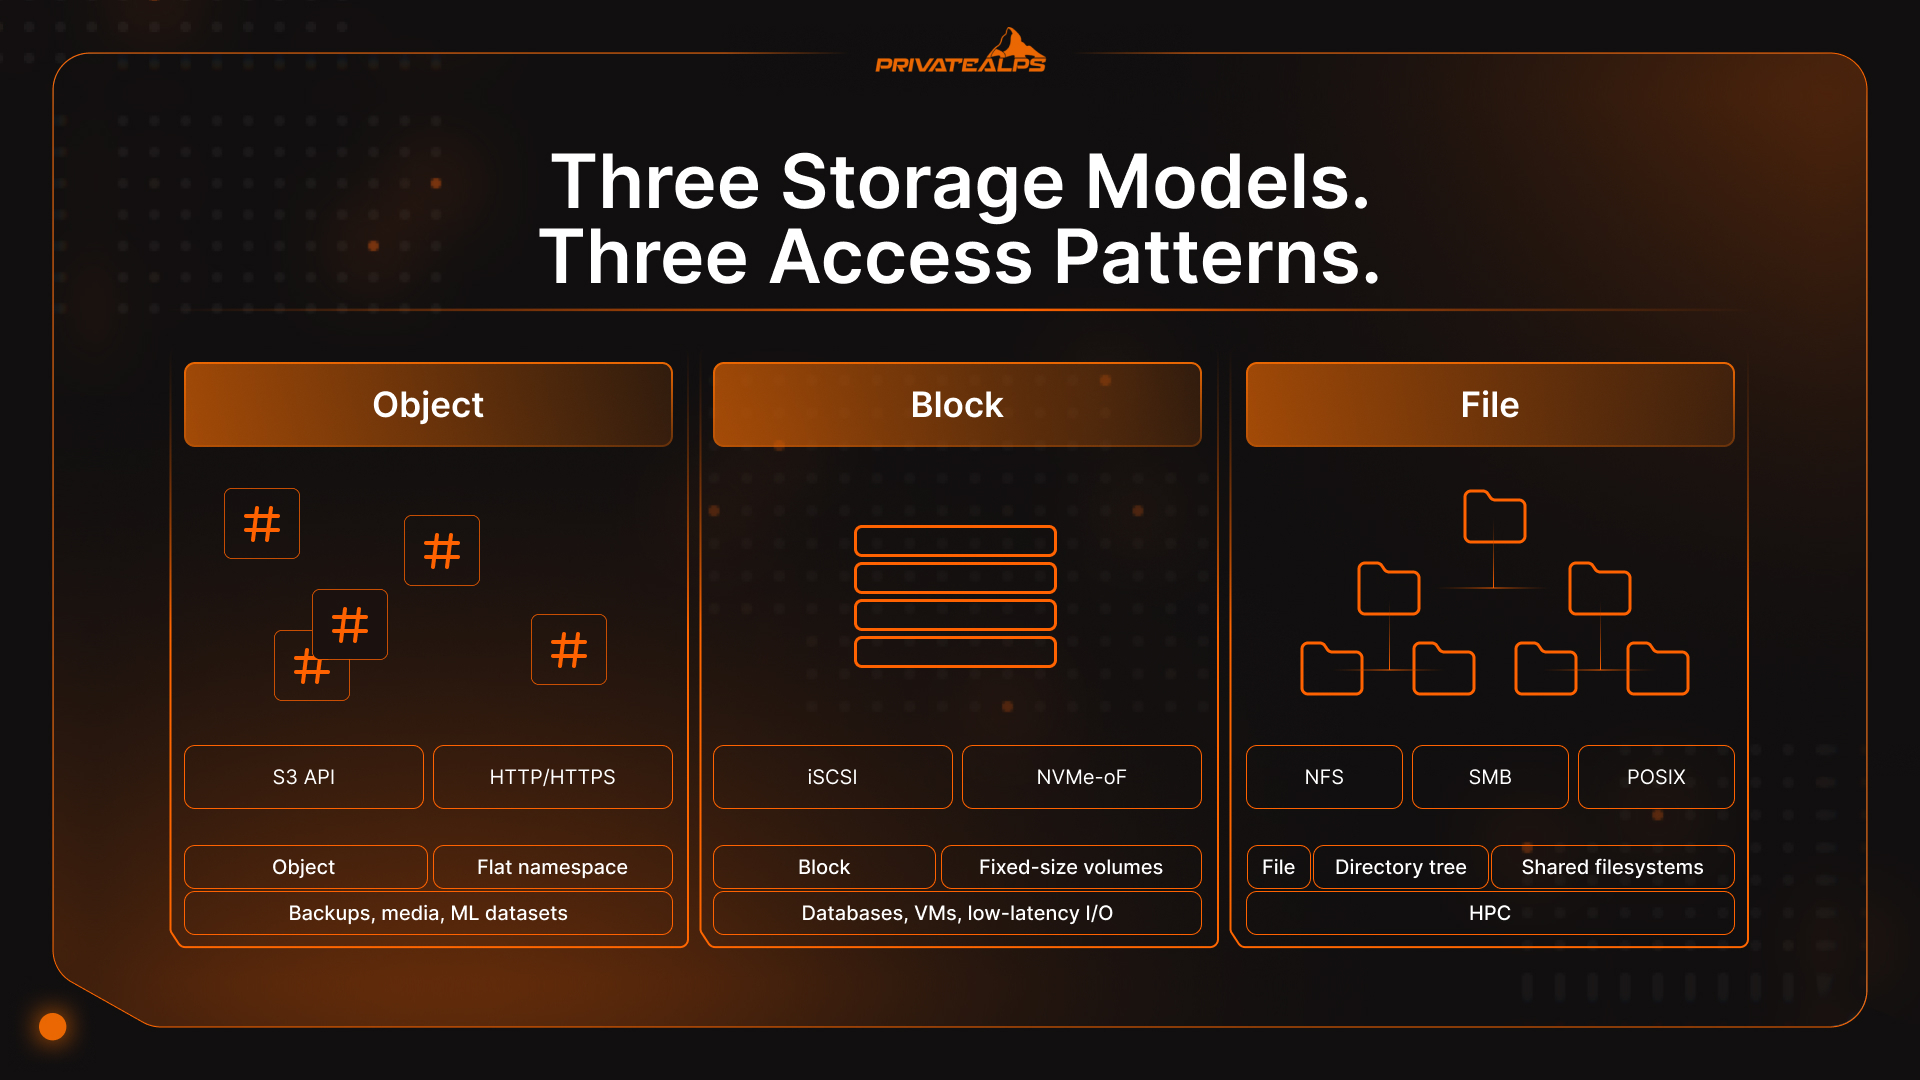
Verteilter Speicher ist keine einheitliche Technik. Er umfasst drei grundlegend verschiedene Datenmodelle. Die falsche Wahl für eine Arbeitslast ist ein überraschend häufiger und teurer Fehler. Object, Block und File Storage lösen jeweils ein anderes Problem. Verteilte Datenbanken wie Cassandra, CockroachDB oder Google Spanner bilden einen vierten Typ. Sie legen Abfragesemantik über die verteilte Datenverwaltung. Das ist allerdings ein eigenes Thema.
| Typ | Datenspeicherung | Zugriffsmethode | Geeignet für | Beispiele |
|---|---|---|---|---|
| Object | Flacher Namensraum, metadatenreiche Objekte | S3-kompatible API (HTTP/HTTPS) | Unstrukturierte Daten im großen Maßstab: Backups, Medien, ML-Datensätze | AWS S3, MinIO, Ceph RADOS |
| Block | Rohe Volumes fester Größe | iSCSI, NVMe-oF, FC | Datenbanken, VMs, latenzarmer zufälliger I/O | Ceph RBD, AWS EBS, Lightbits |
| File | Hierarchischer Verzeichnisbaum | NFS, SMB, POSIX | Gemeinsame Dateisysteme, HPC, Home-Verzeichnisse | GlusterFS, HDFS, Azure Files |
Verteilter Object Storage
Verteilter Object Storage organisiert Daten als einzelne, unveränderliche Objekte in einem flachen Namensraum. Es gibt keine Verzeichnisse, keine Dateipfade und keine Hierarchie, die man pflegen müsste. Jedes Objekt erhält eine eindeutige Kennung (einen Hash oder eine UUID) sowie umfangreiche Metadaten. Der Zugriff erfolgt über eine S3-kompatible API per HTTP. Da Objekte ersetzt statt teilweise aktualisiert werden, entfällt das Sperrproblem, das bei Block- und Dateisystemen Leistung bremst und die Skalierbarkeit begrenzt. So skalieren AWS S3, Azure Blob und Ceph bis in den Exabyte-Bereich. Es gibt keinen Koordinationsaufwand für den Namensraum und keine Sperrkonflikte, und jeder Knoten im Cluster kann jede Objektanfrage eigenständig beantworten.
Verteilter Block Storage
Block Storage stellt Servern rohe Volumes zur Verfügung: Blöcke fester Größe mit eindeutigen Adressen, ohne Dateisystem darüber. Anwendungen schreiben direkt in die Blöcke. Dadurch entsteht konsistenter, latenzarmer zufälliger I/O für Datenbanken, VM-Festplatten und containerisierte Arbeitslasten. Eine Einschränkung der Architektur wird oft übersehen: Ein Block-Volume kann normalerweise nur von einem Server gleichzeitig eingebunden werden. Gemeinsamer Zugriff mehrerer Server erfordert zusätzliche Orchestrierung, etwa ein Cluster-Dateisystem über den Blockgeräten.
Verteilter File Storage
File Storage stellt ein gemeinsames Dateisystem über Standardprotokolle bereit: NFS, SMB oder POSIX-kompatiblen Zugriff. Mehrere Clients können dasselbe Volume gleichzeitig einbinden. Das macht File Storage zur naheliegenden Wahl für kollaborative Arbeitslasten, HPC-Umgebungen und Altanwendungen, die einen Verzeichnisbaum erwarten und in absehbarer Zeit nicht neu geschrieben werden. Der praktische Nachteil: Ein konsistenter Verzeichnisnamensraum über verteilte Knoten erzeugt Koordinationsaufwand, der mit der Größe wächst. Die meisten Hyperscaler wechseln deshalb für Primärdaten irgendwann von verteiltem File Storage zu verteiltem Object Storage, sobald die Volumes groß genug sind.
Das CAP-Theorem: Der unvermeidbare Kompromiss im verteilten Speicher
Das CAP-Theorem besagt, dass ein verteiltes Datensystem gleichzeitig nur zwei von drei Eigenschaften garantieren kann: Konsistenz (jede Leseanfrage liefert den neuesten Schreibvorgang), Verfügbarkeit (jede Anfrage erhält eine Antwort) und Partitionstoleranz (das System läuft auch bei Netzwerkunterbrechungen weiter). Netzwerke werden unterbrochen. Partitionstoleranz ist daher nicht optional. Die eigentliche Entscheidung fällt immer zwischen Konsistenz und Verfügbarkeit, sobald ein Fehler auftritt.
[Eric Brewer stellte CAP im Jahr 2000 vor, Gilbert und Lynch lieferten 2002 den formalen Beweis][https://www.scylladb.com/glossary/cap-theorem/]. Es bestimmt bis heute die gesamte Architektur verteilten Speichers, weil es festlegt, wie sich das System genau dann verhält, wenn Sie es am dringendsten brauchen: wenn bereits etwas kaputt ist.
| System | CAP-Typ | Verhalten bei Partition | Geeignet für |
|---|---|---|---|
| MongoDB | CP (mit Majority-Read/Write-Concern) | Lehnt Anfragen ab, bis die Konsistenz wiederhergestellt ist | Finanzdaten, Bestand, Buchungen |
| HBase | CP | Gibt Fehler zurück statt veralteter Daten | Strukturierte Analysen, konsistente Batch-Jobs |
| Apache Cassandra | AP | Bleibt verfügbar; liefert eventuell veraltete Daten | Social Feeds, Messaging, IoT-Telemetrie |
| DynamoDB (Standard) | AP | Antwortet immer; gleicht Inkonsistenzen asynchron ab | Konsumentenanwendungen mit hohem Durchsatz |
| CockroachDB | CP | Konsistenz zuerst, verteiltes SQL | Globale transaktionale Arbeitslasten |
Die praktische Faustregel lautet: Verträgt Ihre Arbeitslast einen veralteten Lesezugriff? Ein Kontostand, eine Sitzplatzreservierung oder ein Lagerbestand verträgt das wahrscheinlich nicht. Wählen Sie in diesem Fall CP. Bei einem Social Feed, einem Sensor-Ereignisstrom oder Telemetriedaten für Analysen sind einige Sekunden Verzögerung in Ordnung. Dann wählen Sie AP und behalten die Verfügbarkeitsgarantie.
Sicherheit verteilter Speicher: Verschlüsselung und Datensouveränität
Die Sicherheit verteilter Speicher stützt sich auf drei Ebenen: Daten im Ruhezustand, Daten während der Übertragung und Schlüsselhoheit. Wenn eine dieser Ebenen versagt, schützen die anderen nicht mehr. Die Infrastruktur kann vollständig verfügbar sein, während sensible Daten für Unbefugte unbemerkt zugänglich sind.
Die Verschlüsselung muss alle drei Ebenen abdecken. Für Daten im Ruhezustand kommt in der Regel AES-256 zum Einsatz, entweder mit vom Anbieter verwalteten Schlüsseln oder mit kundenverwalteten Schlüsseln (CMK). Die Verwaltung durch den Anbieter ist im Betrieb einfacher, doch der Speicheranbieter besitzt dann das Schlüsselmaterial. Für regulierte Branchen, die Audits durchlaufen, ist das ein kritischer Sicherheitsaspekt. Die clientseitige Verschlüsselung beseitigt dieses Risiko vollständig: Die Daten werden verschlüsselt, bevor sie den Client verlassen. Der Anbieter sieht daher nie Klartext, unabhängig davon, welche rechtlichen Anfragen eingehen. Für Daten während der Übertragung ist TLS 1.3 der Mindeststandard. Wer noch TLS 1.2 zulässt, benötigt nach den meisten aktuellen Compliance-Rahmenwerken eine dokumentierte Ausnahme.
Datensouveränität wird von Teams oft unterschätzt. Daten unterliegen den Gesetzen des Ortes, an dem sie physisch gespeichert sind, nicht dem Land des Unternehmens und auch nicht dem Standort der Nutzer. Die Schweiz besitzt einen Angemessenheitsbeschluss nach Art. 45 DSGVO. Datenübermittlungen von der EU in die Schweiz sind daher ohne zusätzliche vertragliche Garantien möglich. Das revidierte Bundesgesetz über den Datenschutz (revDSG) gleicht die Schweizer Vorschriften an die DSGVO an. Schweizer Infrastruktur bietet somit gleichzeitig einen einheitlichen regulatorischen Schutz nach beiden Regelwerken.
Ein Punkt, der sich leicht aufschieben lässt, aber nicht aufgeschoben werden sollte: Die kryptografischen Verfahren, die heute die meisten Speicherinfrastrukturen schützen, wurden nicht dafür entworfen, einem leistungsfähigen Quantencomputer standzuhalten. Das NIST hat im August 2024 drei Standards für Post-Quanten-Kryptografie verabschiedet, darunter FIPS 203 (ML-KEM). Wenn Ihr verteilter Datenspeicher Datensätze mit langen Aufbewahrungsfristen enthält, etwa medizinische Archive, Finanzunterlagen oder Rechtsdokumente, ist das Bedrohungsmodell „Jetzt speichern, später entschlüsseln“ bereits real. Die Evaluierung sollte deshalb lange vor dem Zeitpunkt beginnen, an dem diese Archive ihre Relevanz verlieren.
Zentrale Vorteile verteilter Speicher
- Fehlertoleranz ohne Dienstunterbrechung: Fällt ein Knoten aus, erkennt das System dies über Heartbeat-Signale und leitet Anfragen automatisch auf die verbleibenden Replikate um. Ein manueller Eingriff oder ein Wartungsfenster ist nicht nötig.
- Horizontale Skalierbarkeit: Neue Speicherkapazität entsteht durch das Hinzufügen von Knoten zum Cluster. Die Daten werden im Hintergrund neu verteilt, ohne den laufenden Betrieb zu beeinträchtigen oder Ausfallzeiten zu verursachen.
- Geografische Verteilung: Die Replikation über mehrere Regionen verringert die Latenz für räumlich verteilte Nutzer. Außerdem wird die Einhaltung von Vorgaben zur Datenlokalisierung zu einer Konfigurationsentscheidung statt zu einem eigenen Infrastrukturprojekt.
- Parallelisierter I/O-Durchsatz: Mehrere Knoten verarbeiten Lese- und Schreibzugriffe gleichzeitig. Bei realen Produktionsvolumen ist dies die einzige skalierbare Architektur für KI- und ML-Trainingspipelines, Videotranskodierung oder Media-Streaming.
- Keine Abhängigkeit von einem Anbieter dank offener Protokolle: S3-kompatible APIs, NFS und Open-Source-Plattformen wie Ceph ermöglichen es Teams, zwischen Anbietern zu wechseln oder die Infrastruktur On-Premises zu betreiben, ohne den Anwendungscode neu schreiben zu müssen.
- Kosteneffizienz im großen Maßstab: Standardhardware ersetzt teure proprietäre Speicher-Arrays. Erasure Coding senkt den Bedarf an Rohkapazität im Vergleich zur vollständigen Replikation über Knoten hinweg um bis zu 50 %.
Grenzen und Herausforderungen verteilter Speicher
- Komplexität der Konsistenz: Ein konsistenter Zustand über alle Knoten hinweg erfordert eine sorgfältige Abstimmung von Konsistenzmodellen, Replikationsfaktoren und Quorum-Einstellungen. Eine Fehlkonfiguration meldet sich nicht lautstark, sondern führt schleichend dazu, dass Daten auseinanderdriften.
- Betriebsaufwand: Ein verteilter Speicher-Cluster erfordert Planung der Fehlerdomänen, Verfahren zum Austausch von Knoten, Monitoring-Pipelines und Performance-Tuning. Ein einzelner Server verlangt davon deutlich weniger.
- Netzwerkabhängigkeit: Die gesamte Architektur setzt zuverlässige Verbindungen mit hoher Bandbreite zwischen den Knoten voraus. Verschlechtert sich das Netzwerk, wirkt sich das direkt und proportional auf Latenz und Durchsatz des Speichers aus.
- Latenz bei kleinen zufälligen I/O-Zugriffen: Verteilte Speicher sind für große sequenzielle Lesevorgänge und parallelen Durchsatz optimiert. Workloads mit vielen kleinen, zufälligen I/O-Zugriffen, insbesondere OLTP-Datenbanken, laufen oft auf lokal angebundenem NVMe-Blockspeicher (sehr schneller Flash-Speicher mit direkter PCIe-Anbindung) besser.
- Mindestgröße für einen sinnvollen Einsatz: Die Kosten- und Komplexitätsvorteile verteilter Speicher zeigen sich auf einem Cluster mit zwei Knoten nicht. Unterhalb einer bestimmten Schwelle sind ein verwalteter Cloud-Speicherdienst oder ein gut konfigurierter Einzelserver schlicht günstiger und einfacher zu betreiben.
Praxisbeispiele für verteilten Speicher
- Medien und Streaming: Netflix und YouTube liefern Videos nicht von einem zentralen Standort aus. Sie verteilen kodierte Inhalte auf Object-Storage-Cluster, die geografisch nah bei den Zuschauern stehen. Ein einzelnes Rechenzentrum könnte gleichzeitige globale Streams nicht in diesem Umfang bewältigen, allein die Bandbreitenkosten wären prohibitiv. Verteilter Datenspeicher macht die Wirtschaftlichkeit von Streaming überhaupt erst möglich.
- Gesundheitswesen: Eine einzige MRT-Untersuchung erzeugt 500 MB bis 1 GB Bilddaten. Multipliziert man das über ein großes Klinikverbund-Netzwerk mit verschiedenen Modalitäten, langen Aufbewahrungspflichten und mehreren Standorten, kommen rasch Petabytes zusammen. Skalierbarer verteilter Speicher mit geografischer Redundanz ermöglicht es Gesundheitssystemen, den HIPAA-konformen Zugriff auf Patientenakten auch dann aufrechtzuerhalten, wenn ein regionales Rechenzentrum ausfällt.
- KI und maschinelles Lernen: Das Training eines großen Sprachmodells bedeutet, GPU-Cluster mit Terabytes bis Petabytes an Daten zu versorgen. Die Zugriffe erfolgen nicht sequenziell und würden ein klassisches Speichersystem nahezu sofort überlasten. Ceph, HDFS und S3-kompatible Object Stores sind daher zur Standard-Infrastrukturschicht für ML-Pipelines geworden, weil ihr paralleler Lesedurchsatz genau dem entspricht, was GPU-Cluster verbrauchen.
- Backup und Disaster Recovery: Echte Notfallwiederherstellung bedeutet, dass Daten mindestens an zwei geografisch getrennten Standorten mit unabhängigen Fehlerdomänen vorliegen, nicht in zwei Racks im selben Gebäude. Replikationsrichtlinien und Platzierungsregeln, die direkt in die Speicherschicht integriert sind, legen RPO und RTO auf Infrastrukturebene fest, ohne dass ein separater Backup-Softwarestack nötig ist. Weniger bewegliche Teile bedeuten zugleich eine kleinere Angriffsfläche.
Verteilter vs. dezentraler Speicher: Was ist der Unterschied?
Verteilter Speicher bedeutet, dass Daten auf viele Knoten verteilt sind, die gesamte Umgebung aber weiterhin einer Organisation gehört und von ihr kontrolliert wird. Das gilt für Richtlinien, Zugriffsrechte, die Löschfähigkeit und Audit-Protokolle. Dezentraler Speicher verzichtet vollständig auf diese zentrale Instanz. Die Daten liegen auf unabhängigen Peers verteilt, und kein einzelner Betreiber kann sie eigenmächtig zensieren, einsehen oder löschen.
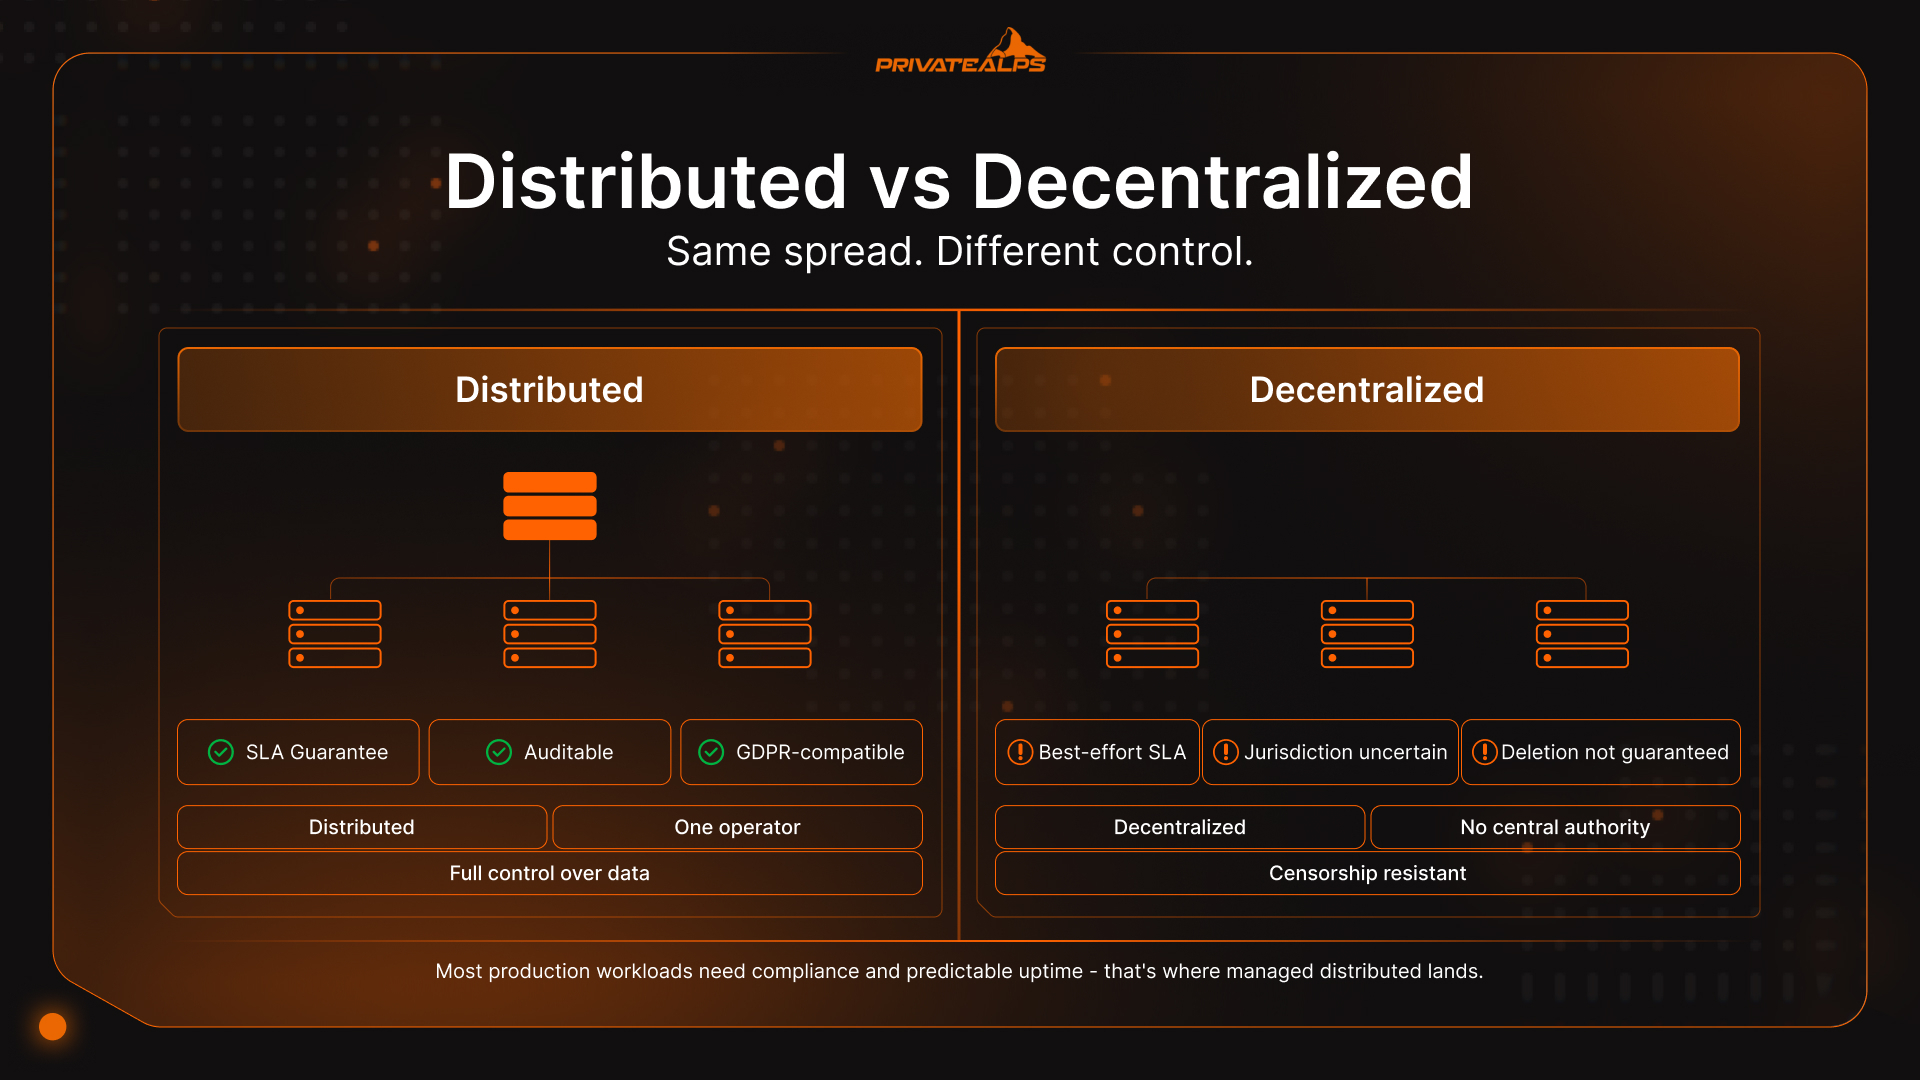
Diese Unterscheidung hat konkrete betriebliche Folgen. Ein zentral verwalteter verteilter Speicher lässt sich prüfen, patchen, mit SLAs absichern und in die Einhaltung regulatorischer Vorgaben einbinden. Ein dezentrales System tauscht all das gegen Zensurresistenz und vertrauenslosen Betrieb ein. Das ist in bestimmten Kontexten wertvoll, entspricht aber nicht dem, was die meisten Unternehmen mit produktiver Speicherinfrastruktur tatsächlich benötigen.
| Dimension | Verteilter Speicher | Dezentraler Speicher |
|---|---|---|
| Kontrolle | Zentral verwaltet | Keine zentrale Instanz |
| SLA / Verfügbarkeit | Vertragliche Garantien möglich | Best Effort, protokollabhängig |
| Compliance | Prüfbar, DSGVO-kompatibel | Rechtsordnung unklar |
| Datenlöschung | Garantiert | Nicht immer möglich |
| Zugriffskontrolle | Rollenbasiert, verwaltet | Kryptografisch, vertrauenslos |
| Beispiele | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Eine weitere Ebene lohnt die Abgrenzung: Multi-Region-Cloud-Speicher wie AWS S3 mit regionsübergreifender Replikation oder Azure Geo-redundant Storage ist trotzdem zentral verwaltete Infrastruktur. Der Anbieter steuert die Knoten und die Replikation, Sie mieten im Grunde lediglich die geografische Verteilung. Echte verteilte Cloud-Plattformen wie Storj oder Cubbit verteilen Daten auf unabhängige Betreiber. Das beseitigt die Bindung an einen Anbieter, wirft aber Fragen zu SLAs und Audit-Trails neu auf. Für die meisten Workloads, die Compliance-Nachweise und planbare Verfügbarkeit erfordern, ist der verwaltete verteilte Ansatz die richtige Wahl.
Zusammenfassung
Verteilter Speicher ist kein Produkt, sondern eine Architekturkategorie. Welche Ausprägung passt, hängt vollständig davon ab, was Sie betreiben. Object Storage, Blockspeicher und Dateispeicher verfügen jeweils über ein Datenmodell, das für unterschiedliche Zugriffsmuster und Workloads entwickelt wurde. Das CAP-Theorem erzwingt bei Netzwerkausfällen einen echten Kompromiss zwischen Konsistenz und Verfügbarkeit. Eine falsche Entscheidung kann teuer werden. Bei der Wahl zwischen Replikation und Erasure Coding entscheidet die Datentemperatur: Heiße Daten brauchen Replikation für niedrige Latenz, kalte Daten profitieren von der Speichereffizienz des Erasure Coding. Für die meisten Teams bietet eine verwaltete verteilte Lösung, sei es bei einem Schweizer Anbieter oder in einer Public Cloud, solange Datenlokalisierung und Sicherheitskontrollen überprüfbar sind, ein besseres Gleichgewicht aus Skalierbarkeit, Leistung und einfachem Tagesbetrieb als ein selbst betriebener Cluster.
Daten in der Schweiz speichern – mit PrivateAlps
Wenn Ihr Workload S3-kompatiblen verteilten Object Storage mit überprüfbarer Datenlokalisierung benötigt, betreibt PrivateAlps Infrastruktur mit Standort in der Schweiz, die sowohl Art. 45 DSGVO als auch das revDSG vollständig erfüllt. Ihre Daten bleiben in der Schweiz, ohne Weitergabe an Dritte, ohne unklare Routen über ausländische Rechtsräume und ohne böse Überraschungen. Ob Sie von einem Hyperscaler wegziehen oder einen datenschutzorientierten verteilten Speicher von Grund auf aufbauen: PrivateAlps liefert die Leistung und die Rechtssicherheit, die Ihr Workload tatsächlich braucht.
FAQ
Was ist der Unterschied zwischen verteiltem Speicher und Cloud-Speicher?
Cloud-Speicher ist ein Bereitstellungsmodell. Ein anderer übernimmt die Verwaltung der Infrastruktur, und Sie greifen über das Internet nach Nutzung ab. Verteilter Speicher ist eine Architektur, bei der Daten zur Ausfallsicherheit und Skalierbarkeit auf mehrere Knoten verteilt werden. Beide Konzepte sind unabhängig voneinander. Verteilten Speicher können Sie vollständig On-Premises mit Ceph oder MinIO betreiben. Ein Cloud-Anbieter kann technisch auch zentralen Speicher hinter einer API bereitstellen. Die meisten Cloud-Speicherdienste nutzen intern verteilte Architekturen, doch das ist ein Implementierungsdetail und nicht die Definition von Cloud-Speicher.
Welches ist das beste verteilte Speichersystem?
Eine pauschale Antwort gibt es nicht. Sie hängt vom Workload und vom Datenmodell ab. Für unstrukturierte Daten und Backups sind S3-kompatible Object Stores wie MinIO oder Ceph RADOS die Standardwahl. Für Datenbank-Volumes und VM-Festplatten mit konsistenter, latenzarmer Blockspeicher-I/O eignet sich Ceph RBD oder Lightbits besser. Für gemeinsam genutzte Dateisysteme im HPC-Umfeld oder in Legacy-Umgebungen fällt die Wahl häufig auf GlusterFS oder HDFS. Beginnen Sie mit dem Zugriffsmuster. Das Speichersystem ergibt sich daraus.
Ist verteilter Speicher dasselbe wie RAID?
Nein. RAID arbeitet innerhalb eines einzelnen Servers oder Speicher-Arrays und schützt vor Festplattenausfällen in einem Gerät. Verteilter Speicher arbeitet über getrennte physische Knoten hinweg, die über ein Netzwerk verbunden sind und sich über mehrere Gebäude oder ganze Rechenzentren erstrecken können. RAID hilft nicht, wenn der Server selbst ausfällt. Verteilte Speichersysteme sind gezielt darauf ausgelegt, Knotenausfälle, Rack-Ausfälle und den vollständigen Ausfall eines Rechenzentrums zu verkraften. Der Unterschied im Wirkungsbereich ist grundlegend.
Wie geht verteilter Speicher mit Knotenausfällen um?
Knoten senden regelmäßig Heartbeat-Signale an die Metadatenschicht des Clusters. Bleibt ein Knoten stehen, erkennt das System den Ausfall, in der Regel innerhalb weniger Sekunden, und leitet Anfragen an Knoten um, die die Replikate oder die Erasure-Coding-Fragmente halten. Bei replikationsbasierten Setups startet danach ein Hintergrundprozess, der neue Kopien erzeugt, um den konfigurierten Replikationsfaktor im Cluster wiederherzustellen. Der gesamte Vorgang läuft automatisch ab. In einem gut konfigurierten verteilten Speicher-Cluster bekommen Anwendungen den Ausfall gar nicht mit.
Ist verteilter Speicher für kleine Unternehmen geeignet?\\
Verwaltete verteilte Speicherdienste, etwa S3-kompatibler Object Storage von einem Cloud-Anbieter oder einem Spezialisten wie PrivateAlps, funktionieren in jeder Größenordnung und haben keine Mindestgröße für einen Cluster. Selbst betriebene verteilte Speicher-Cluster sind dagegen eine andere Geschichte. Ceph im Produktivbetrieb erfordert in der Regel mindestens drei bis fünf Knoten, bevor sich der Betriebsaufwand lohnt. Für kleine Teams bieten verwaltete Dienste alle architektonischen Vorteile verteilten Speichers, ohne die Last der Infrastrukturverwaltung.
