


¿Qué es el almacenamiento distribuido?
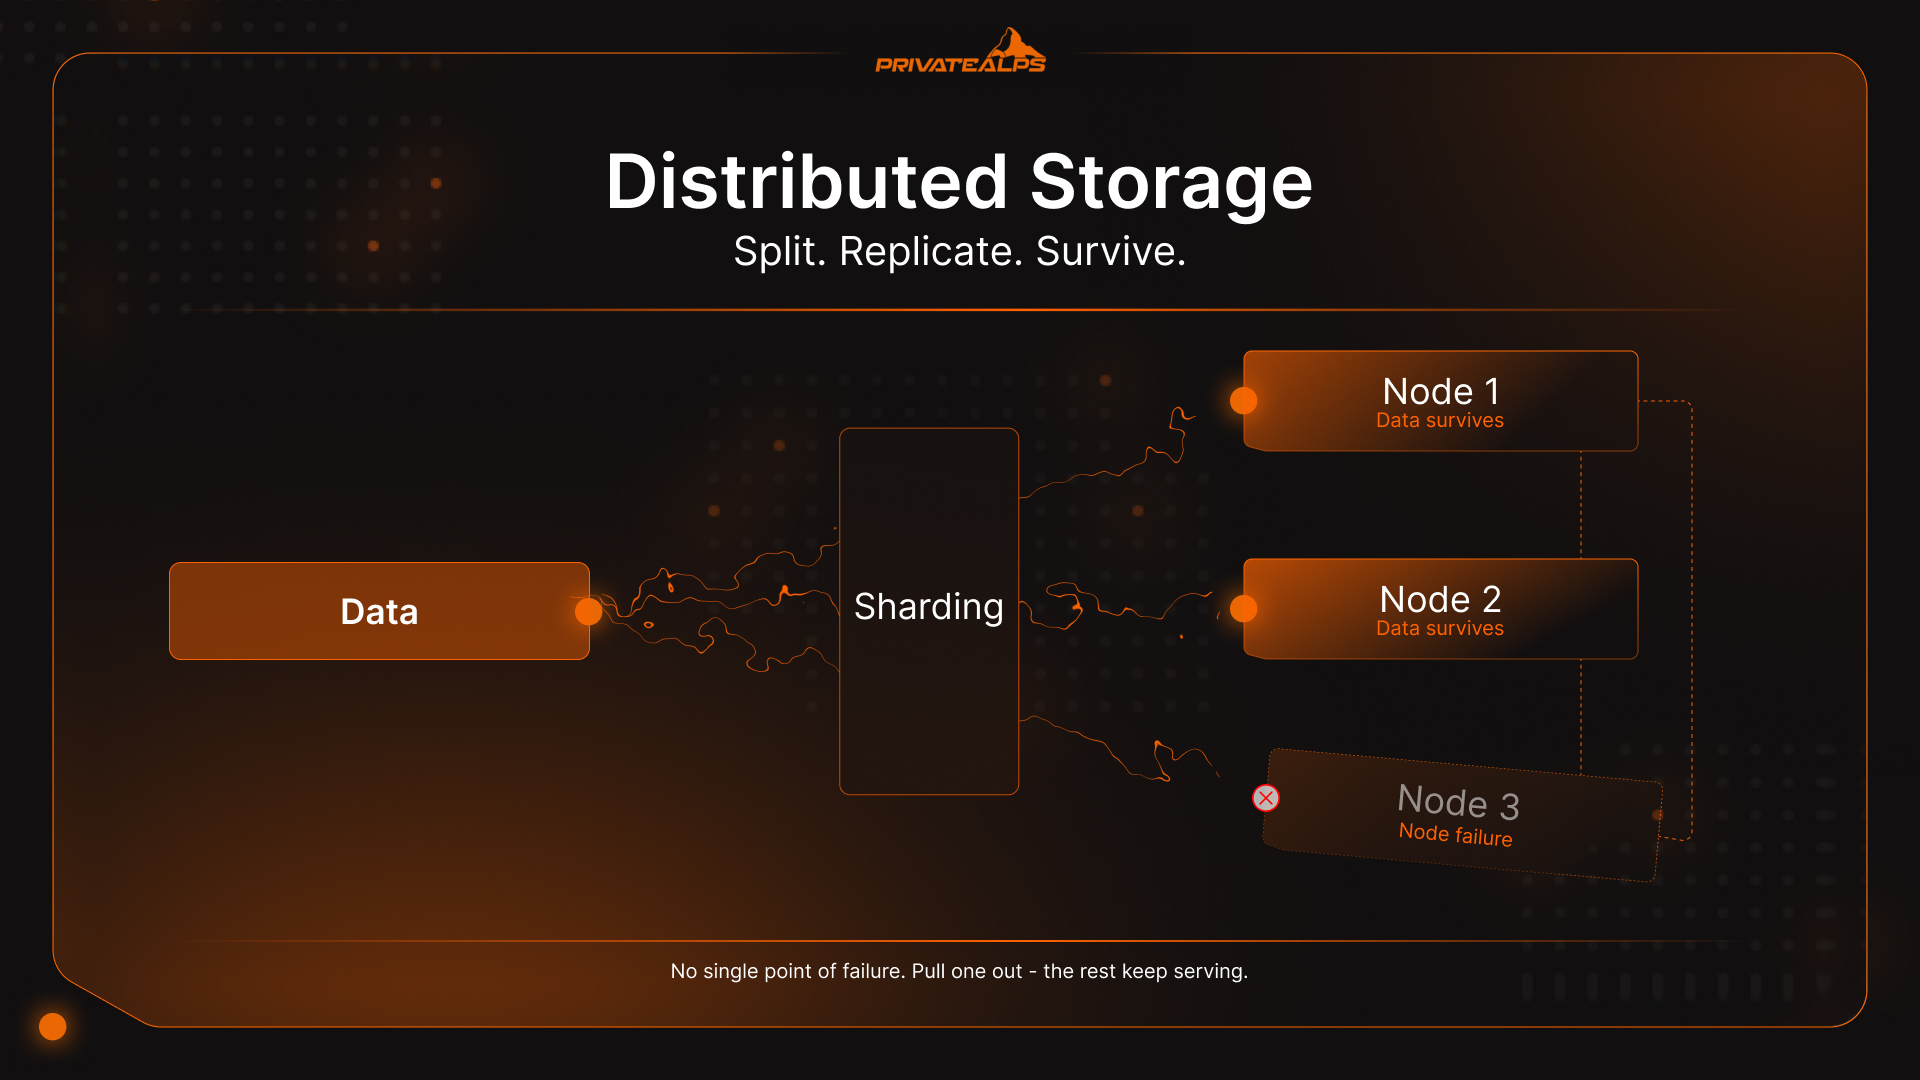
El almacenamiento distribuido es la forma en que la infraestructura moderna gestiona datos que son demasiado grandes, demasiado críticos o demasiado exigentes en accesos para que una sola máquina los almacene de forma fiable. En lugar de escribir todo en un único servidor, el sistema divide, replica o codifica esos datos entre varios nodos independientes: servidores, discos y centros de datos. Trabajan de forma conjunta, pero ningún nodo contiene todo. Si se desconecta uno, el resto sigue dando servicio. Esta guía explica cómo se comportan en la práctica los sistemas de almacenamiento distribuido bajo carga, qué compromisos de arquitectura imponen y qué tipo de almacenamiento encaja con cada carga de trabajo.
Resumen de IA
El almacenamiento distribuido es una arquitectura definida por software que reparte los datos entre varios nodos físicos mediante tres técnicas principales: sharding (dividir los datos en fragmentos discretos que se envían a distintos nodos), replicación (mantener varias copias idénticas en distintos nodos para un acceso rápido) y codificación de borrado (codificar los datos en fragmentos con paridad matemática, de modo que cualquier subconjunto permita reconstruir el conjunto completo).
Existen tres tipos principales de sistemas de almacenamiento distribuido: almacenamiento de objetos (espacio de nombres plano, API compatible con S3), almacenamiento de bloques (volúmenes de tamaño fijo para E/S aleatoria de baja latencia) y almacenamiento de archivos (espacio de nombres jerárquico mediante NFS o SMB). Toda configuración de almacenamiento de datos distribuido se enfrenta al teorema CAP: solo puede garantizar dos de estas tres propiedades a la vez: consistencia, disponibilidad y tolerancia a particiones.
El beneficio operativo principal es que la caída de un nodo no provoca interrupciones: el sistema redirige automáticamente las peticiones a las réplicas que siguen activas. La magnitud de lo que está en juego: la humanidad genera más de 400 millones de terabytes de datos nuevos cada día, un volumen que ninguna arquitectura centralizada puede absorber sin acabar colapsando bajo su propio peso.
Almacenamiento distribuido frente a almacenamiento centralizado
El almacenamiento centralizado concentra todo en un único lugar: un servidor, una SAN o un centro de datos. Ese es todo el modelo. Cuando ese lugar tiene un problema, todo se detiene. El almacenamiento distribuido aborda esto de forma directa: los datos viven en varios nodos independientes, de modo que ningún punto de fallo único puede dejar el sistema fuera de servicio ni bloquear todos los accesos.
Un fallo de hardware y el acceso se corta. Sin más. Escalar implica actualizar o sustituir el sistema principal, lo que normalmente supone tiempo de inactividad y una conversación sobre inversión de capital que nadie quiere tener. El almacenamiento distribuido evita ambas cosas por diseño: para crecer, añades un nodo, y cuando uno falla, el clúster redirige el tráfico alrededor de él. Sin dramas ni interrupciones. Los datos ya estaban en varios nodos antes de que nada se rompiera.
| Dimensión | Almacenamiento centralizado | Almacenamiento distribuido |
|---|---|---|
| Tolerancia a fallos | Punto único de fallo | Los datos sobreviven a la pérdida de nodos |
| Escalabilidad | Vertical (actualizar hardware) | Horizontal (añadir nodos) |
| Latencia | Baja para acceso local | Variable; depende de la topología de red |
| Coste a pequeña escala | Coste inicial más bajo | Clúster mínimo viable más caro |
| Coste a gran escala | Caro de escalar | El hardware estándar reduce el coste |
| Distribución geográfica | Una única ubicación | Multirregión mediante configuración |
| Complejidad operativa | Sencilla de gestionar | Requiere herramientas de orquestación |
Cómo funcionan los sistemas de almacenamiento distribuido
Un sistema de almacenamiento distribuido toma los datos entrantes, los divide en fragmentos, envía esos fragmentos a los nodos adecuados del clúster y sigue cada parte a través de una capa de metadatos. Así, cualquier fragmento puede localizarse, recuperarse y reensamblarse bajo demanda, independientemente del nodo que lo contenga. Ese es el ciclo básico. Cuatro mecanismos lo hacen posible:
- Sharding (particionado de datos) Cuando llegan los datos, el sistema los corta en piezas más pequeñas (shards o bloques) y los reparte entre los nodos. Esto es lo que permite la E/S paralela: varios nodos gestionan lecturas y escrituras al mismo tiempo, de modo que el rendimiento crece con el tamaño del clúster en lugar de quedar limitado por el techo de una sola máquina. La lógica de enrutamiento suele basarse en el hashing consistente, que mantiene una distribución uniforme a medida que el clúster crece, sin tener que reorganizarlo todo cada vez que se añade un nodo.
- Replicación El enfoque sencillo pero eficaz: almacenar N copias idénticas de cada fragmento en nodos separados, normalmente tres. Si un nodo se desconecta, los otros dos siguen atendiendo las peticiones de inmediato. Sin reconstrucción ni esperas. La replicación es la opción adecuada para los datos calientes: bases de datos activas, flujos en tiempo real y cualquier caso en el que un milisegundo extra en las lecturas tenga un coste real.
- Codificación de borrado Aquí es donde las matemáticas de la eficiencia de almacenamiento se vuelven interesantes. En lugar de tres copias completas, el sistema codifica un objeto en $k$ fragmentos de datos más $m$ fragmentos de paridad, distribuye los $k+m$ entre los nodos y puede reconstruir el objeto completo a partir de cualquier $k$ de ellos. Así, $m$ nodos pueden fallar a la vez sin que se pierda nada. Una configuración Reed-Solomon RS(6,3) almacena 9 bloques en lugar de los 18 que exige la replicación 3x, lo que reduce la sobrecarga de almacenamiento bruto del 200 % a aproximadamente el 50 %. El inconveniente es que codificar y decodificar consume ciclos de CPU, y la codificación de borrado funciona mejor con datos fríos: contenido que rara vez se modifica o se accede con alta frecuencia. En cargas de trabajo con escrituras frecuentes y pequeñas, la replicación 3x sigue siendo mejor en latencia.
| Método de protección | Sobrecarga de almacenamiento | Ideal para | Compromiso |
|---|---|---|---|
| Replicación 3x | 3x la capacidad bruta | Datos calientes, cargas de baja latencia | Coste de almacenamiento alto a escala |
| Codificación de borrado RS(6,3) | 1,5x la capacidad bruta | Datos fríos, archivo, objetos grandes | Sobrecarga de CPU, mayor latencia de reconstrucción |
- Enrutamiento de metadatos Todo sistema de almacenamiento distribuido mantiene una capa de metadatos, que es básicamente un mapa de qué fragmento está en qué nodo. Cuando un cliente solicita datos, el servicio de metadatos identifica los nodos correctos, y el sistema recupera y reensambla los fragmentos sin que el cliente vea nunca la complejidad. En clústeres de gran escala como Ceph o HDFS, la capa de metadatos también está distribuida entre varios nodos. Tiene que ser así: un único servidor de metadatos se convierte en el cuello de botella del que intentabas escapar.
Tipos de sistemas de almacenamiento distribuido
El almacenamiento distribuido no es una sola cosa. Es una categoría con tres modelos de datos diferentes, y elegir el equivocado para una carga de trabajo es un error sorprendentemente habitual y costoso. El almacenamiento de objetos, el de bloques y el de archivos resuelven cada uno un problema distinto. Las bases de datos distribuidas (Cassandra, CockroachDB, Google Spanner) representan un cuarto tipo, que añade semántica de consultas sobre la gestión de datos distribuidos, pero eso es un tema aparte.
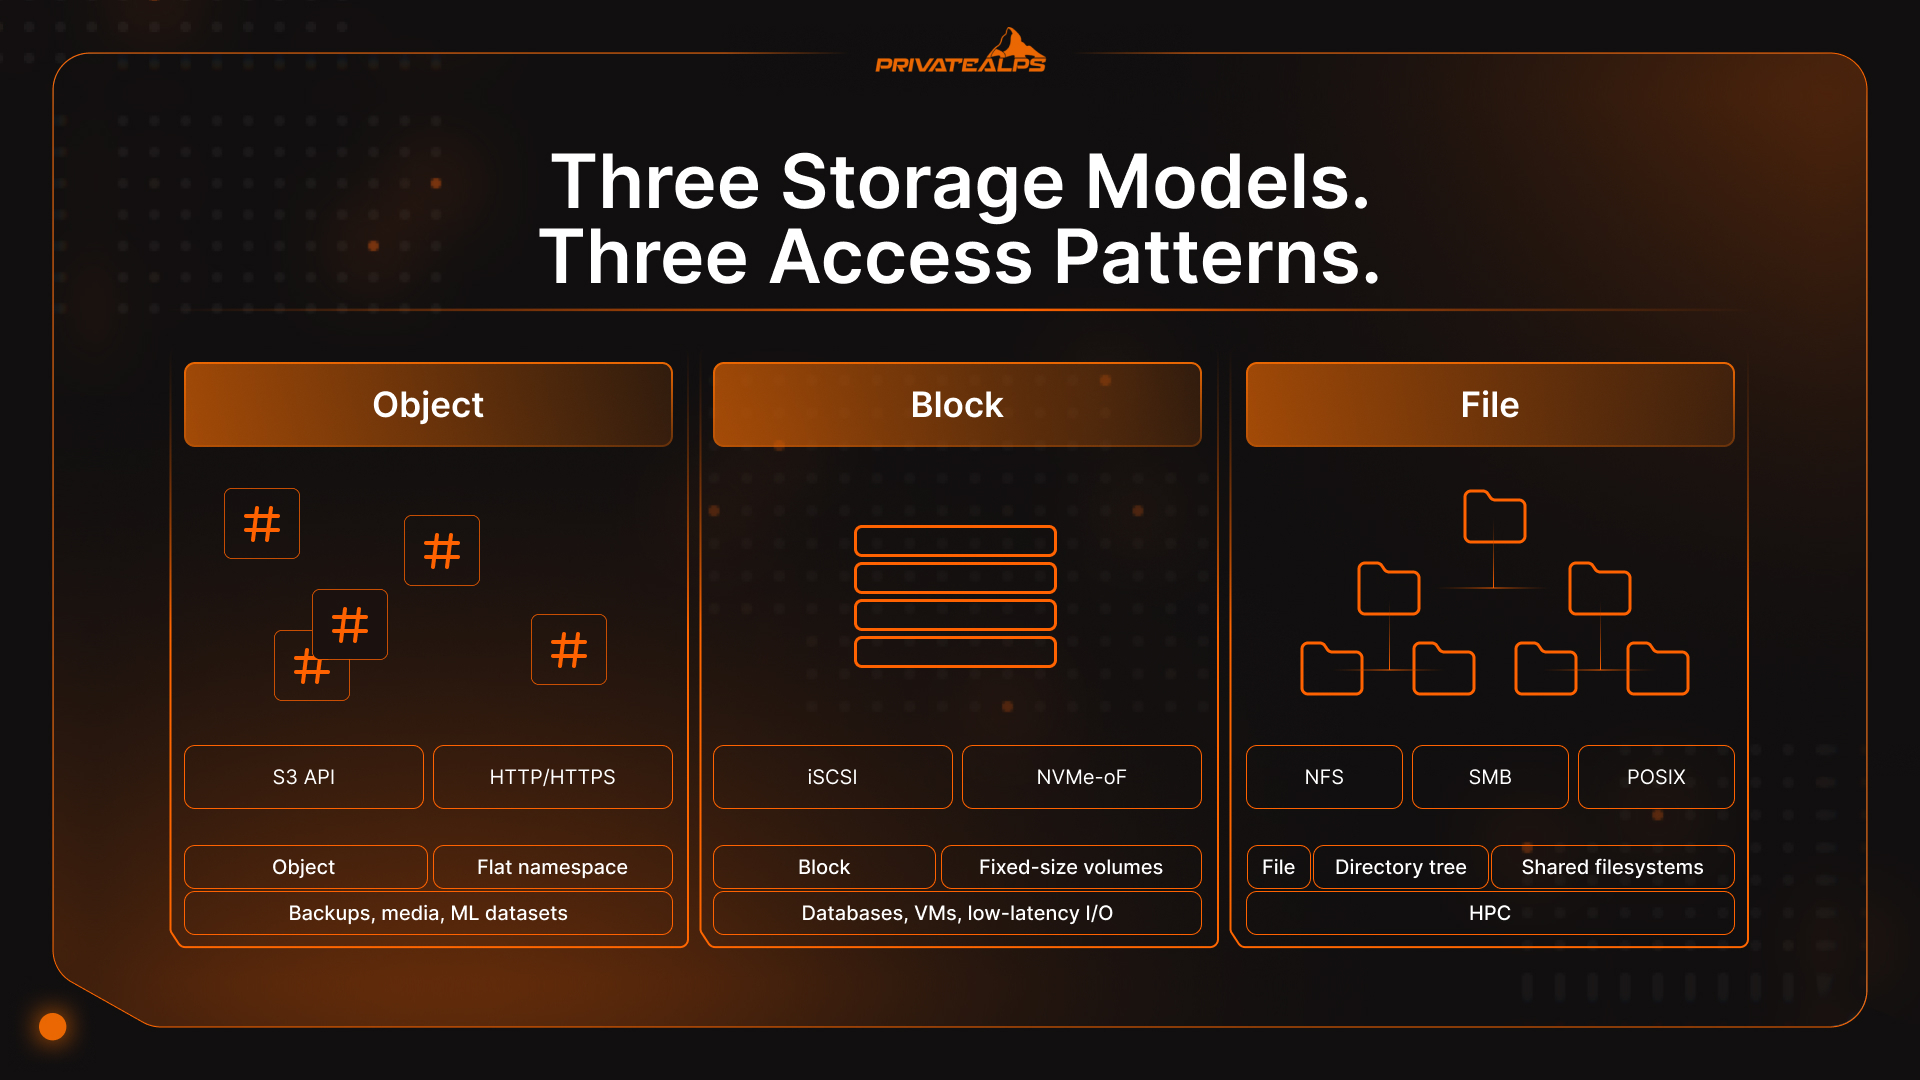
| Tipo | Cómo se almacenan los datos | Método de acceso | Ideal para | Ejemplos |
|---|---|---|---|---|
| Objetos | Espacio de nombres plano, objetos ricos en metadatos | API compatible con S3 (HTTP/HTTPS) | Datos no estructurados a gran escala: copias de seguridad, multimedia, conjuntos de datos de ML | AWS S3, MinIO, Ceph RADOS |
| Bloques | Volúmenes sin formato de tamaño fijo | iSCSI, NVMe-oF, FC | Bases de datos, máquinas virtuales, E/S aleatoria de baja latencia | Ceph RBD, AWS EBS, Lightbits |
| Archivos | Árbol de directorios jerárquico | NFS, SMB, POSIX | Sistemas de archivos compartidos, HPC, directorios de usuario | GlusterFS, HDFS, Azure Files |
Almacenamiento distribuido de objetos
El almacenamiento distribuido de objetos organiza los datos como objetos individuales e inmutables en un espacio de nombres plano: sin directorios, sin rutas de archivos y sin jerarquía que mantener. Cada objeto recibe un identificador único (un hash o un UUID) junto con metadatos ricos, y se accede a él mediante una API compatible con S3 sobre HTTP. Como los objetos se reemplazan en lugar de actualizarse parcialmente, el problema de bloqueos que limita el rendimiento y la escalabilidad en los sistemas de bloques y de archivos simplemente desaparece. Así es como AWS S3, Azure Blob y Ceph escalan hasta exabytes: sin sobrecarga de coordinación del espacio de nombres, sin contención de bloqueos y con cualquier nodo del clúster capaz de atender cualquier petición de objeto de forma independiente.
Almacenamiento distribuido de bloques
El almacenamiento de bloques entrega volúmenes sin formato a los servidores: bloques de tamaño fijo con direcciones únicas, sin una capa de sistema de archivos encima. Las aplicaciones escriben directamente en los bloques, lo que ofrece una E/S aleatoria de baja latencia y constante para bases de datos, discos de máquinas virtuales y cargas de trabajo en contenedores. Una limitación arquitectónica que sorprende a muchos: un volumen de bloques normalmente solo puede montarlo un servidor a la vez. El acceso compartido entre varios servidores requiere orquestación adicional, como un sistema de archivos de clúster superpuesto a los dispositivos de bloques.
Almacenamiento distribuido de archivos
El almacenamiento de archivos presenta un sistema de archivos compartido a través de protocolos estándar: acceso NFS, SMB y compatible con POSIX. Varios clientes pueden montar el mismo volumen al mismo tiempo, lo que lo convierte en la opción natural para cargas de trabajo colaborativas, entornos HPC y aplicaciones heredadas que esperan un árbol de directorios y no se van a reescribir en breve. El compromiso en el mundo real: mantener un espacio de nombres de directorios coherente entre nodos distribuidos genera una sobrecarga de coordinación que crece con la escala. La mayoría de los hiperescaladores acaban migrando del almacenamiento distribuido de archivos al de objetos para los datos principales, una vez que los volúmenes alcanzan un tamaño suficiente.
El teorema CAP: el compromiso inevitable del almacenamiento distribuido
El teorema CAP afirma que un sistema de datos distribuido solo puede garantizar dos de tres cosas a la vez: consistencia (cada lectura devuelve la escritura más reciente), disponibilidad (cada petición recibe una respuesta) y tolerancia a particiones (el sistema sigue funcionando ante divisiones de la red). Las redes se dividen, así que la tolerancia a particiones no es opcional. La decisión real siempre está entre consistencia y disponibilidad cuando se produce un fallo.
[Eric Brewer presentó CAP en 2000; Gilbert y Lynch formalizaron la demostración en 2002][https://www.scylladb.com/glossary/cap-theorem/]. Sigue siendo la decisión que da forma a todo lo demás en la arquitectura de almacenamiento distribuido, porque determina cómo se comporta el sistema justo en el momento en que más lo necesitas: cuando algo ya se ha roto.
| Sistema | Tipo CAP | Comportamiento durante una partición | Ideal para |
|---|---|---|---|
| MongoDB | CP (con concern de lectura/escritura por mayoría) | Rechaza peticiones hasta restablecer la consistencia | Registros financieros, inventario, reservas |
| HBase | CP | Devuelve errores en lugar de datos obsoletos | Analítica estructurada, lotes consistentes |
| Apache Cassandra | AP | Sigue disponible; puede servir lecturas obsoletas | Feeds sociales, mensajería, telemetría IoT |
| DynamoDB (por defecto) | AP | Siempre responde; reconcilia las inconsistencias de forma asíncrona | Aplicaciones de consumo de alto rendimiento |
| CockroachDB | CP | Primero la consistencia, SQL distribuido | Cargas transaccionales globales |
La decisión práctica: ¿puede tu carga de trabajo tolerar una lectura obsoleta? Un saldo bancario, una reserva de asiento o un recuento de inventario: probablemente no. Elige CP. Un feed social, un flujo de eventos de sensores o la telemetría analítica: unos segundos de desfase son aceptables. Elige AP y mantén la garantía de disponibilidad.
Seguridad del almacenamiento distribuido: cifrado y soberanía de los datos
La seguridad en el almacenamiento distribuido abarca tres capas diferentes: datos en reposo, datos en tránsito y propiedad de las claves. Si fallas en una de ellas, las otras no te salvan. La infraestructura puede estar perfectamente disponible mientras los datos sensibles son accesibles, sin que nadie lo note, para personas que no deberían tenerlos.
El cifrado debe cubrir las tres capas. Los datos en reposo suelen usar AES-256, con claves gestionadas por el proveedor o con claves gestionadas por el cliente (CMK). La gestión por el proveedor es más sencilla desde el punto de vista operativo, pero el proveedor de almacenamiento custodia el material de las claves, algo fundamental para los sectores regulados que pasan auditorías. El cifrado en el lado del cliente elimina por completo ese riesgo: los datos se cifran antes de salir del cliente, de modo que el proveedor nunca accede al texto en claro, sin importar qué solicitudes legales lleguen. En cuanto a los datos en tránsito, TLS 1.3 es el mínimo de seguridad; cualquier sistema que siga permitiendo TLS 1.2 necesita una excepción documentada según la mayoría de los marcos de cumplimiento vigentes.
La soberanía de los datos suele pillar desprevenidos a los equipos. Los datos están sujetos a las leyes del lugar donde se almacenan físicamente, no a las del país de la empresa ni a las del usuario. Suiza tiene reconocimiento de adecuación en virtud del artículo 45 del RGPD, por lo que las transferencias de datos de la UE a Suiza se realizan sin salvaguardas contractuales adicionales. La Ley Federal de Protección de Datos (nLPD) revisada alinea la normativa interna suiza con el RGPD, lo que significa que la infraestructura suiza ofrece una cobertura normativa coherente en ambos marcos a la vez.
Hay un aspecto que es fácil de posponer, pero no debería serlo: los algoritmos criptográficos que protegen hoy la mayor parte de la infraestructura de almacenamiento no se diseñaron para resistir a un ordenador cuántico capaz. El NIST finalizó tres estándares de criptografía poscuántica en agosto de 2024, entre ellos FIPS 203 (ML-KEM). Si tu almacenamiento de datos distribuido guarda registros con un largo horizonte de conservación (archivos médicos, registros financieros, documentos legales), la amenaza de «capturar ahora, descifrar después» ya está activa. Los plazos de evaluación deberían empezar mucho antes de que esos archivos lleguen a su fecha de madurez.
Ventajas clave del almacenamiento distribuido
- Tolerancia a fallos sin interrupción del servicio: Si falla un nodo, la detección por latido y el redireccionamiento automático hacia las réplicas que siguen activas se producen sin intervención manual y sin necesidad de ventana de mantenimiento.
- Escalabilidad horizontal: La nueva capacidad de almacenamiento se consigue añadiendo nodos al clúster; los datos se reequilibran en segundo plano sin afectar al tráfico en directo ni requerir tiempo de inactividad.
- Distribución geográfica: La replicación entre regiones reduce la latencia para usuarios repartidos geográficamente y convierte el cumplimiento de la residencia de datos en una decisión de configuración, en lugar de en un proyecto de infraestructura.
- Rendimiento de E/S en paralelo: Varios nodos gestionan lecturas y escrituras simultáneamente. Es la única arquitectura escalable para canalizaciones de entrenamiento de IA y aprendizaje automático, la transcodificación de vídeo o el streaming de contenidos a volúmenes reales de producción.
- Sin dependencia de un proveedor con protocolos abiertos: Las API compatibles con S3, NFS y plataformas de código abierto como Ceph permiten a los equipos migrar entre proveedores o ejecutar la infraestructura en local sin reescribir el código de las aplicaciones.
- Eficiencia de costes a escala: El hardware estándar sustituye a costosas cabinas de almacenamiento propietarias. Además, la codificación de borrado reduce hasta un 50 % la capacidad bruta necesaria frente a la replicación completa entre nodos.
Limitaciones y retos del almacenamiento distribuido
- Complejidad de la consistencia: Mantener un estado coherente entre nodos exige ajustar con cuidado los modelos de consistencia, los factores de replicación y la configuración de quórum. Una mala configuración no da la voz de alarma: los datos se desvían poco a poco hasta divergir.
- Sobrecarga operativa: Gestionar un clúster de almacenamiento distribuido implica planificar los dominios de fallo, los procedimientos de sustitución de nodos, los sistemas de monitorización y el ajuste del rendimiento. Un único servidor no te exige nada de eso.
- Dependencia de la red: Toda la arquitectura presupone una conectividad fiable y de alto ancho de banda entre los nodos. Cualquier degradación de la red se traduce directa y proporcionalmente en más latencia y menos rendimiento de almacenamiento.
- Latencia en E/S aleatorias pequeñas: El almacenamiento distribuido está optimizado para lecturas secuenciales grandes y para el rendimiento en paralelo. Las cargas de trabajo con muchas E/S aleatorias pequeñas, sobre todo las bases de datos OLTP, suelen rendir mejor con almacenamiento de bloques NVMe conectado localmente.
- Escala mínima viable: Las ventajas de coste y complejidad del almacenamiento distribuido no se notan en un clúster de dos nodos. Por debajo de cierto umbral, un servicio de almacenamiento en la nube gestionado o un servidor único bien ajustado es, sencillamente, más barato y más fácil de operar.
Casos de uso reales del almacenamiento distribuido
- Medios y streaming: Netflix y YouTube no sirven el vídeo desde una ubicación central, sino que distribuyen el contenido codificado entre clústeres de almacenamiento de objetos situados geográficamente cerca de los espectadores. Un único centro de datos no puede gestionar retransmisiones globales simultáneas a esa escala; solo los costes de ancho de banda serían prohibitivos. El almacenamiento de datos distribuido es lo que hace viable la economía del streaming.
- Sanidad: Un solo estudio de resonancia magnética genera entre 500 MB y 1 GB de datos de imagen. Multiplícalo por una gran red hospitalaria, con distintas modalidades, largos periodos de conservación y varias sedes, y te encontrarás con petabytes que se acumulan muy deprisa. El almacenamiento distribuido escalable con redundancia geográfica es la forma en que los sistemas sanitarios mantienen un acceso conforme a HIPAA a los historiales de los pacientes, incluso cuando falla un centro de datos regional.
- IA y aprendizaje automático: Entrenar un modelo de lenguaje grande implica alimentar clústeres de GPU con terabytes o petabytes de datos, a los que se accede con patrones no secuenciales que saturarían casi de inmediato un sistema de almacenamiento tradicional. Ceph, HDFS y los almacenes de objetos compatibles con S3 se han convertido en la capa de infraestructura estándar para las canalizaciones de ML, porque su rendimiento de lectura en paralelo se ajusta realmente a lo que consumen los clústeres de GPU.
- Copias de seguridad y recuperación ante desastres: La recuperación real ante desastres exige que los datos existan en al menos dos ubicaciones geográficamente separadas, con dominios de fallo independientes, y no en dos bastidores del mismo edificio. Las políticas de replicación y las reglas de ubicación integradas en la capa de almacenamiento distribuido definen el RPO y el RTO a nivel de infraestructura, sin necesidad de una pila de software de copias de seguridad independiente. Tener menos componentes en movimiento también significa una superficie de ataque más pequeña.
Almacenamiento distribuido vs. descentralizado: ¿cuál es la diferencia?
El almacenamiento distribuido significa que los datos se reparten entre muchos nodos, pero una sola organización sigue siendo la propietaria y controla todo el sistema: las políticas, los derechos de acceso, la capacidad de eliminación y los registros de auditoría. El almacenamiento descentralizado elimina por completo esa autoridad central. Los datos se reparten entre pares independientes y ningún operador puede censurar, acceder o eliminar los datos de forma unilateral.
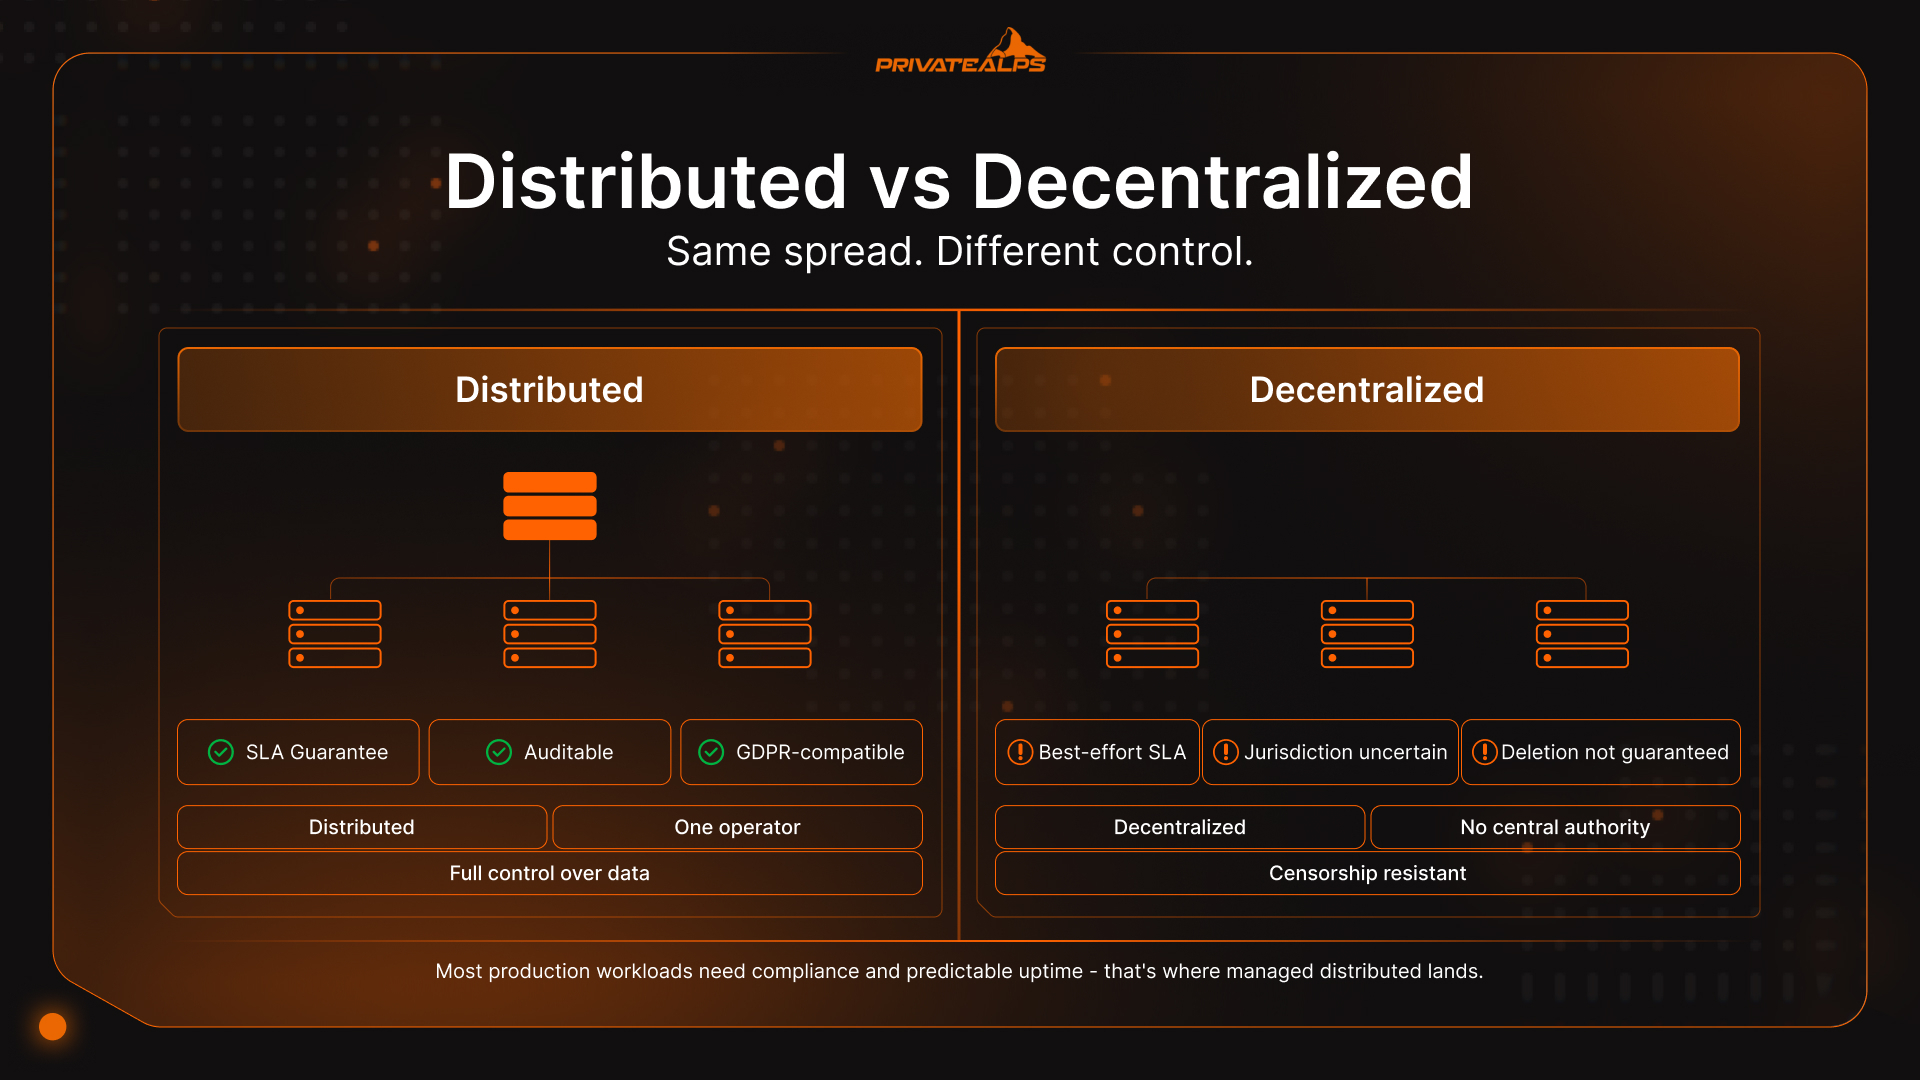
Esta distinción tiene consecuencias operativas reales. Un sistema distribuido gestionado de forma centralizada puede auditarse, parchearse, contar con un SLA y cumplir la normativa. Un sistema descentralizado renuncia a todo ello a cambio de resistencia a la censura y de operación sin necesidad de confianza. Es valioso en contextos concretos, pero no es lo que necesita la mayoría de las empresas que gestionan infraestructura de almacenamiento en producción.
| Dimensión | Almacenamiento distribuido | Almacenamiento descentralizado |
|---|---|---|
| Control | Administración centralizada | Sin autoridad central |
| SLA / garantías de disponibilidad | Garantías contractuales posibles | Mejor esfuerzo, según el protocolo |
| Cumplimiento | Auditable, compatible con el RGPD | Jurisdicción incierta |
| Eliminación de datos | Garantizada | No siempre posible |
| Control de acceso | Basado en roles, gestionado | Criptográfico, sin necesidad de confianza |
| Ejemplos | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Hay una capa más que conviene separar: el almacenamiento en la nube multirregión (AWS S3 con replicación entre regiones, Azure con almacenamiento georredundante) sigue siendo infraestructura administrada de forma centralizada. El proveedor gestiona los nodos y la replicación; en la práctica, estás alquilando la geografía. Las plataformas de nube distribuida auténticas, como Storj o Cubbit, reparten los datos entre operadores independientes, eliminan la dependencia de un proveedor, pero reabren las dudas sobre los SLA y los registros de auditoría. Para la mayoría de las cargas de trabajo que necesitan documentación de cumplimiento y una disponibilidad predecible, el enfoque distribuido gestionado es la opción más razonable.
Resumen
El almacenamiento distribuido no es un producto, sino una categoría arquitectónica, y la variante adecuada depende por completo de lo que vayas a ejecutar. El almacenamiento de objetos, el de bloques y el de archivos tienen cada uno un modelo de datos diseñado para patrones de acceso y cargas de trabajo distintos. El teorema CAP obliga a un compromiso real entre consistencia y disponibilidad en cuanto se producen fallos de red, y equivocarse en esa decisión puede salir caro. Y en cuanto a la replicación frente a la codificación de borrado, decide la temperatura de los datos: los datos «calientes» necesitan replicación para reducir la latencia, mientras que los datos «fríos» se benefician de la eficiencia de almacenamiento de la codificación de borrado. Para la mayoría de los equipos, una solución distribuida gestionada, ya sea de un proveedor privado o de la nube pública, siempre que la residencia de los datos y los controles de seguridad sean verificables, logra un mejor equilibrio entre escalabilidad, rendimiento y simplicidad operativa diaria que un clúster autoalojado.
Guarda tus datos en Suiza, con PrivateAlps
Si tu carga de trabajo necesita almacenamiento distribuido de objetos compatible con S3 y con residencia de datos verificable, PrivateAlps opera infraestructura con sede en Suiza y plenamente conforme con el artículo 45 del RGPD y con la nLPD. Tus datos permanecen en Suiza: sin compartirlos con terceros, sin enrutamientos ambiguos a través de jurisdicciones extranjeras y sin sorpresas. Tanto si vienes de abandonar un hiperescalador como si estás diseñando desde cero una arquitectura de almacenamiento distribuido centrada en la privacidad, PrivateAlps ofrece el rendimiento y la certeza de cumplimiento que tu carga de trabajo realmente necesita.
Preguntas frecuentes
¿Cuál es la diferencia entre el almacenamiento distribuido y el almacenamiento en la nube?
El almacenamiento en la nube es un modelo de prestación: otra empresa gestiona la infraestructura y tú accedes a ella por internet con un modelo de pago por uso. El almacenamiento distribuido es una arquitectura: los datos se reparten entre varios nodos para lograr redundancia y escalabilidad. Son conceptos independientes. Puedes ejecutar almacenamiento distribuido totalmente en local con Ceph o MinIO, y un proveedor de nube puede, en teoría, ofrecer almacenamiento centralizado detrás de una API. La mayoría de los servicios de almacenamiento en la nube usan arquitecturas distribuidas internamente, pero eso es un detalle de implementación, no la definición de almacenamiento en la nube.
¿Cuál es el mejor sistema de almacenamiento distribuido?
No hay una respuesta universal: depende de la carga de trabajo y del modelo de datos. Para datos no estructurados y copias de seguridad, los almacenes de objetos compatibles con S3, como MinIO o Ceph RADOS, son la opción estándar. Para volúmenes de bases de datos y discos de máquinas virtuales que necesitan E/S de bloques consistente y de baja latencia, Ceph RBD o Lightbits encajan mejor. Para sistemas de archivos compartidos en entornos HPC o heredados, suelen elegirse GlusterFS o HDFS. Empieza por el patrón de acceso: el sistema de almacenamiento se deduce de ahí.
¿El almacenamiento distribuido es lo mismo que RAID?
No. RAID funciona dentro de un único servidor o de una única cabina de almacenamiento y protege frente a fallos de disco dentro de una misma máquina. El almacenamiento distribuido funciona entre nodos físicos separados conectados por red, que pueden abarcar varios edificios o centros de datos completos. RAID no sirve de nada cuando falla el propio servidor. Los sistemas de almacenamiento distribuido están diseñados específicamente para tolerar fallos de nodo, de bastidor y caídas completas de un centro de datos. La diferencia de alcance es fundamental.
¿Cómo gestiona el almacenamiento distribuido los fallos de nodo?
Los nodos envían señales de latido periódicas a la capa de metadatos del clúster. Cuando un nodo deja de responder, el sistema detecta el fallo, normalmente en cuestión de segundos, y redirige las peticiones a los nodos que contienen las réplicas o los fragmentos codificados. En las configuraciones basadas en replicación, un proceso de recuperación en segundo plano crea nuevas copias para restablecer el factor de replicación configurado en todo el clúster. Todo el proceso es automático: en un clúster de almacenamiento distribuido bien configurado, las aplicaciones ni siquiera llegan a notar el fallo.
¿Es adecuado el almacenamiento distribuido para pequeñas empresas?
Los servicios de almacenamiento distribuido gestionados, ya sea el almacenamiento de objetos compatible con S3 de un proveedor de nube o el de un especialista como PrivateAlps, funcionan a cualquier escala y no exigen un tamaño mínimo de clúster. Los clústeres de almacenamiento distribuido autoalojados son otra historia: ejecutar Ceph en producción suele requerir entre tres y cinco nodos antes de que la sobrecarga operativa empiece a compensar. Para los equipos pequeños, los servicios gestionados ofrecen todas las ventajas arquitectónicas del almacenamiento distribuido sin la carga de gestionar la infraestructura.
