


分散ストレージとは?仕組み・種類・ユースケースを解説
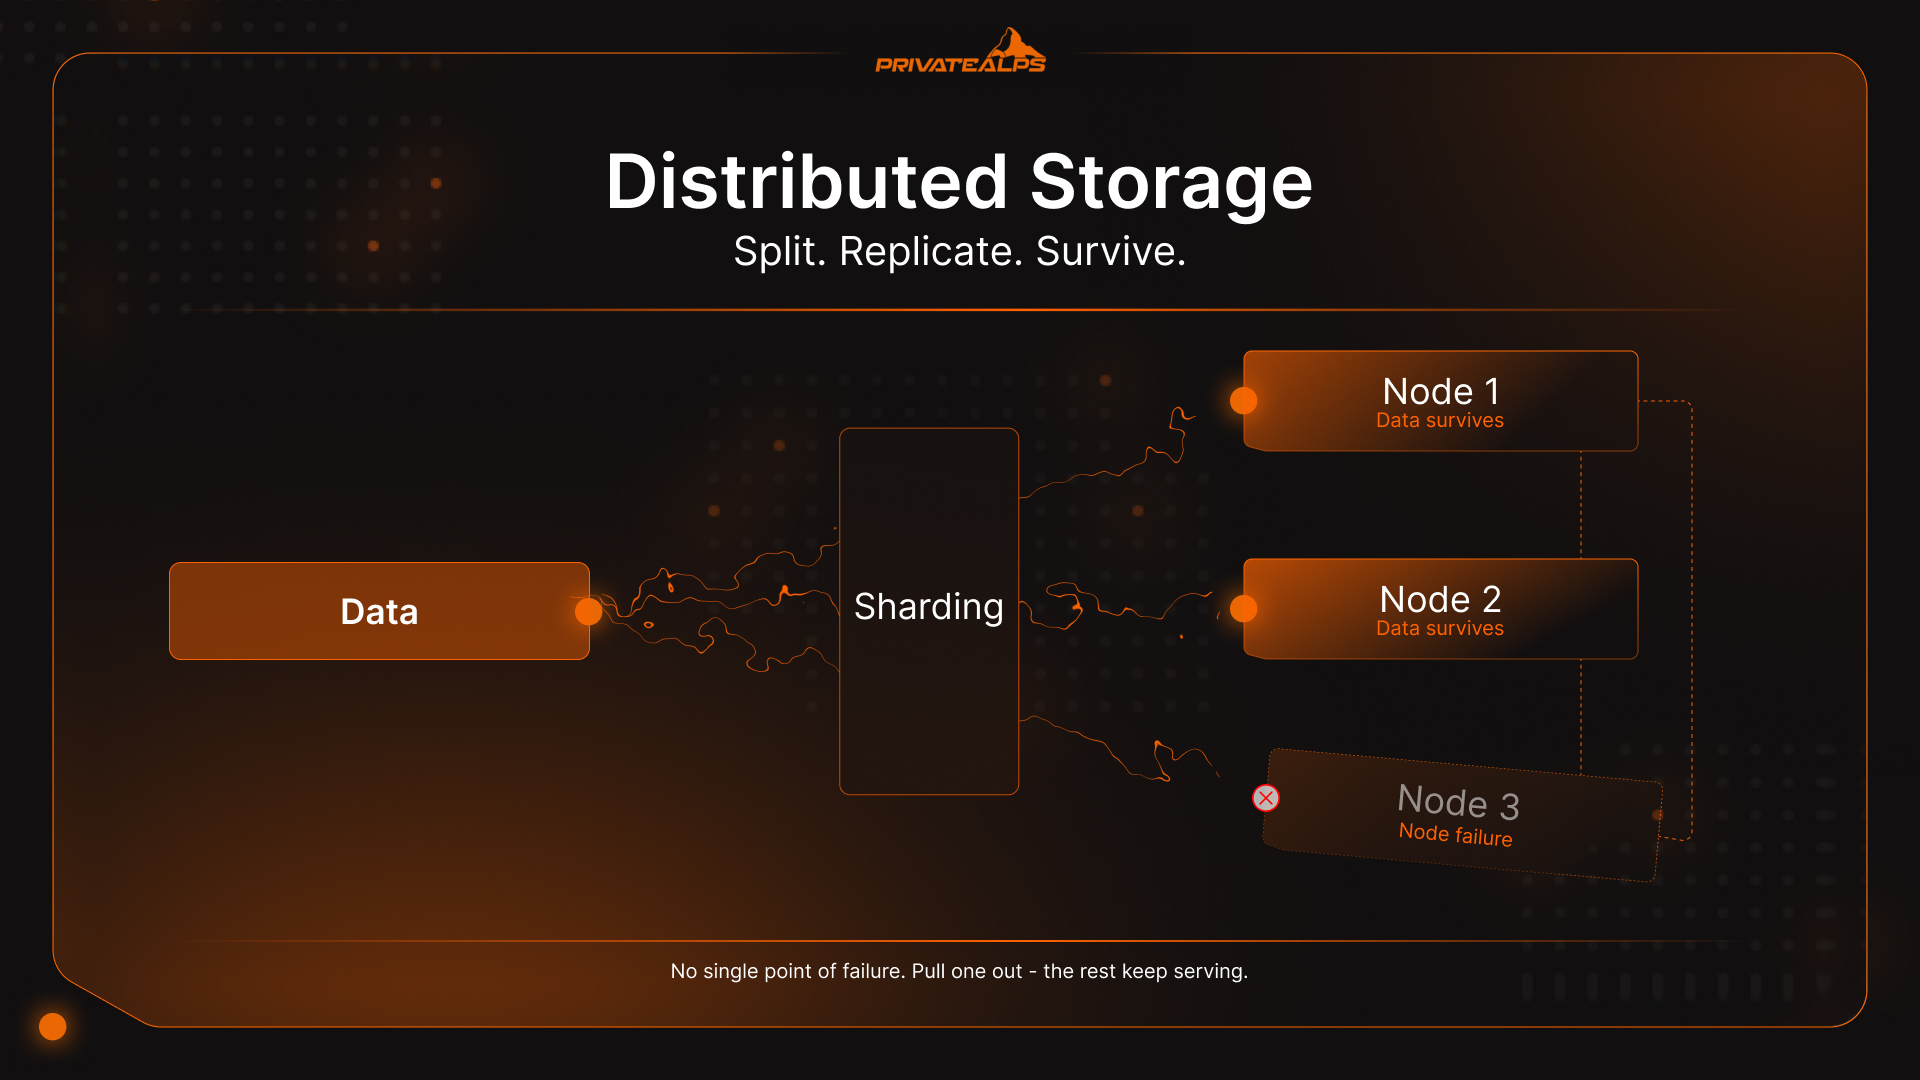
分散ストレージは、1台のマシンでは信頼性高く保持しきれないほど大きく、重要で、アクセスが集中するデータを扱うための仕組みです。すべてのデータを1台のサーバーに書き込むのではなく、データを分割、複製、または符号化し、複数の独立したノード(サーバー、ドライブ、データセンター)に配置します。ノード同士は連携して動作しますが、どの単一ノードもすべてのデータを保持しているわけではありません。1台を取り外しても、残りのノードがサービスを継続します。本ガイドでは、分散ストレージシステムが負荷の高い状況で実際にどのように動作するか、どのようなアーキテクチャ上のトレードオフが生じるか、そしてどのストレージ種別がどのワークロードに適しているかを解説します。
AI要約
分散ストレージは、データを複数の物理ノードに分割して配置するソフトウェア定義型のアーキテクチャです。中核となる技術は次の3つです。シャーディング(データを個別のチャンクに分割し、異なるノードに振り分ける)、レプリケーション(複数の同一コピーをノード間に保持し、高速なアクセスを可能にする)、消失訂正符号(データをパリティ付きの断片に符号化し、一部の断片から全体を復元できるようにする)。
分散ストレージシステムには主に3種類あります。オブジェクトストレージ(フラットな名前空間、S3互換API)、ブロックストレージ(低遅延のランダムI/O向けの固定サイズボリューム)、ファイルストレージ(NFSまたはSMBによる階層型の名前空間)です。どの分散データストレージ構成もCAP定理の制約を受けます。整合性、可用性、分断耐性のうち、同時に保証できるのは2つだけです。
運用面での中核的なメリットは、ノードの障害がサービス停止につながらないことです。システムが生き残ったレプリカへ自動的にリクエストを振り分けます。
扱うデータ量の規模を示すと、人類は現在、毎日4億テラバイトを超える新しいデータを生成しています。これは、集中型アーキテクチャでは、いずれ自らの重みで崩壊せずに吸収できない量です。
分散ストレージと集中型ストレージの違い
集中型ストレージは、すべてを1か所に配置します。1台のサーバー、1台のSAN、1つのデータセンターです。それがモデルの全体です。その場所に問題が起きると、すべてが停止します。分散ストレージは、この問題を直接解決します。データを複数の独立したノードに分散させるため、単一の障害点によってシステム全体が停止したり、すべてのアクセスがブロックされたりすることがありません。
ハードウェアが1台故障すると、アクセスは止まります。それで終わりです。拡張するには、主要システムをアップグレードするか交換する必要があり、通常はダウンタイムと、誰も避けたい設備投資の検討が伴います。分散ストレージは、設計上この両方を回避します。ノードを追加すれば容量を増やせ、ノードが故障しても、クラスターがそのノードを迂回してリクエストを処理します。大きな混乱もサービス停止もありません。データは、何かが壊れる前からすでに複数のノードに存在していたのです。
| 比較項目 | 集中型ストレージ | 分散ストレージ |
|---|---|---|
| 耐障害性 | 単一障害点がある | 個々のノードを失ってもデータが残る |
| 拡張性 | 垂直(ハードウェアをアップグレード) | 水平(ノードを追加) |
| 遅延 | ローカルアクセスでは低い | 変動し、ネットワークトポロジーに依存する |
| 小規模時のコスト | 初期費用が低い | 最小構成のクラスターのコストが高い |
| 大規模時のコスト | 拡張コストが高い | 汎用ハードウェアによりコストを抑えられる |
| 地理的分散 | 単一拠点 | 設定により複数リージョンに対応 |
| 運用の複雑さ | 管理が簡単 | オーケストレーションツールが必要 |
分散ストレージシステムの仕組み
分散ストレージシステムは、受け取ったデータをチャンクに分割し、クラスター内の適切なノードへ振り分け、メタデータレイヤーを通じてすべての断片を追跡します。これにより、どのノードが保持していても、必要に応じて任意の断片を特定、取得、再構成できます。これが基本的な流れです。その仕組みを支える中核技術は次の4つです。
- シャーディング(データ分割) データが書き込まれると、システムはデータを「シャード」または「ブロック」と呼ばれる小さな単位に分割し、複数のノードに分散させます。これにより並列I/Oが可能になります。複数のノードが同時に読み書きを処理するため、スループットは1台の上限ではなく、クラスターの規模に応じて向上します。ルーティングには一般的に一貫性ハッシングが用いられます。これにより、ノードを追加するたびにすべてを再配置することなく、クラスターが拡大してもデータの分散が均等に保たれます。
- レプリケーション 単純ですが効果的な方法です。各シャードの同一コピーを別々のノードにN個(通常は3つ)保存します。1つのノードがオフラインになっても、残りの2つがすぐにサービスを継続します。再構成も待ち時間もありません。レプリケーションは、ホットデータ、つまりアクティブなデータベース、リアルタイムのフィード、読み取りの1ミリ秒の遅延が実際に影響するような用途に適しています。
- 消失訂正符号 ストレージ効率の計算が興味深くなるのがこの部分です。3つの完全なコピーを保存する代わりに、システムはオブジェクトを$k$個のデータ断片と$m$個のパリティ断片に符号化し、$k+m$個すべてをノードに分散させます。そして、そのうちの任意の$k$個から元のオブジェクト全体を復元できます。そのため、$m$個のノードが同時に故障しても、データは失われません。Reed-Solomon RS(6,3)構成では、3倍のレプリケーションで必要となる18ブロックではなく9ブロックを保存するため、生の保存容量のオーバーヘッドを200%から約50%へ削減できます。ただし、符号化と復号にはCPUリソースが必要になります。また、消失訂正符号は、頻繁に変更されない、またはアクセス頻度の低いコールドデータに適しています。小さな書き込みが頻繁に発生するワークロードでは、遅延の面で3倍のレプリケーションの方が依然として優れています。
| 保護方式 | ストレージのオーバーヘッド | 適した用途 | トレードオフ |
|---|---|---|---|
| 3倍レプリケーション | 生の容量の3倍 | ホットデータ、低遅延のワークロード | 規模が大きくなるとストレージコストが高い |
| 消失訂正符号 RS(6,3) | 生の容量の1.5倍 | コールドデータ、アーカイブ、大容量オブジェクト | CPU負荷が高く、再構築の遅延も大きい |
- メタデータルーティング 分散ストレージシステムはすべて、メタデータレイヤーを保持しています。これは基本的に、どのシャードがどのノードにあるかを示すマップです。クライアントがデータを要求すると、メタデータサービスが適切なノードを特定し、クライアントがその複雑さを意識することなく、システムが断片を取得して再構成します。CephやHDFSのような大規模クラスターでは、メタデータレイヤー自体が複数のノードに分散されています。そうでなければなりません。単一のメタデータサーバーは、まさに逃れようとしていたボトルネックになってしまうからです。
分散ストレージシステムの種類
分散ストレージは単一のものではありません。その下には3つの異なるデータモデルがあるカテゴリーです。ワークロードに合わないモデルを選んでしまうことは、意外にもよくあり、かつ高くつく失敗です。オブジェクト、ブロック、ファイルストレージは、それぞれ異なる課題を解決します。分散データベースであるCassandra、CockroachDB、Google Spannerは4つ目の種類にあたり、分散データ管理の上にクエリの仕組みを重ねたものですが、これは別の話題になります。
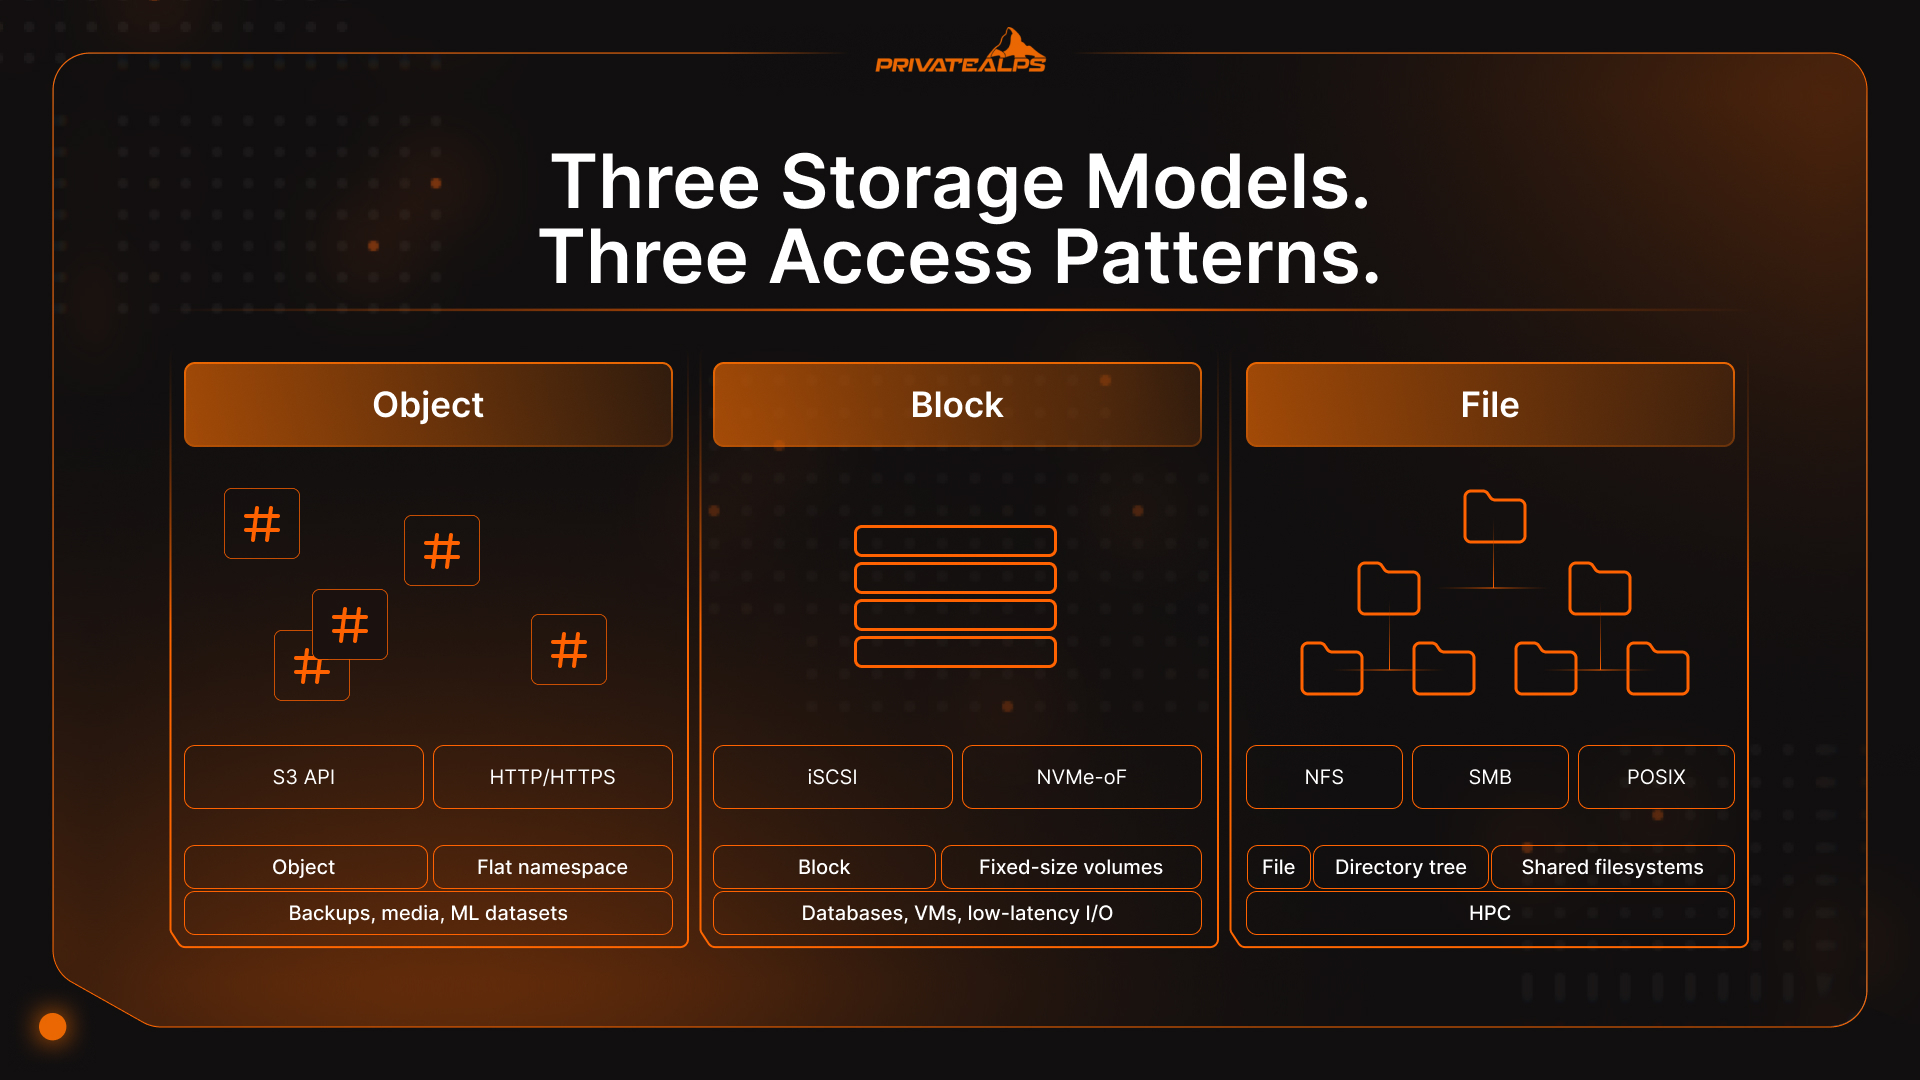
| 種類 | データの保存方法 | アクセス方式 | 適した用途 | 例 |
|---|---|---|---|---|
| オブジェクト | フラットな名前空間、メタデータが豊富なオブジェクト | S3互換API(HTTP/HTTPS) | 大規模な非構造化データ:バックアップ、メディア、ML用データセット | AWS S3、MinIO、Ceph RADOS |
| ブロック | 固定サイズの生ボリューム | iSCSI、NVMe-oF、FC | データベース、VM、低遅延のランダムI/O | Ceph RBD、AWS EBS、Lightbits |
| ファイル | 階層型のディレクトリツリー | NFS、SMB、POSIX | 共有ファイルシステム、HPC、ホームディレクトリ | GlusterFS、HDFS、Azure Files |
分散オブジェクトストレージ
分散オブジェクトストレージは、データをフラットな名前空間に配置された個別の不変のオブジェクトとして管理します。ディレクトリ、ファイルパス、維持すべき階層構造はありません。各オブジェクトには一意の識別子(ハッシュまたはUUID)と豊富なメタデータが付与され、HTTP上のS3互換APIを通じてアクセスします。オブジェクトは部分的に更新されるのではなく置き換えられるため、ブロックやファイルシステムで性能を制約し、拡張性を限定していたロックの問題がなくなります。これにより、AWS S3、Azure Blob、Cephはエクサバイト規模まで拡張できます。名前空間の調整によるオーバーヘッドも、ロックの競合もなく、クラスター内の任意のノードが独立して任意のオブジェクトリクエストに応答できるからです。
分散ブロックストレージ
ブロックストレージは、生のボリュームをサーバーに提供します。固定サイズのブロックに一意のアドレスが割り当てられ、その上にファイルシステムの抽象化はありません。アプリケーションはブロックに直接書き込むため、データベース、VMディスク、コンテナ化されたワークロードに対して、安定した低遅延のランダムI/Oを実現します。見落とされやすい制約が1つあります。ブロックボリュームは通常、一度に1台のサーバーからしかマウントできません。複数のサーバーで共有するには、ブロックデバイスの上にクラスターファイルシステムを重ねるなど、追加のオーケストレーションが必要です。
分散ファイルストレージ
ファイルストレージは、NFS、SMB、POSIX互換のアクセスといった標準プロトコルを通じて、共有ファイルシステムを提供します。複数のクライアントが同じボリュームを同時にマウントできるため、共同作業のワークロード、HPC環境、ディレクトリツリーを前提とし、近いうちに書き直される予定のないレガシーアプリケーションに適しています。実際のトレードオフは次のとおりです。分散ノード全体で一貫したディレクトリ名前空間を維持すると、規模が大きくなるほど増す調整のオーバーヘッドが生じます。ほとんどのハイパースケーラーは、ボリュームが十分に大きくなると、主要データの保存先を分散ファイルストレージから分散オブジェクトストレージへ移行します。
CAP定理:分散ストレージで避けられないトレードオフ
CAP定理は、分散データシステムが同時に保証できるのは3つのうち2つだけだと述べています。3つとは、一貫性(すべての読み取りが最新の書き込みを返す)、可用性(すべてのリクエストに応答がある)、分断耐性(ネットワークが分断されてもシステムが稼働し続ける)です。ネットワークは分断されるものなので、分断耐性は任意ではありません。実際の判断は、障害が発生したときに一貫性と可用性のどちらを優先するかに常に集約されます。
[Eric Brewerは2000年にCAPを提唱し、GilbertとLynchが2002年にその証明を形式化しました][https://www.scylladb.com/glossary/cap-theorem/]。この定理は、分散ストレージのアーキテクチャにおける他のあらゆる判断を今でも方向づけています。システムがまさに最も必要とされる瞬間、つまり既に何かが壊れている状態でどう振る舞うかを決めるからです。
| システム | CAPの分類 | 分断時の動作 | 適した用途 |
|---|---|---|---|
| MongoDB | CP(過半数の読み書き保証を使用した場合) | 一貫性が回復するまでリクエストを拒否する | 金融記録、在庫、予約 |
| HBase | CP | 古いデータを返す代わりにエラーを返す | 構造化された分析、一貫性が求められるバッチ処理 |
| Apache Cassandra | AP | 可用性を維持し、古い読み取りを返すことがある | ソーシャルフィード、メッセージング、IoTのテレメトリー |
| DynamoDB(デフォルト) | AP | 常に応答し、不整合は非同期で調整する | 高スループットのコンシューマー向けアプリ |
| CockroachDB | CP | 一貫性を優先し、分散SQLを提供する | グローバルなトランザクション処理 |
実務上の判断基準はこうです。ワークロードは古い読み取りを許容できるでしょうか。銀行の残高、座席の予約、在庫数は、おそらく許容できません。その場合はCPを選びます。ソーシャルフィード、センサーのイベントストリーム、分析用のテレメトリーでは、数秒の古さは問題ないことが多いでしょう。その場合はAPを選び、可用性の保証を優先します。
分散ストレージのセキュリティ:暗号化とデータ主権
分散ストレージのセキュリティは、保存データ、転送中のデータ、鍵の所有権という3つの異なる層で成り立っています。どれか1つでも誤ると、他の層では補えません。インフラが問題なく稼働していても、機密データが不適切な相手から密かにアクセスされている場合があります。
暗号化は3つの層すべてを対象にする必要があります。保存データには通常AES-256を使用し、プロバイダー管理の鍵か顧客管理の鍵(CMK)のいずれかで管理します。プロバイダー管理の鍵は運用が簡単ですが、鍵の情報をストレージ事業者が保持します。監査を受ける規制業界では、これが重要なセキュリティ上の検討事項になります。クライアント側の暗号化を使うと、このリスクを完全に排除できます。データはクライアントを出る前に暗号化されるため、どのような法的要請があっても、プロバイダーが平文に触れることはありません。転送中のデータについては、TLS 1.3が最低限のセキュリティ基準です。TLS 1.2を許可し続けている場合は、現在の多くのコンプライアンス枠組みで文書化された例外申請が必要になります。
データ主権は、チームが見落としやすい点です。データには、物理的に保存されている場所の法律が適用されます。会社の所在国やユーザーの所在地では決まりません。スイスはGDPR第45条に基づく十分性認定を受けているため、EUからスイスへのデータ移転では、追加の契約上の保護措置は不要です。改正された連邦データ保護法(nFADP)は、スイス国内のルールをGDPRに適合させています。そのため、スイスのインフラは両方の枠組みに対して、一貫した規制対応を同時に提供します。
後回しにしがちですが、対応しておくべき点があります。現在多くのストレージ基盤を保護している暗号アルゴリズムは、高性能な量子コンピュータに耐えられるようには設計されていません。NISTは2024年8月に3つの耐量子暗号標準を最終決定しました。その中にはFIPS 203(ML-KEM)も含まれます。分散データストレージに、医療記録、金融記録、法的文書などの長期保存が必要なデータがある場合、「今収集して後で復号する」という脅威モデルはすでに現実のものです。移行の検討は、これらのアーカイブが寿命を迎えるよりずっと前に始めるべきです。
分散ストレージの主なメリット
- サービスを止めずに耐障害性を確保: ノードに障害が起きると、ハートビート検出により、稼働中のレプリカへ自動的に振り分けられます。手動の対応も、メンテナンス時間も必要ありません。
- 水平スケーラビリティ: 新たなストレージ容量は、クラスターにノードを追加することで確保できます。データはバックグラウンドで再配置され、稼働中のトラフィックに影響せず、停止も不要です。
- 地理的な分散: リージョン間でレプリケーションを行うと、地理的に離れたユーザーへの遅延を減らせます。さらに、データの所在地に関するコンプライアンスも、インフラ構築の大規模プロジェクトではなく、設定の判断で対応できるようになります。
- 並列I/Oのスループット: 複数のノードが読み書きを同時に処理します。実運用の規模でAI/ML学習パイプライン、動画トランスコード、メディアストリーミングを支えられる、唯一のスケーラブルな構成です。
- オープンプロトコルによるベンダーロックインの回避: S3互換API、NFS、そしてCephのようなオープンソース基盤を使うと、アプリケーションコードを書き直さずに、プロバイダー間の移行やオンプレミスでの運用ができます。
- 大規模運用でのコスト効率: 汎用ハードウェアが高価な専用ストレージアレイに代わります。さらに、イレイジャーコーディングを使うと、ノード間での完全なレプリケーションと比べて、必要な物理容量を最大50%削減できます。
分散ストレージの限界と課題
- 整合性の複雑さ: ノード間で一貫した状態を保つには、整合性モデル、レプリケーション係数、クォーラム設定を慎重に調整する必要があります。設定を誤ってもすぐには表面化せず、データが静かに食い違っていきます。
- 運用負荷: 分散ストレージクラスターの運用では、障害ドメインの設計、ノードの交換手順、監視パイプライン、性能チューニングを自ら担う必要があります。単一のサーバーであれば、ここまでの作業は求められません。
- ネットワークへの依存: この構成は、ノード間の信頼性が高く広帯域な接続を前提としています。ネットワークが劣化すると、その影響はストレージの遅延とスループット低下として、そのまま比例して現れます。
- 小さなランダムI/Oの遅延: 分散ストレージは、大きな連続読み取りと並列スループットに最適化されています。小さなランダムI/Oが多いワークロード、特にOLTPデータベースでは、ローカル接続のNVMeブロックストレージの方が性能が良いことが多くあります。
- 最低限の実用規模: 分散ストレージのコストと複雑さの利点は、2ノードのクラスターでは現れません。一定の規模を下回る場合は、マネージドのクラウドストレージサービスや、適切にチューニングされた単一サーバーの方が、単純に安く、運用も簡単です。
分散ストレージの実際のユースケース
- メディアとストリーミング NetflixやYouTubeは、動画を中央の拠点から配信していません。視聴者の近くに配置されたオブジェクトストレージクラスター全体に、エンコード済みのコンテンツを分散させています。1つのデータセンターでは、世界中の同時配信を大規模に処理することはできません。帯域コストだけでも非現実的な額になります。分散データストレージは、ストリーミングの経済性を実際に成り立たせている仕組みです。
- 医療 MRI検査1件で、500MBから1GBの画像データが生成されます。これを大規模な病院ネットワークに掛け合わせると、モダリティの違い、長期保存の要件、複数拠点などが絡み、ペタバイト規模のデータが急速に蓄積されていきます。地理的な冗長性を備えたスケーラブルな分散ストレージは、地域のデータセンターに障害が起きた場合でも、医療機関がHIPAA準拠で患者記録にアクセスし続けるための仕組みです。
- AIと機械学習 大規模言語モデルを学習させるには、GPUクラスターに数テラバイトから数ペタバイトのデータを供給する必要があります。そのアクセスは非連続的で、従来のストレージシステムはすぐに飽和してしまいます。Ceph、HDFS、S3互換のオブジェクトストアは、並列読み取りのスループットがGPUクラスターの消費量に実際に見合うため、MLパイプラインの標準的なインフラ層になっています。
- バックアップと災害復旧 本当の意味での災害復旧とは、独立した障害ドメインを持つ、地理的に離れた少なくとも2か所にデータが存在することです。同じビル内の2つのラックでは不十分です。分散ストレージ層に直接組み込まれたレプリケーションポリシーと配置ルールによって、別途バックアップソフトウェアを導入しなくても、インフラのレベルでRPOとRTOを定義できます。構成要素が少なければ、攻撃対象領域も小さくなります。
分散ストレージと分散型ストレージの違い:何が異なるのか?
分散ストレージでは、データは多数のノードに分散されますが、ポリシー、アクセス権、削除の権限、監査ログなどの全体を、1つの組織が依然として所有し管理しています。一方、分散型ストレージは、その中央の権限を完全に取り除きます。データは独立したピア同士で保存され、単独の運用者が一方的に検閲、アクセス、削除することはできません。
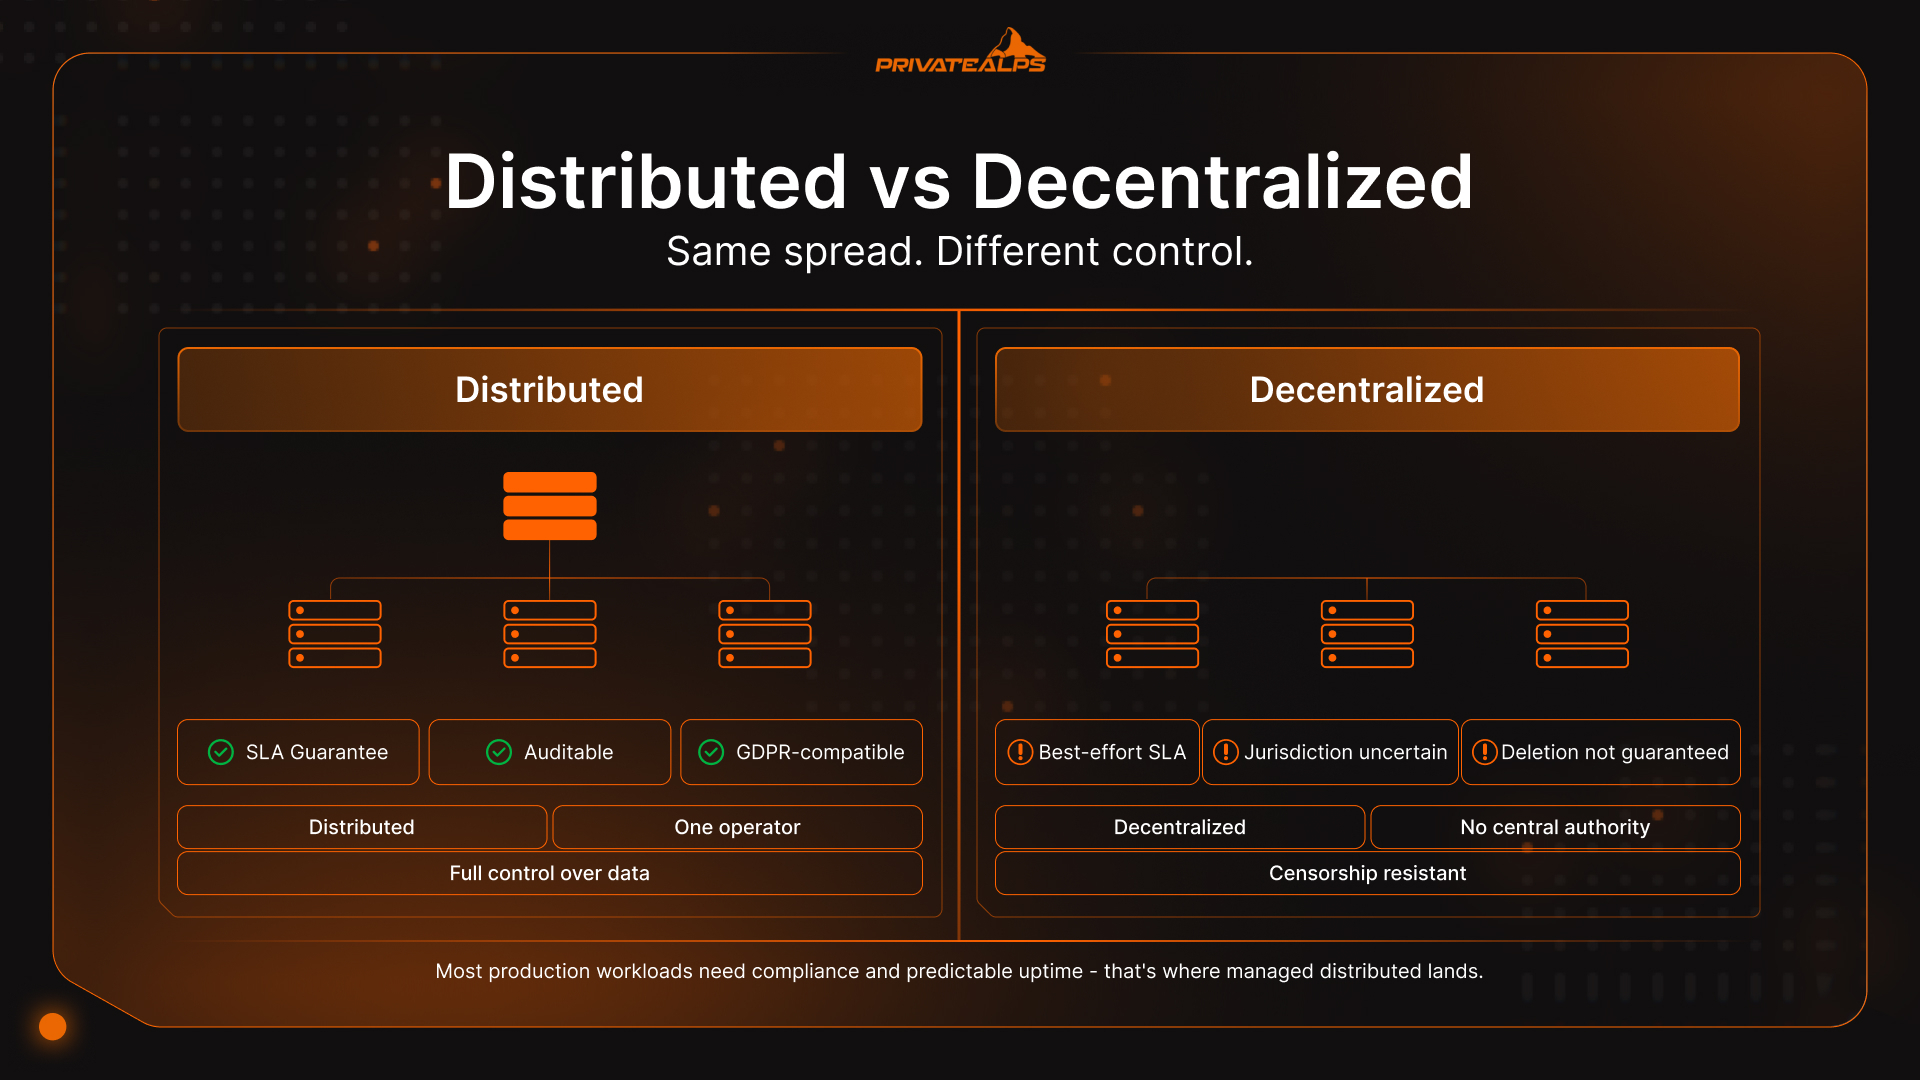
この違いは、運用面で実際の影響をもたらします。中央で管理される分散システムは、監査、パッチ適用、SLAの保証、規制への準拠が可能です。分散型システムは、これらと引き換えに、検閲への耐性と信頼不要の運用を得ます。特定の場面では価値がありますが、本番のストレージ基盤を運用するほとんどの企業が必要としているものではありません。
| 比較項目 | 分散ストレージ | 分散型ストレージ |
|---|---|---|
| 管理 | 中央で管理 | 中央の管理主体なし |
| SLA / 稼働率の保証 | 契約上の保証が可能 | ベストエフォート、プロトコル依存 |
| コンプライアンス | 監査可能、GDPRに対応可能 | 管轄が不明確 |
| データ削除 | 保証される | 必ずしも可能ではない |
| アクセス制御 | ロールベース、管理される | 暗号ベース、信頼不要 |
| 例 | AWS S3、Azure Blob、Ceph | Storj、Filecoin、IPFS |
もう1つ区別しておきたいのが、マルチリージョンのクラウドストレージです。リージョン間レプリケーションを使うAWS S3や、Azureの地理冗長ストレージは、依然として中央で管理されたインフラです。ノードとレプリケーションを管理するのはプロバイダーであり、利用者は実質的に「地理的な配置」を借りているにすぎません。StorjやCubbitのような真の分散型クラウドプラットフォームは、独立した運用者にわたってデータを振り分けます。プロバイダーへのロックインは減りますが、SLAや監査証跡に関する懸念が再び生じます。コンプライアンス文書と予測可能な稼働率が求められるほとんどのワークロードでは、マネージドの分散型アプローチが適切な選択になります。
まとめ
分散ストレージは製品ではなく、アーキテクチャの分類です。どの種類を選ぶべきかは、何を運用するかによって完全に決まります。オブジェクトストレージ、ブロックストレージ、ファイルストレージには、それぞれ異なるアクセスパターンとワークロードに向けて設計されたデータモデルがあります。CAP定理により、ネットワーク障害が起きた瞬間に、整合性と可用性の間で避けられないトレードオフが生じます。この判断を誤ると、コストが大きくなることがあります。レプリケーションとイレイジャーコーディングのどちらを選ぶかは、データの温度で決まります。ホットデータは低遅延のためにレプリケーションが必要で、コールドデータはイレイジャーコーディングの容量効率の恩恵を受けます。多くのチームにとって、データの所在地とセキュリティ管理を検証できるかぎり、プライベートプロバイダーでもパブリッククラウドでも、マネージドの分散ソリューションが最適です。スケーラビリティ、性能、日々の運用の簡単さのバランスにおいて、自前で構築したクラスターよりも優れています。
スイスにデータを保存するならPrivateAlps
ワークロードで、データの所在地を検証できるS3互換の分散オブジェクトストレージが必要な場合は、PrivateAlpsが役立ちます。PrivateAlpsはスイス国内のインフラを運用しており、GDPR第45条とnFADPの両方に完全に準拠しています。データはスイス国内に留まり、第三者との共有はなく、外国の法域を経由する不透明な経路もありません。ハイパースケーラーからの移行を検討している場合でも、プライバシー重視の分散ストレージ基盤をゼロから構築する場合でも、PrivateAlpsは、ワークロードが実際に必要とする性能とコンプライアンスの確実性を提供します。
よくある質問
分散ストレージとクラウドストレージの違いは何ですか?
クラウドストレージは提供モデルです。インフラは他社が管理し、利用者は従量課金でインターネット経由にアクセスします。分散ストレージはアーキテクチャです。冗長性とスケーラビリティのために、データを複数のノードに分散させます。両者は独立した概念です。CephやMinIOを使えば、分散ストレージを完全にオンプレミスで運用できます。一方で、クラウドプロバイダーがAPIの背後で集中型ストレージを提供することも技術的には可能です。多くのクラウドストレージサービスは内部で分散アーキテクチャを使っていますが、それは実装の詳細であり、クラウドストレージの定義そのものではありません。
最適な分散ストレージシステムはどれですか?
万人に共通する答えはありません。ワークロードとデータモデルによって決まります。非構造化データやバックアップには、MinIOやCeph RADOSなどのS3互換オブジェクトストアが標準的な選択肢です。データベースのボリュームやVMのディスクで、一貫性のある低遅延のブロックI/Oが必要な場合は、Ceph RBDやLightbitsの方が適しています。HPCやレガシー環境の共有ファイルシステムでは、GlusterFSやHDFSが一般的です。まずアクセスパターンを検討してください。ストレージシステムは、そこから決まります。
分散ストレージはRAIDと同じですか?
いいえ、同じではありません。RAIDは1台のサーバーまたはストレージアレイの中で動作し、その1台の内部でのディスク障害から保護します。分散ストレージは、ネットワークで接続された別々の物理ノードをまたいで動作します。複数のビルや、データセンター全体にまたがることもあります。サーバー自体が故障した場合、RAIDは役に立ちません。分散ストレージシステムは、ノードの障害、ラックの障害、データセンター全体の停止に耐えるように、特別に設計されています。対象範囲の違いは本質的なものです。
分散ストレージは、ノードの障害をどのように処理しますか?
各ノードは、クラスターのメタデータ層に定期的にハートビート信号を送ります。ノードが応答を停止すると、システムは通常数秒以内に障害を検出し、リクエストをレプリカまたはイレイジャーコーディングの断片を保持するノードへ振り分けます。レプリケーション方式では、バックグラウンドの復旧プロセスが新しいコピーを作成し、クラスター全体で設定されたレプリケーション係数を回復させます。この一連の処理は自動的に行われます。適切に設定された分散ストレージクラスターでは、アプリケーションが障害をまったく認識しないことも多くあります。
分散ストレージは中小企業にも適していますか?
はい、適しています。クラウドプロバイダーのS3互換オブジェクトストレージや、PrivateAlpsのような専門サービスなどのマネージドな分散ストレージサービスは、規模を問わず利用でき、最小限のクラスター構成は必要ありません。一方、自前で運用する分散ストレージクラスターは事情が異なります。Cephを本番で運用するには、通常3〜5ノード以上が必要で、その運用負荷が見合うようになるまでには時間がかかります。少人数のチームには、マネージドサービスが、インフラ管理の負担なしに分散ストレージのアーキテクチャ上のメリットをすべて提供します。
