


Czym jest rozproszone przechowywanie danych?
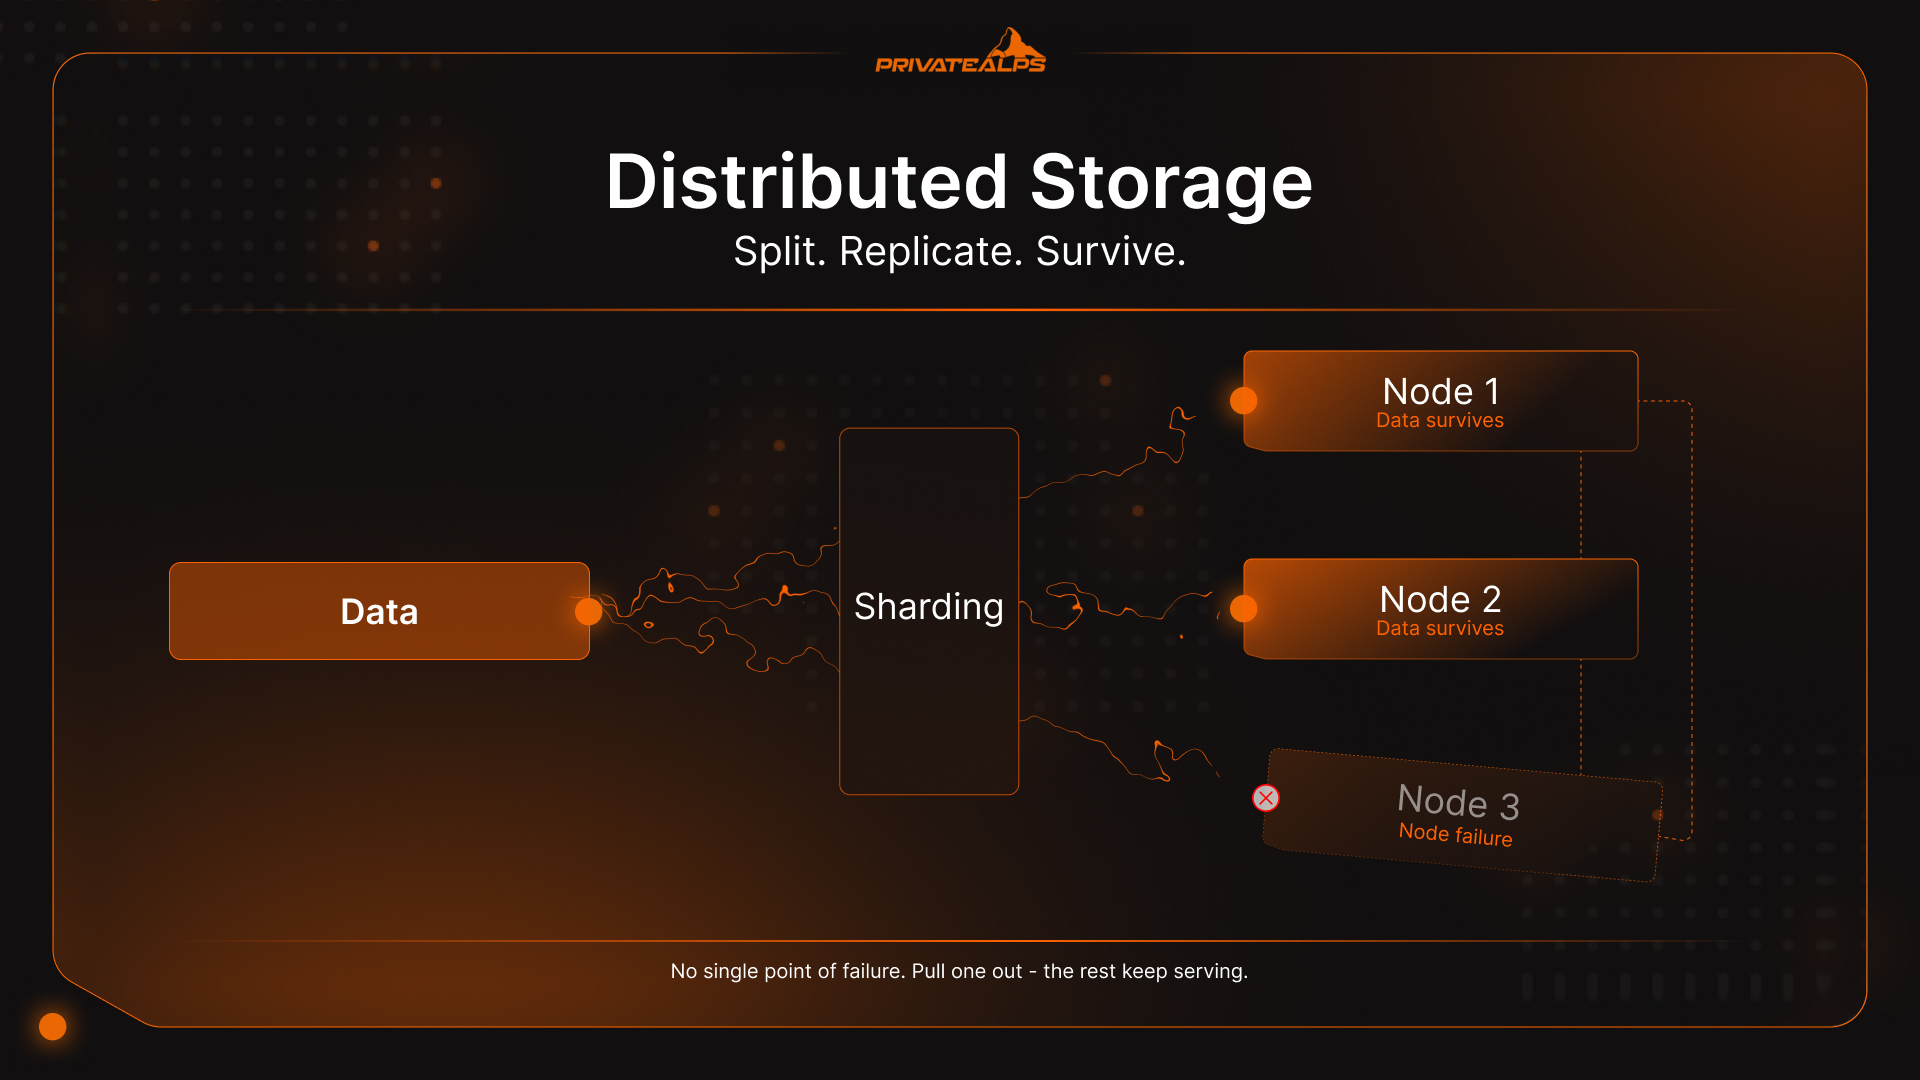
Rozproszone przechowywanie danych to sposób, w jaki nowoczesna infrastruktura radzi sobie z danymi, które są zbyt duże, zbyt krytyczne lub zbyt intensywnie wykorzystywane, by jedna maszyna mogła je niezawodnie przechowywać. Zamiast zapisywać wszystko na jednym serwerze, system dzieli, replikuje lub koduje te dane na wielu niezależnych węzłach: serwerach, dyskach, centrach danych. Działają one wspólnie, ale żaden pojedynczy węzeł nie przechowuje wszystkiego. Gdy jeden z nich wypadnie, pozostałe nadal obsługują żądania. Ten przewodnik wyjaśnia, jak systemy rozproszonego przechowywania danych faktycznie działają pod obciążeniem, jakie kompromisy architektoniczne ze sobą niosą i który typ pamięci masowej pasuje do którego zastosowania.
Podsumowanie AI
Rozproszone przechowywanie danych to programowo definiowana architektura, która dzieli dane między wiele fizycznych węzłów, korzystając z trzech podstawowych technik: sharding (podziału danych na odrębne fragmenty kierowane do różnych węzłów), replikacja (utrzymywania wielu identycznych kopii na różnych węzłach w celu szybkiego dostępu) oraz kodowanie korekcyjne (kodowania danych we fragmenty z parzystością matematyczną, dzięki której dowolny podzbiór pozwala odtworzyć całość).
Istnieją trzy główne typy rozproszonych systemów przechowywania danych: storage obiektowy (płaska przestrzeń nazw, interfejs API zgodny z S3), pamięć blokowa (woluminy o stałym rozmiarze do losowego I/O o niskim opóźnieniu) oraz pamięć plikowa (hierarchiczna przestrzeń nazw przez NFS lub SMB). Każde rozproszone przechowywanie danych podlega twierdzeniu CAP: system może jednocześnie zagwarantować tylko dwie z trzech właściwości: spójność, dostępność i odporność na podziały sieci.
Główną korzyścią operacyjną jest to, że awarie węzłów nie powodują przestojów, ponieważ system automatycznie przekierowuje żądania do działających replik. Skala problemu jest ogromna: ludzkość generuje każdego dnia ponad 400 milionów terabajtów nowych danych, czyli tyle, że żadna scentralizowana architektura nie jest w stanie tego udźwignąć bez z czasem załamania się pod własnym ciężarem.
Rozproszone przechowywanie danych a scentralizowana pamięć masowa
Scentralizowana pamięć masowa umieszcza wszystko w jednym miejscu: na jednym serwerze, w jednej macierzy SAN, w jednym centrum danych. Taki jest cały model. Gdy z tym miejscem coś jest nie tak, wszystko się zatrzymuje. Rozproszone przechowywanie danych rozwiązuje ten problem wprost: dane znajdują się na wielu niezależnych węzłach, więc żadna pojedyncza awaria nie może wyłączyć całego systemu ani zablokować dostępu do wszystkich danych.
Jedna awaria sprzętu i dostęp ustaje. Bez wyjątków. Skalowanie oznacza modernizację lub wymianę głównego systemu, co zwykle wiąże się z przestojem i rozmową o nakładach inwestycyjnych, której nikt nie chce prowadzić. Rozproszone przechowywanie danych omija oba te problemy z założenia: aby rosnąć, wystarczy dodać węzeł, a gdy któryś ulegnie awarii, klaster omija go automatycznie. Bez dramatów i bez przestoju. Dane były już wcześniej na wielu węzłach, zanim cokolwiek się zepsuło.
| Wymiar | Scentralizowana pamięć masowa | Rozproszone przechowywanie danych |
|---|---|---|
| Tolerancja na awarie | Pojedynczy punkt awarii | Dane przetrwają utratę pojedynczego węzła |
| Skalowalność | Pionowa (modernizacja sprzętu) | Pozioma (dodawanie węzłów) |
| Opóźnienie | Niskie przy dostępie lokalnym | Zmienne; zależy od topologii sieci |
| Koszt w małej skali | Niższy koszt początkowy | Wyższa minimalna opłacalna wielkość klastra |
| Koszt w dużej skali | Kosztowne skalowanie | Sprzęt standardowy obniża koszty |
| Rozmieszczenie geograficzne | Jedna lokalizacja | Wiele regionów dzięki konfiguracji |
| Złożoność operacyjna | Prosta w zarządzaniu | Wymaga narzędzi do orkiestracji |
Jak działają rozproszone systemy przechowywania danych
System rozproszonego przechowywania danych przyjmuje nadchodzące dane, dzieli je na fragmenty, kieruje te fragmenty do właściwych węzłów w klastrze i śledzi każdy element za pomocą warstwy metadanych. Dzięki temu dowolny fragment można zlokalizować, pobrać i złożyć na żądanie, niezależnie od tego, który węzeł go przechowuje. To podstawowy cykl działania. Napędzają go cztery mechanizmy:
- Sharding (partycjonowanie danych) Gdy dane trafiają do systemu, zostają pocięte na mniejsze części (shardy lub bloki) i rozmieszczone między węzłami. To właśnie umożliwia równoległe I/O: wiele węzłów obsługuje odczyty i zapisy jednocześnie, więc przepustowość rośnie wraz z rozmiarem klastra zamiast ograniczać się do możliwości jednej maszyny. Logika routingu to zwykle haszowanie spójne, które utrzymuje równomierny rozkład danych w miarę rozrastania się klastra, bez przetasowywania wszystkiego za każdym razem, gdy dodawany jest węzeł.
- Replikacja Proste, ale skuteczne podejście: przechowywanie N identycznych kopii każdego shardu na oddzielnych węzłach, zwykle trzech. Gdy jeden węzeł przestanie działać, pozostałe dwa natychmiast obsługują żądania. Bez rekonstrukcji, bez czekania. Replikacja jest właściwym wyborem dla danych gorących: aktywnych baz danych, kanałów danych w czasie rzeczywistym i wszystkiego, gdzie dodatkowa milisekunda przy odczycie rzeczywiście kosztuje.
- Kodowanie korekcyjne Tu matematyka efektywności przechowywania staje się ciekawa. Zamiast trzech pełnych kopii system koduje obiekt w $k$ fragmentów danych oraz $m$ fragmentów parzystości, rozmieszcza wszystkie $k+m$ fragmentów między węzłami i może odtworzyć pełny obiekt z dowolnych $k$ z nich. Zatem $m$ węzłów może ulec awarii jednocześnie i nic nie zostanie utracone. Konfiguracja Reed-Solomon RS(6,3) przechowuje 9 bloków zamiast 18 wymaganych przy 3x replikacji, obniżając narzut surowej pamięci masowej z 200% do około 50%. Haczyk polega na tym, że kodowanie i dekodowanie zużywają cykle procesora, a kodowanie korekcyjne sprawdza się lepiej w przypadku danych zimnych, czyli treści rzadko modyfikowanych lub odczytywanych z dużą częstotliwością. Przy obciążeniach z częstymi, małymi zapisami 3x replikacja nadal wygrywa pod względem opóźnień.
| Metoda ochrony | Narzut pamięci | Najlepsze zastosowanie | Kompromis |
|---|---|---|---|
| 3x replikacja | 3x pojemność surowa | Dane gorące, obciążenia o niskim opóźnieniu | Wysoki koszt pamięci przy dużej skali |
| Kodowanie korekcyjne RS(6,3) | 1,5x pojemność surowa | Dane zimne, archiwizacja, duże obiekty | Obciążenie procesora, dłuższe opóźnienie odbudowy |
- Routing metadanych Każdy rozproszony system przechowywania danych utrzymuje warstwę metadanych, czyli w gruncie rzeczy mapę tego, który shard znajduje się na którym węźle. Gdy klient żąda danych, usługa metadanych identyfikuje właściwe węzły, a system pobiera i składa fragmenty bez tego, by klient widział jakąkolwiek złożoność. W dużych klastrach, takich jak Ceph czy HDFS, warstwa metadanych jest sama rozproszona między węzłami. Musi być. Pojedynczy serwer metadanych stałby się wąskim gardłem, przed którym właśnie uciekamy.
Rodzaje rozproszonych systemów przechowywania danych
Rozproszone przechowywanie danych to nie jedna rzecz. To kategoria obejmująca trzy odrębne modele danych, a wybór niewłaściwego do danego zadania to zaskakująco częsty i kosztowny błąd. Storage obiektowy, pamięć blokowa i pamięć plikowa rozwiązują każdy inny problem. Rozproszone bazy danych, takie jak Cassandra, CockroachDB czy Google Spanner, stanowią czwarty typ: nakładają semantykę zapytań na rozproszone zarządzanie danymi, ale to osobny temat.
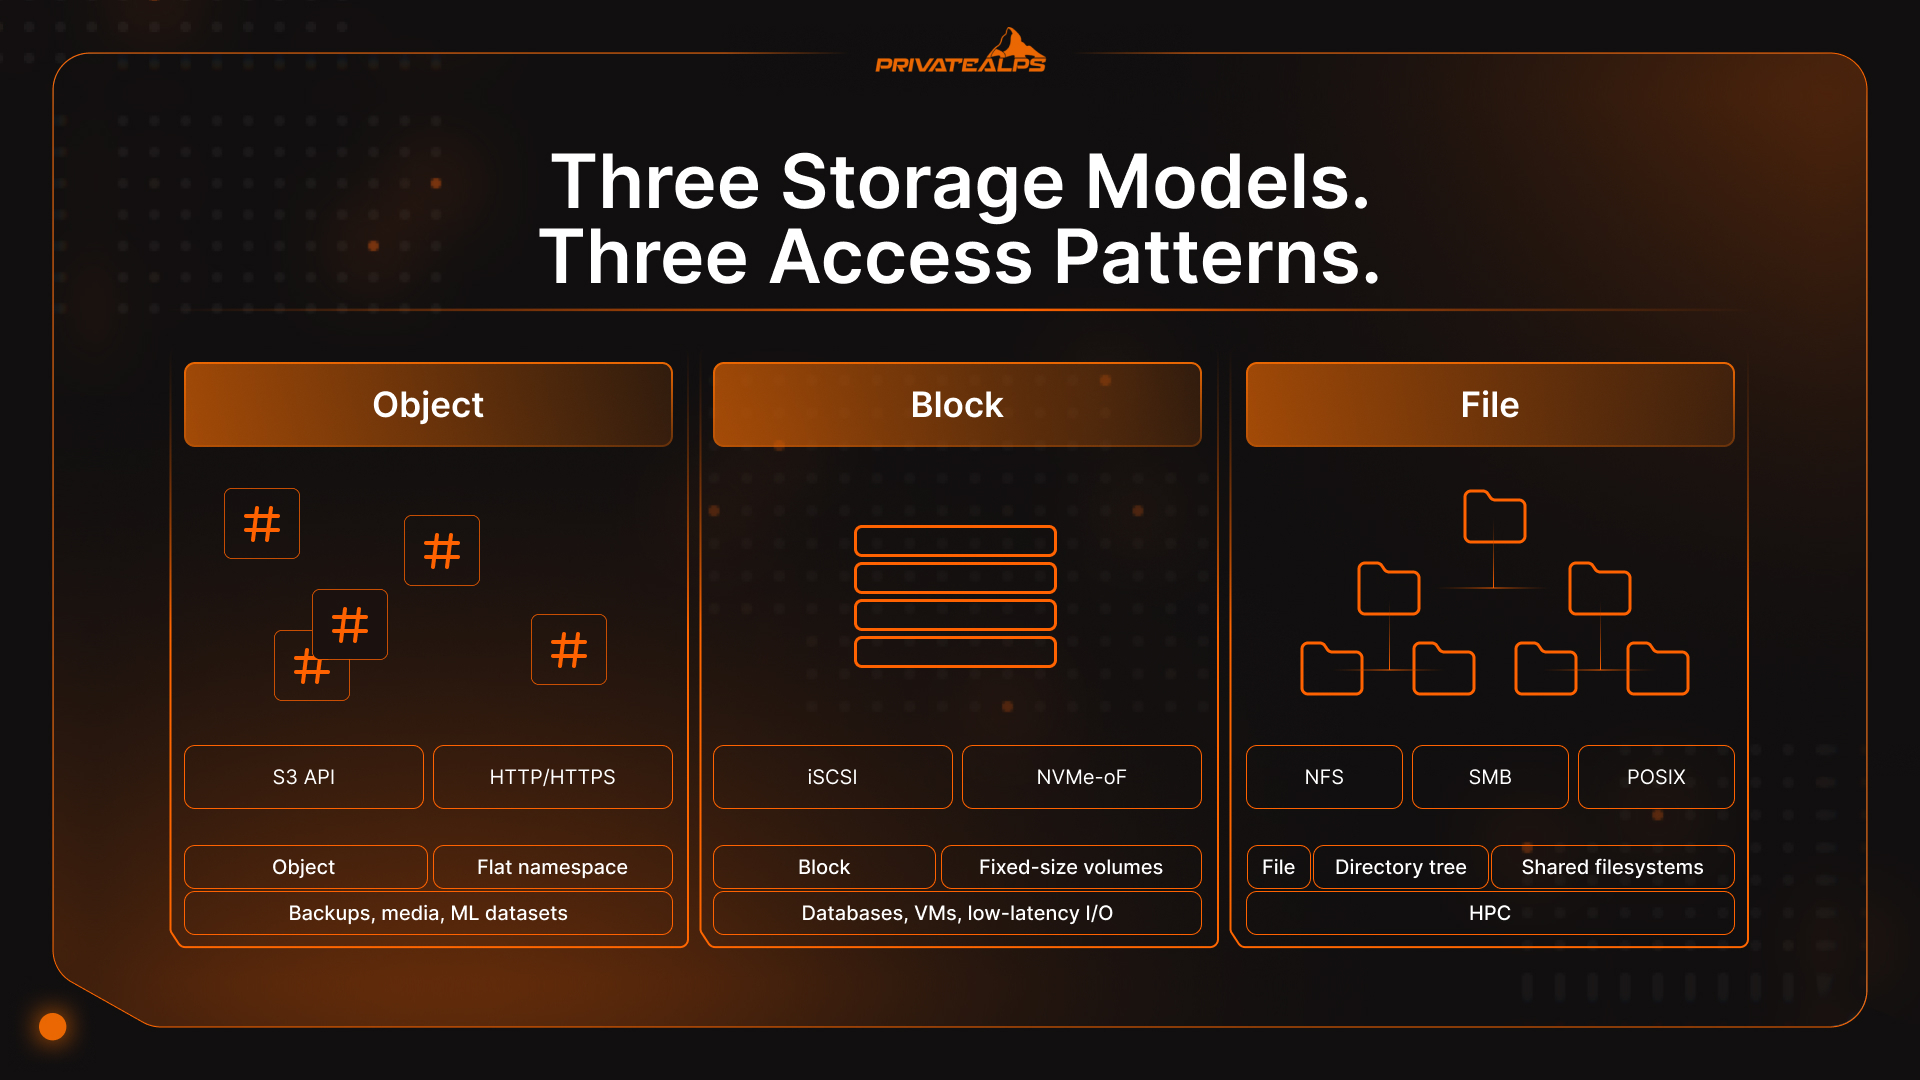
| Typ | Sposób przechowywania | Metoda dostępu | Najlepsze zastosowanie | Przykłady |
|---|---|---|---|---|
| Obiektowy | Płaska przestrzeń nazw, obiekty bogate w metadane | Interfejs API zgodny z S3 (HTTP/HTTPS) | Dane nieustrukturyzowane na dużą skalę: kopie zapasowe, multimedia, zbiory danych ML | AWS S3, MinIO, Ceph RADOS |
| Blokowy | Surowe woluminy o stałym rozmiarze | iSCSI, NVMe-oF, FC | Bazy danych, maszyny wirtualne, losowe I/O o niskim opóźnieniu | Ceph RBD, AWS EBS, Lightbits |
| Plikowy | Hierarchiczne drzewo katalogów | NFS, SMB, POSIX | Współdzielone systemy plików, HPC, katalogi domowe | GlusterFS, HDFS, Azure Files |
Rozproszony storage obiektowy
Rozproszony storage obiektowy organizuje dane jako pojedyncze, niezmienne obiekty umieszczone w płaskiej przestrzeni nazw: bez katalogów, bez ścieżek plików, bez hierarchii do utrzymania. Każdy obiekt otrzymuje unikalny identyfikator (skrót lub UUID) oraz bogate metadane, a dostęp do niego uzyskuje się przez interfejs API zgodny z S3 po protokole HTTP. Ponieważ obiekty są zastępowane, a nie częściowo aktualizowane, problem blokowania, który ogranicza wydajność i skalowalność w systemach blokowych i plikowych, po prostu znika. Dzięki temu AWS S3, Azure Blob i Ceph skalują się do eksabajtów: nie ma narzutu na koordynację przestrzeni nazw ani rywalizacji o blokady, a każdy węzeł klastra może niezależnie obsłużyć dowolne żądanie obiektu.
Rozproszona pamięć blokowa
Pamięć blokowa przekazuje serwerom surowe woluminy: bloki o stałym rozmiarze z unikalnymi adresami, bez abstrakcji systemu plików. Aplikacje zapisują bezpośrednio do bloków, co zapewnia spójne, losowe I/O o niskim opóźnieniu dla baz danych, dysków maszyn wirtualnych i obciążeń kontenerowych. Jedno ograniczenie architektoniczne, które zaskakuje wiele osób: wolumin blokowy zwykle może być zamontowany tylko na jednym serwerze naraz. Współdzielony dostęp wielu serwerów wymaga dodatkowej orkiestracji, na przykład klastrowego systemu plików nałożonego na urządzenia blokowe.
Rozproszona pamięć plikowa
Pamięć plikowa udostępnia współdzielony system plików przez standardowe protokoły: NFS, SMB oraz dostęp zgodny z POSIX. Wielu klientów może zamontować ten sam wolumin jednocześnie, co czyni ją naturalnym wyborem dla obciążeń zespołowych, środowisk HPC i starszych aplikacji, które oczekują drzewa katalogów i nie zostaną przepisane w najbliższym czasie. Rzeczywisty kompromis: utrzymanie spójnej przestrzeni nazw katalogów w rozproszonych węzłach generuje narzut koordynacji, który narasta wraz ze skalą. Większość hiperskalerów z czasem przenosi dane podstawowe z rozproszonej pamięci plikowej do rozproszonego storage obiektowego, gdy wolumeny osiągną odpowiednio duży rozmiar.
Twierdzenie CAP: nieuniknione kompromisy w rozproszonym przechowywaniu danych
Twierdzenie CAP mówi, że rozproszony system danych może zagwarantować tylko dwie z trzech rzeczy naraz: spójność (każdy odczyt zwraca najnowszy zapis), dostępność (każde żądanie otrzymuje odpowiedź) oraz odporność na podział sieci (system działa dalej mimo podziałów sieci). Sieci się dzielą, więc odporność na podziały nie jest opcjonalna. Prawdziwa decyzja zawsze dotyczy wyboru między spójnością a dostępnością, gdy pojawi się awaria.
[Eric Brewer przedstawił twierdzenie CAP w 2000 roku, a Gilbert i Lynch sformalizowali dowód w 2002 roku][https://www.scylladb.com/glossary/cap-theorem/]. Nadal to ono determinuje wszystko inne w architekturze rozproszonego przechowywania danych, ponieważ określa, jak system zachowuje się właśnie w momencie, gdy jest to najbardziej potrzebne, czyli gdy coś już nie działa.
| System | Typ CAP | Zachowanie podczas podziału | Najlepsze zastosowanie |
|---|---|---|---|
| MongoDB | CP (z odczytem/zapisem większościowym) | Odrzuca żądania do przywrócenia spójności | Rekordy finansowe, stany magazynowe, rezerwacje |
| HBase | CP | Zwraca błędy zamiast nieaktualnych danych | Ustrukturyzowana analityka, spójne zadania wsadowe |
| Apache Cassandra | AP | Pozostaje dostępna; może zwracać nieaktualne odczyty | Kanały społecznościowe, komunikacja, telemetria IoT |
| DynamoDB (domyślnie) | AP | Zawsze odpowiada; niespójności uzgadnia asynchronicznie | Aplikacje konsumenckie o dużej przepustowości |
| CockroachDB | CP | Najpierw spójność, rozproszony SQL | Globalne obciążenia transakcyjne |
Praktyczne pytanie brzmi: czy obciążenie może tolerować nieaktualny odczyt? Saldo konta, rezerwacja miejsca czy stan magazynowy raczej nie mogą tolerować takiej nieaktualności, więc w takim przypadku wybiera się CP. Kanał społecznościowy, strumień zdarzeń z czujników czy telemetria analityczna mogą tolerować kilka sekund nieaktualności, więc wtedy wybiera się AP, zachowując gwarancję dostępności.
Bezpieczeństwo rozproszonego przechowywania danych: szyfrowanie i suwerenność danych
Bezpieczeństwo w rozproszonej pamięci masowej opiera się na trzech odrębnych warstwach: danych w spoczynku, danych w tranzycie i własności kluczy. Zaniedbanie choćby jednej z nich sprawia, że pozostałe nie dają ochrony. Infrastruktura może działać bez zarzutu, a wrażliwe dane mogą być po cichu dostępne dla niewłaściwych osób.
Szyfrowanie musi obejmować wszystkie trzy warstwy. Dane w spoczynku zazwyczaj szyfruje się algorytmem AES-256, z kluczami zarządzanymi przez dostawcę lub z kluczami zarządzanymi przez klienta (CMK). Zarządzanie przez dostawcę jest operacyjnie prostsze, ale to dostawca pamięci masowej przechowuje materiał kluczowy, co jest istotnym czynnikiem bezpieczeństwa dla branż regulowanych, które przechodzą audyty. Szyfrowanie po stronie klienta całkowicie eliminuje to ryzyko: dane są szyfrowane, zanim opuszczą urządzenie klienta, więc dostawca nigdy nie ma dostępu do danych jawnych, niezależnie od tego, jakie żądania prawne pojawią się w przyszłości. Dla danych w tranzycie TLS 1.3 stanowi minimalny standard bezpieczeństwa. Każde połączenie, które nadal dopuszcza TLS 1.2, wymaga udokumentowanego wyjątku zgodnie z większością obowiązujących dziś ram zgodności.
Suwerenność danych często zaskakuje zespoły. Dane podlegają prawu tego kraju, w którym fizycznie się znajdują, a nie prawu kraju firmy ani lokalizacji użytkownika. Szwajcaria ma status kraju o odpowiednim poziomie ochrony zgodnie z art. 45 RODO, więc transfery danych z UE do Szwajcarii odbywają się bez dodatkowych zabezpieczeń umownych. Zmieniona ustawa federalna o ochronie danych (nFADP) dostosowuje szwajcarskie przepisy krajowe do RODO. Oznacza to, że szwajcarska infrastruktura zapewnia spójne wymogi regulacyjne zgodne z obydwoma systemami jednocześnie.
Jedną kwestię łatwo odłożyć, a nie powinno się tego robić: algorytmy kryptograficzne, które dziś chronią większość infrastruktury pamięci masowej, nie zostały zaprojektowane tak, by przetrwać działanie zdolnego komputera kwantowego. NIST sfinalizował trzy standardy kryptografii postkwantowej w sierpniu 2024 roku, w tym FIPS 203 (ML-KEM). Jeśli w rozproszonym przechowywaniu danych trzymasz rekordy o długim okresie retencji, takie jak archiwa medyczne, dokumentacja finansowa czy dokumenty prawne, model zagrożenia „zbieraj teraz, odszyfruj później” jest już aktywny. Oceny takich rozwiązań powinny zacząć się znacznie wcześniej, zanim archiwa osiągną dojrzałość.
Kluczowe zalety rozproszonego przechowywania danych
- Odporność na awarie bez przerw w działaniu usług: Awaria węzła uruchamia wykrywanie sygnałów heartbeat i automatyczne przekierowanie ruchu do działających replik. Nie jest potrzebna ręczna interwencja ani okno serwisowe.
- Skalowalność horyzontalna: Nową pojemność zapewnia dodanie węzłów do klastra. Dane są rozdzielane w tle, bez wpływu na aktywny ruch i bez przestojów.
- Rozproszenie geograficzne: Replikacja między regionami skraca opóźnienia dla użytkowników rozsianych geograficznie, a zgodność z wymogiem lokalizacji danych staje się kwestią konfiguracji, a nie osobnego projektu infrastrukturalnego.
- Przepustowość równoległego I/O: Wiele węzłów obsługuje odczyty i zapisy jednocześnie. Jest to jedyna skalowalna architektura dla potoków trenowania AI/ML, transkodowania wideo i strumieniowania mediów w realnej skali produkcyjnej.
- Brak uzależnienia od dostawcy dzięki otwartym protokołom: Interfejsy API zgodne z S3, NFS oraz otwartoźródłowe platformy, takie jak Ceph, pozwalają migrować między dostawcami lub uruchamiać infrastrukturę lokalnie bez przepisywania kodu aplikacji.
- Efektywność kosztowa przy skali: Sprzęt powszechnie dostępny zastępuje drogie zamknięte macierze dyskowe. Kodowanie korekcyjne (erasure coding) dodatkowo zmniejsza wymaganą surową pojemność nawet o 50% w porównaniu z pełną replikacją między węzłami.
Ograniczenia i wyzwania rozproszonego przechowywania danych
- Złożoność spójności: Utrzymanie spójnego stanu między węzłami wymaga starannego dostrojenia modeli spójności, współczynników replikacji i ustawień kworum. Błędna konfiguracja nie daje o sobie znać głośno. Po cichu prowadzi do rozbieżności danych.
- Narzut operacyjny: Prowadzenie klastra rozproszonej pamięci masowej oznacza planowanie domen awarii, procedury wymiany węzłów, potoki monitoringu i strojenie wydajności. Pojedynczy serwer nie wymaga od administratora nic z tego.
- Zależność od sieci: Cała architektura zakłada niezawodną, szerokopasmową łączność między węzłami. Pogorszenie jakości sieci bezpośrednio i proporcjonalnie przekłada się na wzrost opóźnień i spadek przepustowości pamięci masowej.
- Opóźnienia przy małych losowych operacjach I/O: Rozproszona pamięć masowa jest zoptymalizowana pod kątem dużych odczytów sekwencyjnych i przepustowości równoległej. Obciążenia z dużą liczbą małych, losowych operacji I/O, zwłaszcza bazy OLTP, często działają lepiej na lokalnie podłączonej pamięci blokowej NVMe.
- Minimalna sensowna skala: Zalety kosztowe i wynikająca z nich prostota rozproszonego przechowywania danych nie ujawniają się w klastrze dwuwęzłowym. Poniżej pewnego progu zarządzana usługa chmurowej pamięci masowej lub dobrze dostrojony pojedynczy serwer są po prostu tańsze i łatwiejsze w utrzymaniu.
Zastosowania rozproszonego przechowywania danych w praktyce
- Media i streaming: Netflix i YouTube nie serwują wideo z jednej lokalizacji. Rozprowadzają zakodowane treści między klastrami storage obiektowego, umieszczonymi geograficznie blisko widzów. Pojedyncze centrum danych nie udźwignie jednoczesnych globalnych strumieni na dużą skalę, a same koszty przepustowości byłyby zaporowe. To właśnie rozproszone przechowywanie danych sprawia, że ekonomia streamingu w ogóle działa.
- Ochrona zdrowia: Jedno badanie MRI generuje od 500 MB do 1 GB danych obrazowych. Pomnóż to przez dużą sieć szpitali, różne modalności, długie wymogi retencji i wiele placówek, a otrzymasz petabajty, które szybko się kumulują. Skalowalne rozproszone przechowywanie danych z redundancją geograficzną pozwala systemom ochrony zdrowia utrzymać dostęp do dokumentacji pacjentów zgodny z HIPAA, nawet gdy regionalne centrum danych przestanie działać.
- AI i uczenie maszynowe: Trenowanie dużego modelu językowego oznacza dostarczanie klastrom GPU terabajtów, a nawet petabajtów danych, odczytywanych w nieuporządkowany sposób. Taki dostęp szybko przeciążyłby tradycyjny system pamięci masowej. Ceph, HDFS i magazyny obiektów zgodne z S3 stały się standardową warstwą infrastruktury dla potoków ML, ponieważ ich równoległa przepustowość odczytu faktycznie odpowiada temu, czego potrzebują klastry GPU.
- Kopie zapasowe i odzyskiwanie po awarii: Prawdziwe odzyskiwanie po awarii oznacza, że dane istnieją w co najmniej dwóch geograficznie oddzielnych lokalizacjach z niezależnymi domenami awarii, a nie w dwóch szafach w tym samym budynku. Polityki replikacji i reguły rozmieszczenia wbudowane bezpośrednio w warstwę rozproszonej pamięci masowej określają RPO i RTO na poziomie infrastruktury, bez potrzeby osobnego stosu oprogramowania do tworzenia kopii zapasowych. Mniej ruchomych elementów oznacza też mniejszą powierzchnię ataku.
Rozproszone przechowywanie danych a zdecentralizowane: jaka jest różnica?
Rozproszone przechowywanie danych oznacza, że dane są rozłożone na wielu węzłach, ale całością nadal zarządza i kontroluje jedna organizacja: polityki, prawa dostępu, możliwość usuwania i dzienniki audytu. Zdecentralizowana pamięć masowa całkowicie rezygnuje z centralnej władzy. Dane istnieją w niezależnych węzłach równorzędnych, a żaden pojedynczy operator nie może jednostronnie ocenzurować, udostępnić ani usunąć danych.
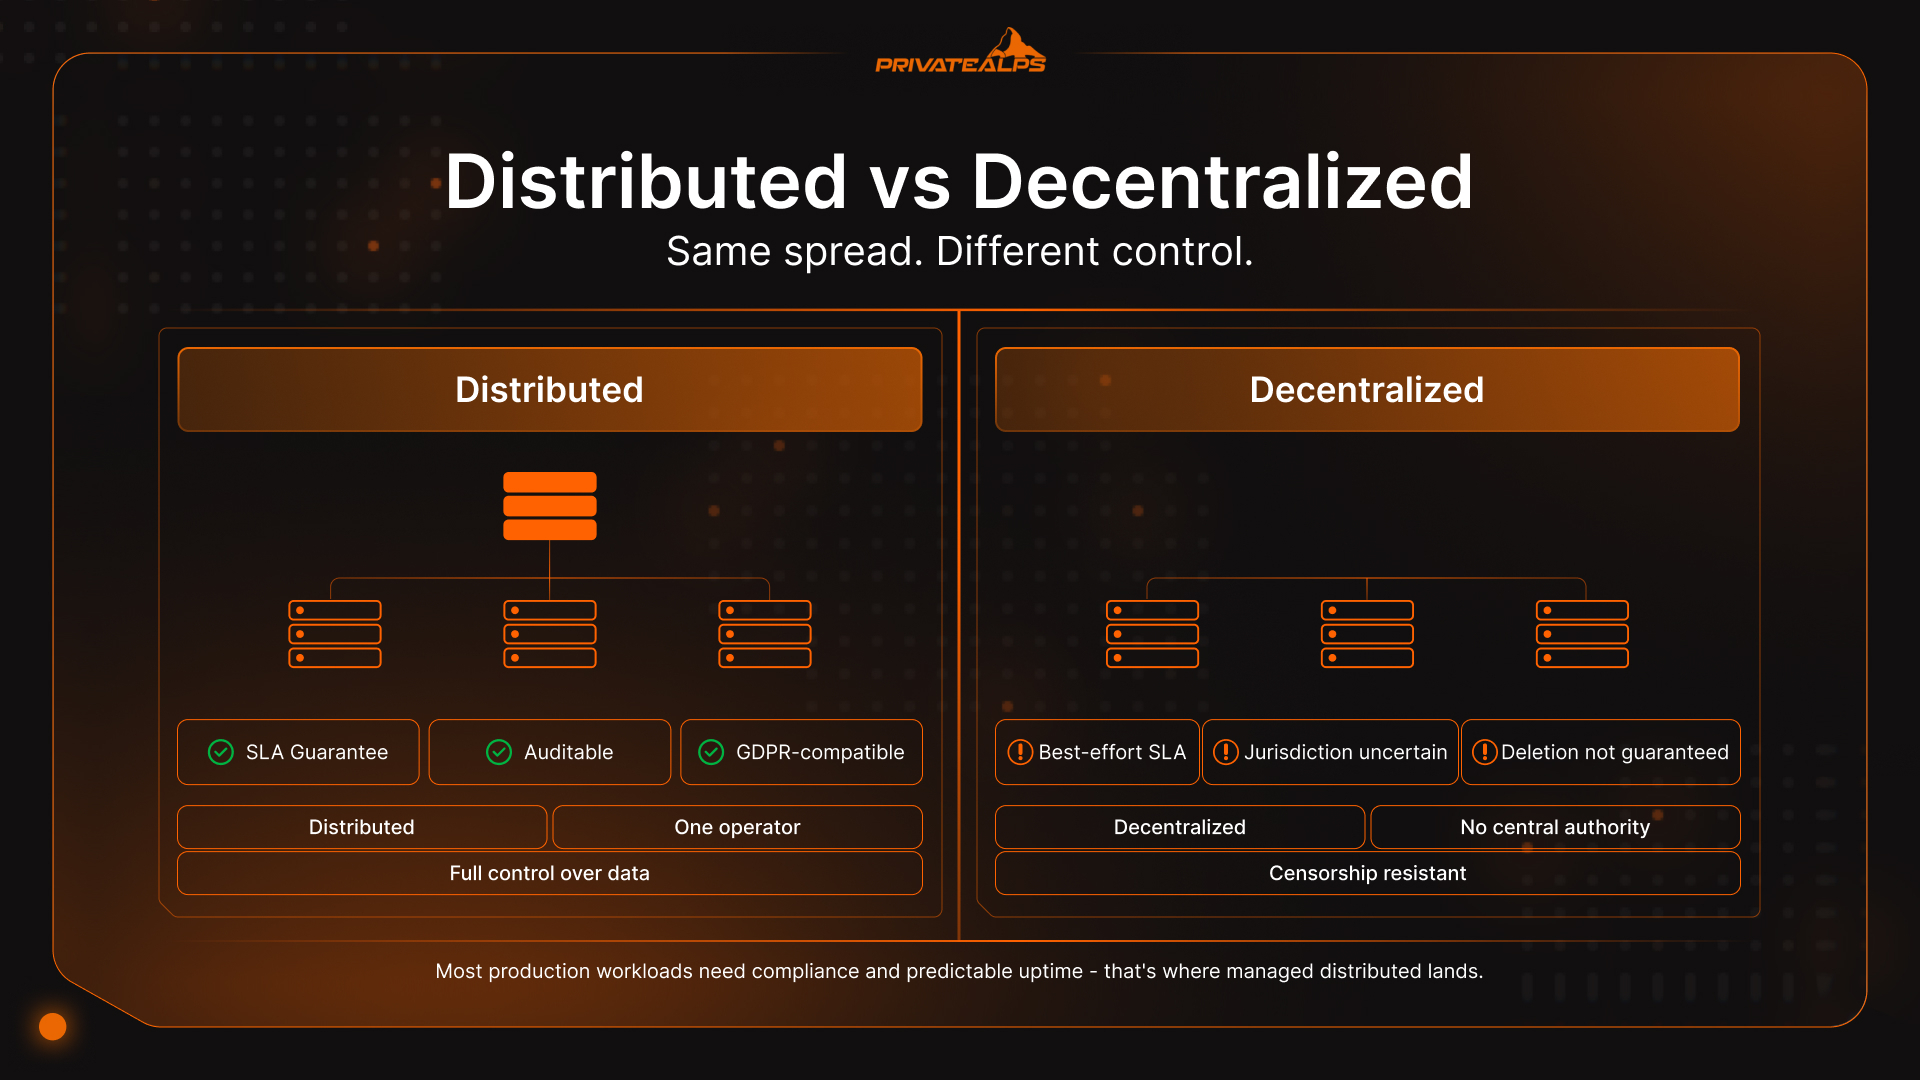
To rozróżnienie ma realne konsekwencje operacyjne. Centralnie zarządzany system rozproszony można audytować, łatać, objąć umową SLA i doprowadzić do zgodności z przepisami. System zdecentralizowany wymienia to wszystko na odporność na cenzurę i działanie bez zaufania. Jest to wartościowe w określonych kontekstach, ale nie jest tym, czego większość firm prowadzących produkcyjną infrastrukturę pamięci masowej faktycznie potrzebuje.
| Wymiar | Rozproszone przechowywanie danych | Zdecentralizowana pamięć masowa |
|---|---|---|
| Kontrola | Zarządzanie centralne | Brak centralnego organu |
| SLA / gwarancje dostępności | Możliwe gwarancje umowne | Best-effort, zależne od protokołu |
| Zgodność | Możliwość audytu, zgodność z RODO | Niepewna jurysdykcja |
| Usuwanie danych | Gwarantowane | Nie zawsze możliwe |
| Kontrola dostępu | Oparta na rolach, zarządzana | Kryptograficzna, bez zaufania |
| Przykłady | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Jeszcze jedną warstwę warto wyodrębnić: wieloregionową chmurową pamięć masową, np. AWS S3 z replikacją między regionami czy Azure z geograficznie nadmiarową pamięcią masową, to nadal infrastruktura zarządzana centralnie. Dostawca zarządza węzłami i replikacją, a użytkownik w praktyce wynajmuje geografię. Prawdziwe rozproszone platformy chmurowe, takie jak Storj czy Cubbit, rozprowadzają dane między niezależnych operatorów. Eliminują uzależnienie od dostawcy, ale otwierają pytania o SLA i ścieżki audytu. W przypadku większości obciążeń wymagających dokumentacji zgodności i przewidywalnej dostępności najlepszym rozwiązaniem jest zarządzane podejście rozproszone.
Podsumowanie
Rozproszone przechowywanie danych nie jest produktem, lecz kategorią architektoniczną, a właściwy wariant zależy wyłącznie od tego, co uruchamiasz. Storage obiektowy, blokowy i plikowy mają każdy model danych zbudowany pod inne wzorce dostępu i profile obciążeń. Twierdzenie CAP wymusza realny kompromis między spójnością a dostępnością w chwili wystąpienia awarii sieci, a błędna decyzja w tym zakresie może być kosztowna. Gdy wybierasz między replikacją a kodowaniem korekcyjnym, o wyborze decyduje temperatura danych: gorące dane wymagają replikacji ze względu na opóźnienia, a zimne dane zyskują na wydajności przestrzennej kodowania korekcyjnego. Dla większości zespołów zarządzane rozwiązanie rozproszone, od dostawcy prywatnego lub z publicznej chmury, pod warunkiem że lokalizację danych i kontrolę bezpieczeństwa da się zweryfikować, daje lepszy bilans skalowalności, wydajności i codziennej prostoty obsługi niż samodzielnie utrzymywany klaster.
Przechowuj dane w Szwajcarii z PrivateAlps
Jeśli Twoje obciążenie wymaga rozproszonego storage obiektowego zgodnego z S3 i zweryfikowalnej lokalizacji danych, PrivateAlps oferuje szwajcarską infrastrukturę w pełni zgodną z art. 45 RODO i nFADP. Twoje dane pozostają w Szwajcarii, bez udostępniania osobom trzecim, bez niejednoznacznego przesyłania przez zagraniczne jurysdykcje i bez niespodzianek. Niezależnie od tego, czy migrujesz od hiperskalera, czy budujesz od podstaw architekturę rozproszonego przechowywania danych z naciskiem na prywatność, PrivateAlps zapewnia wydajność i pewność zgodności, których wymaga Twoje obciążenie.
FAQ
Jaka jest różnica między rozproszonym przechowywaniem danych a chmurową pamięcią masową?
Chmurowa pamięć masowa to model dostarczania usługi: infrastrukturą zarządza ktoś inny, a dostęp uzyskuje się przez internet w modelu płatności za wykorzystanie. Rozproszone przechowywanie danych to architektura, w której dane są rozłożone na wielu węzłach w celu zapewnienia redundancji i skalowalności. Są to niezależne pojęcia. Rozproszone przechowywanie danych można w całości uruchomić lokalnie na Ceph lub MinIO, a dostawca chmury może technicznie udostępniać scentralizowaną pamięć masową za interfejsem API. Większość usług chmurowej pamięci masowej korzysta wewnętrznie z architektur rozproszonych, ale jest to szczegół implementacyjny, a nie definicja chmurowej pamięci masowej.
Który system rozproszonego przechowywania danych jest najlepszy?
Nie ma uniwersalnej odpowiedzi. Zależy to od obciążenia i modelu danych. Dla danych nieustrukturyzowanych i kopii zapasowych standardowym wyborem są magazyny obiektów zgodne z S3, takie jak MinIO lub Ceph RADOS. Dla wolumenów baz danych i dysków maszyn wirtualnych, które wymagają spójnego I/O blokowego o niskim opóźnieniu, lepiej sprawdzi się Ceph RBD lub Lightbits. Dla współdzielonych systemów plików w środowiskach HPC lub w infrastrukturze legacy zespoły zwykle wybierają GlusterFS lub HDFS. Zacznij od wzorca dostępu, a wybór systemu pamięci masowej wynika z niego.
Czy rozproszone przechowywanie danych to to samo co RAID?
Nie. RAID działa w obrębie pojedynczego serwera lub macierzy dyskowej i chroni przed awarią dysku wewnątrz jednej maszyny. Rozproszone przechowywanie danych działa na oddzielnych fizycznych węzłach połączonych przez sieć, potencjalnie rozmieszczonych w kilku budynkach lub całych centrach danych. RAID nie pomoże, gdy zawiedzie sam serwer. Rozproszone systemy pamięci masowej są zaprojektowane specjalnie po to, by tolerować awarie węzłów, awarie szaf serwerowych i pełne awarie centrów danych. Różnica w zakresie działania ma charakter fundamentalny.
Jak rozproszone przechowywanie danych radzi sobie z awariami węzłów?
Węzły regularnie wysyłają sygnały heartbeat do warstwy metadanych klastra. Gdy węzeł przestaje odpowiadać, system wykrywa awarię, zwykle w ciągu kilku sekund, i przekierowuje żądania do węzłów przechowujących repliki lub fragmenty z kodowaniem korekcyjnym. W konfiguracjach opartych na replikacji proces odzyskiwania w tle tworzy nowe kopie, aby przywrócić skonfigurowany współczynnik replikacji w całym klastrze. Cały mechanizm działa automatycznie. W dobrze skonfigurowanym klastrze rozproszonej pamięci masowej aplikacje w ogóle nie zauważają awarii.
Czy rozproszone przechowywanie danych nadaje się dla małych firm?
Zarządzane usługi rozproszonej pamięci masowej, takie jak storage obiektowy zgodny z S3 od dostawcy chmury lub wyspecjalizowanej firmy, na przykład PrivateAlps, działają w każdej skali i nie wymagają minimalnego rozmiaru klastra. Samodzielnie utrzymywane klastry rozproszonej pamięci masowej to już inna sprawa. Produkcyjne uruchomienie Ceph zwykle wymaga od trzech do pięciu węzłów, zanim narzut operacyjny zacznie się opłacać. Dla małych zespołów usługi zarządzane zapewniają pełne korzyści architektury rozproszonej bez ciężaru zarządzania infrastrukturą.
