


O que é armazenamento distribuído?
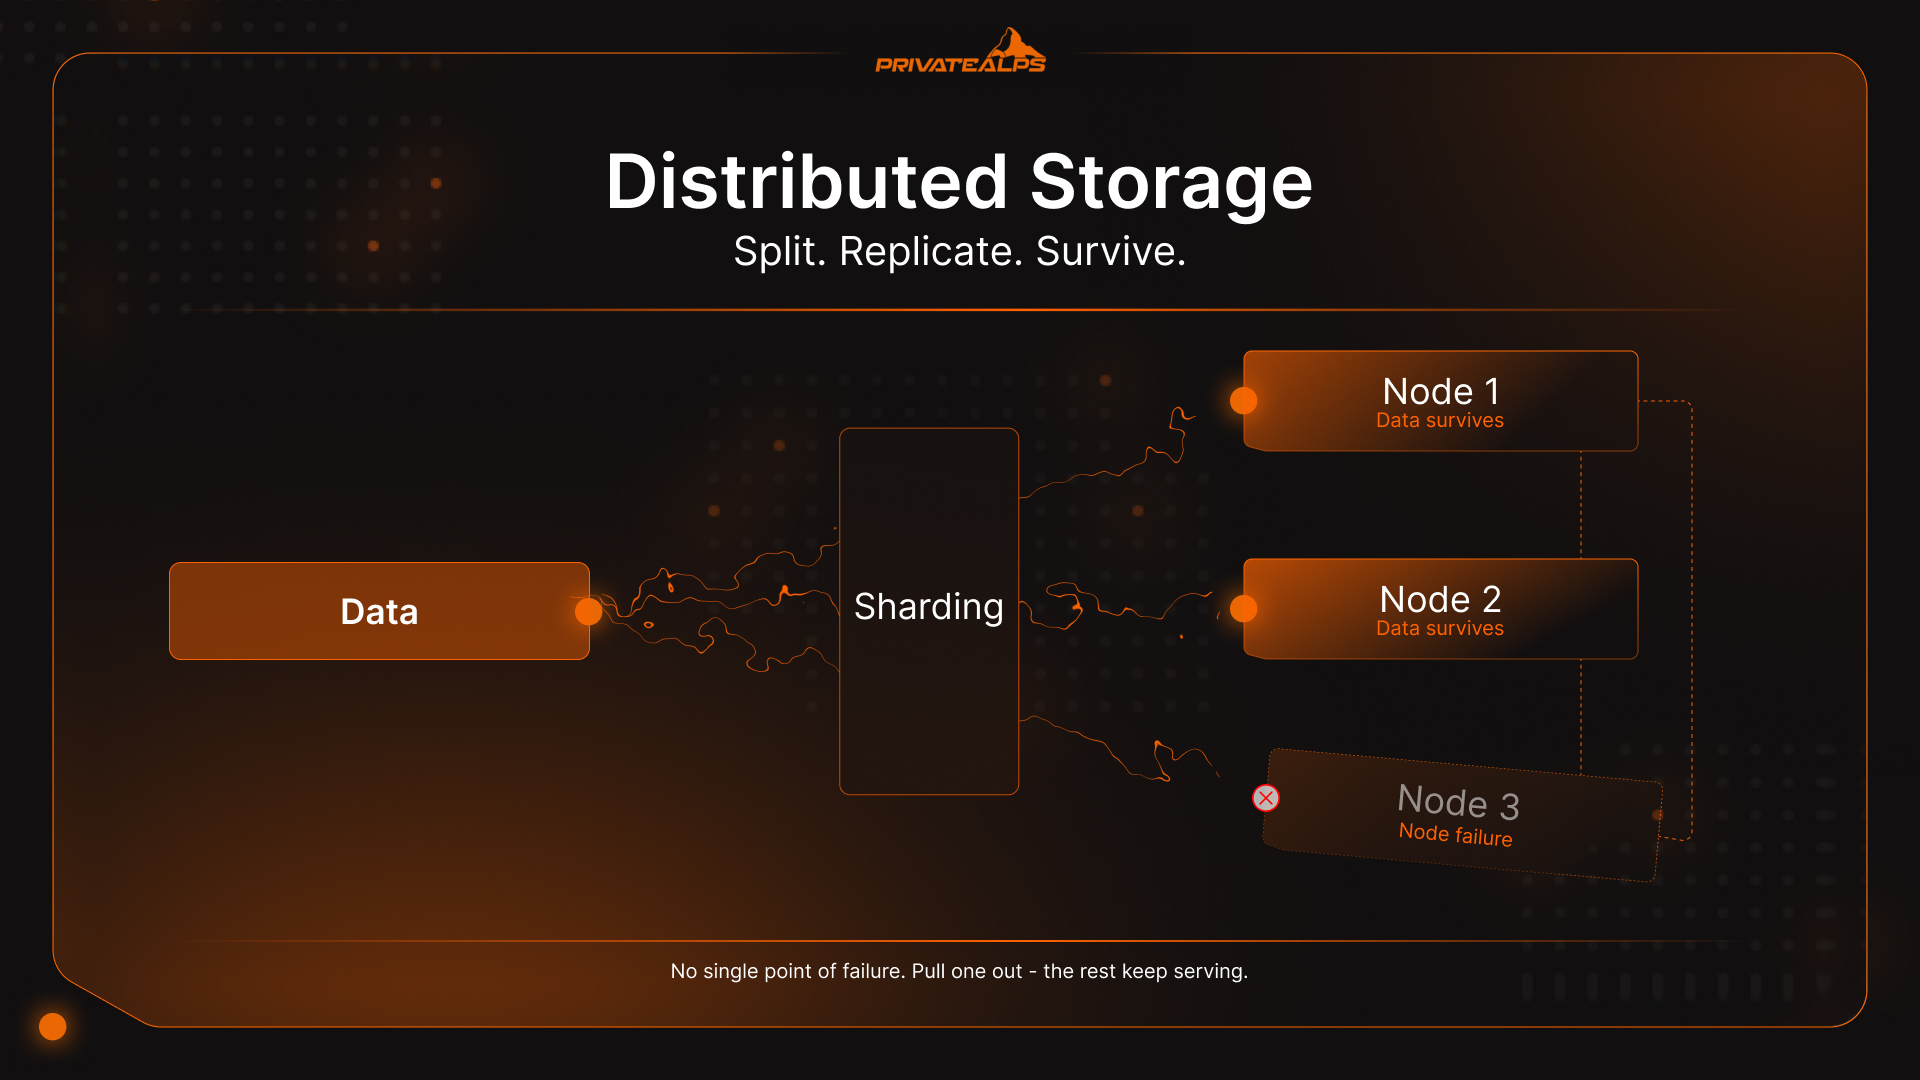
O armazenamento distribuído é a forma como a infraestrutura moderna lida com dados grandes demais, críticos demais ou com acesso intenso demais para serem guardados com confiabilidade em uma única máquina. Em vez de gravar tudo em um único servidor, o sistema divide, replica ou codifica esses dados em vários nós independentes – servidores, discos, data centers. Eles trabalham juntos, mas nenhum nó guarda tudo. Se você tirar um deles do ar, os demais continuam atendendo. Este guia explica como os sistemas de armazenamento distribuído se comportam na prática sob carga, quais trade-offs de arquitetura eles impõem e qual tipo de armazenamento é adequado para cada carga de trabalho.
Resumo com IA
O armazenamento distribuído é uma arquitetura definida por software que particiona dados em vários nós físicos usando três técnicas principais: sharding (divisão dos dados em blocos discretos, roteados para nós diferentes), replicação (manutenção de várias cópias idênticas entre os nós para acesso rápido) e codificação de apagamento (codificação dos dados em fragmentos com paridade matemática, de modo que qualquer subconjunto possa reconstruir o todo).
Existem três tipos principais de sistemas de armazenamento distribuído: armazenamento de objetos (namespace plano, API compatível com S3), armazenamento em blocos (volumes de tamanho fixo para I/O aleatório de baixa latência) e armazenamento de arquivos (namespace hierárquico via NFS ou SMB). Toda configuração de armazenamento distribuído de dados esbarra no teorema CAP: ele só consegue garantir duas entre consistência, disponibilidade e tolerância a partições, simultaneamente.
O principal benefício operacional é que a falha de um nó não causa indisponibilidade; o sistema redireciona as requisições automaticamente para as réplicas que continuam funcionando.
O tamanho do que está em jogo: a humanidade gera mais de 400 milhões de terabytes de novos dados a cada dia – um volume que nenhuma arquitetura centralizada consegue absorver sem, eventualmente, colapsar sob o próprio peso.
Armazenamento distribuído vs. centralizado
O armazenamento centralizado concentra tudo em um único local – um servidor, um SAN, um data center. É esse o modelo inteiro. Quando esse local tem um problema, tudo para. O armazenamento distribuído resolve isso diretamente: os dados ficam espalhados por vários nós independentes, então nenhum ponto único de falha consegue tirar o sistema inteiro do ar ou bloquear todo o acesso.
Uma falha de hardware e o acesso para. Simples assim. Escalar significa atualizar ou substituir o sistema principal, o que normalmente envolve indisponibilidade e uma discussão sobre investimento de capital que ninguém quer ter. O armazenamento distribuído contorna os dois problemas por design: para crescer, basta adicionar um nó, e quando um nó falha, o cluster se reorganiza sem ele. Sem drama, sem queda. Os dados já estavam em vários nós antes de qualquer coisa quebrar.
| Dimensão | Armazenamento centralizado | Armazenamento distribuído |
|---|---|---|
| Tolerância a falhas | Ponto único de falha | Os dados sobrevivem à perda de um nó |
| Escalabilidade | Vertical (atualizar hardware) | Horizontal (adicionar nós) |
| Latência | Baixa para acesso local | Variável; depende da topologia da rede |
| Custo em pequena escala | Custo inicial menor | Cluster mínimo viável mais caro |
| Custo em grande escala | Caro para escalar | Hardware commodity reduz o custo |
| Distribuição geográfica | Local único | Multirregião por configuração |
| Complexidade operacional | Simples de gerenciar | Exige ferramentas de orquestração |
Como funcionam os sistemas de armazenamento distribuído
Um sistema de armazenamento distribuído recebe os dados, divide-os em blocos, direciona esses blocos para os nós certos do cluster e controla cada parte por meio de uma camada de metadados – assim, qualquer fragmento pode ser localizado, recuperado e remontado sob demanda, independentemente do nó que o armazena. Esse é o ciclo básico. Quatro mecanismos o sustentam:
- Sharding (particionamento de dados) Quando os dados chegam, o sistema os corta em pedaços menores – shards ou blocos – e os distribui entre os nós. É isso que possibilita o I/O paralelo: vários nós leem e gravam ao mesmo tempo, então a vazão cresce com o tamanho do cluster, em vez de estagnar no limite de uma única máquina. A lógica de roteamento costuma usar hash consistente, que mantém a distribuição equilibrada conforme o cluster cresce, sem reorganizar tudo a cada novo nó adicionado.
- Replicação A abordagem simples, porém eficaz: armazenar N cópias idênticas de cada shard em nós separados, normalmente três. Se um nó sair do ar, os outros dois continuam atendendo imediatamente. Sem reconstrução, sem espera. A replicação é a escolha certa para dados quentes – bancos de dados ativos, feeds em tempo real, qualquer caso em que um milissegundo extra nas leituras realmente custe algo.
- Codificação de apagamento É aqui que a matemática da eficiência de armazenamento fica interessante. Em vez de três cópias completas, o sistema codifica um objeto em $k$ fragmentos de dados mais $m$ fragmentos de paridade, distribui todos os $k+m$ entre os nós e consegue reconstruir o objeto completo a partir de quaisquer $k$ deles. Ou seja, $m$ nós podem falhar ao mesmo tempo sem que nada se perca. Uma configuração Reed-Solomon RS(6,3) armazena 9 blocos em vez dos 18 exigidos pela replicação 3x, reduzindo o overhead bruto de armazenamento de 200% para cerca de 50%. O porém é que a codificação e a decodificação consomem ciclos de CPU, e a codificação de apagamento tem desempenho melhor em dados frios – conteúdo raramente modificado ou acessado com alta frequência. Para cargas de trabalho com muitas gravações pequenas e frequentes, a replicação 3x ainda vence em latência.
| Método de proteção | Overhead de armazenamento | Ideal para | Trade-off |
|---|---|---|---|
| Replicação 3x | 3x a capacidade bruta | Dados quentes, cargas de baixa latência | Alto custo de armazenamento em escala |
| Codificação de apagamento RS(6,3) | 1,5x a capacidade bruta | Dados frios, arquivamento, objetos grandes | Overhead de CPU, latência de reconstrução maior |
- Roteamento de metadados Todo sistema de armazenamento distribuído mantém uma camada de metadados – basicamente, um mapa de qual shard está em qual nó. Quando um cliente solicita dados, o serviço de metadados identifica os nós corretos, e o sistema recupera e remonta os fragmentos sem que o cliente veja a complexidade. Em clusters de grande escala, como Ceph ou HDFS, a camada de metadados também é distribuída entre os nós. Precisa ser assim. Um único servidor de metadados vira o gargalo que você estava tentando eliminar.
Tipos de sistemas de armazenamento distribuído
Armazenamento distribuído não é uma coisa só. É uma categoria com três modelos de dados distintos, e escolher o errado para uma carga de trabalho é um erro surpreendentemente comum e caro. Armazenamento de objetos, em blocos e de arquivos resolvem problemas diferentes. Bancos de dados distribuídos – Cassandra, CockroachDB, Google Spanner – representam um quarto tipo, adicionando semântica de consulta sobre o gerenciamento distribuído de dados, mas isso já é outra discussão.
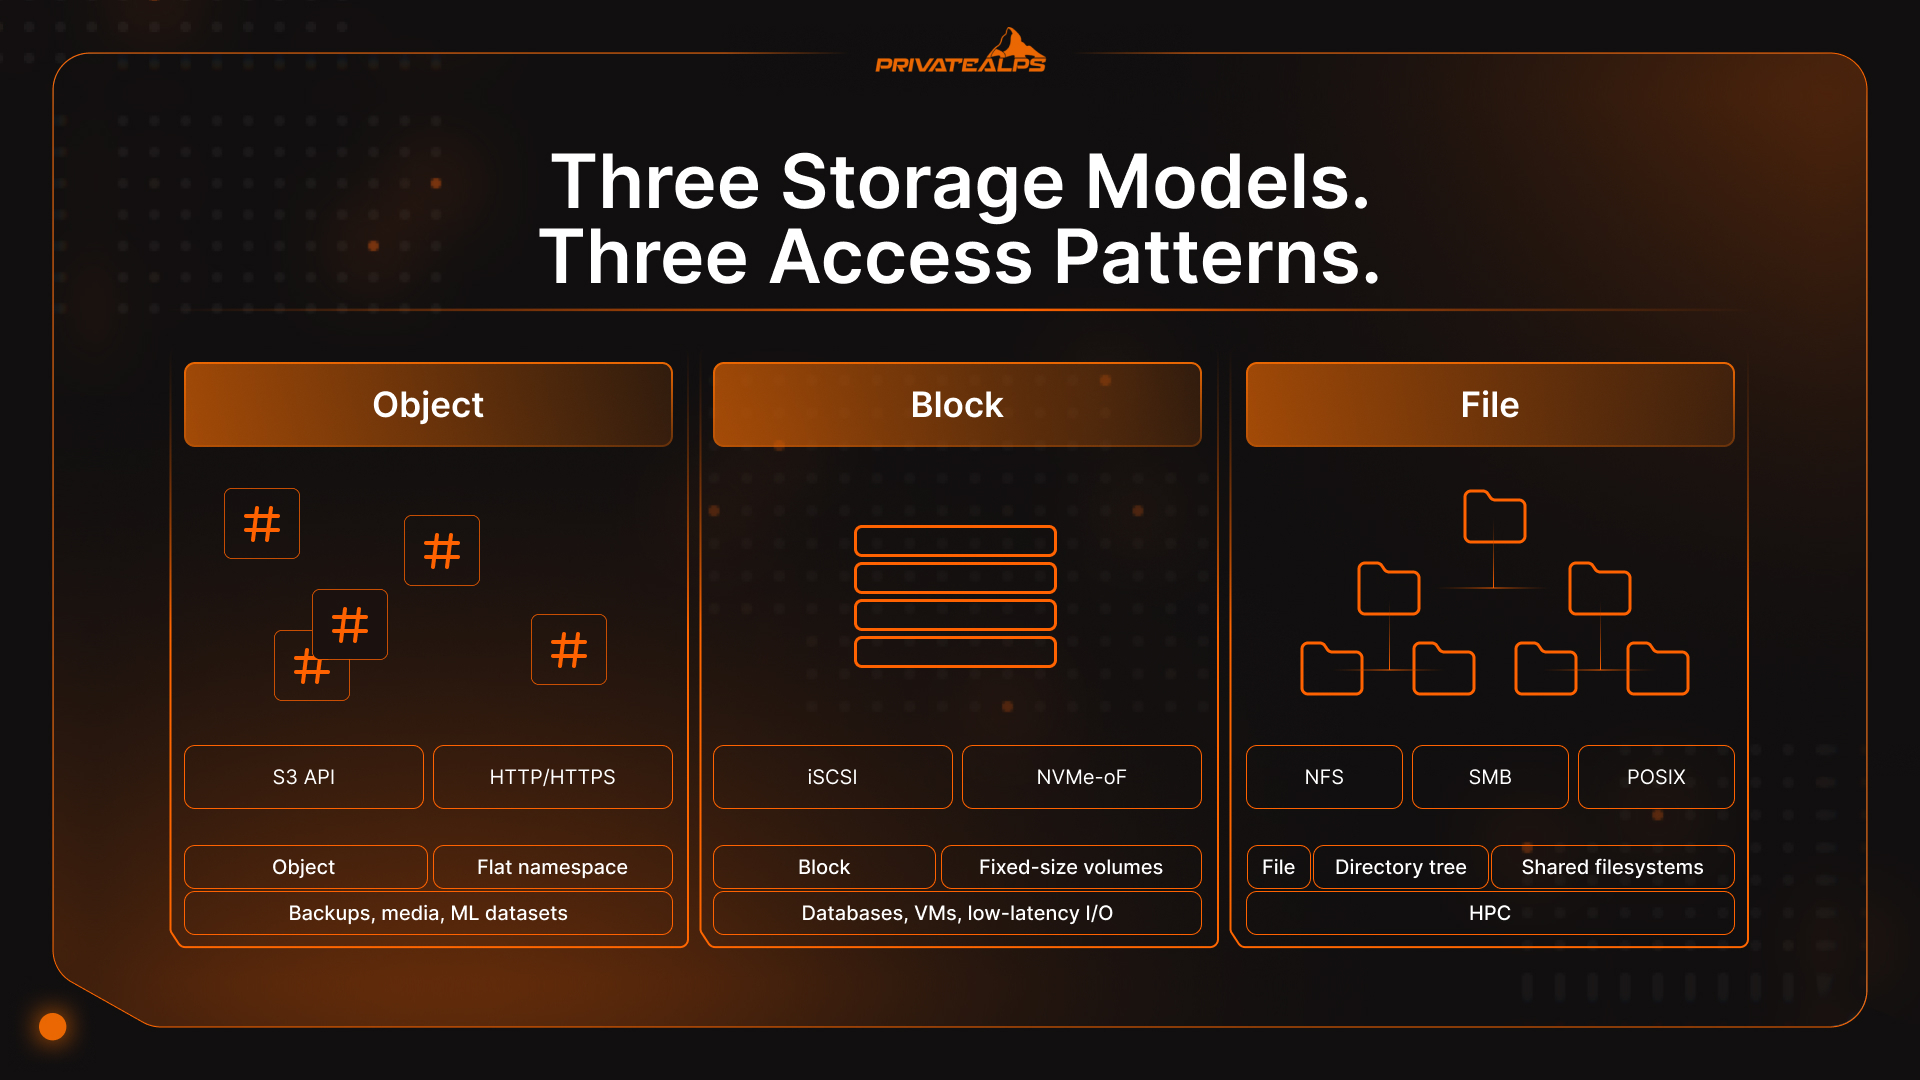
| Tipo | Como os dados são armazenados | Método de acesso | Ideal para | Exemplos |
|---|---|---|---|---|
| Objeto | Namespace plano, objetos ricos em metadados | API compatível com S3 (HTTP/HTTPS) | Dados não estruturados em escala: backups, mídia, datasets de ML | AWS S3, MinIO, Ceph RADOS |
| Bloco | Volumes brutos de tamanho fixo | iSCSI, NVMe-oF, FC | Bancos de dados, VMs, I/O aleatório de baixa latência | Ceph RBD, AWS EBS, Lightbits |
| Arquivo | Árvore de diretórios hierárquica | NFS, SMB, POSIX | Sistemas de arquivos compartilhados, HPC, diretórios pessoais | GlusterFS, HDFS, Azure Files |
Armazenamento de objetos distribuído
O armazenamento de objetos distribuído organiza os dados como objetos individuais e imutáveis em um namespace plano – sem diretórios, sem caminhos de arquivos, sem hierarquia para manter. Cada objeto recebe um identificador único (um hash ou UUID) e metadados detalhados, e você o acessa por uma API compatível com S3 via HTTP. Como os objetos são substituídos, e não atualizados parcialmente, o problema de bloqueio que limita o desempenho e a escalabilidade nos sistemas de bloco e de arquivos simplesmente desaparece. É assim que o AWS S3, o Azure Blob e o Ceph escalam para exabytes: sem sobrecarga de coordenação de namespace, sem disputa por locks, e qualquer nó do cluster pode atender qualquer requisição de objeto de forma independente.
Armazenamento em blocos distribuído
O armazenamento em blocos entrega volumes brutos aos servidores – blocos de tamanho fixo com endereços únicos, sem camada de sistema de arquivos por cima. As aplicações gravam diretamente nos blocos, o que garante I/O aleatório de baixa latência e consistente para bancos de dados, discos de VMs e cargas de trabalho em contêineres. Uma limitação arquitetural pega muita gente de surpresa: um volume de bloco normalmente só pode ser montado por um servidor por vez. Para acesso compartilhado entre vários servidores, é preciso uma camada adicional de orquestração, como um sistema de arquivos em cluster sobre os dispositivos de bloco.
Armazenamento de arquivos distribuído
O armazenamento de arquivos apresenta um sistema de arquivos compartilhado por meio de protocolos padrão – acesso NFS, SMB e compatível com POSIX. Vários clientes podem montar o mesmo volume ao mesmo tempo, o que o torna a escolha natural para cargas colaborativas, ambientes de HPC e aplicações legadas que dependem de uma árvore de diretórios e não serão reescritas tão cedo. O trade-off no mundo real: manter um namespace de diretórios consistente entre nós distribuídos cria sobrecarga de coordenação que se acumula em escala. A maioria dos hyperscalers acaba migrando do armazenamento de arquivos distribuído para o armazenamento de objetos distribuído, no caso dos dados primários, quando os volumes ficam grandes o suficiente.
O teorema CAP: o trade-off inevitável no armazenamento distribuído
O teorema CAP afirma que um sistema de dados distribuído só pode garantir duas de três coisas ao mesmo tempo: Consistência (toda leitura retorna a escrita mais recente), Disponibilidade (toda requisição recebe uma resposta) e Tolerância a partições (o sistema continua funcionando mesmo com divisões na rede). Redes se dividem – a tolerância a partições não é opcional. A decisão real é sempre entre consistência e disponibilidade quando uma falha acontece.
[Eric Brewer apresentou o CAP em 2000; Gilbert e Lynch formalizaram a prova em 2002][https://www.scylladb.com/glossary/cap-theorem/]. Ele continua sendo a decisão que molda todo o resto na arquitetura de armazenamento distribuído, porque determina como o sistema se comporta exatamente no momento em que você mais precisa dele – quando algo já está quebrado.
| Sistema | Tipo CAP | Comportamento durante uma partição | Ideal para |
|---|---|---|---|
| MongoDB | CP (com read/write concern de maioria) | Rejeita requisições até a consistência ser restabelecida | Registros financeiros, estoque, reservas |
| HBase | CP | Retorna erros em vez de dados desatualizados | Análises estruturadas, jobs em lote consistentes |
| Apache Cassandra | AP | Continua disponível; pode servir leituras desatualizadas | Feeds sociais, mensageria, telemetria de IoT |
| DynamoDB (padrão) | AP | Sempre responde; reconcilia inconsistências de forma assíncrona | Aplicações de consumo com alto volume de requisições |
| CockroachDB | CP | Consistência em primeiro lugar, SQL distribuído | Cargas transacionais globais |
Na prática, a pergunta é: sua carga de trabalho tolera uma leitura desatualizada? Um saldo bancário, uma reserva de assento, uma contagem de estoque – provavelmente não. Escolha CP. Um feed social, um fluxo de eventos de sensores, telemetria de análises – alguns segundos de defasagem são aceitáveis. Escolha AP e mantenha a garantia de disponibilidade.
Segurança do armazenamento distribuído: criptografia e soberania de dados
A segurança no armazenamento distribuído se apoia em três camadas distintas: dados em repouso, dados em trânsito e posse das chaves. Se uma delas falhar, as outras não compensam. A infraestrutura pode estar totalmente disponível enquanto dados sensíveis ficam acessíveis, sem que ninguém perceba, para as pessoas erradas.
A criptografia precisa cobrir as três camadas. Os dados em repouso normalmente usam AES-256, com chaves gerenciadas pelo provedor ou chaves gerenciadas pelo cliente (CMK). O modelo gerenciado pelo provedor é mais simples de operar, mas o fornecedor de armazenamento fica com o material das chaves, o que é uma consideração de segurança crítica para setores regulados que passam por auditorias. A criptografia no lado do cliente elimina essa exposição: os dados são criptografados antes de sair do cliente, então o provedor nunca acessa o texto puro, independentemente de quais solicitações legais cheguem. Para os dados em trânsito, o TLS 1.3 é o mínimo de segurança; qualquer configuração que ainda permita o TLS 1.2 precisa de uma exceção documentada na maioria dos frameworks de conformidade atuais.
A soberania de dados costuma pegar as equipes de surpresa. Os dados estão sujeitos às leis do lugar onde fisicamente estão armazenados, e não ao país da empresa nem à localização do usuário. A Suíça tem status de adequação pelo Artigo 45 do GDPR, então transferências de dados da UE para a Suíça ocorrem sem salvaguardas contratuais adicionais. A Lei Federal de Proteção de Dados (nFADP) revisada alinha as regras suíças internas ao GDPR, o que significa que a infraestrutura suíça oferece cobertura regulatória consistente para os dois frameworks ao mesmo tempo.
Há um ponto fácil de adiar, mas que não deveria ser: os algoritmos criptográficos que protegem a maior parte da infraestrutura de armazenamento hoje não foram projetados para resistir a um computador quântico capaz. O NIST finalizou três padrões de criptografia pós-quântica em agosto de 2024, incluindo o FIPS 203 (ML-KEM). Se o seu armazenamento distribuído de dados guarda registros com longo prazo de retenção, como arquivos médicos, registros financeiros ou documentos jurídicos, o modelo de ameaça “colher agora, descriptografar depois” já está ativo. O planejamento de migração deve começar bem antes de esses arquivos chegarem ao fim da vida útil.
Principais vantagens do armazenamento distribuído
- Tolerância a falhas sem interrupção do serviço: a falha de um nó aciona a detecção por heartbeat e o redirecionamento automático para as réplicas que continuam funcionando, sem intervenção manual e sem necessidade de janela de manutenção.
- Escalabilidade horizontal: a nova capacidade de armazenamento vem da adição de nós ao cluster; os dados são rebalanceados em segundo plano, sem afetar o tráfego ativo e sem exigir indisponibilidade.
- Distribuição geográfica: a replicação entre regiões reduz a latência para usuários geograficamente dispersos e transforma a conformidade com a residência de dados em uma decisão de configuração, e não em um projeto de infraestrutura.
- Throughput de I/O paralelo: vários nós processam leituras e gravações simultaneamente, o que torna essa a única arquitetura escalável para pipelines de treinamento de IA/ML, transcodificação de vídeo ou streaming de mídia em volumes reais de produção.
- Sem dependência de fornecedor com protocolos abertos: APIs compatíveis com S3, NFS e plataformas de código aberto como o Ceph permitem que as equipes migrem entre provedores ou rodem a infraestrutura on-premises sem reescrever o código da aplicação.
- Eficiência de custo em escala: hardware de prateleira substitui caros arrays de armazenamento proprietários; a codificação por apagamento (erasure coding) reduz ainda mais a capacidade bruta necessária, em até 50% em comparação com a replicação completa entre nós.
Limitações e desafios do armazenamento distribuído
- Complexidade de consistência: manter um estado consistente entre os nós exige ajuste cuidadoso dos modelos de consistência, dos fatores de replicação e das configurações de quórum. Uma configuração errada não faz barulho; ela vai, silenciosamente, levando os dados a divergir.
- Sobrecarga operacional: operar um cluster de armazenamento distribuído significa cuidar do planejamento de domínios de falha, dos procedimentos de substituição de nós, dos pipelines de monitoramento e do ajuste de desempenho. Um único servidor não exige nada disso de você.
- Dependência de rede: toda a arquitetura pressupõe conectividade confiável e de alta largura de banda entre os nós. A degradação da rede se traduz diretamente e de forma proporcional em perda de latência e de throughput no armazenamento.
- Latência em I/O aleatório de pequenos blocos: o armazenamento distribuído é otimizado para leituras sequenciais grandes e throughput paralelo. Cargas de trabalho com muitos acessos aleatórios de pequenos blocos, especialmente bancos de dados OLTP, costumam ter desempenho melhor em armazenamento NVMe de bloco anexado localmente.
- Escala mínima viável: as vantagens de custo e complexidade do armazenamento distribuído não aparecem em um cluster de dois nós. Abaixo de determinado limite, um serviço de armazenamento em nuvem gerenciado ou um servidor único bem ajustado simplesmente custam menos e são mais fáceis de operar.
Casos de uso reais do armazenamento distribuído
- Mídia e streaming: a Netflix e o YouTube não entregam vídeo a partir de um local central; distribuem o conteúdo codificado entre clusters de armazenamento de objetos posicionados geograficamente perto dos espectadores. Um único data center não daria conta de transmissões globais simultâneas em escala; só os custos de banda seriam proibitivos. O armazenamento distribuído de dados é o que torna a economia do streaming viável na prática.
- Saúde: um único exame de ressonância magnética gera de 500 MB a 1 GB de dados de imagem. Multiplique isso por uma grande rede hospitalar, com diferentes modalidades, longos prazos de retenção e vários sites, e você terá petabytes acumulando-se rapidamente. O armazenamento distribuído escalável, com redundância geográfica, é a forma como os sistemas de saúde mantêm acesso em conformidade com a HIPAA aos prontuários de pacientes, mesmo quando um data center regional falha.
- IA e aprendizado de máquina: treinar um grande modelo de linguagem significa alimentar clusters de GPU com terabytes a petabytes de dados, acessados em padrões não sequenciais que saturariam quase imediatamente um sistema de armazenamento tradicional. Ceph, HDFS e os object stores compatíveis com S3 se tornaram a camada de infraestrutura padrão para pipelines de ML, porque seu throughput de leitura paralela acompanha de fato o que os clusters de GPU consomem.
- Backup e recuperação de desastres: uma recuperação de desastres de verdade significa que os dados existem em pelo menos dois locais geograficamente separados, com domínios de falha independentes, e não em dois racks no mesmo prédio. Políticas de replicação e regras de posicionamento incorporadas diretamente à camada de armazenamento distribuído definem o RPO e o RTO no nível da infraestrutura, sem exigir uma pilha separada de software de backup. Menos partes móveis também significam uma superfície de ataque menor.
Armazenamento distribuído vs. armazenamento descentralizado: qual é a diferença?
O armazenamento distribuído significa que os dados estão espalhados por muitos nós, mas uma única organização ainda possui e controla o conjunto: políticas, direitos de acesso, capacidade de exclusão e logs de auditoria. O armazenamento descentralizado elimina totalmente essa autoridade central. Os dados ficam espalhados entre pares independentes, e nenhum operador isolado consegue censurar, acessar ou excluir esses dados por conta própria.
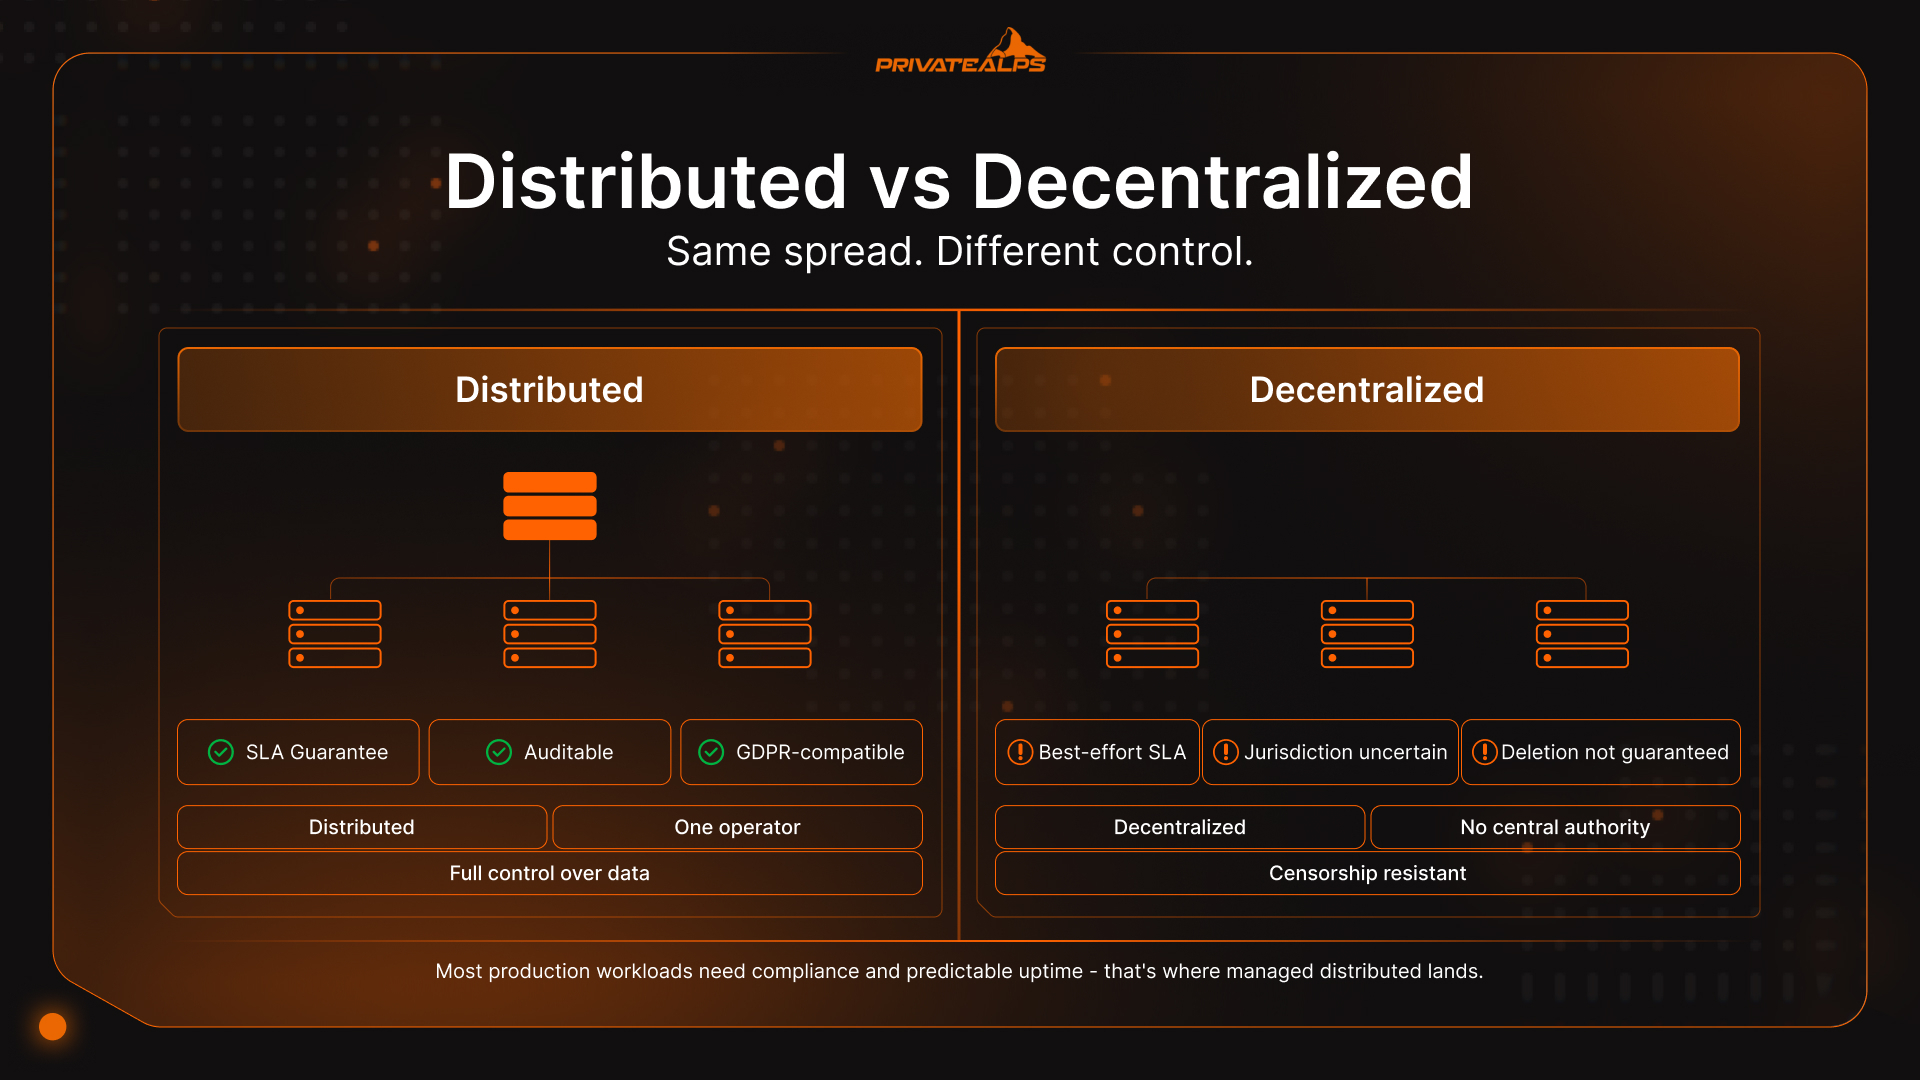
Essa distinção tem consequências operacionais reais. Um sistema distribuído gerenciado centralmente pode ser auditado, corrigido, coberto por SLA e levado à conformidade regulatória. Um sistema descentralizado troca tudo isso por resistência à censura e operação sem necessidade de confiança prévia, o que é valioso em contextos específicos, mas não é o que a maioria das empresas que executam infraestrutura de armazenamento em produção realmente precisa.
| Dimensão | Armazenamento distribuído | Armazenamento descentralizado |
|---|---|---|
| Controle | Administrado centralmente | Sem autoridade central |
| SLA / garantias de uptime | Garantias contratuais possíveis | Melhor esforço, dependente do protocolo |
| Conformidade | Auditável, compatível com GDPR | Jurisdição incerta |
| Exclusão de dados | Garantida | Nem sempre possível |
| Controle de acesso | Baseado em papéis, gerenciado | Criptográfico, sem confiança prévia |
| Exemplos | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Mais uma camada que vale separar: o armazenamento em nuvem multirregião, como o AWS S3 com replicação entre regiões ou o armazenamento geo-redundante do Azure, continua sendo uma infraestrutura administrada centralmente. O provedor gerencia os nós e a replicação; na prática, você está alugando geografia. Plataformas de nuvem distribuídas de verdade, como Storj ou Cubbit, roteiam os dados entre operadores independentes, o que elimina o aprisionamento a um provedor, mas reabre questões sobre SLAs e trilhas de auditoria. Para a maioria das cargas de trabalho que precisam de documentação de conformidade e de uptime previsível, a abordagem distribuída gerenciada é onde as coisas acabam se encaixando.
Resumo
O armazenamento distribuído não é um produto; é uma categoria arquitetural, e a versão certa depende inteiramente do que você executa. O armazenamento de objetos, de blocos e de arquivos têm, cada um, um modelo de dados pensado para padrões de acesso e perfis de carga diferentes. O teorema CAP força um trade-off real entre consistência e disponibilidade no momento em que ocorrem falhas de rede, e errar essa escolha pode ser caro. Já na comparação entre replicação e codificação por apagamento, a temperatura dos dados decide: dados “quentes” precisam de replicação para ter baixa latência, enquanto dados “frios” se beneficiam dos ganhos de eficiência de armazenamento da codificação por apagamento. Para a maioria das equipes, uma solução distribuída gerenciada, de provedor privado ou nuvem pública, desde que a residência dos dados e os controles de segurança sejam verificáveis, oferece um equilíbrio melhor entre escalabilidade, desempenho e simplicidade operacional do dia a dia do que um cluster auto-hospedado.
Armazene seus dados na Suíça, com a PrivateAlps
Se a sua carga de trabalho precisa de armazenamento distribuído de objetos compatível com S3 e com residência de dados verificável, a PrivateAlps opera uma infraestrutura com sede na Suíça, totalmente em conformidade com o Artigo 45 do GDPR e com a nFADP. Seus dados permanecem na Suíça: sem compartilhamento com terceiros, sem roteamento ambíguo por jurisdições estrangeiras, sem surpresas. Seja para migrar para longe de um hyperscaler ou para construir do zero uma arquitetura de armazenamento distribuído focada em privacidade, a PrivateAlps entrega o desempenho e a segurança de conformidade que a sua carga de trabalho realmente exige.
FAQ
Qual é a diferença entre armazenamento distribuído e armazenamento em nuvem?
O armazenamento em nuvem é um modelo de entrega: outra empresa gerencia a infraestrutura, e você acessa os dados pela internet, pagando conforme o uso. O armazenamento distribuído é uma arquitetura: os dados são espalhados por vários nós para garantir redundância e escalabilidade. São conceitos independentes. Você pode rodar armazenamento distribuído totalmente on-premises com Ceph ou MinIO, e um provedor de nuvem pode, tecnicamente, servir armazenamento centralizado por trás de uma API. A maioria dos serviços de armazenamento em nuvem usa arquiteturas distribuídas internamente, mas isso é um detalhe de implementação, e não a definição de armazenamento em nuvem.
Qual é o melhor sistema de armazenamento distribuído?
Não existe resposta universal; depende da carga de trabalho e do modelo de dados. Para dados não estruturados e backups, os object stores compatíveis com S3, como MinIO ou Ceph RADOS, são a escolha padrão. Para volumes de bancos de dados e discos de VMs que exigem I/O de bloco consistente e de baixa latência, o Ceph RBD ou o Lightbits são mais adequados. Para sistemas de arquivos compartilhados em ambientes de HPC ou legados, o GlusterFS ou o HDFS costumam ser a opção das equipes. Comece pelo padrão de acesso; o sistema de armazenamento decorre disso.
Armazenamento distribuído é o mesmo que RAID?
Não. O RAID opera dentro de um único servidor ou array de armazenamento e protege contra falha de disco dentro de uma máquina. O armazenamento distribuído opera entre nós físicos separados, conectados por rede, potencialmente espalhados por vários prédios ou data centers inteiros. O RAID não ajuda quando o próprio servidor falha. Já os sistemas de armazenamento distribuído são projetados especificamente para tolerar falhas de nós, de racks e até a indisponibilidade total de um data center. A diferença de escopo é fundamental.
Como o armazenamento distribuído lida com falhas de nós?
Os nós enviam sinais de heartbeat regulares para a camada de metadados do cluster. Quando um nó deixa de responder, o sistema detecta a falha, geralmente em questão de segundos, e redireciona as requisições para os nós que guardam as réplicas ou os fragmentos codificados por apagamento. Em configurações baseadas em replicação, um processo de recuperação em segundo plano cria novas cópias para restaurar o fator de replicação configurado no cluster. Tudo acontece automaticamente; em um cluster de armazenamento distribuído bem configurado, as aplicações nem chegam a perceber a falha.
O armazenamento distribuído é adequado para pequenas empresas?\\
Serviços de armazenamento distribuído gerenciados, como o armazenamento de objetos compatível com S3 de um provedor de nuvem ou de um especialista como a PrivateAlps, funcionam em qualquer escala e não exigem um cluster mínimo. Clusters de armazenamento distribuído auto-hospedados são outra história: rodar o Ceph em produção normalmente exige pelo menos três a cinco nós antes que a sobrecarga operacional passe a se justificar. Para equipes pequenas, os serviços gerenciados oferecem todos os benefícios arquiteturais do armazenamento distribuído sem o peso da gestão da infraestrutura.
