


Що таке розподілене сховище даних?
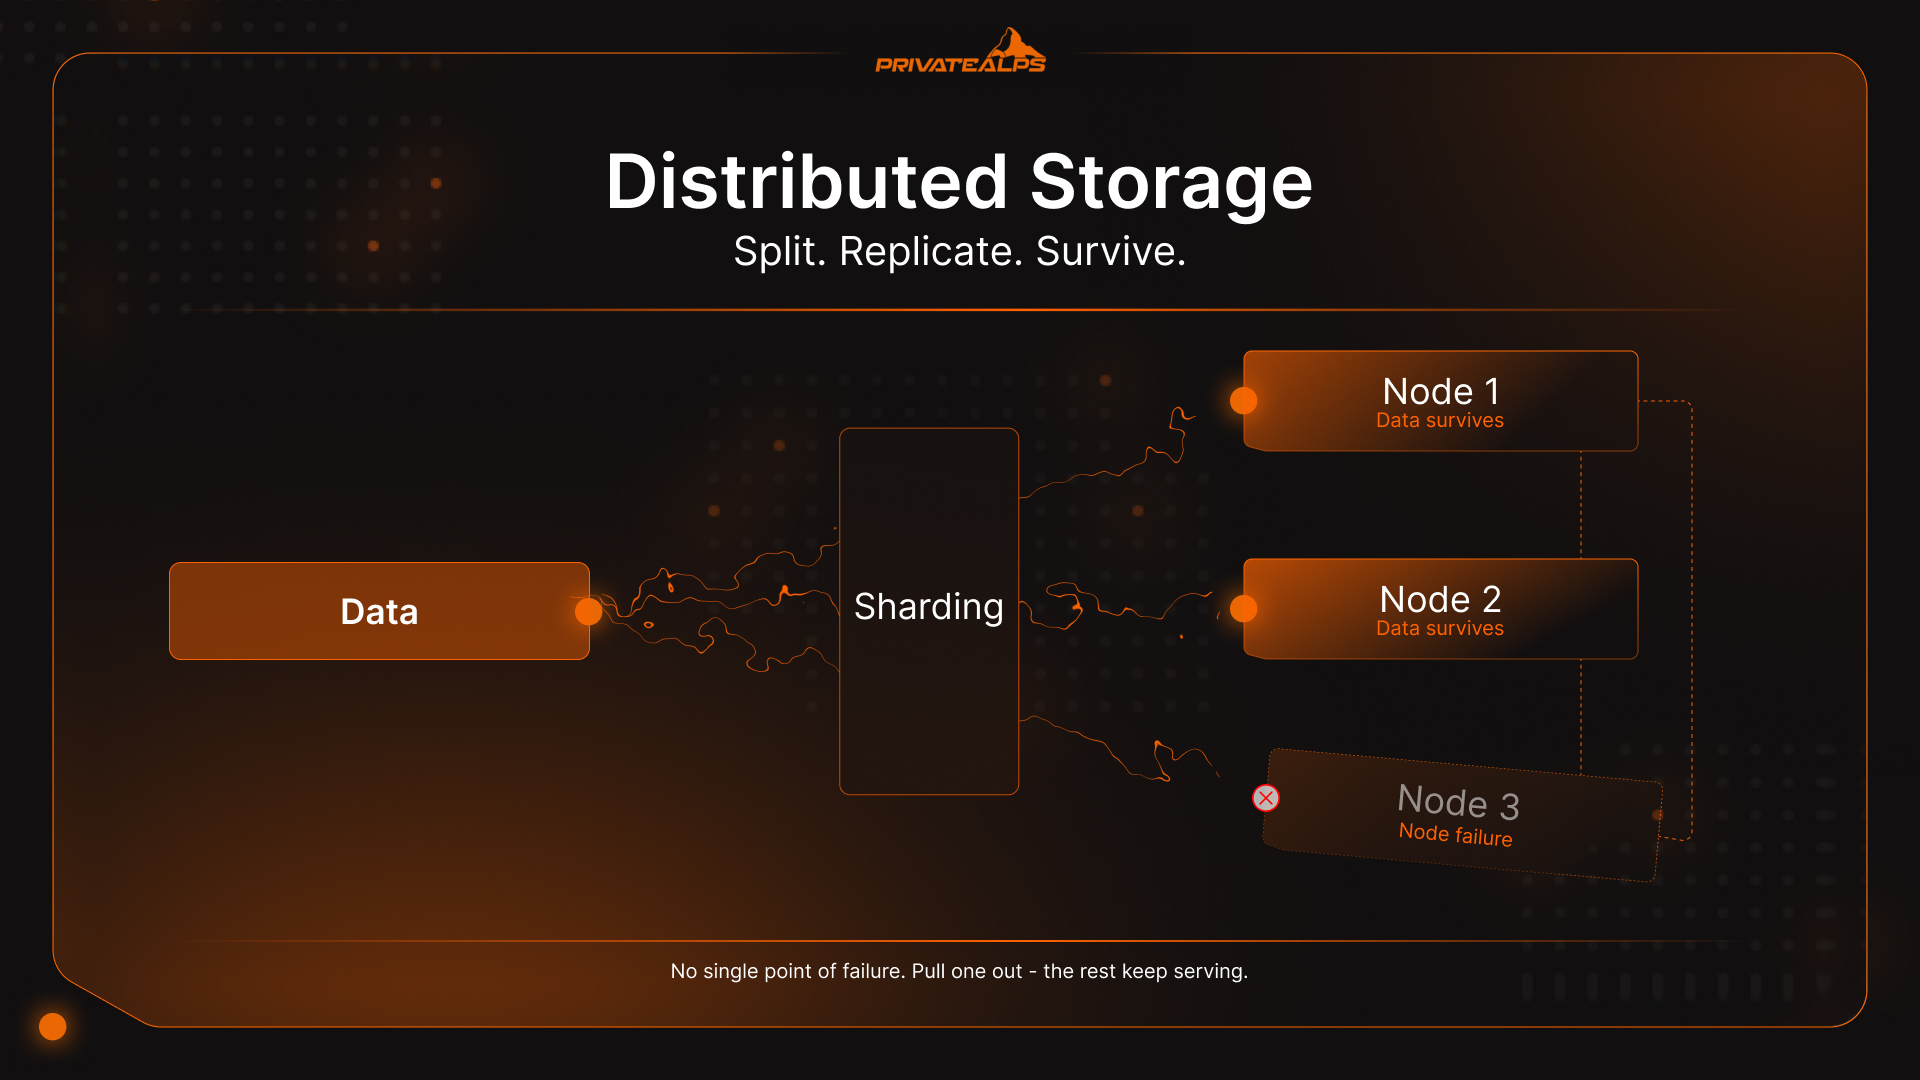
Розподілене сховище даних — це спосіб, яким сучасна інфраструктура зберігає дані, що є надто великими, надто критичними або надто інтенсивно використовуваними, щоб їх надійно утримував один комп'ютер. Замість того щоб записувати все на один сервер, система розділяє, реплікує або кодує ці дані між кількома незалежними вузлами: серверами, дисками, дата-центрами. Вони працюють разом, але жоден окремий вузол не містить усе. Вимкніть один із них, і решта продовжить обслуговувати запити. Цей посібник пояснює, як системи розподіленого сховища насправді поводяться під навантаженням, які архітектурні компроміси вони передбачають і який тип сховища підходить для якого навантаження.
Короткий огляд (AI Summary)
Розподілене сховище — це програмно визначена архітектура, яка розподіляє дані між кількома фізичними вузлами, використовуючи три основні техніки: шардинг (поділ даних на окремі фрагменти, які спрямовуються на різні вузли), реплікацію (зберігання кількох ідентичних копій на різних вузлах для швидкого доступу) та стирання кодування (кодування даних у фрагменти з математичною парністю, завдяки чому будь-яка їх частина дозволяє відновити весь обсяг).
Існує три основні типи систем розподіленого сховища: об'єктне сховище (плоский простір імен, API, сумісний з S3), блокове сховище (томи фіксованого розміру для випадкового вводу-виводу з низькою затримкою) та файлове сховище (ієрархічний простір імен через NFS або SMB). Будь-яка система розподіленого сховища даних стикається з теоремою CAP: вона може одночасно гарантувати лише дві з трьох властивостей: узгодженість, доступність і стійкість до розділення мережі.
Основна операційна перевага полягає в тому, що відмови вузлів не спричиняють простоїв: система автоматично перенаправляє запити на працюючі репліки. Масштаб того, що перебуває на кону: людство щодня генерує понад 400 мільйонів терабайтів нових даних, і жодна централізована архітектура не здатна вмістити такий обсяг, не зазнавши зрештою колапсу під власною вагою.
Розподілене сховище проти централізованого
Централізоване сховище розміщує все в одному місці: на одному сервері, в одній SAN-мережі або в одному дата-центрі. Це і є вся модель. Щойно в цьому місці виникає проблема, зупиняється все. Розподілене сховище вирішує це безпосередньо: дані зберігаються на кількох незалежних вузлах, тож жодна окрема точка відмови не може повністю вивести систему з ладу або заблокувати весь доступ.
Одна апаратна відмова — і доступ припиняється. Повністю. Масштабування означає оновлення або заміну основної системи, що зазвичай пов'язано з простоями та розмовами про капітальні витрати, які ніхто не хоче вести. Розподілене сховище обходить обидві проблеми за задумом: щоб збільшити ємність, додайте вузол, а якщо вузол вийде з ладу, кластер обійде його. Без жодних проблем і простоїв. Дані вже були розміщені на кількох вузлах до того, як щось зламалося.
| Параметр | Централізоване сховище | Розподілене сховище |
|---|---|---|
| Відмовостійкість | Єдина точка відмови | Дані зберігаються після втрати окремого вузла |
| Масштабованість | Вертикальна (оновлення заліза) | Горизонтальна (додавання вузлів) |
| Затримка | Низька для локального доступу | Змінна; залежить від топології мережі |
| Вартість у малому масштабі | Нижчі початкові витрати | Вищий мінімально життєздатний кластер |
| Вартість у великому масштабі | Дороге масштабування | Стандартне обладнання знижує вартість |
| Географічний розподіл | Одна локація | Мультирегіональність за конфігурацією |
| Складність експлуатації | Просте управління | Потребує інструментів оркестрації |
Як працюють системи розподіленого сховища
Система розподіленого сховища приймає вхідні дані, розбиває їх на фрагменти, спрямовує ці фрагменти на потрібні вузли в межах кластера та відстежує кожен елемент через шар метаданих. Завдяки цьому будь-який фрагмент можна знайти, отримати та зібрати за потреби, незалежно від того, на якому вузлі він розміщений. Це базовий цикл. Його забезпечують чотири механізми:
- Шардинг (розподіл даних). Коли дані надходять, система ріже їх на менші частини (шарди або блоки) і розподіляє між вузлами. Саме це відкриває паралельний ввід-вивід: кілька вузлів одночасно обробляють читання та запис, тож пропускна здатність зростає разом із розміром кластера, а не впирається в межу однієї машини. Логіка маршрутизації зазвичай базується на узгодженому хешуванні, яке забезпечує рівномірний розподіл навіть у міру зростання кластера, не перетасовуючи все заново щоразу, коли додається вузол.
- Реплікація. Простий, але ефективний підхід: зберігати N ідентичних копій кожного шарда на окремих вузлах, зазвичай три. Якщо один вузол вимикається, два інші продовжують обслуговувати запити миттєво. Жодної реконструкції та жодного очікування. Реплікація — правильний вибір для «гарячих» даних: активних баз даних, потокових стрічок реального часу, а також усього, де додаткова мілісекунда на читання справді має значення.
- Стирання кодування. Тут математика ефективності зберігання стає цікавою. Замість трьох повних копій система кодує об'єкт у $k$ фрагментів даних плюс $m$ фрагментів парності, розподіляє всі $k+m$ між вузлами і може відновити повний об'єкт з будь-яких $k$ із них. Отже, $m$ вузлів можуть вийти з ладу одночасно, і нічого не буде втрачено. Конфігурація Reed-Solomon RS(6,3) зберігає 9 блоків замість 18, потрібних для 3x реплікації, знижуючи накладні витрати на сире сховище з 200% приблизно до 50%. Недолік полягає в тому, що кодування та декодування споживають процесорні цикли, а стирання кодування працює краще для «холодних» даних, тобто контенту, який рідко змінюють або до якого рідко звертаються. Для навантажень із частими дрібними записами 3x реплікація все ще виграє за затримкою.
| Метод захисту | Накладні витрати сховища | Найкраще підходить | Компроміс |
|---|---|---|---|
| 3x реплікація | 3x від сирої ємності | «Гарячі» дані, навантаження з низькою затримкою | Висока вартість сховища у великому масштабі |
| Стирання кодування RS(6,3) | 1,5x від сирої ємності | «Холодні» дані, архівування, великі об'єкти | Навантаження на процесор, довший час відновлення |
- Маршрутизація метаданих. Кожна система розподіленого сховища веде шар метаданих, по суті карту того, на якому вузлі розташований кожен шард. Коли клієнт запитує дані, служба метаданих визначає потрібні вузли, а система отримує і збирає фрагменти, не показуючи клієнту жодних подробиць складності. У великомасштабних кластерах, таких як Ceph чи HDFS, шар метаданих сам розподілений між вузлами. Так і має бути. Один сервер метаданих стає вузьким місцем, від якого ви намагалися позбутися.
Типи систем розподіленого сховища
Розподілене сховище — це не одна річ. Це категорія з трьома різними моделями даних у основі, і вибір неправильної для конкретного навантаження є напрочуд поширеною та дорогою помилкою. Об'єктне, блокове та файлове сховище вирішують різні завдання. Розподілені бази даних, як-от Cassandra, CockroachDB і Google Spanner, становлять четвертий тип: вони додають семантику запитів поверх розподіленого управління даними, але це окрема тема.
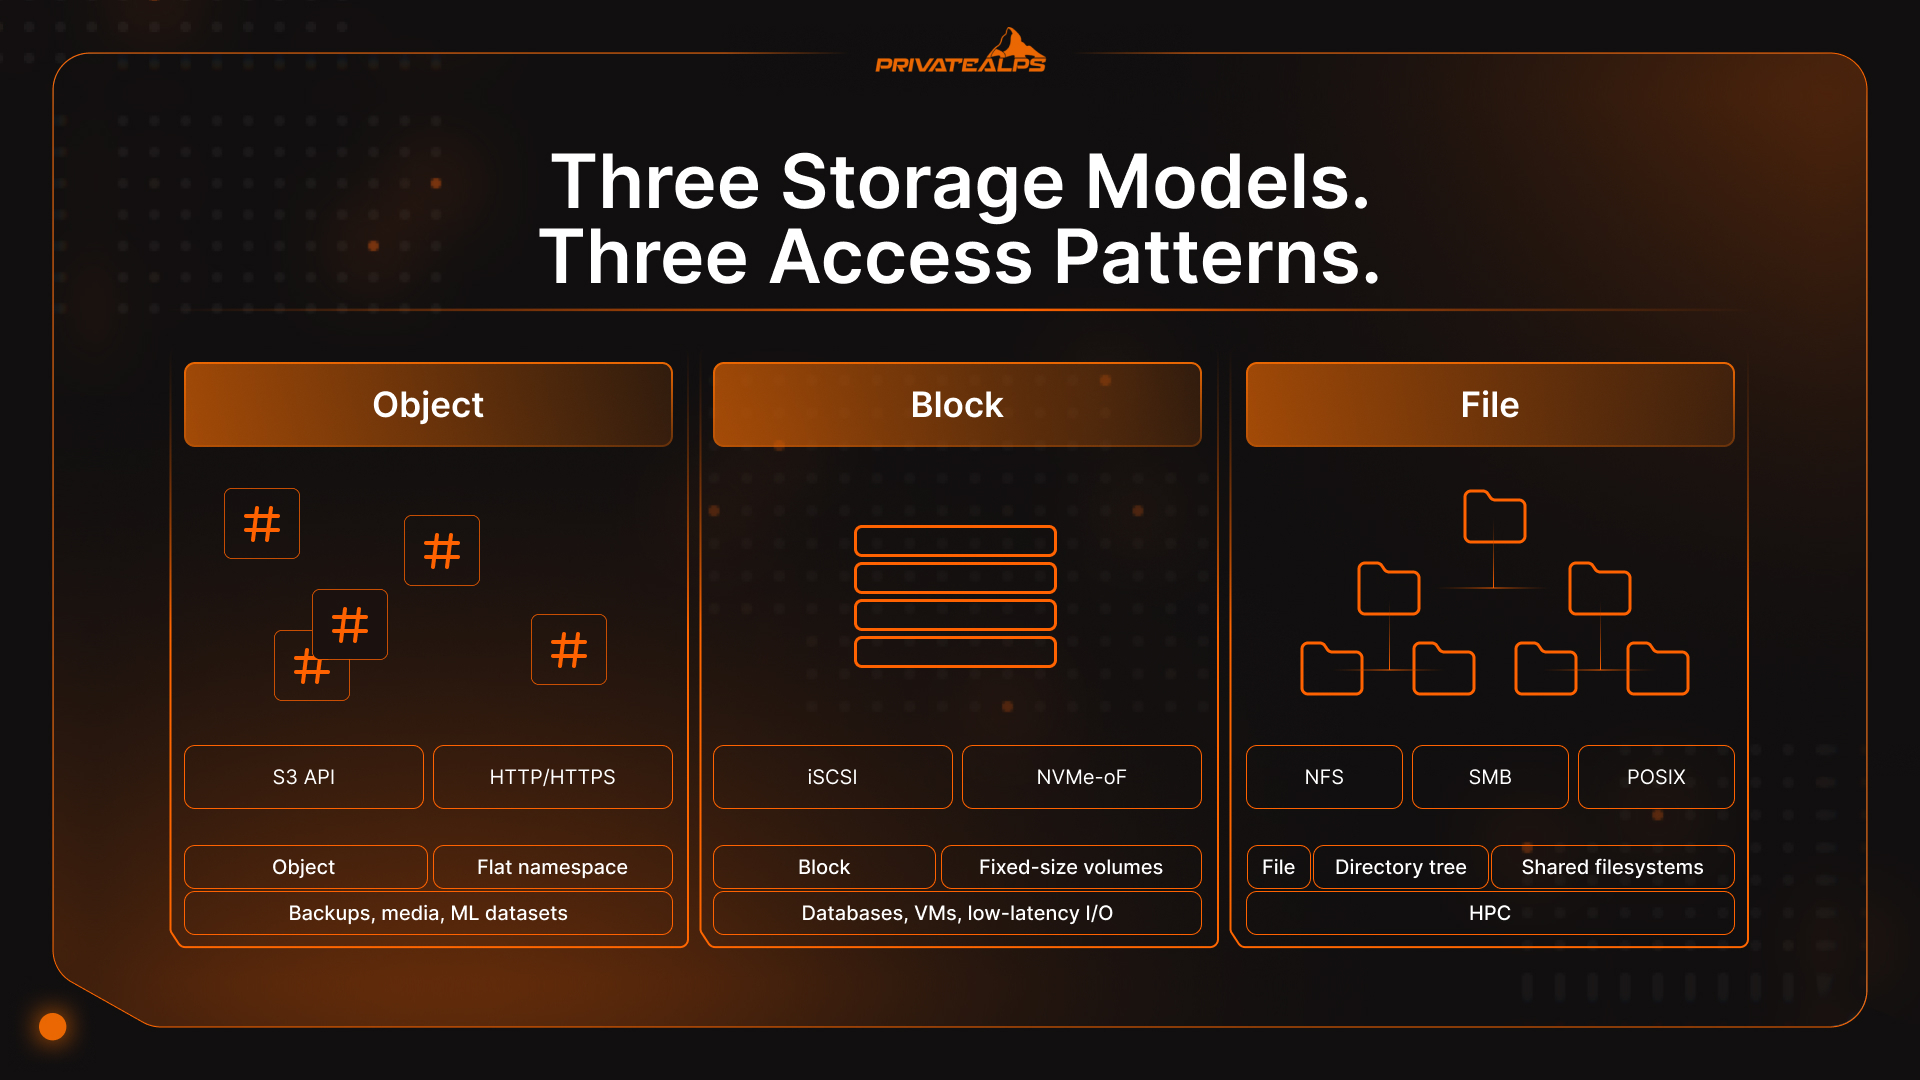
| Тип | Як зберігаються дані | Метод доступу | Найкраще підходить | Приклади |
|---|---|---|---|---|
| Об'єктне | Плоский простір імен, об'єкти з багатими метаданими | API, сумісний з S3 (HTTP/HTTPS) | Неструктуровані дані у великих обсягах: резервні копії, медіа, набори даних для ML | AWS S3, MinIO, Ceph RADOS |
| Блокове | Сирі томи фіксованого розміру | iSCSI, NVMe-oF, FC | Бази даних, віртуальні машини, випадковий ввід-вивід з низькою затримкою | Ceph RBD, AWS EBS, Lightbits |
| Файлове | Ієрархічне дерево каталогів | NFS, SMB, POSIX | Спільні файлові системи, HPC, домашні каталоги | GlusterFS, HDFS, Azure Files |
Розподілене об'єктне сховище
Розподілене об'єктне сховище організовує дані як окремі незмінні об'єкти в плоскому просторі імен: без каталогів, без шляхів до файлів і без ієрархії для підтримки. Кожен об'єкт отримує унікальний ідентифікатор (хеш або UUID) та багаті метадані, а доступ до нього здійснюється через API, сумісний з S3, по HTTP. Оскільки об'єкти замінюються, а не оновлюються частково, проблема блокувань, яка обмежує продуктивність і масштабованість у блокових і файлових системах, просто зникає. Саме так AWS S3, Azure Blob і Ceph масштабуються до ексабайтів: без накладних витрат на координацію простору імен, без конкуренції за блокування і з можливістю будь-якого вузла кластера незалежно обслуговувати будь-який запит до об'єкта.
Розподілене блокове сховище
Блокове сховище передає серверам сирі томи: блоки фіксованого розміру з унікальними адресами та без жодної абстракції файлової системи поверх них. Застосунки записують дані безпосередньо в блоки, що забезпечує стабільний випадковий ввід-вивід з низькою затримкою для баз даних, дисків віртуальних машин і контейнеризованих навантажень. Одне архітектурне обмеження, яке часто несподівано виникає: блоковий том, як правило, може бути змонтований лише на одному сервері в певний момент часу. Для спільного доступу з кількох серверів потрібна додаткова оркестрація, наприклад кластерна файлова система, накладена на блокові пристрої.
Розподілене файлове сховище
Файлове сховище надає спільну файлову систему через стандартні протоколи: NFS, SMB, доступ, сумісний з POSIX. Кілька клієнтів можуть одночасно монтувати один том, що робить його природним вибором для спільної роботи, HPC-середовищ і застарілих застосунків, які очікують дерева каталогів і не будуть переписані найближчим часом. Реальний компроміс полягає в тому, що підтримка узгодженого простору імен каталогів між розподіленими вузлами створює накладні витрати на координацію, які зростають разом із масштабом. Більшість гіперскейлерів зрештою переходять від розподіленого файлового сховища до розподіленого об'єктного для основних даних, щойно обсяги стають достатньо великими.
Теорема CAP: неминучий компроміс у розподіленому сховищі
Теорема CAP стверджує, що розподілена система даних може одночасно гарантувати лише дві з трьох властивостей: узгодженість (кожне читання повертає останній запис), доступність (кожен запит отримує відповідь) і стійкість до розділення (система продовжує працювати під час розривів мережі). Мережі розриваються, тож стійкість до розділення не є опційною. Справжній вибір завжди стоїть між узгодженістю та доступністю в момент збою.
Ерік Брюер представив CAP у 2000 році; Гілберт і Лінч формалізували доведення у 2002-му. Це досі рішення, яке визначає все інше в архітектурі розподіленого сховища, адже воно вирішує, як система поводиться саме тоді, коли це найбільше потрібно, а саме коли щось уже зламалося.
| Система | Тип CAP | Поведінка під час розділення | Найкраще підходить |
|---|---|---|---|
| MongoDB | CP (з читанням і записом за більшістю) | Відхиляє запити, доки узгодженість не буде відновлено | Фінансові записи, інвентар, бронювання |
| HBase | CP | Повертає помилки, а не застарілі дані | Структуровані аналітичні дані, узгоджені пакетні завдання |
| Apache Cassandra | AP | Залишається доступною; може повертати застарілі читання | Стрічки соцмереж, месенджери, телеметрія IoT |
| DynamoDB (типово) | AP | Завжди відповідає; узгоджує розбіжності асинхронно | Застосунки для споживачів з високою пропускною здатністю |
| CockroachDB | CP | Спочатку узгодженість, розподілений SQL | Глобальні транзакційні навантаження |
Практичне рішення таке: чи може ваше навантаження витримати застаріле читання? Баланс банківського рахунку, бронювання місця, облік інвентарю — ймовірно, ні. Оберіть CP. Стрічка соцмереж, потік подій із сенсорів, телеметрія аналітики — кілька секунд застарілості цілком прийнятні. Оберіть AP і зберігайте гарантію доступності.
Безпека розподіленого сховища даних: шифрування та суверенітет даних
Безпека в розподіленому сховищі даних охоплює три окремі рівні: дані в стані спокою, дані під час передавання та володіння ключами. Якщо помилитися з будь-яким із них, решта не врятує. Інфраструктура може бути цілком доступною, водночас чутливі дані непомітно відкриті для сторонніх осіб.
Шифрування має охоплювати всі три рівні. Для даних у стані спокою зазвичай використовують AES-256, з ключами, які керує провайдер, або з ключами, якими керує клієнт (CMK). Керування ключами провайдером простіше в експлуатації, але ключовий матеріал зберігає постачальник сховища, а це критично важливо для регульованих галузей, які проходять аудити. Клієнтське шифрування усуває цей ризик повністю: дані шифруються ще до того, як покинуть клієнта, тож провайдер ніколи не бачить відкритого тексту, хоч би які юридичні запити надходили. Для даних під час передавання TLS 1.3 є мінімальним стандартом безпеки. Будь-яке використання TLS 1.2 за більшістю чинних стандартів відповідності потребує задокументованого винятку.
Суверенітет даних часто стає несподіванкою для команд. На дані поширюються закони тієї країни, де вони фізично зберігаються, а не країни компанії чи місцезнаходження користувача. Швейцарія має статус адекватності згідно зі статтею 45 GDPR, тож передавання даних із ЄС до Швейцарії відбувається без додаткових договірних гарантій. Оновлений Федеральний закон про захист даних (nFADP) узгоджує швейцарські внутрішні норми з GDPR, а отже, швейцарська інфраструктура одночасно забезпечує послідовне регуляторне покриття за обома режимами.
Є один момент, який легко відкласти, але не варто: криптографічні алгоритми, що захищають більшість сховищ сьогодні, не розраховані на стійкість до потужного квантового комп'ютера. NIST затвердив три стандарти постквантової криптографії у серпні 2024 року, зокрема FIPS 203 (ML-KEM). Якщо ваше розподілене сховище даних зберігає записи з тривалим строком зберігання, як-от медичні архіви, фінансові звіти чи юридичні документи, загроза «зберегти зараз, розшифрувати пізніше» вже актуальна. Оцінку ризиків слід почати задовго до того, як ці архіви досягнуть зрілості.
Ключові переваги розподіленого сховища даних
- Відмовостійкість без переривання роботи сервісу: відмова вузла запускає виявлення через heartbeat-сигнали та автоматичне перенаправлення на справні репліки. Ручне втручання не потрібне, вікно обслуговування також.
- Горизонтальна масштабованість: нова ємність сховища з'являється завдяки додаванню вузлів до кластера. Дані перерозподіляються у фоновому режимі, не впливаючи на живий трафік і не вимагаючи простою.
- Географічний розподіл: реплікація між регіонами зменшує затримку для віддалених користувачів і перетворює відповідність вимогам щодо місця зберігання даних на питання конфігурації, а не окремого інфраструктурного проєкту.
- Паралельна пропускна здатність I/O: кілька вузлів одночасно обробляють читання та запис. Це єдина масштабована архітектура для конвеєрів навчання ШІ та МН, транскодування відео й потокового медіа у реальних промислових обсягах.
- Відсутність прив'язки до постачальника завдяки відкритим протоколам: API, сумісні з S3, NFS і відкриті платформи на кшталт Ceph дозволяють мігрувати між провайдерами або розгортати інфраструктуру локально без переписування коду застосунків.
- Економічна ефективність у великих масштабах: стандартне апаратне забезпечення замінює дорогі пропрієтарні масиви сховища. Кодування erasure coding додатково знижує вимоги до сирої ємності до 50% порівняно з повною реплікацією між вузлами.
Обмеження та виклики розподіленого сховища даних
- Складність узгодженості: підтримка узгодженого стану між вузлами потребує ретельного налаштування моделей узгодженості, коефіцієнтів реплікації та параметрів кворуму. Помилка конфігурації не дає про себе знати голосно, а тихо призводить до розходження даних.
- Операційні витрати: експлуатація кластера розподіленого сховища передбачає планування доменів відмов, процедури заміни вузлів, конвеєри моніторингу та налаштування продуктивності. Один сервер не вимагає від вас усього цього.
- Залежність від мережі: уся архітектура передбачає надійне з'єднання з високою пропускною здатністю між вузлами. Погіршення мережі напряму і пропорційно призводить до зростання затримки та втрати пропускної здатності сховища.
- Затримка при малих випадкових операціях I/O: розподілене сховище оптимізоване для великих послідовних читань і паралельної пропускної здатності. Навантаження з великою кількістю малих випадкових операцій I/O, особливо OLTP-бази даних, часто працюють краще на локально підключеному блочному сховищі NVMe.
- Мінімальний життєздатний масштаб: переваги розподіленого сховища за вартістю та складністю не проявляються на кластері з двох вузлів. Нижче певного порога керована хмарна служба сховища або добре налаштований окремий сервер просто дешевші й простіші в експлуатації.
Практичні сценарії використання розподіленого сховища даних
- Медіа та стримінг: Netflix і YouTube не віддають відео з одного центрального місця, а розподіляють закодований контент між кластерами об'єктного сховища, розташованими географічно поблизу глядачів. Один центр обробки даних не впорається з одночасними глобальними потоками у великому масштабі, а лише витрати на пропускну здатність були б непомірними. Саме розподілене сховище даних робить економіку стримінгу реально життєздатною.
- Охорона здоров'я: одне МРТ-дослідження генерує від 500 МБ до 1 ГБ даних зображень. Помножте це на велику мережу лікарень із різними модальностями, тривалими вимогами до зберігання та кількома майданчиками, і ви отримаєте петабайти, які швидко накопичуються. Масштабоване розподілене сховище з географічним резервуванням дає медичним системам змогу зберігати доступ до записів пацієнтів, що відповідає вимогам HIPAA, навіть коли регіональний центр обробки даних виходить з ладу.
- ШІ та машинне навчання: навчання великої мовної моделі означає подачу даних обсягом від терабайтів до петабайтів на кластери GPU, до того ж у непослідовних шаблонах доступу, які майже миттєво перевантажили б традиційну систему зберігання. Ceph, HDFS і об'єктні сховища, сумісні з S3, стали стандартним шаром інфраструктури для конвеєрів МН, адже їхня паралельна пропускна здатність читання справді відповідає тому, що споживають кластери GPU.
- Резервне копіювання та аварійне відновлення: справжнє аварійне відновлення означає, що дані існують щонайменше у двох географічно відокремлених локаціях з незалежними доменами відмов, а не у двох стійках в одній будівлі. Політики реплікації та правила розміщення, вбудовані безпосередньо в шар розподіленого сховища, визначають RPO та RTO на рівні інфраструктури без потреби в окремому стеку програм для резервного копіювання. Менше рухомих частин також означає меншу поверхню атаки.
Розподілене та децентралізоване сховище: у чому різниця?
Розподілене сховище означає, що дані розподілені між багатьма вузлами, але вся система належить і контролюється однією організацією: політиками, правами доступу, можливістю видалення, журналами аудиту. Децентралізоване сховище повністю прибирає таку центральну владу. Дані зберігаються на незалежних однорангових вузлах, і жоден окремий оператор не може одноосібно цензурувати, отримати доступ чи видалити їх.
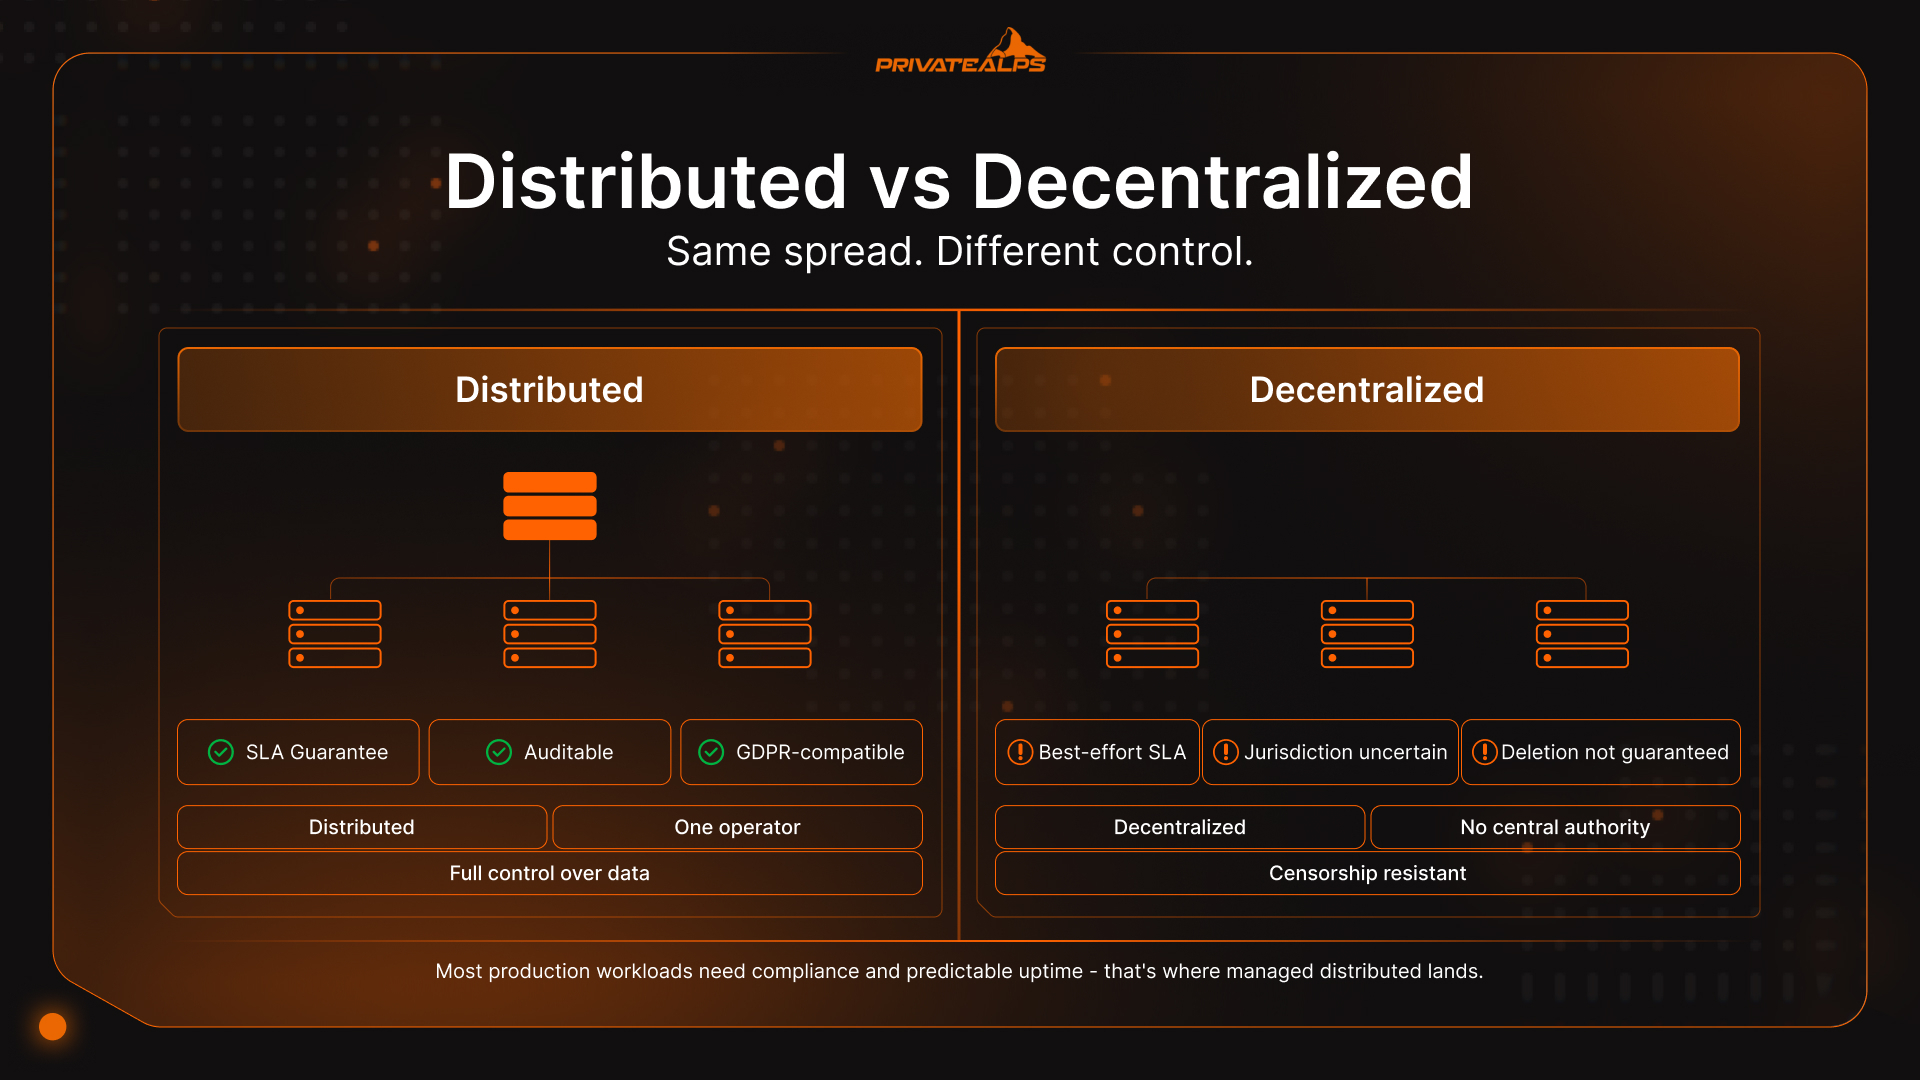
Ця різниця має реальні наслідки для експлуатації. Централізовано керовану розподілену систему можна перевірити, оновити, забезпечити SLA та привести у відповідність до регуляторних вимог. Децентралізована система жертвує всім цим заради стійкості до цензури та роботи без довіри до посередника. Це цінно в окремих контекстах, але не те, що більшості бізнесів, які експлуатують продуктивну сховищну інфраструктуру, справді потрібно.
| Параметр | Розподілене сховище | Децентралізоване сховище |
|---|---|---|
| Контроль | Централізоване адміністрування | Немає центрального органу |
| SLA / гарантії доступності | Можливі договірні гарантії | Найкращі зусилля, залежить від протоколу |
| Відповідність вимогам | Придатне для аудиту, сумісне з GDPR | Юрисдикція невизначена |
| Видалення даних | Гарантоване | Не завжди можливе |
| Контроль доступу | Рольовий, керований | Криптографічний, без довіри |
| Приклади | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Ще один рівень, який варто розглянути окремо: мультирегіональне хмарне сховище, наприклад AWS S3 з реплікацією між регіонами або геонадмірне сховище Azure. Це все одно централізовано керована інфраструктура. Провайдер керує вузлами та реплікацією, а ви фактично орендуєте географію. Справжні розподілені хмарні платформи, як-от Storj чи Cubbit, розподіляють дані між незалежними операторами, усуваючи прив'язку до провайдера, але знову ставлять питання про SLA та журнали аудиту. Для більшості навантажень, яким потрібна документація з відповідності та передбачувана доступність, найкращим варіантом є керований розподілений підхід.
Підсумок
Розподілене сховище даних — це не продукт, а архітектурна категорія, і відповідний варіант повністю залежить від того, що ви запускаєте. Об'єктне, блочне та файлове сховище мають моделі даних, створені для різних шаблонів доступу та типів навантажень. Теорема CAP змушує робити реальний вибір між узгодженістю та доступністю щойно виникають збої мережі, і помилитися тут може бути дорого. Щодо реплікації та erasure coding, рішення визначає «температура» даних: гарячим даним потрібна реплікація для низької затримки, а холодні дані виграють від ефективності erasure coding. Для більшості команд кероване розподілене рішення, від приватного провайдера або з публічної хмари, за умови що місце зберігання даних і засоби безпеки можна перевірити, забезпечує кращий баланс масштабованості, продуктивності та щоденної операційної простоти, ніж самостійно розгорнутий кластер.
Зберігайте дані у Швейцарії разом із PrivateAlps
Якщо вашому навантаженню потрібне розподілене об'єктне сховище, сумісне з S3, із перевірюваним місцем зберігання даних, PrivateAlps використовує швейцарську інфраструктуру, повністю відповідну статті 45 GDPR і nFADP. Ваші дані залишаються у Швейцарії: без передавання третім сторонам, без неоднозначної маршрутизації через закордонні юрисдикції, без несподіванок. Чи ви мігруєте від гіперскейлера, чи створюєте архітектуру розподіленого сховища з орієнтацією на приватність з нуля, PrivateAlps забезпечує продуктивність і впевненість у відповідності, яких справді потребує ваше навантаження.
Часті запитання
У чому різниця між розподіленим сховищем і хмарним сховищем?
Хмарне сховище є моделлю надання послуг: інфраструктуру керує хтось інший, ви отримуєте доступ через інтернет і платите за використання. Розподілене сховище є архітектурою: дані розподілені між кількома вузлами для резервування та масштабування. Це незалежні поняття. Розподілене сховище можна повністю розгорнути локально за допомогою Ceph або MinIO, а хмарний провайдер технічно може надавати централізоване сховище через API. Більшість хмарних сервісів зберігання всередині використовують розподілену архітектуру, але це деталь реалізації, а не визначення хмарного сховища.
Яка найкраща система розподіленого сховища?
Універсальної відповіді немає. Все залежить від навантаження та моделі даних. Для неструктурованих даних і резервних копій стандартним вибором є об'єктні сховища, сумісні з S3, як-от MinIO або Ceph RADOS. Для томів баз даних і дисків віртуальних машин, яким потрібен узгоджений блочний I/O з низькою затримкою, краще підходить Ceph RBD або Lightbits. Для спільних файлових систем у HPC або застарілих середовищах команди зазвичай обирають GlusterFS або HDFS. Почніть із шаблону доступу, і вибір системи зберігання випливатиме з нього.
Чи є розподілене сховище тим самим, що й RAID?
Ні. RAID працює всередині одного сервера або масиву сховища і захищає від відмови диска в межах однієї машини. Розподілене сховище працює між окремими фізичними вузлами, з'єднаними мережею, які можуть розташовуватися в кількох будівлях або навіть у цілих центрах обробки даних. RAID не допомагає, коли виходить з ладу сам сервер. Розподілені системи зберігання спеціально створені для того, щоб витримувати відмови вузлів, стійок і повні відключення центрів обробки даних. Різниця у масштабі принципова.
Як розподілене сховище справляється з відмовами вузлів?
Вузли регулярно надсилають heartbeat-сигнали шару метаданих кластера. Коли вузол перестає відповідати, система виявляє збій, зазвичай протягом кількох секунд, і перенаправляє запити на вузли з репліками або фрагментами erasure coding. У схемах на основі реплікації фоновий процес відновлення потім створює нові копії, щоб відновити налаштований коефіцієнт реплікації в кластері. Усе відбувається автоматично: у добре налаштованому кластері розподіленого сховища застосунки взагалі не помічають збою.
Чи підходить розподілене сховище малому бізнесу?\\
Керовані сервіси розподіленого сховища, наприклад об'єктне сховище, сумісне з S3, від хмарного провайдера або спеціалізованого сервісу на кшталт PrivateAlps, працюють у будь-якому масштабі без мінімальних вимог до кластера. Самостійно розгорнуті кластери розподіленого сховища — інша історія: для продуктивної роботи Ceph зазвичай потрібно щонайменше три–п'ять вузлів, перш ніж операційні витрати почнуть виправдовувати себе. Для невеликих команд керовані сервіси забезпечують повні архітектурні переваги розподіленого сховища без тягаря управління інфраструктурою.
