


Apa Itu Distributed Storage?
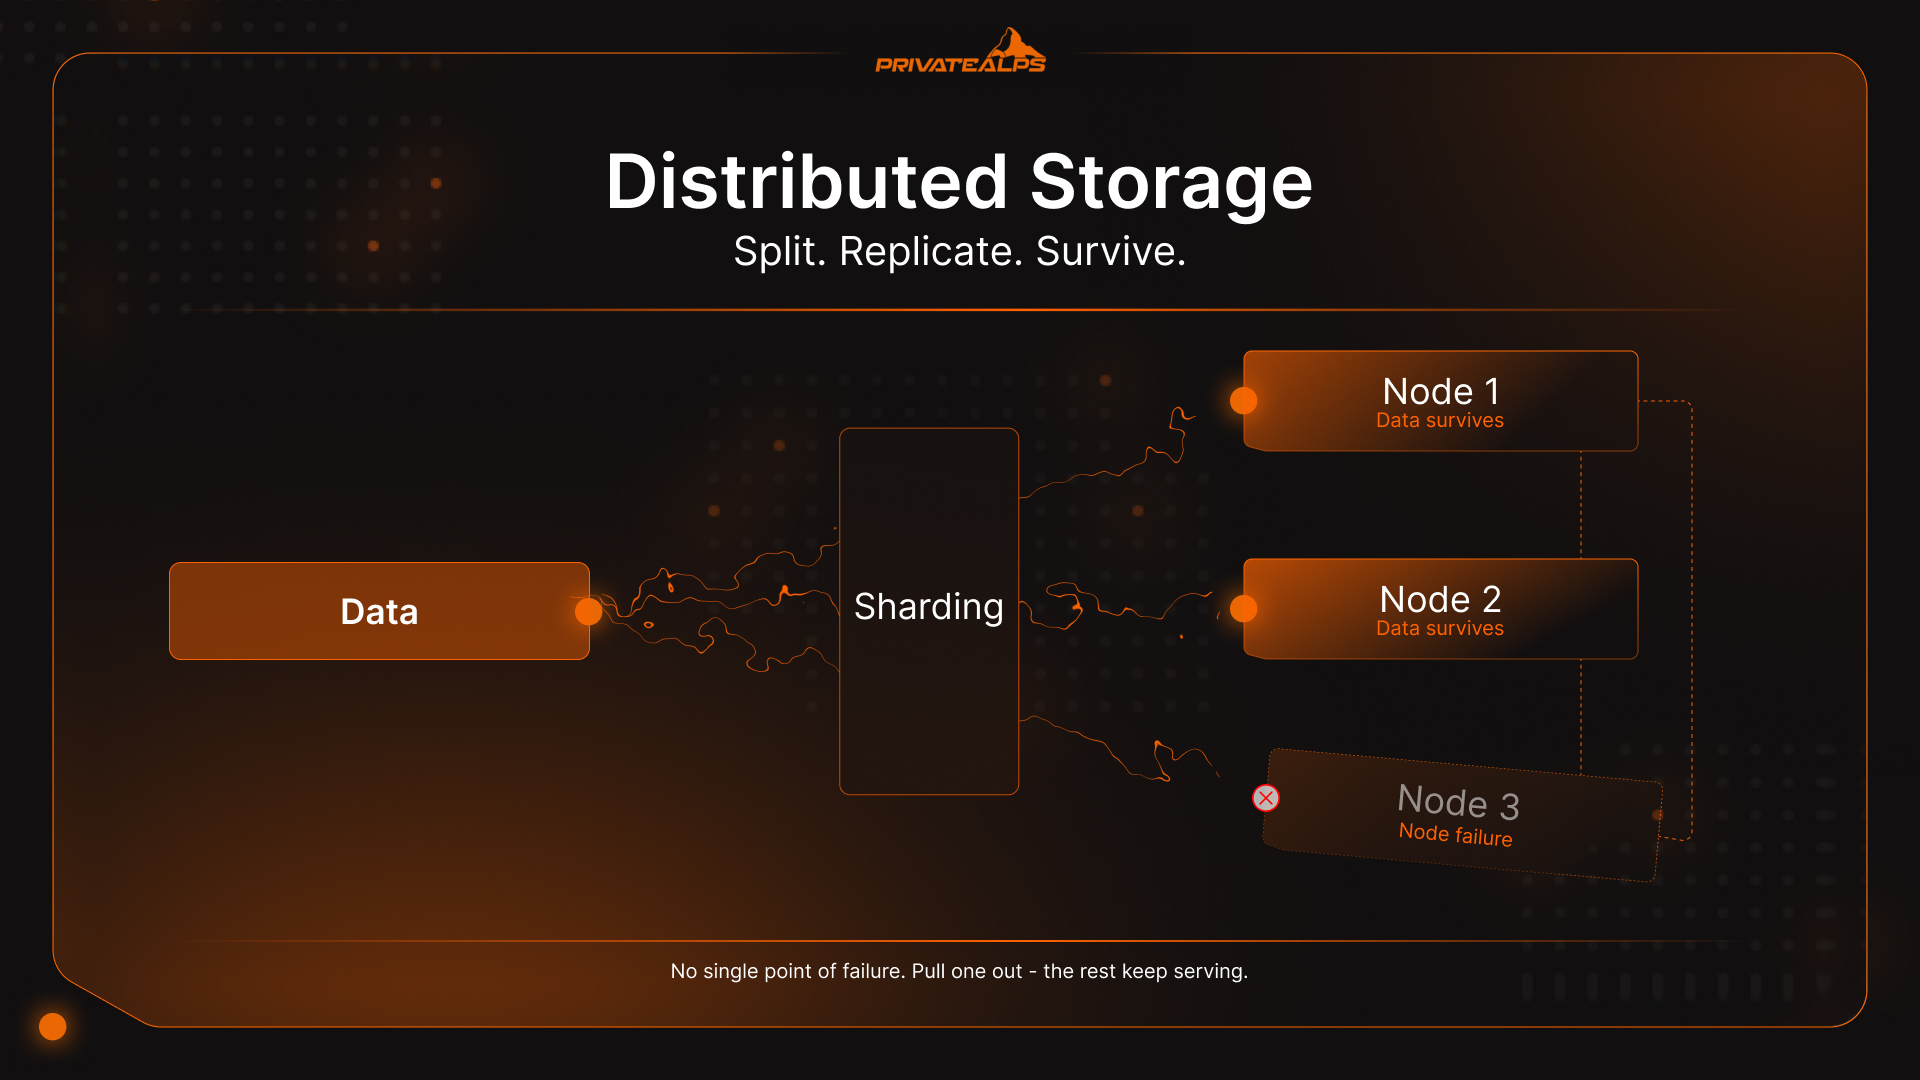
Distributed storage adalah cara infrastruktur modern menangani data yang terlalu besar, terlalu penting, atau terlalu sering diakses untuk disimpan secara andal di satu mesin. Alih-alih menulis semua data ke satu server, sistem memecah, mereplikasi, atau mengodekan data tersebut ke banyak node independen, seperti server, drive, dan data center. Node-node ini bekerja bersama, tetapi tidak ada satu node pun yang menyimpan seluruh data. Jika satu node dicabut, node lainnya tetap melayani permintaan. Panduan ini membahas cara sistem distributed storage benar-benar berperilaku di bawah beban, trade-off arsitektur apa saja yang harus diterima, dan jenis penyimpanan mana yang cocok untuk setiap beban kerja.
Ringkasan AI
Distributed storage adalah arsitektur yang didefinisikan melalui perangkat lunak dan mempartisi data di banyak node fisik dengan tiga teknik inti: sharding (membagi data menjadi potongan-potongan diskret yang diarahkan ke node berbeda), replikasi (menyimpan beberapa salinan identik di berbagai node untuk akses cepat), dan erasure coding (mengodekan data menjadi fragmen dengan parity matematis sehingga sebagian fragmen saja sudah cukup untuk merekonstruksi keseluruhan data).
Ada tiga jenis utama sistem distributed storage: object storage (namespace datar, API kompatibel S3), block storage (volume berukuran tetap untuk I/O acak dengan latensi rendah), dan file storage (namespace hierarkis melalui NFS atau SMB). Setiap penyiapan distributed data storage berhadapan dengan CAP theorem, yang hanya dapat menjamin dua dari consistency, availability, dan partition tolerance secara bersamaan.
Manfaat operasional utamanya adalah kegagalan node tidak menyebabkan gangguan layanan. Sistem akan otomatis mengalihkan permintaan ke replika yang masih berfungsi. Skala taruhannya: umat manusia menghasilkan lebih dari 400 juta terabyte data baru setiap hari. Volume sebesar ini tidak dapat ditampung oleh arsitektur terpusat tanpa pada akhirnya runtuh di bawah bebannya sendiri.
Perbedaan Distributed Storage dan Centralized Storage
Centralized storage menempatkan semua data di satu lokasi, yaitu satu server, satu SAN, atau satu data center. Itulah seluruh modelnya. Ketika lokasi itu bermasalah, semuanya ikut berhenti. Distributed storage menjawab masalah ini secara langsung: data tersebar di banyak node independen, sehingga tidak ada satu titik kegagalan yang dapat membuat seluruh sistem offline atau memblokir semua akses.
Satu kegagalan perangkat keras dan akses langsung terhenti. Titik. Penskalaan berarti meningkatkan atau mengganti sistem utama, yang biasanya melibatkan downtime dan pembahasan belanja modal yang tidak ingin dihadapi siapa pun. Distributed storage menghindari keduanya secara desain: tambahkan node untuk memperbesar kapasitas, dan saat sebuah node mati, cluster akan mengalihkan lalu lintas di sekitarnya. Tanpa keributan, tanpa gangguan. Data sudah berada di banyak node sebelum ada yang rusak.
| Dimensi | Penyimpanan Terpusat | Penyimpanan Terdistribusi |
|---|---|---|
| Toleransi kesalahan | Satu titik kegagalan | Data tetap aman saat satu node hilang |
| Skalabilitas | Vertikal (upgrade hardware) | Horizontal (tambah node) |
| Latensi | Rendah untuk akses lokal | Bervariasi; bergantung pada topologi jaringan |
| Biaya skala kecil | Biaya awal lebih rendah | Cluster minimum yang layak lebih mahal |
| Biaya skala besar | Mahal untuk diskalakan | Commodity hardware menekan biaya |
| Distribusi geografis | Satu lokasi | Multi-region sesuai konfigurasi |
| Kompleksitas operasional | Mudah dikelola | Memerlukan tooling orkestrasi |
Cara Kerja Sistem Distributed Storage
Sistem distributed storage menerima data masuk, memecahnya menjadi potongan-potongan, mengarahkan potongan tersebut ke node yang tepat di seluruh cluster, lalu melacak setiap bagian melalui metadata layer. Dengan begitu, fragmen apa pun dapat ditemukan, diambil, dan dirakit ulang sesuai kebutuhan, tidak peduli node mana yang menyimpannya. Itulah siklus dasarnya. Ada empat mekanisme yang menjalankannya:
- Sharding (Partisi Data) Saat data masuk, sistem memotongnya menjadi bagian-bagian yang lebih kecil, yaitu shard atau blok, lalu menyebarkannya ke berbagai node. Di sinilah parallel I/O terbuka: banyak node menangani pembacaan dan penulisan secara bersamaan, sehingga throughput meningkat seiring ukuran cluster, bukan terbatas pada kapasitas satu mesin. Logika routing biasanya memakai consistent hashing, yang menjaga distribusi tetap merata saat cluster bertambah tanpa menyusun ulang seluruh data setiap kali sebuah node ditambahkan.
- Replikasi Pendekatannya sederhana tetapi efektif: simpan N salinan identik dari setiap shard di node terpisah, biasanya tiga. Jika satu node offline, dua node lainnya langsung tetap melayani. Tidak perlu rekonstruksi dan tidak perlu menunggu. Replikasi adalah pilihan tepat untuk hot data, seperti database aktif, feed real-time, dan apa pun yang akan rugi jika pembacaan bertambah satu milidetik.
- Erasure Coding Di sinilah perhitungan efisiensi penyimpanan menjadi menarik. Alih-alih tiga salinan penuh, sistem mengodekan objek menjadi $k$ fragmen data ditambah $m$ fragmen parity, mendistribusikan semua $k+m$ ke seluruh node, dan dapat merekonstruksi objek penuh dari $k$ fragmen mana pun. Jadi $m$ node dapat gagal sekaligus tanpa ada data yang hilang. Konfigurasi Reed-Solomon RS(6,3) menyimpan 9 blok, bukan 18 blok yang dibutuhkan oleh replikasi 3x, sehingga overhead penyimpanan mentah turun dari 200% menjadi sekitar 50%. Kelemahannya, proses encode dan decode menghabiskan siklus CPU, dan erasure coding lebih cocok untuk cold data, yaitu konten yang jarang diubah atau diakses dengan frekuensi tinggi. Untuk beban kerja dengan penulisan kecil yang sering, replikasi 3x tetap lebih unggul dari sisi latensi.
| Metode Proteksi | Overhead Penyimpanan | Paling Cocok Untuk | Trade-Off |
|---|---|---|---|
| Replikasi 3x | 3x kapasitas mentah | Hot data, beban kerja berlatensi rendah | Biaya penyimpanan tinggi saat skala besar |
| Erasure Coding RS(6,3) | 1,5x kapasitas mentah | Cold data, arsip, objek besar | Beban CPU, latensi rebuild lebih tinggi |
- Metadata Routing Setiap sistem distributed storage menyimpan metadata layer, yang pada dasarnya berupa peta shard mana berada di node mana. Saat klien meminta data, layanan metadata menentukan node yang tepat, lalu sistem mengambil dan merakit fragmen tanpa klien perlu melihat kerumitannya. Pada cluster berskala besar seperti Ceph atau HDFS, metadata layer itu sendiri juga didistribusikan ke banyak node. Memang harus begitu. Satu metadata server saja akan menjadi bottleneck yang justru ingin Anda hindari.
Jenis-Jenis Sistem Distributed Storage
Distributed storage bukan satu hal tunggal. Ia adalah kategori dengan tiga model data yang berbeda di dalamnya, dan salah memilih satu untuk sebuah beban kerja merupakan kesalahan yang cukup sering terjadi dan mahal. Object, block, dan file storage masing-masing memecahkan masalah yang berbeda. Distributed database, seperti Cassandra, CockroachDB, dan Google Spanner, mewakili jenis keempat dengan menambahkan semantik query di atas pengelolaan data terdistribusi, tetapi itu adalah pembahasan tersendiri.
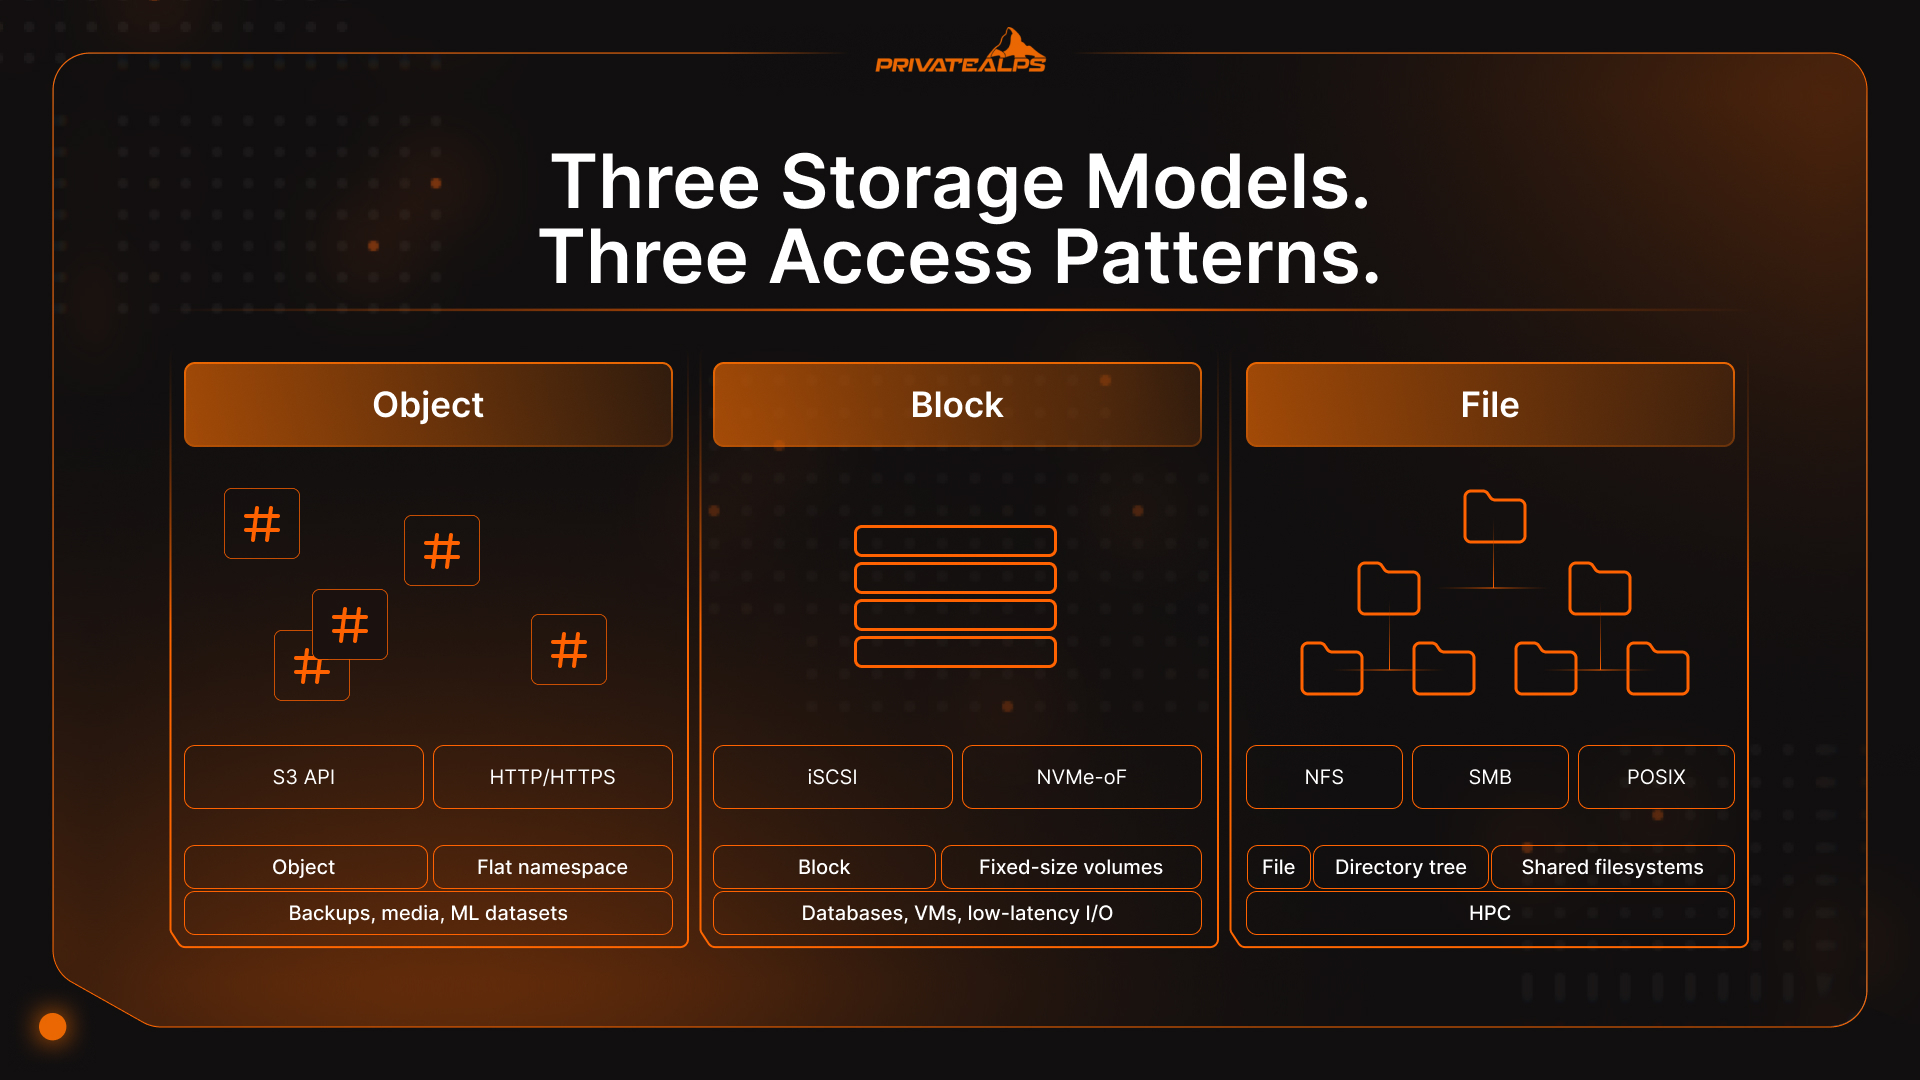
| Jenis | Cara Data Disimpan | Metode Akses | Paling Cocok Untuk | Contoh |
|---|---|---|---|---|
| Object | Namespace datar, objek kaya metadata | API kompatibel S3 (HTTP/HTTPS) | Data tidak terstruktur skala besar: backup, media, dataset ML | AWS S3, MinIO, Ceph RADOS |
| Block | Volume mentah berukuran tetap | iSCSI, NVMe-oF, FC | Database, VM, I/O acak berlatensi rendah | Ceph RBD, AWS EBS, Lightbits |
| File | Pohon direktori hierarkis | NFS, SMB, POSIX | Filesystem bersama, HPC, direktori home | GlusterFS, HDFS, Azure Files |
Distributed Object Storage
Distributed object storage menyusun data sebagai objek individual yang tidak dapat diubah dan berada dalam namespace datar. Tidak ada direktori, tidak ada path file, dan tidak ada hierarki yang perlu dikelola. Setiap objek mendapatkan identifier unik (hash atau UUID) beserta metadata yang kaya, dan Anda mengaksesnya melalui API kompatibel S3 lewat HTTP. Karena objek diganti, bukan diperbarui sebagian, masalah locking yang membatasi performa dan skalabilitas pada sistem block dan file menjadi hilang. Begitulah cara AWS S3, Azure Blob, dan Ceph mencapai skala exabyte: tidak ada overhead koordinasi namespace, tidak ada lock contention, dan node mana pun di cluster dapat melayani permintaan objek secara mandiri.
Distributed Block Storage
Block storage menyerahkan volume mentah ke server: blok berukuran tetap dengan alamat unik, tanpa abstraksi filesystem di atasnya. Aplikasi menulis langsung ke blok, dan inilah yang menghasilkan I/O acak berlatensi rendah yang konsisten untuk database, disk VM, dan beban kerja container. Satu keterbatasan arsitektur yang sering terlewat: volume block biasanya hanya dapat di-mount oleh satu server dalam satu waktu. Akses bersama dari banyak server memerlukan orkestrasi tambahan, seperti cluster filesystem yang diletakkan di atas perangkat block.
Distributed File Storage
File storage menyajikan filesystem bersama melalui protokol standar, yaitu akses NFS, SMB, dan POSIX-compatible. Banyak klien dapat me-mount volume yang sama secara bersamaan, sehingga jenis ini cocok alami untuk beban kerja kolaboratif, lingkungan HPC, dan aplikasi lama yang mengharapkan pohon direktori serta belum akan ditulis ulang dalam waktu dekat. Trade-off di dunia nyata: menjaga namespace direktori yang konsisten di banyak node menimbulkan overhead koordinasi yang semakin berat seiring skala. Sebagian besar hyperscaler pada akhirnya beralih dari distributed file storage ke distributed object storage untuk data utama, setelah volume menjadi cukup besar.
CAP Theorem: Trade-Off yang Tak Terhindarkan dalam Distributed Storage
CAP theorem menyatakan bahwa sistem data terdistribusi hanya dapat menjamin dua dari tiga hal sekaligus: Consistency (setiap pembacaan mengembalikan penulisan terbaru), Availability (setiap permintaan mendapat respons), dan Partition Tolerance (sistem tetap berjalan saat jaringan terbelah). Jaringan memang bisa terbelah, sehingga partition tolerance bukan pilihan. Keputusan sebenarnya selalu ada di antara consistency dan availability saat terjadi kegagalan.
[Eric Brewer memperkenalkan CAP pada tahun 2000; Gilbert dan Lynch merumuskan pembuktiannya pada tahun 2002][https://www.scylladb.com/glossary/cap-theorem/]. Hingga kini, teorema ini tetap menjadi keputusan yang membentuk hampir semua aspek lain dalam arsitektur distributed storage, karena ia menentukan bagaimana sistem berperilaku tepat pada saat Anda paling membutuhkannya, yaitu ketika ada sesuatu yang sudah rusak.
| Sistem | Tipe CAP | Perilaku Saat Partisi | Paling Cocok Untuk |
|---|---|---|---|
| MongoDB | CP (dengan read/write concern mayoritas) | Menolak permintaan sampai konsistensi pulih | Catatan keuangan, inventaris, pemesanan |
| HBase | CP | Mengembalikan error alih-alih data usang | Analitik terstruktur, batch job yang konsisten |
| Apache Cassandra | AP | Tetap tersedia; mungkin menyajikan pembacaan usang | Feed sosial, pesan, telemetri IoT |
| DynamoDB (default) | AP | Selalu merespons; merekonsiliasi inkonsistensi secara asinkron | Aplikasi konsumen dengan throughput tinggi |
| CockroachDB | CP | Konsistensi diutamakan, SQL terdistribusi | Beban kerja transaksional global |
Pertanyaan praktisnya: apakah beban kerja Anda bisa menoleransi pembacaan usang? Saldo bank, reservasi kursi, atau jumlah inventaris, kemungkinbesar tidak bisa. Pilih CP. Feed sosial, aliran event sensor, atau telemetri analitik masih aman jika tertinggal beberapa detik. Pilih AP dan pertahankan jaminan availability.
Keamanan Distributed Storage: Enkripsi dan Kedaulatan Data
Keamanan dalam distributed storage terdiri atas tiga lapisan yang berbeda: data at rest, data in transit, dan kepemilikan kunci. Jika salah satunya keliru, dua lainnya tidak akan menyelamatkan Anda. Infrastruktur bisa tetap tersedia sepenuhnya, sementara data sensitif diam-diam dapat diakses oleh pihak yang tidak berhak.
Enkripsi harus mencakup ketiga lapisan tersebut. Data at rest umumnya menggunakan AES-256, baik melalui kunci yang dikelola penyedia maupun customer-managed keys (CMK). Kunci yang dikelola penyedia lebih sederhana dari sisi operasional, tetapi vendor penyimpanan memegang materi kunci. Hal ini menjadi pertimbangan keamanan yang kritis bagi industri yang diatur regulasi dan menjalani audit. Client-side encryption menghilangkan paparan tersebut sepenuhnya. Data dienkripsi sebelum meninggalkan klien, sehingga penyedia tidak pernah menyentuh data dalam bentuk teks biasa, apa pun permintaan hukum yang masuk. Untuk data in transit, TLS 1.3 merupakan standar keamanan minimum. Sistem yang masih mengizinkan TLS 1.2 memerlukan pengecualian terdokumentasi menurut sebagian besar kerangka kepatuhan saat ini.
Kedaulatan data sering membuat tim terkejut. Data tunduk pada hukum tempat data itu secara fisik berada, bukan pada negara perusahaan atau lokasi pengguna. Swiss memiliki status kecukupan berdasarkan Pasal 45 GDPR, sehingga transfer data dari Uni Eropa ke Swiss dapat berjalan tanpa perlindungan kontraktual tambahan. Undang-Undang Perlindungan Data Federal (nFADP) yang telah direvisi menyelaraskan aturan domestik Swiss dengan GDPR. Artinya, infrastruktur di Swiss memberikan cakupan regulasi yang konsisten di kedua kerangka sekaligus.
Satu hal yang mudah ditunda, tetapi sebaiknya tidak: algoritma kriptografi yang melindungi sebagian besar infrastruktur penyimpanan saat ini tidak dirancang untuk bertahan menghadapi komputer kuantum yang mumpuni. NIST menetapkan tiga standar kriptografi pasca-kuantum pada Agustus 2024, termasuk FIPS 203 (ML-KEM). Jika distributed data storage Anda menyimpan catatan dengan masa retensi panjang, seperti arsip medis, catatan keuangan, dan dokumen hukum, model ancaman "kumpulkan sekarang, dekripsi nanti" sudah aktif. Evaluasi sebaiknya dimulai jauh sebelum arsip tersebut mencapai titik kritisnya.
Keunggulan Utama Distributed Storage
- Toleransi kesalahan tanpa gangguan layanan: Kegagalan node memicu deteksi heartbeat dan pengalihan otomatis ke replika yang masih berjalan, tanpa intervensi manual dan tanpa perlu jendela pemeliharaan.
- Skalabilitas horizontal: Kapasitas penyimpanan baru didapat dengan menambahkan node ke klaster. Data diseimbangkan ulang di latar belakang tanpa mengganggu lalu lintas aktif atau memerlukan downtime.
- Distribusi geografis: Replikasi lintas wilayah mengurangi latensi bagi pengguna yang tersebar secara geografis dan menjadikan kepatuhan residensi data sebagai keputusan konfigurasi, bukan proyek infrastruktur.
- Throughput I/O paralel: Banyak node menangani operasi baca dan tulis secara bersamaan. Ini menjadikannya satu-satunya arsitektur yang dapat diskalakan untuk pipeline pelatihan AI/ML, transcoding video, atau streaming media pada volume produksi nyata.
- Tanpa vendor lock-in dengan protokol terbuka: API yang kompatibel dengan S3, NFS, dan platform open-source seperti Ceph memungkinkan tim berpindah antarpenyedia atau menjalankan infrastruktur on-premises tanpa menulis ulang kode aplikasi.
- Efisiensi biaya dalam skala besar: Perangkat keras komoditas menggantikan array penyimpanan proprietary yang mahal. Erasure coding selanjutnya memangkas kebutuhan kapasitas mentah hingga 50% dibandingkan replikasi penuh antarnode.
Keterbatasan dan Tantangan Distributed Storage
- Kompleksitas konsistensi: Menjaga state yang konsisten di seluruh node memerlukan penyetelan model konsistensi, faktor replikasi, dan pengaturan quorum yang cermat. Konfigurasi yang keliru tidak memberi tanda dengan keras; ia diam-diam membuat data menyimpang.
- Beban operasional: Menjalankan klaster distributed storage berarti mengelola perencanaan failure domain, prosedur penggantian node, pipeline monitoring, dan penyetelan performa. Satu server saja tidak menuntut semua itu dari Anda.
- Ketergantungan pada jaringan: Seluruh arsitektur mengasumsikan konektivitas antarnode yang andal dan berbandwidth tinggi. Degradasi jaringan langsung dan proporsional berujung pada penurunan latensi dan throughput penyimpanan.
- Latensi untuk I/O acak berukuran kecil: Distributed storage dioptimalkan untuk pembacaan sekuensial berukuran besar dan throughput paralel. Beban kerja dengan pola I/O acak berukuran kecil yang intensif, terutama database OLTP, sering berperforma lebih baik pada block storage NVMe yang terpasang secara lokal.
- Skala minimum yang layak: Keunggulan biaya dan kompleksitas distributed storage tidak terlihat pada klaster dua node. Di bawah ambang tertentu, layanan cloud storage terkelola atau satu server yang disetel dengan baik jauh lebih murah dan lebih mudah dioperasikan.
Kasus Penggunaan Nyata Distributed Storage
- Media dan Streaming Netflix dan YouTube tidak menyajikan video dari satu lokasi pusat. Mereka mendistribusikan konten terenkode ke klaster object storage yang ditempatkan dekat dengan penonton secara geografis. Satu data center tidak sanggup menangani aliran global simultan dalam skala besar, dan biaya bandwidth saja akan terlalu mahal. Distributed data storage itulah yang membuat ekonomi streaming benar-benar berjalan.
- Kesehatan Satu studi MRI menghasilkan 500 MB hingga 1 GB data citra. Kalikan angka itu di jaringan rumah sakit besar, dengan berbagai modalitas, kebutuhan retensi panjang, dan banyak lokasi, dan Anda akan menghadapi petabyte yang menumpuk dengan cepat. Distributed storage yang dapat diskalakan dengan redundansi geografis adalah cara sistem kesehatan menjaga akses sesuai HIPAA ke rekam pasien, bahkan ketika data center regional gagal.
- AI dan Machine Learning Melatih model bahasa besar berarti memasok klaster GPU dengan data dari terabyte hingga petabyte, yang diakses dalam pola non-sekuensial yang akan langsung membebani sistem penyimpanan tradisional. Ceph, HDFS, dan object store yang kompatibel dengan S3 telah menjadi lapisan infrastruktur standar untuk pipeline ML karena throughput baca paralelnya benar-benar sejalan dengan kebutuhan klaster GPU.
- Backup dan Pemulihan Bencana Pemulihan bencana yang sesungguhnya berarti data ada di setidaknya dua lokasi yang terpisah secara geografis dengan failure domain yang independen, bukan dua rak di gedung yang sama. Kebijakan replikasi dan aturan penempatan yang dibangun langsung di lapisan distributed storage menentukan RPO dan RTO di tingkat infrastruktur, tanpa memerlukan tumpukan perangkat lunak backup terpisah. Komponen yang lebih sedikit juga berarti permukaan serangan yang lebih kecil.
Distributed Storage vs. Decentralized Storage: Apa Perbedaannya?
Distributed storage berarti data tersebar di banyak node, tetapi satu organisasi tetap memiliki dan mengendalikan seluruhnya: kebijakan, hak akses, kemampuan penghapusan, dan log audit. Decentralized storage sepenuhnya menghapus otoritas pusat tersebut. Data tersebar di antara peer independen, dan tidak ada satu operator pun yang dapat secara sepihak menyensor, mengakses, atau menghapusnya.
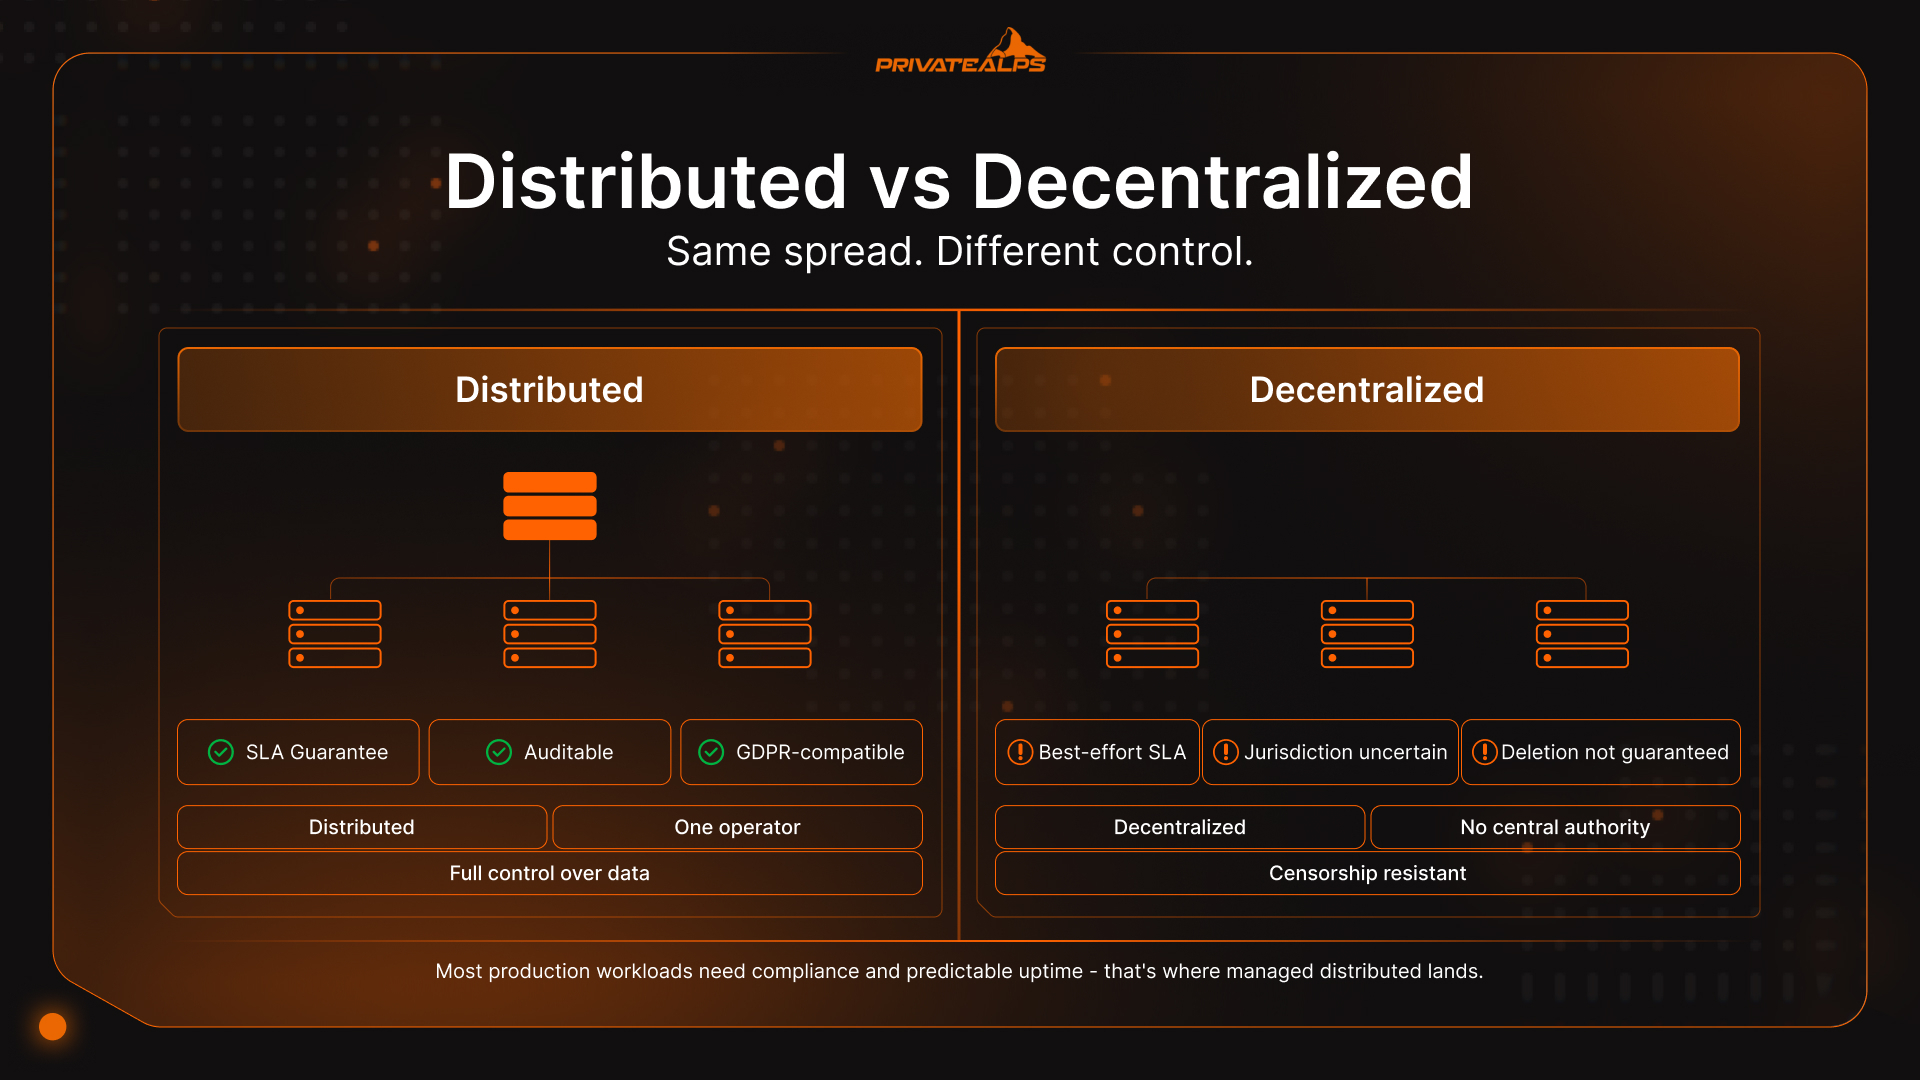
Perbedaan ini punya konsekuensi operasional yang nyata. Sistem yang dikelola secara terpusat dapat diaudit, di-patch, didukung SLA, dan dibawa ke dalam kepatuhan regulasi. Sistem terdesentralisasi menukar semua itu dengan ketahanan terhadap sensor dan operasi tanpa kepercayaan (trustless). Nilai ini berharga dalam konteks tertentu, tetapi bukan yang paling dibutuhkan kebanyakan bisnis yang menjalankan infrastruktur penyimpanan produksi.
| Dimensi | Distributed Storage | Decentralized Storage |
|---|---|---|
| Kontrol | Dikelola secara terpusat | Tanpa otoritas pusat |
| SLA / jaminan uptime | Jaminan kontraktual dimungkinkan | Best-effort, bergantung protokol |
| Kepatuhan | Dapat diaudit, kompatibel GDPR | Yurisdiksi tidak pasti |
| Penghapusan data | Terjamin | Tidak selalu memungkinkan |
| Kontrol akses | Berbasis peran, dikelola | Kriptografis, trustless |
| Contoh | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Satu lapisan lagi perlu dipisahkan: cloud storage multi-region, seperti AWS S3 dengan cross-region replication atau Azure geo-redundant storage, tetap merupakan infrastruktur yang dikelola secara terpusat. Penyedia mengelola node dan replikasi, sehingga Anda pada dasarnya menyewa geografi. Platform cloud terdistribusi sejati seperti Storj atau Cubbit merutekan data ke berbagai operator independen. Hal ini menghilangkan vendor lock-in, tetapi membuka kembali pertanyaan seputar SLA dan jejak audit. Untuk sebagian besar beban kerja yang membutuhkan dokumentasi kepatuhan dan uptime yang dapat diprediksi, pendekatan distributed yang terkelola adalah pilihan yang paling masuk akal.
Ringkasan
Distributed storage bukanlah sebuah produk, melainkan kategori arsitektur, dan jenis yang tepat bergantung sepenuhnya pada apa yang Anda jalankan. Object, block, dan file storage masing-masing memiliki model data yang dibangun untuk pola akses dan bentuk beban kerja yang berbeda. CAP theorem memaksa adanya trade-off nyata antara konsistensi dan ketersediaan begitu kegagalan jaringan terjadi. Keputusan yang keliru dalam hal ini bisa mahal. Untuk urusan replikasi versus erasure coding, temperatur data yang menentukan: data yang sering diakses membutuhkan replikasi demi latensi, sedangkan data dingin diuntungkan oleh efisiensi penyimpanan erasure coding. Bagi sebagian besar tim, solusi distributed yang terkelola, baik dari penyedia privat maupun public cloud, selama residensi data dan kontrol keamanannya dapat diverifikasi, memberikan keseimbangan yang lebih baik antara skalabilitas, performa, dan kemudahan operasional harian dibandingkan klaster yang dikelola sendiri.
Simpan Data Anda di Swiss bersama PrivateAlps
Jika beban kerja Anda membutuhkan distributed object storage yang kompatibel dengan S3 dan residensi data yang dapat diverifikasi, PrivateAlps menjalankan infrastruktur berbasis Swiss yang sepenuhnya mematuhi Pasal 45 GDPR dan nFADP. Data Anda tetap berada di Swiss, tanpa pembagian ke pihak ketiga, tanpa perutean yang tidak jelas melalui yurisdiksi asing, dan tanpa kejutan. Baik Anda sedang beralih dari hyperscaler maupun membangun arsitektur distributed storage yang mengutamakan privasi dari awal, PrivateAlps memberikan performa dan kepastian kepatuhan yang dibutuhkan beban kerja Anda.
FAQ
Apa Perbedaan antara Distributed Storage dan Cloud Storage?
Cloud storage adalah model layanan: pihak lain mengelola infrastrukturnya, dan Anda mengaksesnya melalui internet dengan sistem bayar sesuai pemakaian. Distributed storage adalah arsitektur: data tersebar di berbagai node untuk redundansi dan skalabilitas. Keduanya merupakan konsep yang independen. Anda dapat menjalankan distributed storage sepenuhnya di on-premises dengan Ceph atau MinIO, dan penyedia cloud secara teknis juga bisa menyajikan centralized storage di balik API. Sebagian besar layanan cloud storage memang menggunakan arsitektur terdistribusi secara internal, tetapi itu adalah detail implementasi, bukan definisi dari cloud storage.
Apa Sistem Distributed Storage Terbaik?
Tidak ada jawaban universal. Semuanya bergantung pada beban kerja dan model datanya. Untuk data tidak terstruktur dan backup, object store yang kompatibel dengan S3 seperti MinIO atau Ceph RADOS adalah pilihan standar. Untuk volume database dan disk VM yang membutuhkan block I/O konsisten dengan latensi rendah, Ceph RBD atau Lightbits lebih cocok. Untuk shared filesystem di lingkungan HPC atau sistem lama, GlusterFS atau HDFS biasanya menjadi pilihan tim. Mulailah dari pola akses, lalu sistem penyimpanan akan mengikuti dari sana.
Apakah Distributed Storage Sama dengan RAID?
Tidak. RAID bekerja di dalam satu server atau array penyimpanan dan melindungi dari kegagalan disk di dalam satu mesin. Distributed storage bekerja di seluruh node fisik terpisah yang terhubung melalui jaringan, yang berpotensi membentang di beberapa gedung atau seluruh data center. RAID tidak membantu ketika server itu sendiri gagal. Sistem distributed storage dirancang khusus untuk menoleransi kegagalan node, kegagalan rak, dan gangguan total data center. Perbedaan cakupan ini bersifat mendasar.
Bagaimana Distributed Storage Menangani Kegagalan Node?
Node secara berkala mengirim sinyal heartbeat ke lapisan metadata klaster. Ketika sebuah node berhenti merespons, sistem mendeteksi kegagalan tersebut, biasanya dalam hitungan detik, dan mengalihkan permintaan ke node yang menyimpan replika atau fragmen erasure-coded. Pada pengaturan berbasis replikasi, proses pemulihan di latar belakang kemudian membuat salinan baru untuk mengembalikan faktor replikasi yang telah dikonfigurasi di seluruh klaster. Seluruh proses ini berjalan otomatis. Pada klaster distributed storage yang dikonfigurasi dengan baik, aplikasi bahkan tidak pernah merasakan kegagalannya.
Apakah Distributed Storage Cocok untuk Bisnis Kecil?\\
Layanan distributed storage terkelola, seperti object storage yang kompatibel dengan S3 dari penyedia cloud atau penyedia khusus seperti PrivateAlps, dapat digunakan pada skala berapa pun tanpa persyaratan minimum klaster. Klaster distributed storage yang dikelola sendiri adalah cerita yang berbeda. Menjalankan Ceph secara produktif biasanya memerlukan minimal tiga hingga lima node sebelum beban operasionalnya terasa sepadan. Untuk tim kecil, layanan terkelola memberikan manfaat arsitektur distributed storage secara penuh tanpa beban pengelolaan infrastruktur.
