


Cos'è lo storage distribuito?
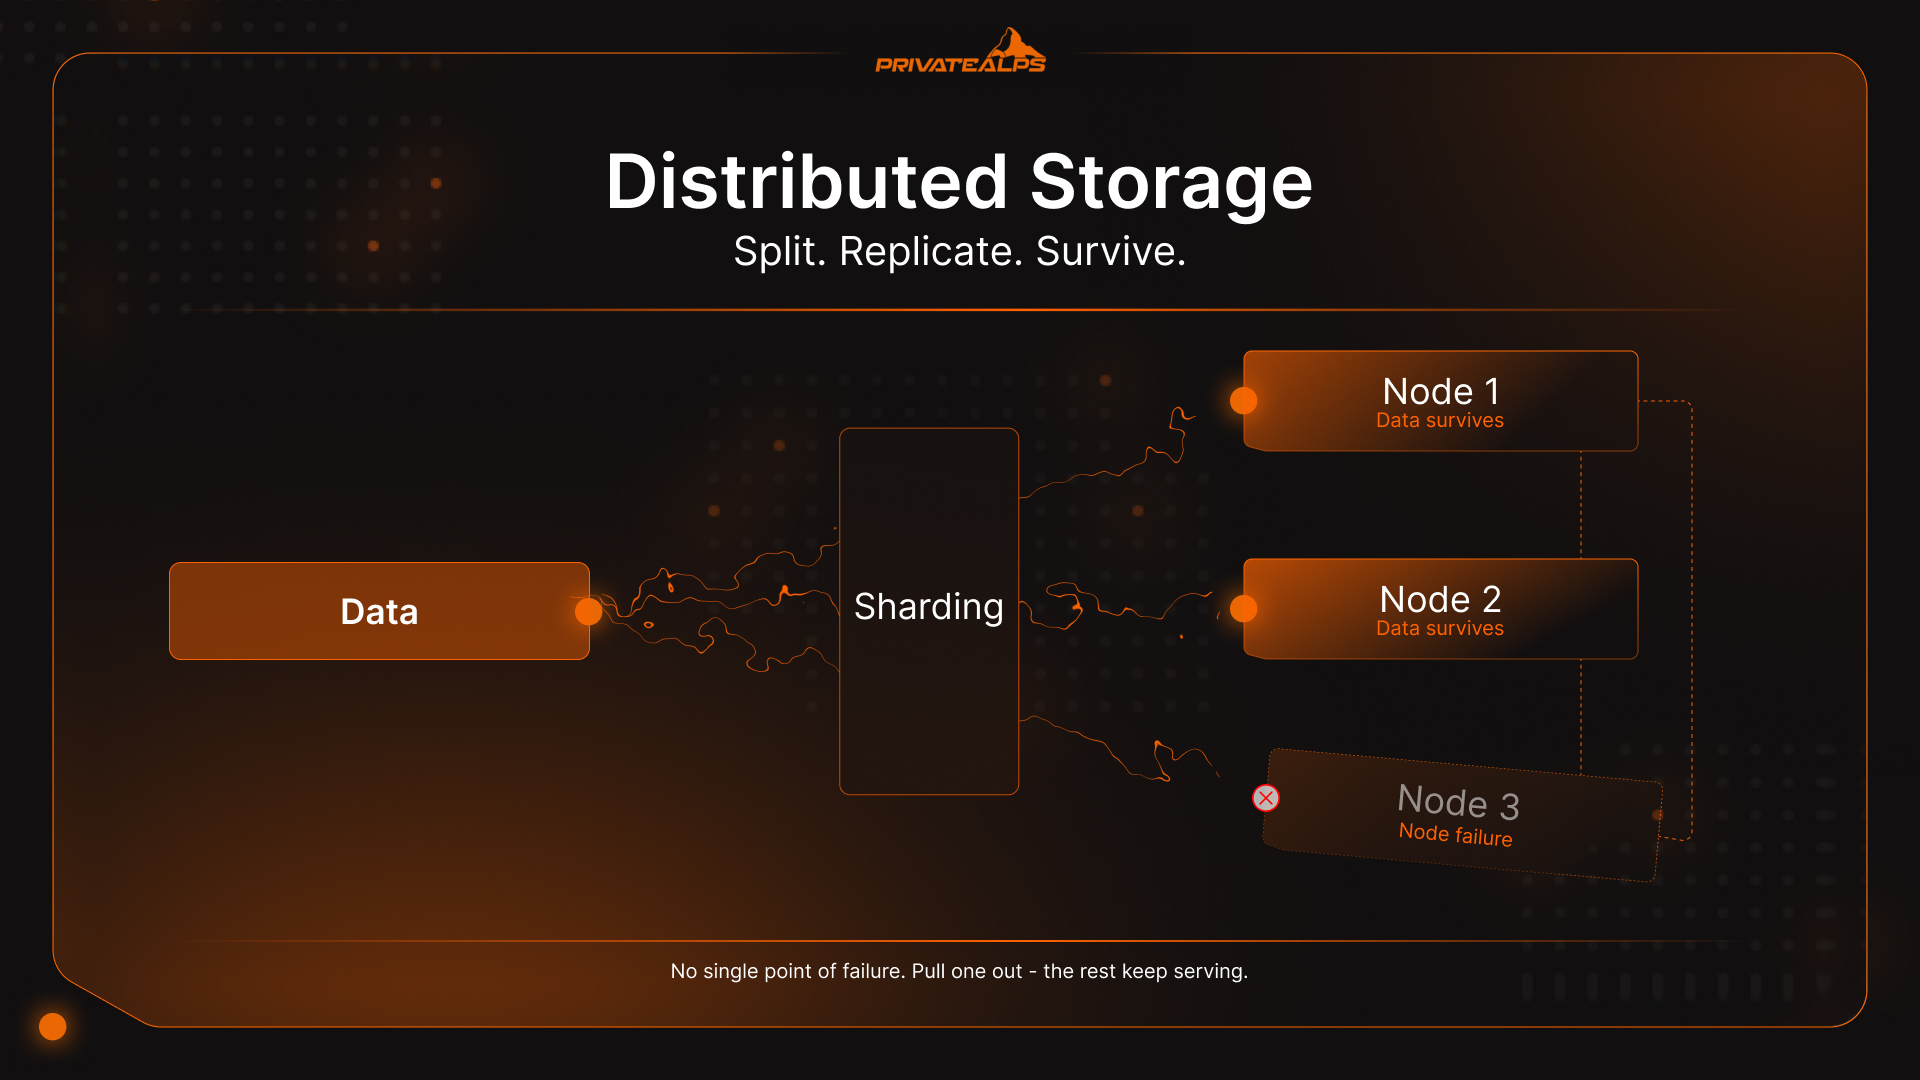
Lo storage distribuito è il modo in cui l'infrastruttura moderna gestisce dati troppo grandi, troppo critici o troppo frequentemente accessibili perché una sola macchina possa conservarli in modo affidabile. Invece di scrivere tutto su un unico server, il sistema divide, replica o codifica quei dati su più nodi indipendenti: server, dischi e data center. Lavorano insieme, ma nessun nodo contiene tutto. Se ne spegni uno, gli altri continuano a rispondere. Questa guida spiega come si comportano davvero i sistemi di storage distribuito sotto carico, quali compromessi architetturali impongono e quale tipo di storage si adatta a ciascun carico di lavoro.
Riepilogo IA
Lo storage distribuito è un'architettura definita via software che ripartisce i dati su più nodi fisici, usando tre tecniche principali: sharding (suddivisione dei dati in blocchi discreti instradati su nodi diversi), replica (mantenimento di più copie identiche sui vari nodi per un accesso rapido) ed erasure coding (codifica dei dati in frammenti con parità matematica, così che un sottoinsieme qualsiasi possa ricostruire l'intero).
Esistono tre tipi principali di sistemi di storage distribuito: object storage (namespace piatto, API compatibile con S3), block storage (volumi di dimensione fissa per I/O casuale a bassa latenza) e file storage (namespace gerarchico tramite NFS o SMB). Ogni configurazione di storage distribuito deve fare i conti con il teorema CAP: può garantire solo due tra coerenza, disponibilità e tolleranza alle partizioni, contemporaneamente.
Il vantaggio operativo principale è che il guasto di un nodo non provoca interruzioni: il sistema reindirizza automaticamente le richieste sulle repliche ancora attive. La posta in gioco è enorme: l'umanità genera ogni singolo giorno oltre 400 milioni di terabyte di nuovi dati, un volume che nessuna architettura centralizzata può assorbire senza crollare prima o poi sotto il proprio peso.
Storage distribuito vs. storage centralizzato
Lo storage centralizzato concentra tutto in un unico punto: un server, una SAN, un data center. Il modello è tutto qui. Quando quel punto ha un problema, si ferma tutto. Lo storage distribuito risolve questo limite alla radice: i dati vivono su più nodi indipendenti, quindi nessun singolo punto di guasto può mettere offline l'intero sistema o bloccare tutti gli accessi.
Basta un guasto hardware e l'accesso si blocca. Punto. Scalare significa aggiornare o sostituire il sistema principale, con tempi di inattività e una discussione sulla spesa in conto capitale che nessuno vuole affrontare. Lo storage distribuito aggira entrambi i problemi per progettazione: per crescere aggiungi un nodo e, quando un nodo si guasta, il cluster lo esclude automaticamente. Niente drammi, niente interruzioni. I dati erano già su più nodi prima che succedesse qualcosa.
| Dimensione | Storage centralizzato | Storage distribuito |
|---|---|---|
| Tolleranza ai guasti | Singolo punto di guasto | I dati sopravvivono alla perdita di un nodo |
| Scalabilità | Verticale (aggiornamento hardware) | Orizzontale (aggiunta di nodi) |
| Latenza | Bassa per accessi locali | Variabile; dipende dalla topologia di rete |
| Costo su piccola scala | Costo iniziale più basso | Cluster minimo vitale più costoso |
| Costo su larga scala | Costoso da scalare | L'hardware standard riduce i costi |
| Distribuzione geografica | Singola sede | Multi-regione tramite configurazione |
| Complessità operativa | Semplice da gestire | Richiede strumenti di orchestrazione |
Come funzionano i sistemi di storage distribuito
Un sistema di storage distribuito prende i dati in arrivo, li spezza in blocchi, instrada questi blocchi verso i nodi giusti del cluster e tiene traccia di ogni frammento tramite un livello di metadati, in modo che qualsiasi frammento possa essere localizzato, recuperato e ricomposto su richiesta, indipendentemente dal nodo che lo ospita. È questo il meccanismo di base. Quattro meccanismi lo rendono possibile:
- Sharding (partizionamento dei dati) Quando i dati arrivano, il sistema li taglia in pezzi più piccoli (shard o blocchi) e li distribuisce sui nodi. È questo che rende possibile l'I/O parallelo: più nodi gestiscono letture e scritture contemporaneamente, quindi la produttività cresce con le dimensioni del cluster invece di fermarsi al limite di una singola macchina. La logica di instradamento si basa di solito sul consistent hashing, che mantiene uniforme la distribuzione man mano che il cluster cresce, senza dover riorganizzare tutto ogni volta che si aggiunge un nodo.
- Replica L'approccio semplice ma efficace: conservare N copie identiche di ogni shard su nodi separati, di solito tre. Se un nodo va offline, gli altri due continuano a rispondere immediatamente. Nessuna ricostruzione, nessuna attesa. La replica è la scelta giusta per i dati caldi: database attivi, flussi in tempo reale, tutto ciò in cui un millisecondo in più in lettura ti costa davvero qualcosa.
- Erasure coding È qui che i calcoli sull'efficienza dello storage diventano interessanti. Invece di tre copie complete, il sistema codifica un oggetto in $k$ frammenti di dati più $m$ frammenti di parità, distribuisce tutti i $k+m$ frammenti sui nodi e può ricostruire l'oggetto intero a partire da un qualsiasi sottoinsieme di $k$ frammenti. Quindi $m$ nodi possono guastarsi contemporaneamente senza perdere nulla. Una configurazione Reed-Solomon RS(6,3) memorizza 9 blocchi invece dei 18 richiesti dalla replica 3x, riducendo il sovraccarico di storage grezzo dal 200% a circa il 50%. Il rovescio della medaglia è che codifica e decodifica consumano cicli di CPU, e l'erasure coding funziona meglio sui dati freddi, ovvero contenuti raramente modificati o acceduti con alta frequenza. Per carichi di lavoro con scritture piccole e frequenti, la replica 3x resta la più veloce in termini di latenza.
| Metodo di protezione | Sovraccarico di storage | Ideale per | Compromesso |
|---|---|---|---|
| Replica 3x | 3x la capacità grezza | Dati caldi, carichi a bassa latenza | Costo di storage elevato su larga scala |
| Erasure coding RS(6,3) | 1,5x la capacità grezza | Dati freddi, archiviazione, oggetti di grandi dimensioni | Sovraccarico di CPU, latenza di ricostruzione più alta |
- Instradamento dei metadati Ogni sistema di storage distribuito mantiene un livello di metadati, sostanzialmente una mappa di quale shard si trova su quale nodo. Quando un client richiede dei dati, il servizio di metadati individua i nodi giusti, e il sistema recupera e ricompone i frammenti senza che il client veda mai la complessità. Nei cluster su larga scala come Ceph o HDFS, il livello di metadati è a sua volta distribuito su più nodi. Deve esserlo: un singolo server di metadati diventerebbe il collo di bottiglia da cui stavi cercando di fuggire.
Tipi di sistemi di storage distribuito
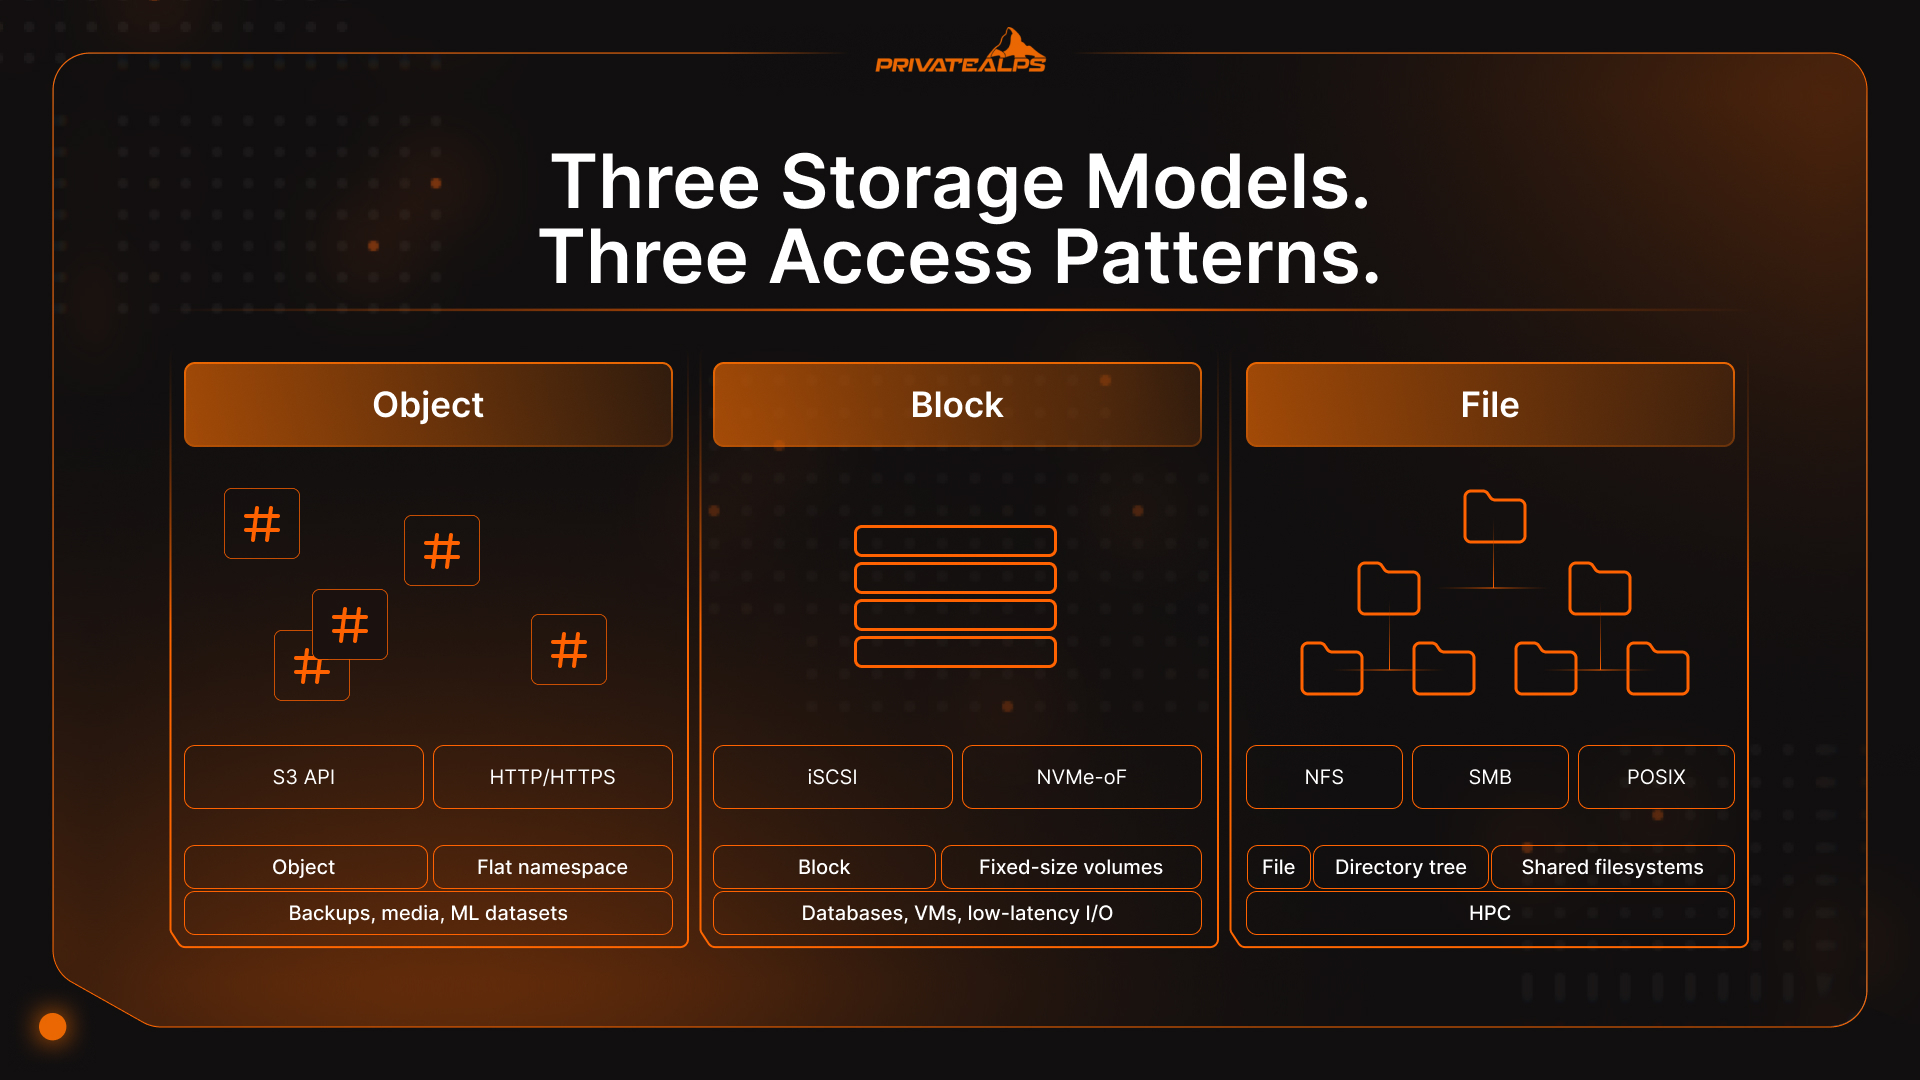
Lo storage distribuito non è una cosa sola. È una categoria con tre modelli di dati distinti, e scegliere quello sbagliato per un carico di lavoro è un errore sorprendentemente comune e costoso. Object, block e file storage risolvono ciascuno un problema diverso. I database distribuiti (Cassandra, CockroachDB, Google Spanner) rappresentano un quarto tipo, che aggiunge una semantica di query sopra la gestione distribuita dei dati, ma è un discorso a parte.
| Tipo | Come vengono memorizzati i dati | Metodo di accesso | Ideale per | Esempi |
|---|---|---|---|---|
| Object | Namespace piatto, oggetti ricchi di metadati | API compatibile con S3 (HTTP/HTTPS) | Dati non strutturati su larga scala: backup, media, dataset di ML | AWS S3, MinIO, Ceph RADOS |
| Block | Volumi grezzi di dimensione fissa | iSCSI, NVMe-oF, FC | Database, VM, I/O casuale a bassa latenza | Ceph RBD, AWS EBS, Lightbits |
| File | Albero di directory gerarchico | NFS, SMB, POSIX | Filesystem condivisi, HPC, home directory | GlusterFS, HDFS, Azure Files |
Object storage distribuito
L'object storage distribuito organizza i dati come oggetti individuali e immutabili in un namespace piatto: nessuna directory, nessun percorso di file, nessuna gerarchia da mantenere. Ogni oggetto riceve un identificatore unico (un hash o un UUID) insieme a metadati ricchi, e vi si accede tramite un'API compatibile con S3 su HTTP. Poiché gli oggetti vengono sostituiti anziché aggiornati in parte, scompare il problema del locking che nei block e nei file system limita le prestazioni e la scalabilità. È così che AWS S3, Azure Blob e Ceph arrivano a scalare fino all'exabyte: nessun sovraccarico di coordinamento del namespace, nessuna contesa sui lock e qualsiasi nodo del cluster può servire qualsiasi richiesta su un oggetto in modo indipendente.
Block storage distribuito
Il block storage consegna volumi grezzi ai server: blocchi di dimensione fissa con indirizzi univoci, senza un'astrazione di filesystem sopra. Le applicazioni scrivono direttamente sui blocchi, ed è questo che assicura un I/O casuale a bassa latenza e costante per database, dischi delle VM e carichi containerizzati. Una limitazione architetturale che sorprende molti: un volume a blocchi di solito può essere montato da un solo server alla volta. Per l'accesso condiviso tra più server servono orchestrazione aggiuntiva, come un filesystem di cluster stratificato sopra i dispositivi a blocchi.
File storage distribuito
Il file storage presenta un filesystem condiviso tramite protocolli standard: NFS, SMB, accesso compatibile con POSIX. Più client possono montare lo stesso volume contemporaneamente, il che lo rende la scelta naturale per carichi di lavoro collaborativi, ambienti HPC e applicazioni legacy che si aspettano un albero di directory e non verranno riscritte a breve. Il compromesso reale: mantenere un namespace di directory coerente tra nodi distribuiti crea un sovraccarico di coordinamento che cresce con la scala. La maggior parte degli hyperscaler, alla fine, migra dal file storage distribuito all'object storage distribuito per i dati primari, una volta che i volumi diventano abbastanza grandi.
Il teorema CAP: il compromesso inevitabile nello storage distribuito
Il teorema CAP afferma che un sistema di dati distribuito può garantire solo due di tre cose alla volta: Coerenza (ogni lettura restituisce l'ultima scrittura), Disponibilità (ogni richiesta riceve una risposta) e Tolleranza alle partizioni (il sistema continua a funzionare nonostante le divisioni di rete). Le reti si dividono: la tolleranza alle partizioni non è facoltativa. La vera decisione riguarda sempre la scelta tra coerenza e disponibilità quando si verifica un guasto.
[Eric Brewer ha introdotto il CAP nel 2000; Gilbert e Lynch ne hanno formalizzato la dimostrazione nel 2002][https://www.scylladb.com/glossary/cap-theorem/]. È ancora la decisione che plasma tutto il resto nell'architettura dello storage distribuito, perché determina come si comporta il sistema proprio nel momento in cui ne hai più bisogno: quando qualcosa è già rotto.
| Sistema | Tipo CAP | Comportamento durante una partizione | Ideale per |
|---|---|---|---|
| MongoDB | CP (con read/write concern di maggioranza) | Rifiuta le richieste finché la coerenza non è ripristinata | Registri finanziari, inventario, prenotazioni |
| HBase | CP | Restituisce errori anziché dati obsoleti | Analisi strutturate, batch con coerenza garantita |
| Apache Cassandra | AP | Resta disponibile; può servire letture obsolete | Feed social, messaggistica, telemetria IoT |
| DynamoDB (default) | AP | Risponde sempre; riconcilia le incoerenze in modo asincrono | App consumer ad alto throughput |
| CockroachDB | CP | Prima la coerenza, SQL distribuito | Carichi transazionali globali |
La regola pratica: il tuo carico di lavoro può tollerare una lettura obsoleta? Un saldo bancario, una prenotazione di posti, un conteggio di inventario: probabilmente no. Scegli CP. Un feed social, un flusso di eventi da sensori, la telemetria per l'analisi: qualche secondo di ritardo va bene. Scegli AP e mantieni la garanzia di disponibilità.
Sicurezza dello storage distribuito: crittografia e sovranità dei dati
La sicurezza nello storage distribuito si articola su tre livelli distinti: dati a riposo, dati in transito e proprietà delle chiavi. Se ne sbagli uno, gli altri non ti salvano. L'infrastruttura può funzionare perfettamente mentre i dati sensibili sono accessibili, senza che tu se ne accorga, alle persone sbagliate.
La crittografia deve coprire tutti e tre i livelli. I dati a riposo usano in genere AES-256, con chiavi gestite dal provider oppure chiavi gestite dal cliente (CMK). Quelle gestite dal provider sono più semplici da amministrare, ma il fornitore dello storage custodisce il materiale delle chiavi, un aspetto di sicurezza critico per i settori regolamentati che sono sottoposti a audit. La crittografia lato client elimina completamente questo rischio: i dati vengono cifrati prima di lasciare il client, quindi il provider non vede mai il testo in chiaro, qualunque richiesta legale gli arrivi. Per i dati in transito, TLS 1.3 è il minimo di sicurezza accettabile; qualsiasi sistema che consenta ancora TLS 1.2 richiede un'eccezione documentata secondo la maggior parte dei framework di conformità attuali.
La sovranità dei dati è spesso un punto che coglie i team di sorpresa. I dati sono soggetti alle leggi del luogo in cui si trovano fisicamente, non del Paese dell'azienda né della posizione dell'utente. La Svizzera ha lo status di adeguatezza ai sensi dell'articolo 45 del GDPR, quindi i trasferimenti di dati dall'UE verso la Svizzera avvengono senza ulteriori garanzie contrattuali. La nuova Legge federale sulla protezione dei dati (nLPD) allinea le norme svizzere al GDPR, il che significa che un'infrastruttura svizzera offre una copertura normativa coerente con entrambi i framework contemporaneamente.
C'è un aspetto che è facile rimandare, ma non dovresti: gli algoritmi crittografici che oggi proteggono gran parte dell'infrastruttura di storage non sono stati progettati per resistere a un computer quantistico capace. Il NIST ha finalizzato tre standard per la crittografia post-quantistica nell'agosto 2024, tra cui FIPS 203 (ML-KEM). Se il tuo storage distribuito conserva dati con un lungo periodo di conservazione, come archivi medici, registri finanziari o documenti legali, la minaccia « raccogli ora, decifra dopo » è già attiva. Le valutazioni dovrebbero iniziare ben prima che quegli archivi raggiungano la maturità.
Vantaggi principali dello storage distribuito
- Tolleranza ai guasti senza interruzioni del servizio: il guasto di un nodo attiva il rilevamento tramite heartbeat e il reindirizzamento automatico verso le repliche ancora attive, senza intervento manuale e senza finestre di manutenzione.
- Scalabilità orizzontale: la nuova capacità di storage si ottiene aggiungendo nodi al cluster; i dati si ribilanciano in background senza toccare il traffico in produzione né richiedere downtime.
- Distribuzione geografica: la replica tra regioni riduce la latenza per utenti dispersi sul territorio e trasforma la conformità sulla residenza dei dati in una decisione di configurazione, anziché in un progetto infrastrutturale.
- Throughput I/O parallelo: più nodi gestiscono letture e scritture simultaneamente, ed è l'unica architettura scalabile per pipeline di addestramento AI/ML, transcodifica video o streaming multimediale con volumi di produzione reali.
- Nessun vendor lock-in grazie a protocolli aperti: API compatibili con S3, NFS e piattaforme open source come Ceph permettono ai team di migrare tra provider o di far girare l'infrastruttura in locale senza riscrivere il codice applicativo.
- Efficienza dei costi su larga scala: hardware standard sostituisce i costosi array di storage proprietari; l'erasure coding riduce ulteriormente la capacità grezza necessaria, fino al 50% in meno rispetto alla replica completa tra nodi.
Limiti e sfide dello storage distribuito
- Complessità di coerenza: mantenere uno stato coerente tra i nodi richiede una taratura accurata dei modelli di coerenza, dei fattori di replica e delle impostazioni di quorum. Una configurazione errata non si fa notare subito: fa semplicemente divergere i dati, poco a poco.
- Carico operativo: gestire un cluster di storage distribuito significa occuparsi della pianificazione dei domini di guasto, delle procedure di sostituzione dei nodi, delle pipeline di monitoraggio e dell'ottimizzazione delle prestazioni. Un singolo server non ti chiede tutto questo.
- Dipendenza dalla rete: l'intera architettura presuppone una connettività affidabile e ad alta banda tra i nodi. Un degrado della rete si traduce direttamente e in modo proporzionale in più latenza e in una perdita di throughput.
- Latenza per I/O casuali di piccole dimensioni: lo storage distribuito è ottimizzato per letture sequenziali di grandi dimensioni e per il throughput parallelo. I carichi di lavoro con molti I/O casuali di piccole dimensioni, soprattutto i database OLTP, spesso funzionano meglio su storage a blocchi NVMe collegato localmente.
- Scala minima praticabile: i vantaggi in termini di costi e complessità dello storage distribuito non emergono su un cluster a due nodi. Sotto una certa soglia, un servizio di storage cloud gestito o un singolo server ben configurato costano meno e sono più semplici da gestire.
Casi d'uso reali dello storage distribuito
- Media e streaming: Netflix e YouTube non servono i video da una sede centrale, ma distribuiscono i contenuti codificati su cluster di object storage posizionati geograficamente vicino agli spettatori. Un singolo data center non potrebbe gestire flussi globali simultanei su larga scala; i soli costi di banda sarebbero proibitivi. È lo storage distribuito a rendere sostenibile l'economia dello streaming.
- Sanità: un singolo esame di risonanza magnetica genera da 500 MB a 1 GB di dati di imaging. Moltiplica questo valore per una grande rete ospedaliera, con modalità diverse, lunghi periodi di conservazione e più sedi, e ti ritroverai con petabyte che si accumulano in fretta. Lo storage distribuito scalabile con ridondanza geografica è il modo in cui i sistemi sanitari mantengono un accesso conforme alla HIPAA alle cartelle dei pazienti anche quando un data center regionale va in guasto.
- AI e machine learning: addestrare un grande modello linguistico significa alimentare cluster GPU con dati da terabyte a petabyte, letti con schemi non sequenziali che saturerebbero quasi subito un sistema di storage tradizionale. Ceph, HDFS e i object store compatibili con S3 sono diventati il livello infrastrutturale standard per le pipeline ML, perché il loro throughput di lettura parallela corrisponde davvero a ciò che consumano i cluster GPU.
- Backup e disaster recovery: un vero disaster recovery significa che i dati esistono in almeno due sedi geograficamente separate, con domini di guasto indipendenti, e non in due rack dello stesso edificio. Le policy di replica e le regole di posizionamento integrate direttamente nel livello di storage distribuito definiscono RPO e RTO a livello infrastrutturale, senza richiedere uno stack software di backup separato. Meno componenti in movimento significano anche una superficie d'attacco più ridotta.
Storage distribuito vs. storage decentralizzato: qual è la differenza?
Lo storage distribuito significa che i dati sono suddivisi su molti nodi, ma un'unica organizzazione possiede e controlla tutto: policy, diritti di accesso, possibilità di cancellazione, log di audit. Lo storage decentralizzato elimina del tutto questa autorità centrale. I dati vivono su peer indipendenti e nessun singolo operatore può censurarli, accedervi o eliminarli unilateralmente.
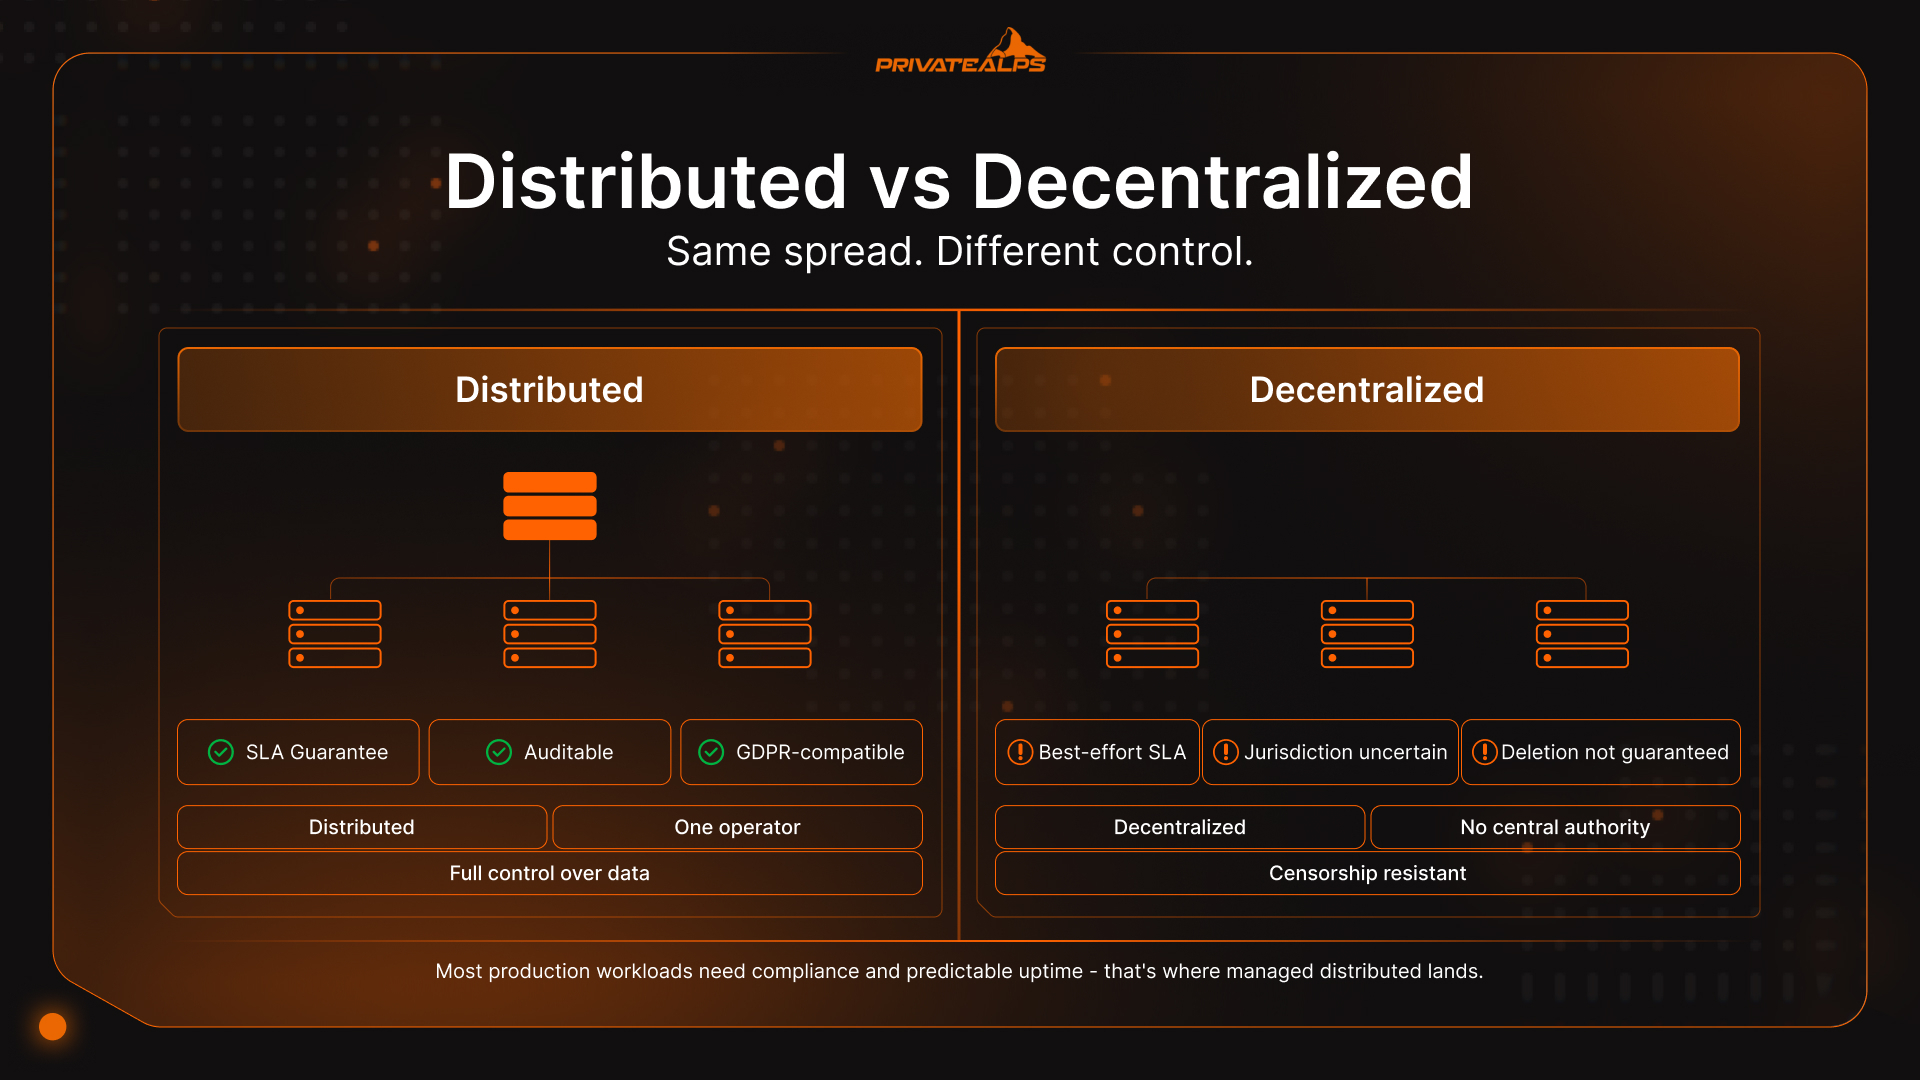
Questa distinzione ha conseguenze operative concrete. Un sistema distribuito gestito centralmente può essere sottoposto ad audit, aggiornato, coperto da SLA e portato in conformità normativa. Un sistema decentralizzato sacrifica tutto ciò in cambio di resistenza alla censura e di un funzionamento senza fiducia (trustless): un valore prezioso in contesti specifici, ma non ciò di cui la maggior parte delle aziende che gestiscono infrastrutture di storage in produzione ha realmente bisogno.
| Dimensione | Storage distribuito | Storage decentralizzato |
|---|---|---|
| Controllo | Amministrato centralmente | Nessuna autorità centrale |
| SLA / garanzie di uptime | Garanzie contrattuali possibili | Best-effort, dipende dal protocollo |
| Conformità | Verificabile, compatibile con GDPR | Giurisdizione incerta |
| Cancellazione dei dati | Garantita | Non sempre possibile |
| Controllo degli accessi | Basato sui ruoli, gestito | Crittografico, trustless |
| Esempi | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
Un ulteriore livello da distinguere: lo storage cloud multi-regione, come AWS S3 con replica tra regioni o lo storage geo-ridondante di Azure, resta infrastruttura amministrata centralmente. Il provider gestisce nodi e replica; di fatto stai affittando la geografia. Le vere piattaforme cloud distribuite, come Storj o Cubbit, instradano i dati tra operatori indipendenti, eliminando il lock-in verso un singolo provider ma riaprendo questioni legate agli SLA e alle tracce di audit. Per la maggior parte dei carichi di lavoro che richiedono documentazione di conformità e uptime prevedibile, l'approccio distribuito gestito è la scelta giusta.
Riepilogo
Lo storage distribuito non è un prodotto, ma una categoria architetturale, e la variante giusta dipende interamente da ciò che fai girare. Object storage, block storage e file storage hanno ciascuno un modello dei dati pensato per schemi di accesso e tipi di carico di lavoro diversi. Il teorema CAP impone un vero compromesso tra coerenza e disponibilità nel momento in cui si verificano guasti di rete; sbagliare questa scelta può costare caro. Quando si tratta di replica contro erasure coding, decide la « temperatura » dei dati: i dati caldi richiedono la replica per la latenza, mentre i dati freddi traggono vantaggio dall'efficienza di storage dell'erasure coding. Per la maggior parte dei team, una soluzione di storage distribuito gestita, di un provider privato o di un cloud pubblico, purché la residenza dei dati e i controlli di sicurezza siano verificabili, offre un equilibrio migliore tra scalabilità, prestazioni e semplicità operativa quotidiana rispetto a un cluster self-hosted.
Archivia i tuoi dati in Svizzera con PrivateAlps
Se il tuo carico di lavoro richiede object storage distribuito compatibile con S3 e una residenza dei dati verificabile, PrivateAlps gestisce un'infrastruttura con sede in Svizzera, pienamente conforme sia all'articolo 45 del GDPR sia alla nLPD. I tuoi dati restano in Svizzera: niente condivisione con terzi, niente instradamenti ambigui attraverso giurisdizioni straniere, niente sorprese. Che tu stia migrando da un hyperscaler o costruendo da zero un'architettura di storage distribuito orientata alla privacy, PrivateAlps offre le prestazioni e la certezza di conformità di cui il tuo carico di lavoro ha realmente bisogno.
FAQ
Qual è la differenza tra storage distribuito e storage cloud?
Lo storage cloud è un modello di erogazione: qualcun altro gestisce l'infrastruttura e tu vi accedi via internet con un modello pay-per-use. Lo storage distribuito è un'architettura: i dati sono suddivisi su più nodi per garantire ridondanza e scalabilità. Sono concetti indipendenti. Puoi far girare lo storage distribuito interamente in locale con Ceph o MinIO, e un provider cloud può tecnicamente offrire storage centralizzato dietro un'API. La maggior parte dei servizi di storage cloud usa internamente architetture distribuite, ma si tratta di un dettaglio implementativo, non della definizione di storage cloud.
Qual è il miglior sistema di storage distribuito?
Non esiste una risposta universale: dipende dal carico di lavoro e dal modello dei dati. Per i dati non strutturati e i backup, gli object store compatibili con S3, come MinIO o Ceph RADOS, sono la scelta standard. Per i volumi dei database e i dischi delle VM che richiedono I/O a blocchi coerente e a bassa latenza, Ceph RBD o Lightbits sono più adatti. Per i filesystem condivisi in ambienti HPC o legacy, la scelta tipica dei team è GlusterFS o HDFS. Parti dallo schema di accesso: il sistema di storage ne deriva di conseguenza.
Lo storage distribuito è la stessa cosa del RAID?
No. Il RAID opera all'interno di un singolo server o di un singolo array di storage e protegge dal guasto di un disco all'interno di una macchina. Lo storage distribuito opera su nodi fisici separati collegati in rete, che possono estendersi su più edifici o interi data center. Il RAID non ti aiuta quando si guasta il server stesso. I sistemi di storage distribuito sono progettati specificamente per tollerare guasti di nodi, di rack e interruzioni complete di un data center. La differenza di portata è fondamentale.
Come gestisce lo storage distribuito i guasti dei nodi?
I nodi inviano segnali heartbeat regolari al livello di metadati del cluster. Quando un nodo smette di rispondere, il sistema rileva il guasto, di solito in pochi secondi, e reindirizza le richieste verso i nodi che contengono le repliche o i frammenti in erasure coding. Nelle configurazioni basate sulla replica, un processo di ripristino in background crea poi nuove copie per ristabilire il fattore di replica configurato in tutto il cluster. L'intero meccanismo è automatico: in un cluster di storage distribuito ben configurato, le applicazioni non si accorgono affatto del guasto.
Lo storage distribuito è adatto alle piccole imprese?
I servizi di storage distribuito gestiti, come l'object storage compatibile con S3 di un provider cloud o di un specialista come PrivateAlps, funzionano a qualsiasi scala e senza un requisito minimo di cluster. I cluster di storage distribuito self-hosted sono un discorso diverso: far girare Ceph in produzione richiede in genere da tre a cinque nodi prima che il carico operativo inizi a giustificarsi. Per i piccoli team, i servizi gestiti offrono tutti i vantaggi architetturali dello storage distribuito senza l'onere della gestione dell'infrastruttura.
