


Vad är distribuerad lagring?
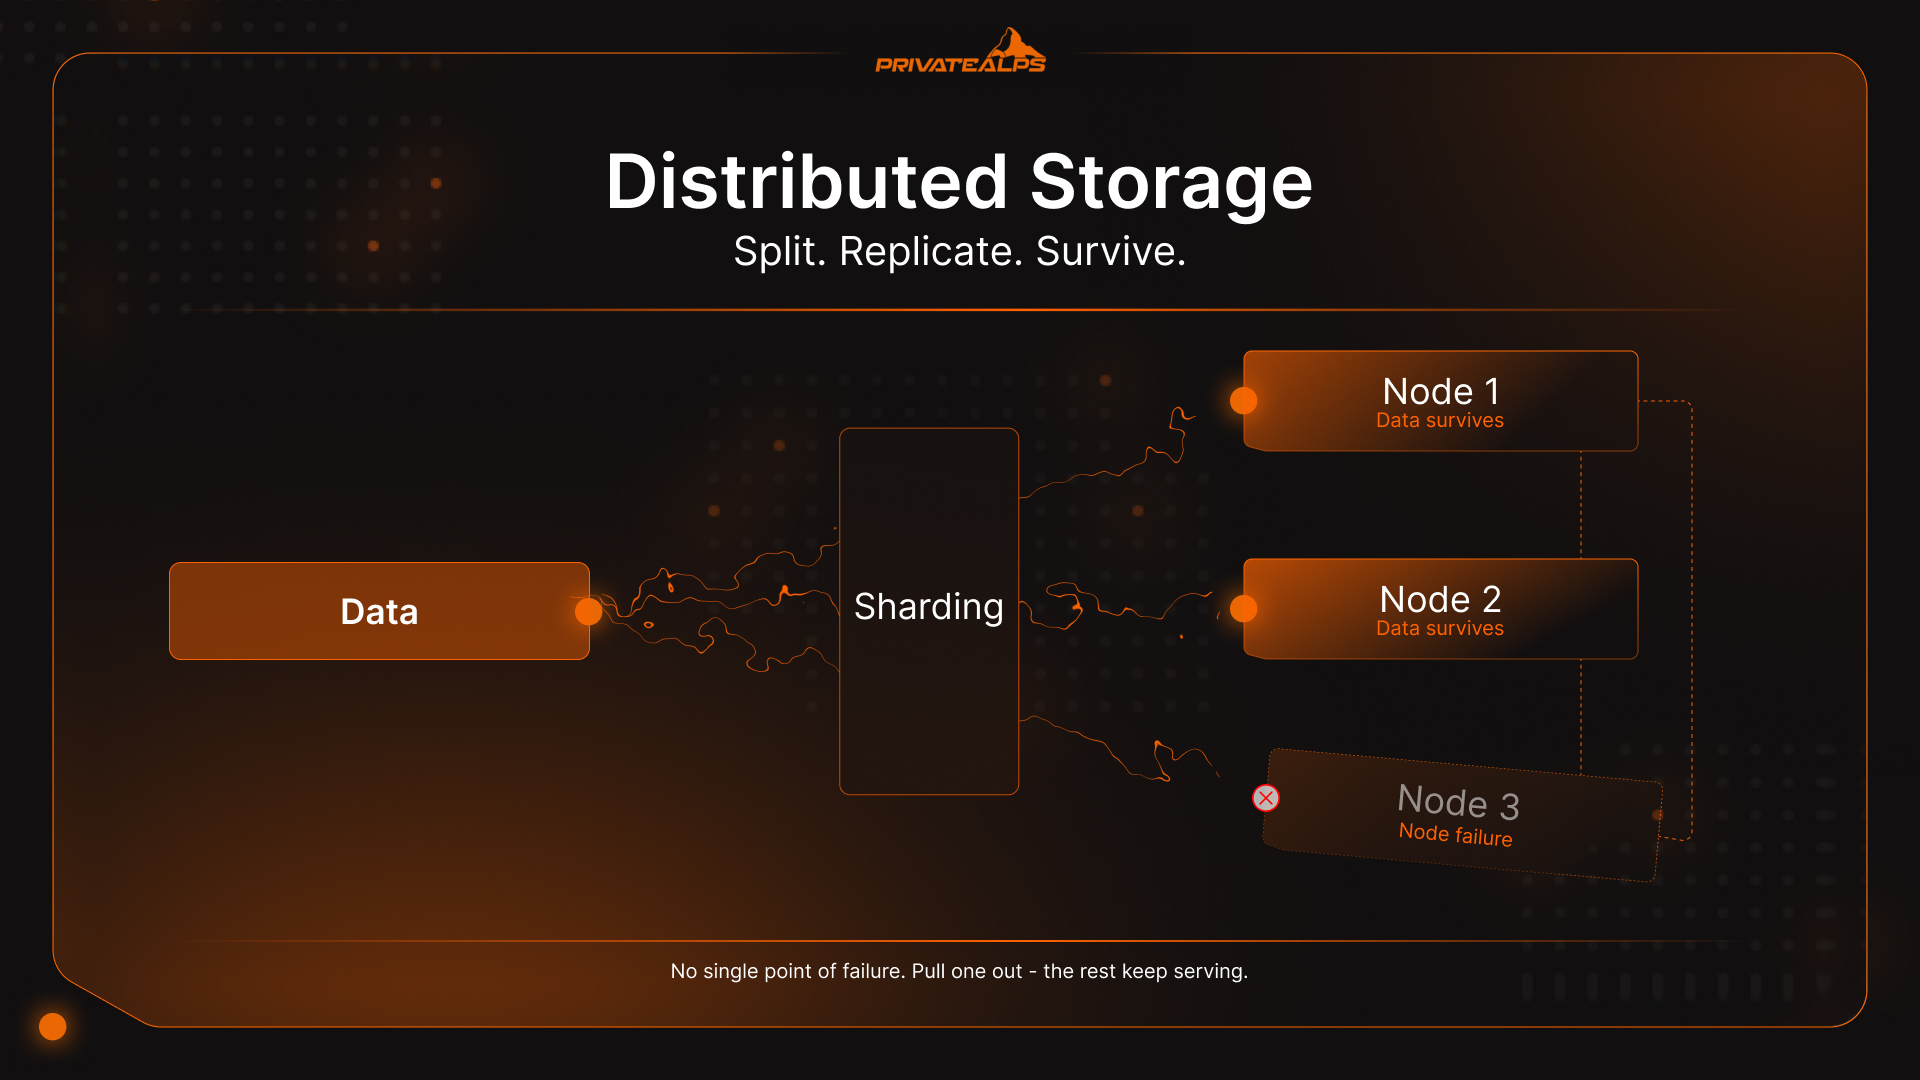
Distribuerad lagring är hur modern infrastruktur hanterar data som är för stor, för kritisk eller för åtkomstintensiv för att en enskild maskin ska kunna lagra den på ett tillförlitligt sätt. Istället för att skriva allt till en enda server delar, replikerar eller kodar systemet datan över flera oberoende noder – servrar, diskar, datacenter. De samverkar, men ingen enskild nod innehåller allt. Tar du bort en nod fortsätter de övriga att leverera data. Den här guiden går igenom hur distribuerade lagringssystem faktiskt beter sig under belastning, vilka arkitektoniska avvägningar de medför och vilken lagringstyp som passar vilken arbetsbelastning.
AI-sammanfattning
Distribuerad lagring är en mjukvarudefinierad arkitektur som fördelar data över flera fysiska noder med tre centrala tekniker: sharding (uppdelning av data i separata bitar som dirigeras till olika noder), replikering (flera identiska kopior på olika noder för snabb åtkomst) och erasure coding (kodning av data i fragment med matematisk paritet, så att en delmängd räcker för att återskapa hela datan).
Det finns tre huvudtyper av distribuerade lagringssystem: objektlagring (platt namnrymd, S3-kompatibelt API), blocklagring (volymer med fast storlek för låg latens vid slumpmässig I/O) och fillagring (hierarkisk namnrymd via NFS eller SMB). Varje distribuerad datalagringslösning stöter på CAP-teoremet: den kan bara garantera två av följande samtidigt – konsistens, tillgänglighet och partitionstolerans.
Den främsta driftfördelen är att nodfel inte orsakar avbrott. Systemet dirigerar automatiskt om förfrågningar till de replikor som fortfarande fungerar.
Det som står på spel i skala: mänskligheten genererar över 400 miljoner terabyte ny data varje dag. Det är en volym som ingen centraliserad arkitektur kan hantera utan att så småningom kollapsa under sin egen tyngd.
Distribuerad vs. centraliserad lagring
Centraliserad lagring samlar allt på en plats – en server, ett SAN, ett datacenter. Det är hela modellen. När den platsen får problem stannar allt. Distribuerad lagring löser detta direkt: data finns över flera oberoende noder, så inget enskilt felställe kan slå ut hela systemet eller blockera all åtkomst.
Ett maskinvarufel och åtkomsten upphör. Punkt. Att skala upp innebär att uppgradera eller ersätta det primära systemet, vilket oftast kräver driftstopp och en investeringsdiskussion som ingen vill ha. Distribuerad lagring kringgår båda problemen från början: lägg till en nod för att växa, och när en nod går sönder dirigerar klustret om trafiken runt den. Inga dramatiska förlopp, inget avbrott. Datan fanns redan på flera noder innan något gick fel.
| Dimension | Centraliserad lagring | Distribuerad lagring |
|---|---|---|
| Feltolerans | Enskilt felställe | Data överlever att enskilda noder förloras |
| Skalbarhet | Vertikal (uppgradera hårdvara) | Horisontell (lägg till noder) |
| Latens | Låg vid lokal åtkomst | Varierar; beror på nätverkstopologin |
| Kostnad i liten skala | Lägre initial kostnad | Högre minsta lönsamma kluster |
| Kostnad i stor skala | Dyrt att skala | Standardhårdvara minskar kostnaden |
| Geografisk spridning | En plats | Flera regioner genom konfiguration |
| Driftkomplexitet | Enkel att hantera | Kräver orkestreringsverktyg |
Så fungerar distribuerade lagringssystem
Ett distribuerat lagringssystem tar in data, delar upp den i bitar, dirigerar bitarna till rätt noder i klustret och spårar varje del via ett metadatalager. Därmed kan varje fragment hittas, hämtas och sättas ihop på begäran, oavsett vilken nod som innehåller det. Det är grundloopen. Fyra mekanismer driver den:
- Sharding (datapartitionering) När data tas emot delar systemet upp den i mindre delar – shards eller block – och sprider ut dem över noderna. Det är detta som möjliggör parallell I/O: flera noder hanterar läsningar och skrivningar samtidigt, så genomströmningen växer med klustrets storlek i stället för att nå taket för en enda maskin. Dirigeringslogiken bygger oftast på konsistent hashning, som håller fördelningen jämn när klustret växer utan att allt behöver omfördelas varje gång en nod läggs till.
- Replikering Det enkla men effektiva sättet: lagra N identiska kopior av varje shard på separata noder, normalt tre. Om en nod går offline fortsätter de övriga två att leverera direkt. Ingen återskapning, ingen väntetid. Replikering är rätt val för heta data, till exempel aktiva databaser, realtidsflöden och allt där en extra millisekund vid läsning faktiskt kostar något.
- Erasure coding Här blir matematiken för lagringseffektivitet intressant. I stället för tre fullständiga kopior kodar systemet ett objekt i $k$ datafragment plus $m$ paritetsfragment, sprider alla $k+m$ över noderna och kan återskapa hela objektet från valfria $k$ av dem. Alltså kan $m$ noder fallera samtidigt utan att något går förlorat. En Reed-Solomon RS(6,3)-konfiguration lagrar 9 block i stället för de 18 som krävs vid 3x replikering, vilket minskar det råa lagringsöverhead från 200 % till ungefär 50 %. Haken är att kodning och avkodning förbrukar CPU-cykler, och erasure coding fungerar bättre för kalla data, det vill säga innehåll som sällan ändras eller används med hög frekvens. För arbetsbelastningar med många små skrivningar är 3x replikering fortfarande bäst när det gäller latens.
| Skyddsmetod | Lagringsöverhead | Bäst för | Avvägning |
|---|---|---|---|
| 3x replikering | 3x råkapacitet | Heta data, arbetsbelastningar med låg latens | Hög lagringskostnad i skala |
| Erasure coding RS(6,3) | 1,5x råkapacitet | Kalla data, arkivering, stora objekt | CPU-överhead, högre återuppbyggnadstid |
- Metadatadirigering Varje distribuerat lagringssystem har ett metadatalager, i grunden en karta över vilken shard som finns på vilken nod. När en klient begär data identifierar metadatatjänsten rätt noder, och systemet hämtar och sätter ihop fragmenten utan att klienten ser komplexiteten. I storskaliga kluster som Ceph eller HDFS är metadatalagret i sig distribuerat över noder. Det måste vara så. En enda metadataserver blir flaskhalsen som du försökte bli av med.
Typer av distribuerade lagringssystem
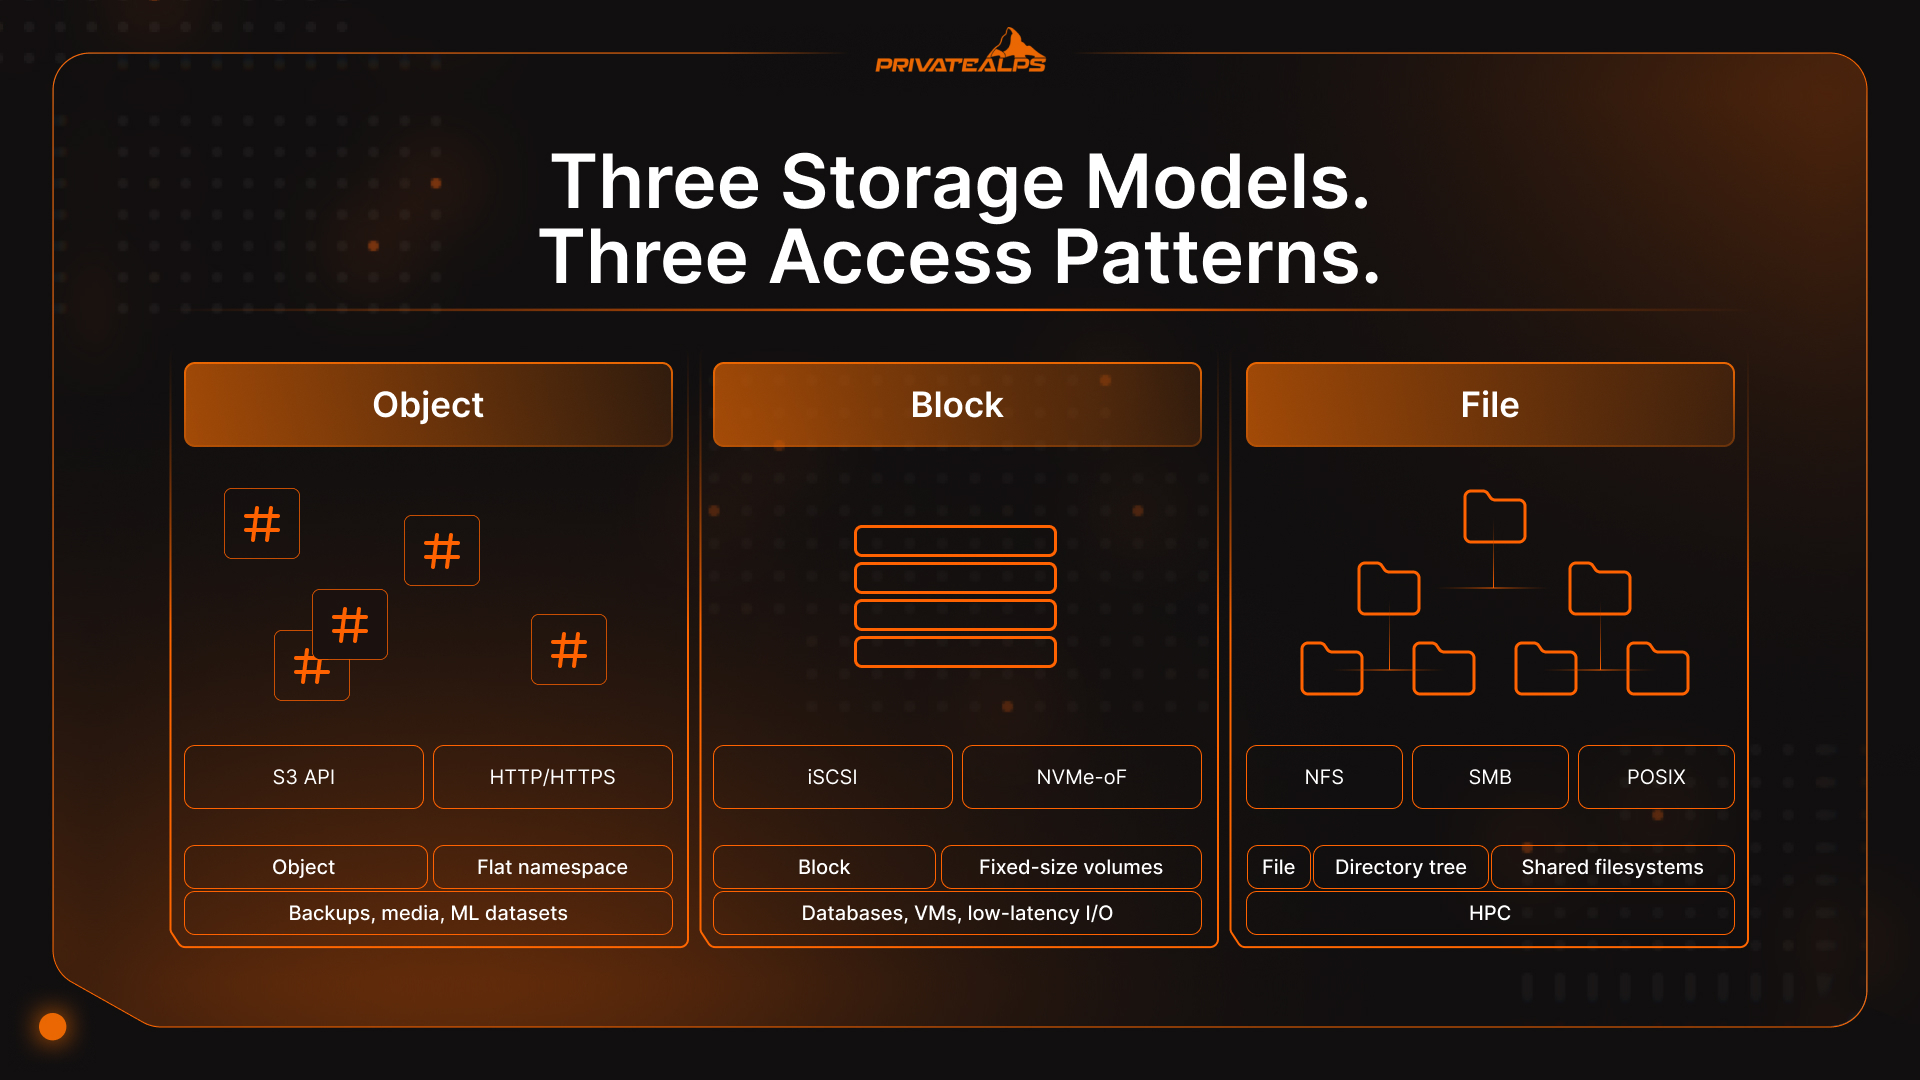
Distribuerad lagring är inte en enda sak. Det är en kategori med tre olika datamodeller, och att välja fel modell för en arbetsbelastning är ett överraskande vanligt och dyrt misstag. Objekt-, block- och fillagring löser var sitt problem. Distribuerade databaser – Cassandra, CockroachDB, Google Spanner – utgör en fjärde typ, eftersom de lägger frågesemantik ovanpå distribuerad datahantering, men det är en separat diskussion.
| Typ | Hur data lagras | Åtkomstmetod | Bäst för | Exempel |
|---|---|---|---|---|
| Objekt | Platt namnrymd, metadatarika objekt | S3-kompatibelt API (HTTP/HTTPS) | Ostrukturerad data i stor skala: backuper, media, ML-dataset | AWS S3, MinIO, Ceph RADOS |
| Block | Råa volymer med fast storlek | iSCSI, NVMe-oF, FC | Databaser, VM:er, I/O med låg latens och slumpmässig åtkomst | Ceph RBD, AWS EBS, Lightbits |
| Fil | Hierarkiskt kataloglträd | NFS, SMB, POSIX | Delade filsystem, HPC, hemkataloger | GlusterFS, HDFS, Azure Files |
Distribuerad objektlagring
Distribuerad objektlagring organiserar data som enskilda, oföränderliga objekt i en platt namnrymd. Det finns inga kataloger, inga sökvägar och ingen hierarki att underhålla. Varje objekt får en unik identifierare (en hash eller UUID) plus rik metadata, och du når det via ett S3-kompatibelt API över HTTP. Eftersom objekt ersätts i stället för att uppdateras delvis försvinner låsproblemet som begränsar prestanda och skalbarhet i block- och filsystem. Så skalar AWS S3, Azure Blob och Ceph till exabyte: ingen koordineringskostnad för namnrymden, ingen låskonkurrens och vilken nod som helst i klustret kan hantera vilken objektförfrågan som helst självständigt.
Distribuerad blocklagring
Blocklagring ger servrar råa volymer, block med fast storlek och unika adresser, utan något filsystemlager ovanpå. Applikationer skriver direkt till blocken, vilket ger konsekvent I/O med låg latens och slumpmässig åtkomst för databaser, VM-diskar och containerbaserade arbetsbelastningar. En arkitektonisk begränsning som överraskar många: en blockvolym kan normalt bara monteras av en server i taget. Delad åtkomst från flera servrar kräver extra orkestrering ovanpå, till exempel ett klusterfilsystem som läggs över blockenheterna.
Distribuerad fillagring
Fillagring presenterar ett delat filsystem via standardprotokoll – NFS, SMB, POSIX-kompatibel åtkomst. Flera klienter kan montera samma volym samtidigt, vilket gör den till ett naturligt val för samarbetsbaserade arbetsbelastningar, HPC-miljöer och äldre applikationer som förväntar sig ett kataloglträd och inte kommer att skrivas om i närtid. Den verkliga avvägningen: att upprätthålla ett konsekvent kataloglnamnrymd över distribuerade noder skapar koordineringsöverhead som växer med skalan. De flesta hyperskalare migrerar så småningom från distribuerad fillagring till distribuerad objektlagring för primärdata när volymerna blir tillräckligt stora.
CAP-teoremet: den oundvikliga avvägningen i distribuerad lagring
CAP-teoremet säger att ett distribuerat datasystem bara kan garantera två av tre saker samtidigt: konsistens (varje läsning returnerar den senaste skrivningen), tillgänglighet (varje förfrågan får ett svar) och partitionstolerans (systemet fortsätter att fungera vid nätverksavbrott). Nätverk delas upp – partitionstolerans är inte valfri. Det verkliga valet står alltid mellan konsistens och tillgänglighet när ett fel inträffar.
[Eric Brewer introducerade CAP år 2000; Gilbert och Lynch formaliserade beviset år 2002][https://www.scylladb.com/glossary/cap-theorem/]. Det är fortfarande det beslut som formar allt annat i arkitekturen för distribuerad lagring, eftersom det avgör hur systemet beter sig i exakt det ögonblick du mest behöver det, när något redan är trasigt.
| System | CAP-typ | Beteende vid partition | Bäst för |
|---|---|---|---|
| MongoDB | CP (med majoritetsbaserade läs- och skrivkrav) | Avvisar förfrågningar tills konsistensen återställts | Finansiella register, lager, bokningar |
| HBase | CP | Returnerar fel hellre än inaktuell data | Strukturerad analys, konsekventa batchjobb |
| Apache Cassandra | AP | Förblir tillgänglig; kan returnera inaktuella läsningar | Sociala flöden, meddelanden, IoT-telemetri |
| DynamoDB (standard) | AP | Svarar alltid; avstämmer inkonsekvens asynkront | Konsumentappar med hög genomströmning |
| CockroachDB | CP | Konsistens först, distribuerad SQL | Globala transaktionsarbetsbelastningar |
Den praktiska slutsatsen: tål din arbetsbelastning en inaktuell läsning? Ett bankkonto, en platsreservation eller ett lagersaldo – troligen inte. Välj CP. Ett socialt flöde, en flod av sensorhändelser eller analystelemetri – några sekunders föråldring är acceptabelt. Välj AP och behåll tillgänglighetsgarantin.
Säkerhet i distribuerad lagring: kryptering och datasuveränitet
Säkerheten i distribuerad lagring vilar på tre skilda lager: data i vila, data under överföring och nyckelägande. Brister du i ett av dem hjälper inte de andra. Infrastrukturen kan vara helt tillgänglig samtidigt som känslig data i tysthet är åtkomlig för fel personer.
Kryptering behöver täcka alla tre. Data i vila använder typiskt AES-256, antingen med nycklar som hanteras av leverantören eller med kundhanterade nycklar (CMK). Leverantörshanterade nycklar är enklare att drifta, men lagringsleverantören har då själva nyckelmaterialet, vilket är en kritisk säkerhetsaspekt för reglerade branscher som genomgår revisioner. Klientsidig kryptering tar bort den exponeringen helt: data krypteras innan den lämnar klienten, så leverantören aldrig ser klartext oavsett vilka juridiska förfrågningar som kommer in. För data under överföring är TLS 1.3 golvet för säkerheten. Allt som fortfarande tillåter TLS 1.2 kräver ett dokumenterat undantag enligt de flesta aktuella efterlevnadsramverk.
Datasuveränitet överraskar ofta team. Data omfattas av lagarna på den plats där den fysiskt finns, varken företagets land eller användarens plats spelar roll. Schweiz har adekvat skyddsnivå enligt GDPR artikel 45, så dataöverföringar från EU till Schweiz kan genomföras utan ytterligare avtalsmässiga skyddsåtgärder. Den reviderade dataskyddslagen (nFADP) harmoniserar de schweiziska inhemska reglerna med GDPR, vilket innebär att schweizisk infrastruktur ger enhetlig regelefterlevnad enligt båda ramverken samtidigt.
Något som är lätt att skjuta upp men som man inte bör skjuta upp: de kryptografiska algoritmer som skyddar merparten av dagens lagringsinfrastruktur är inte utformade för att klara en kapabel kvantdator. NIST slutförde tre standarder för postkvantkryptografi i augusti 2024, bland dem FIPS 203 (ML-KEM). Om din distribuerade datalagring innehåller poster med lång bevarandetid, som medicinska arkiv, finansiella handlingar eller juridiska dokument, är hotmodellen ”skörda nu, dekryptera senare” redan aktiv. Utvärderingen bör påbörjas långt innan dessa arkiv når sin mognad.
Viktiga fördelar med distribuerad lagring
- Feltolerans utan avbrott i tjänsten: Ett nodfel utlöser hjärtslagsdetektering och automatisk omdirigering till återstående repliker. Ingen manuell insats och inget underhållsfönster krävs.
- Horisontell skalbarhet: Ny lagringskapacitet kommer från att lägga till noder i klustret. Data balanseras om i bakgrunden utan att påverka live-trafik eller kräva driftstopp.
- Geografisk spridning: Replikering över regioner minskar latensen för geografiskt spridda användare och gör efterlevnad av dataplacering till ett konfigurationsbeslut snarare än ett infrastrukturprojekt.
- Parallell I/O-genomströmning: Flera noder hanterar läsningar och skrivningar samtidigt. Det är den enda skalbara arkitekturen för AI/ML-träningspipelines, videotranskodning och mediestreaming i verklig produktionsvolym.
- Ingen leverantörsinlåsning med öppna protokoll: S3-kompatibla API:er, NFS och open source-plattformar som Ceph låter team byta leverantör eller köra infrastrukturen on-premises utan att skriva om applikationskoden.
- Kostnadseffektivitet i skala: Standardhårdvara ersätter dyra proprietära lagringsarrayer. Erasure coding minskar dessutom råkapacitetsbehovet med upp till 50 % jämfört med full replikering mellan noder.
Begränsningar och utmaningar med distribuerad lagring
- Konsistenskomplexitet: Att upprätthålla ett konsekvent tillstånd över noder kräver noggrann inställning av konsistensmodeller, replikeringsfaktorer och kvorumvärden. En felkonfiguration larmar inte högljutt utan driver tyst data mot divergens.
- Driftkostnad: Att köra ett distribuerat lagringskluster innebär ansvar för planering av felområden, procedurer för nodbyte, övervakningspipelines och prestandajustering. En enskild server kräver inte allt detta av dig.
- Nätverksberoende: Hela arkitekturen förutsätter tillförlitlig anslutning med hög bandbredd mellan noderna. Nätverksförsämring översätts direkt och proportionellt till förlust av lagringslatens och genomströmning.
- Latens för små slumpmässiga I/O: Distribuerad lagring är optimerad för stora sekventiella läsningar och parallell genomströmning. Arbetslaster med tung småslumpig I/O, särskilt OLTP-databaser, fungerar ofta bättre på lokalt kopplad NVMe-blocklagring.
- Minsta rimliga skala: Kostnads- och komplexitetsfördelarna med distribuerad lagring syns inte i ett kluster med två noder. Under en viss tröskel är en hanterad molnlagringstjänst eller en välinställd enskild server helt enkelt billigare och enklare att driva.
Verkliga användningsfall för distribuerad lagring
- Media och streaming: Netflix och YouTube levererar inte video från en central plats. De distribuerar kodat innehåll över objektlagringskluster placerade geografiskt nära tittarna. Ett enda datacenter klarar inte samtidiga globala strömmar i skala, och bandbreddskostnaderna ensamma skulle vara oöverkomliga. Distribuerad datalagring är det som gör streamingens ekonomi faktiskt fungerar.
- Hälso- och sjukvård: En MR-undersökning genererar 500 MB till 1 GB bilddata. Multiplicera det över ett stort sjukhusnätverk, med olika modaliteter, långa bevarandekrav och flera platser, så talar du om petabyte som ackumuleras snabbt. Skalbar distribuerad lagring med geografisk redundans är hur vårdsystem bibehåller HIPAA-kompatibel åtkomst till patientjournaler även när ett regionalt datacenter havererar.
- AI och maskininlärning: Att träna en stor språkmodell innebär att mata GPU-kluster med terabyte till petabyte data, åtkomna i icke-sekventiella mönster som snabbt skulle mätta ett traditionellt lagringssystem. Ceph, HDFS och S3-kompatibla objektlager har blivit standardinfrastrukturen för ML-pipelines eftersom deras parallella läsgenomströmning faktiskt matchar vad GPU-klustren förbrukar.
- Backup och katastrofåterställning: Verklig katastrofåterställning innebär att data finns på minst två geografiskt åtskilda platser med oberoende felområden, inte två rack i samma byggnad. Replikeringspolicyer och placeringsregler inbyggda direkt i det distribuerade lagringslagret definierar RPO och RTO på infrastrukturnivå, utan att kräva en separat backupmjukvarustack. Färre rörliga delar innebär också en mindre attackyta.
Distribuerad lagring vs. decentraliserad lagring: vad är skillnaden?
Distribuerad lagring innebär att data sprids över många noder, men en organisation äger och styr fortfarande helheten: policyer, åtkomsträttigheter, raderingsförmåga och granskningsloggar. Decentraliserad lagring tar helt bort den centrala auktoriteten. Data lever över oberoende peers, och ingen enskild operatör kan ensidigt censurera, komma åt eller radera den.
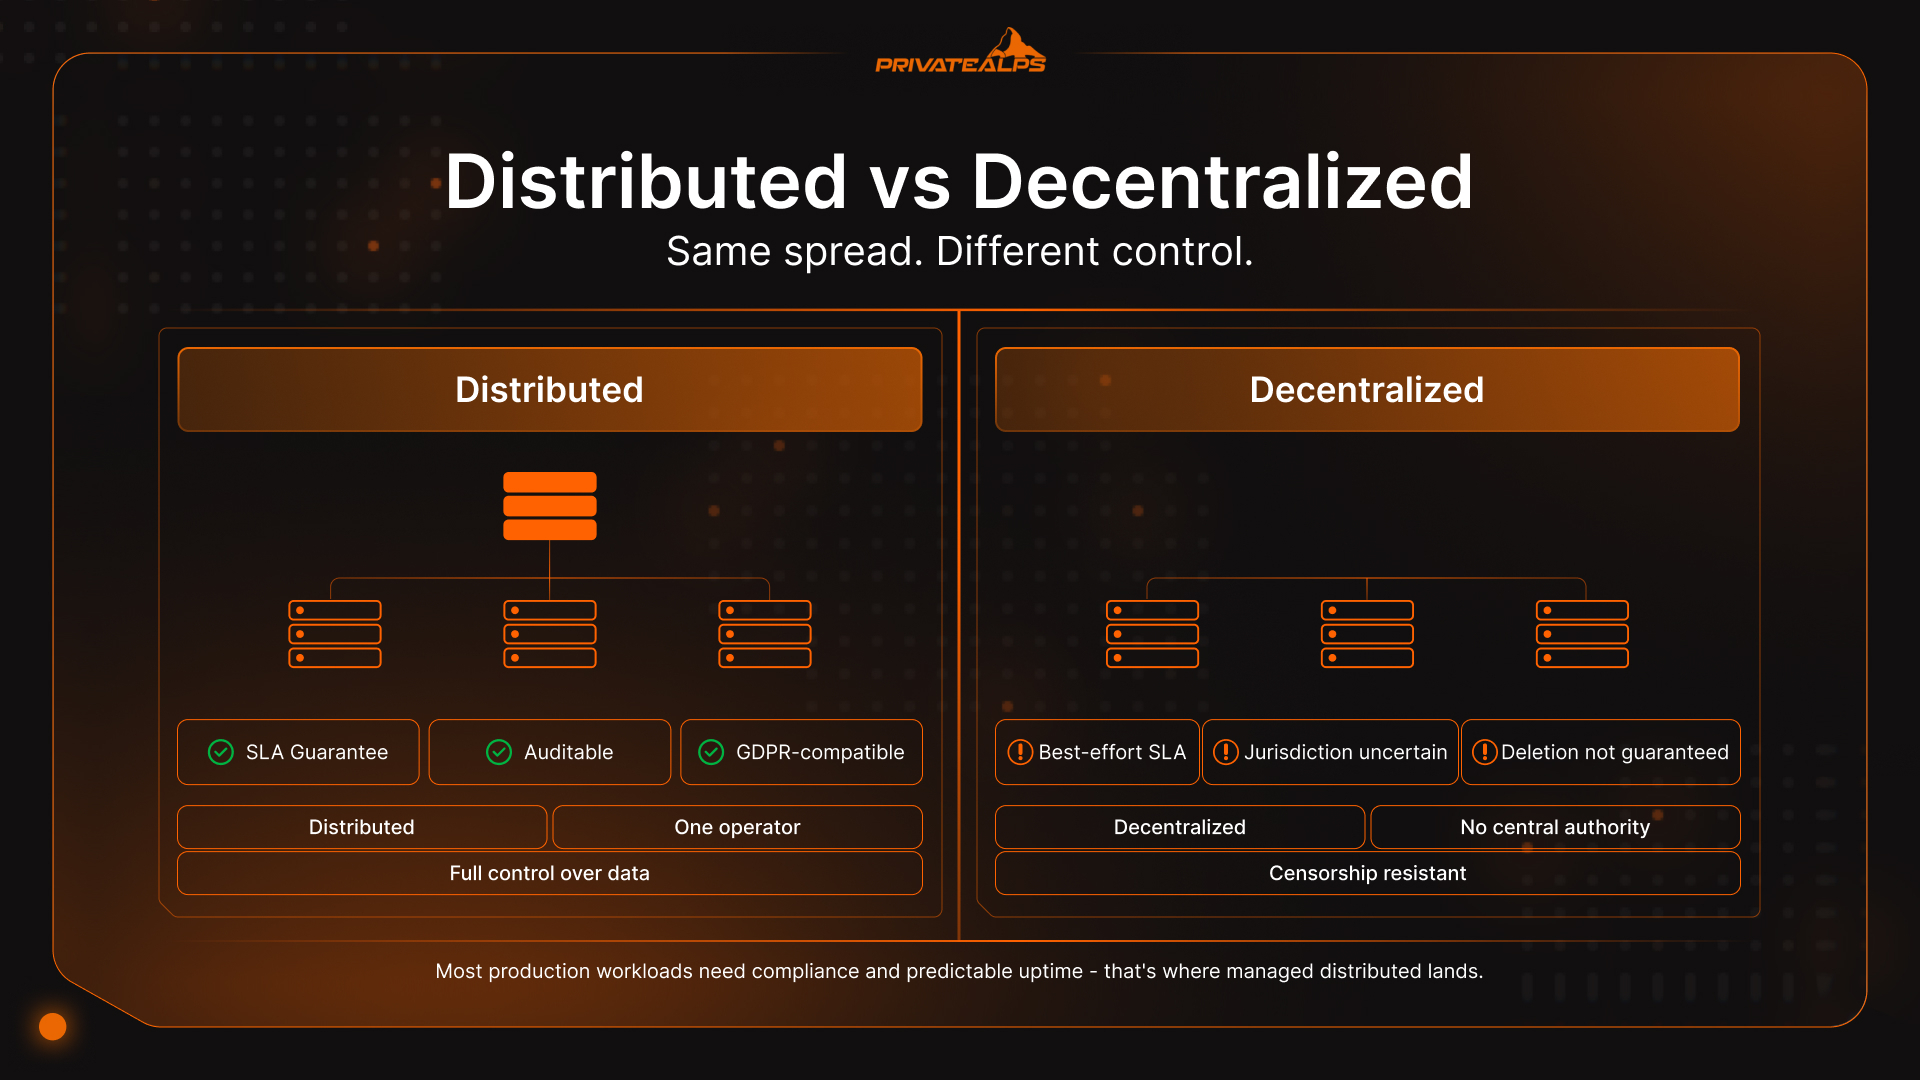
Skillnaden får verkliga operativa konsekvenser. Ett centralt hanterat distribuerat system kan granskas, patchas, omfattas av SLA:er och föras in i regelefterlevnad. Ett decentraliserat system byter bort allt detta mot censurmotstånd och förtroendelös drift. Det är värdefullt i specifika sammanhang, men inte det de flesta företag som kör produktionslagring faktiskt behöver.
| Aspekt | Distribuerad lagring | Decentraliserad lagring |
|---|---|---|
| Kontroll | Centralt administrerad | Ingen central auktoritet |
| SLA / upptidsgarantier | Avtalsenliga garantier möjliga | Best effort, protokollberoende |
| Efterlevnad | Granskningsbar, GDPR-kompatibel | Jurisdiktion osäker |
| Dataradering | Garanterad | Inte alltid möjlig |
| Åtkomstkontroll | Rollbaserad, hanterad | Kryptografisk, förtroendelös |
| Exempel | AWS S3, Azure Blob, Ceph | Storj, Filecoin, IPFS |
En annan skillnad värd att lyfta fram: molnlagring över flera regioner, som AWS S3 med replikering mellan regioner eller Azure geo-redundant storage, är fortfarande centralt administrerad infrastruktur. Leverantören sköter noder och replikering, så du hyr i praktiken geografi. Verkliga distribuerade molnplattformar som Storj eller Cubbit fördelar data över oberoende operatörer. Det tar bort leverantörsinlåsning men väcker frågor om SLA:er och granskningsspår igen. För de flesta arbetslaster som kräver efterlevnadsdokumentation och förutsägbar upptid är det hanterade distribuerade alternativet där det landar.
Sammanfattning
Distribuerad lagring är inte en produkt. Den är en arkitekturkategori, och rätt variant beror helt på vad du kör. Objekt-, block- och fillagring har var sin datamodell byggd för olika åtkomstmönster och arbetslastformer. CAP-satsen tvingar fram en verklig avvägning mellan konsistens och tillgänglighet i samma ögonblick som nätverksfel uppstår, och att fatta fel beslut där kan bli dyrt. När det gäller replikering kontra erasure coding avgör datatemperaturen: varm data behöver replikering för latens, medan kall data drar nytta av erasure codings effektivitet i lagringsutrymme. För de flesta team ger en hanterad distribuerad lösning, från privat leverantör eller publik moln, så länge dataplacering och säkerhetskontroller är verifierbara, en bättre balans mellan skalbarhet, prestanda och vardaglig driftsenkelhet än ett självhostat kluster.
Lagra din data i Schweiz – med PrivateAlps
Om din arbetslast behöver S3-kompatibel distribuerad objektlagring med verifierbar dataplacering kör PrivateAlps schweizisk infrastruktur som fullt ut uppfyller både GDPR artikel 45 och nFADP. Din data stannar i Schweiz: ingen delning med tredje part, ingen oklar routing genom utländska jurisdiktioner och inga överraskningar. Oavsett om du flyttar bort från en hyperscaler eller bygger en integritetsfokuserad distribuerad lagringsarkitektur från grunden levererar PrivateAlps den prestanda och efterlevnadssäkerhet som din arbetslast faktiskt kräver.
FAQ
Vad är skillnaden mellan distribuerad lagring och molnlagring?
Molnlagring är en leveransmodell. Någon annan sköter infrastrukturen och du når den över internet på betalning per användning. Distribuerad lagring är en arkitektur, där data sprids över flera noder för redundans och skalbarhet. Det är oberoende begrepp. Du kan köra distribuerad lagring helt on-premises med Ceph eller MinIO, och en molnleverantör kan tekniskt sett leverera centraliserad lagring bakom ett API. De flesta molnlagringstjänster använder distribuerade arkitekturer internt, men det är en implementationsdetalj och inte definitionen av molnlagring.
Vilket är det bästa distribuerade lagringssystemet?
Det finns inget universellt svar. Det beror på arbetslasten och datamodellen. För ostrukturerad data och backuper är S3-kompatibla objektlager som MinIO eller Ceph RADOS standardvalet. För databasvolymer och VM-diskar som kräver konsekvent I/O med låg latens på blocknivå är Ceph RBD eller Lightbits ett bättre val. För delade filsystem i HPC- eller äldre miljöer hamnar team oftast på GlusterFS eller HDFS. Börja med åtkomstmönstret, så följer lagringssystemet av det.
Är distribuerad lagring samma sak som RAID?
Nej. RAID verkar inom en enskild server eller lagringsarray och skyddar mot diskfel inuti en maskin. Distribuerad lagring verkar över separata fysiska noder som är kopplade via nätverk, eventuellt spridda över flera byggnader eller hela datacenter. RAID hjälper inte när själva servern havererar. Distribuerade lagringssystem är specifikt utformade för att tåla nodfel, rackfel och totala datacenterhaverier. Skillnaden i omfattning är grundläggande.
Hur hanterar distribuerad lagring nodfel?
Noder skickar regelbundna hjärtslagssignaler till klustrets metadatalager. När en nod slutar svara upptäcker systemet felet, vanligtvis inom några sekunder, och omdirigerar förfrågningar till noder som har replikerna eller de erasure-kodade fragmenten. I replikeringsbaserade upplägg startar sedan en bakgrundsåterställning som skapar nya kopior för att återställa den konfigurerade replikeringsfaktorn i klustret. Allt sker automatiskt. I ett väl konfigurerat distribuerat lagringskluster märker applikationerna aldrig felet alls.
Är distribuerad lagring lämpligt för små företag?\\
Hanterade distribuerade lagringstjänster, som S3-kompatibel objektlagring från en molnleverantör eller en specialist som PrivateAlps, fungerar i alla skalor utan krav på minsta klusterstorlek. Självhostade distribuerade lagringskluster är en annan historia. Att köra Ceph i produktion kräver typiskt minst tre till fem noder innan driftkostnaden börjar motivera sig. För små team ger hanterade tjänster alla arkitektoniska fördelar med distribuerad lagring utan bördan av infrastrukturdrift.
